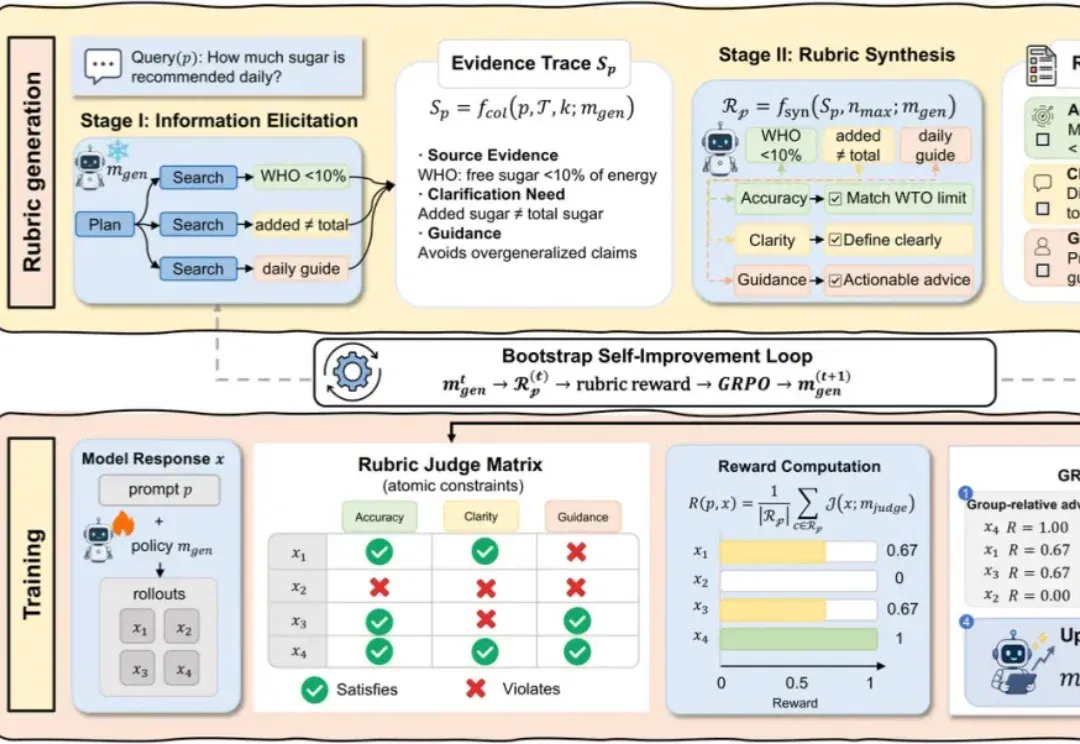
NeurIPS 2026|小红书 × 复旦大学用DR-Rubric为开放式强化学习构建评分标准 (opens in a new tab)
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
Categories
Practical guides to AI tools, models and related technologies.
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
太震撼了。 就在刚刚,一项研究显示,GPT-6 Astra 已经解决了 98% 的全新理论物理难题!
由Transformer奠基论文核心作者Llion Jones创办的 Sakana AI,联手UC Berkeley带来了一项递归自我改进(RSI)新成果:MASS(Multi-Agent Self-Supervision)。
谷歌的AI数学家,登上Science了!
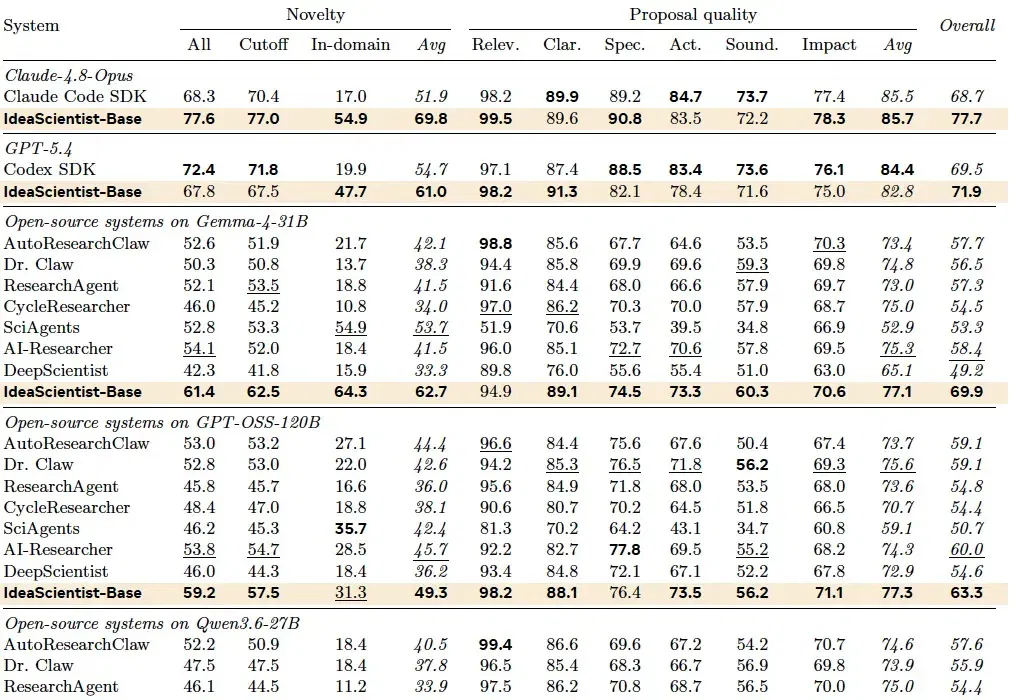
都知道跨学科才能拿大结果,可啃完全陌生的领域又太烧心?
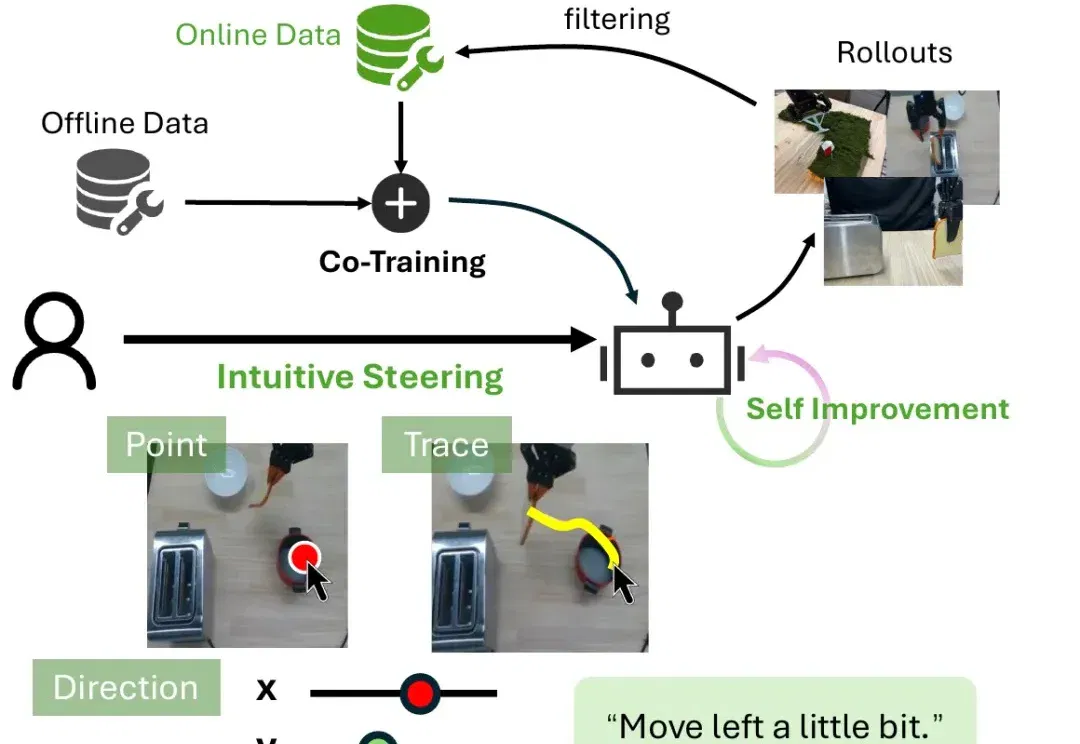
看着机器人抓偏了杯子、迟迟对不准面包机的插口,人们可能会忍不住提醒:“往左一点,再往前一点。”这些对人类来说再简单不过的调整,对机器人却未必容易。
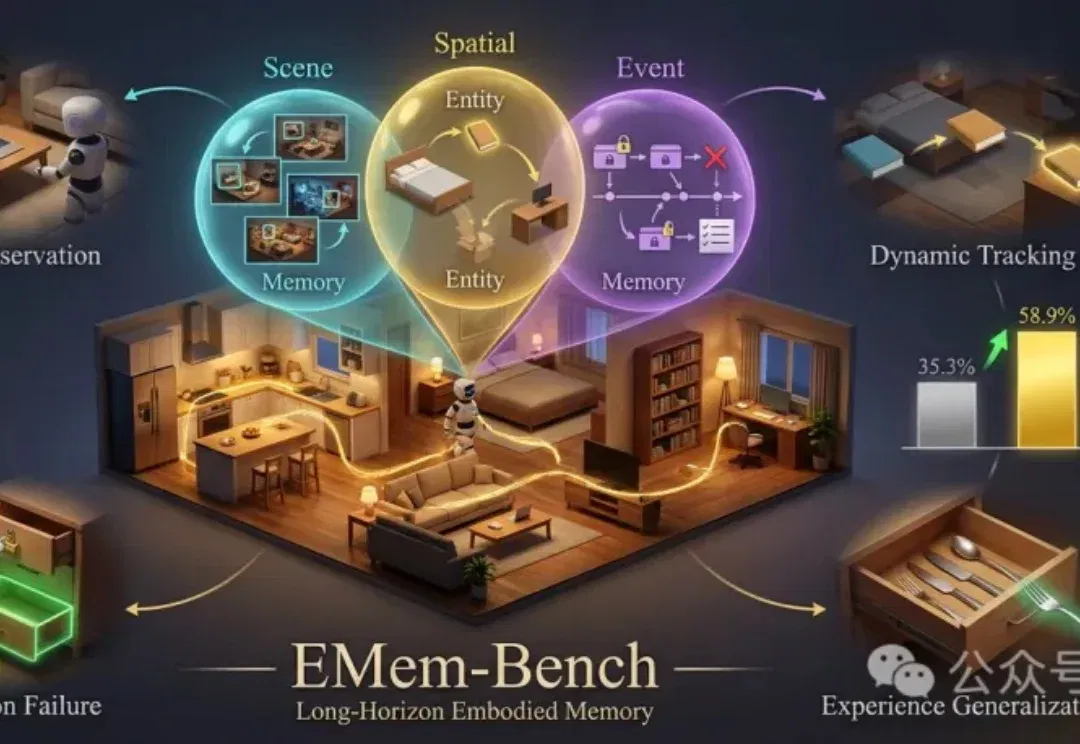
设想一个日常场景: 家庭机器人刚刚在茶几上看见一本书,去厨房完成几项任务后,接到取书的指令,却又开始挨个房间搜索。它已经试过一个打不开的抽屉,过了一会儿,还是回到同一个抽屉前反复尝试。
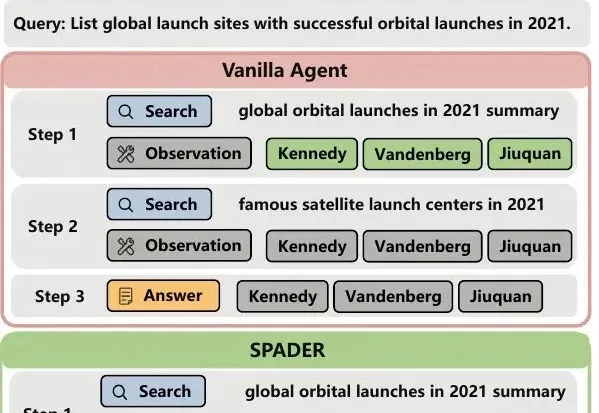
一句话概括:多答案问答要求智能体找全整个答案集合,而不是只搜到一个就停止。现有 RL 方法在此场景下存在两处错位:优势计算停留在轨迹级,信用分配粗糙;F1 奖励对头部与长尾实体一视同仁,智能体缺乏探索长尾的动力。
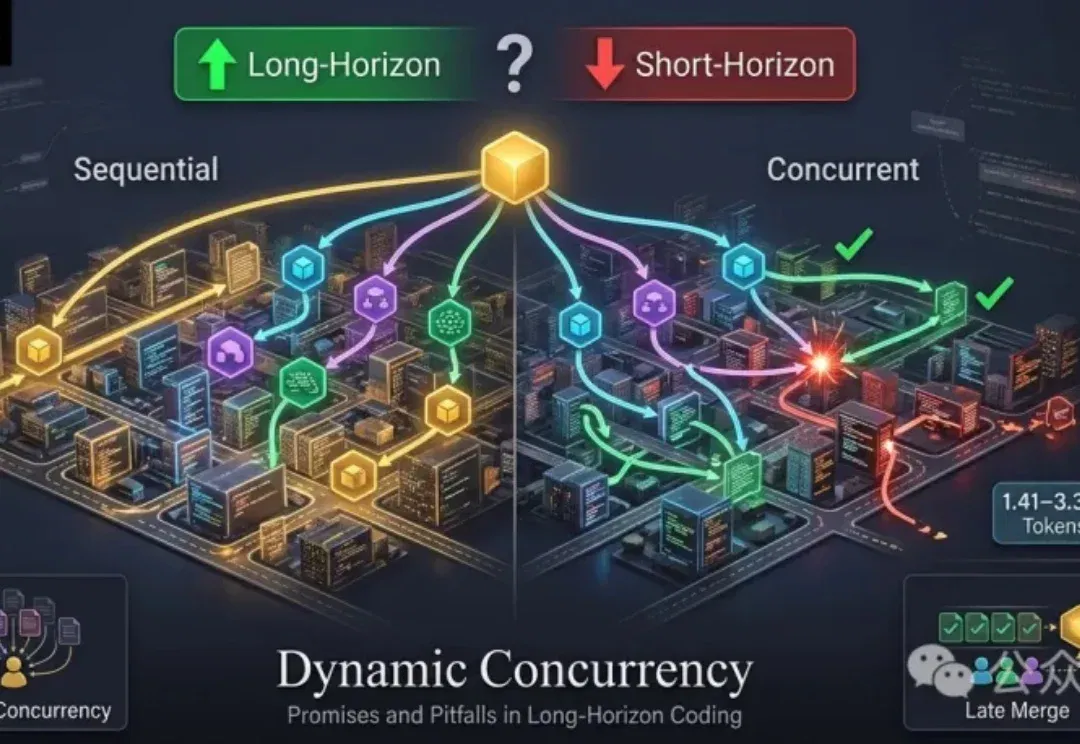
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
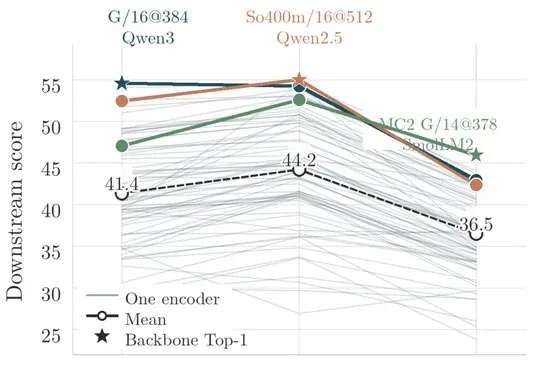
团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。
STILL被NeurIPS 2026正式接收,这一首个内容感知的同层混合注意力架构通过自显著性分数按内容选择token,仅用0.04B训练token即在16K上下文下实现80%显存削减和83%预填充加速。
厦门大学ASC Lab团队提出的FlowMAS获NeurIPS 2026录用,通过GFlowNet、好奇心驱动模块和信息引导优化模块自动生成多样且低成本的大模型多智能体工作流拓扑,并在六个基准实验中取得领先成绩。
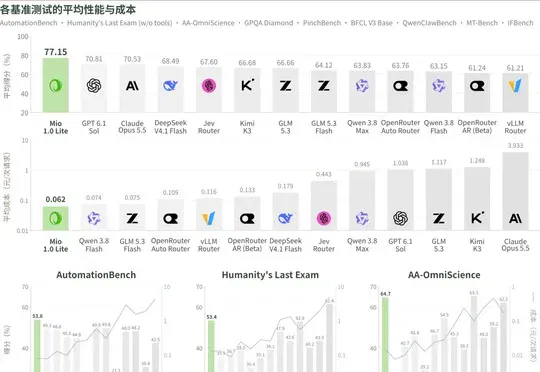
南芥智能发布模型群体智能技术报告,披露Mio 1.0 Lite在9个公开benchmark中平均得分77.15/100居首、平均每请求成本0.06元最低,其SinapisAI平台已公测并收录484个模型。
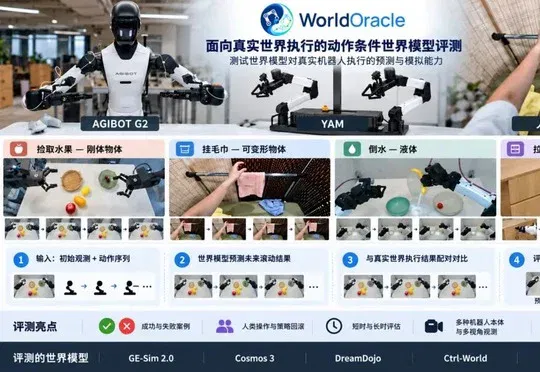
普林斯顿大学、得克萨斯大学奥斯汀分校、多伦多大学、NVIDIA和智元研究人员提出WorldOracle,并于10月16日开放评测平台;七种模型的真实执行对照显示,其机械臂轨迹较准但物体运动易偏离,长序列预测表现也会明显退化。
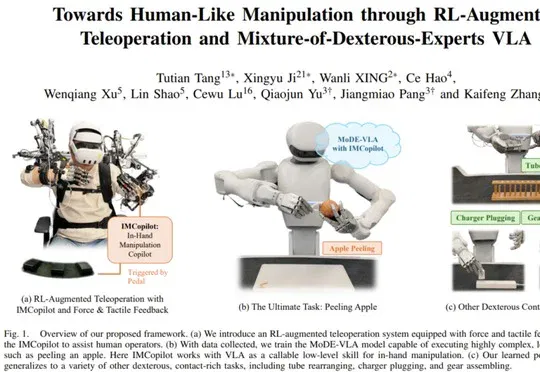
Sharpa以22自由度Sharpa Wave灵巧手为硬件平台,通过融合人类与遥操作数据、解耦运动与接触控制及开展触觉跨本体学习,系统推进灵巧操作的数据、模型与硬件协同研究。
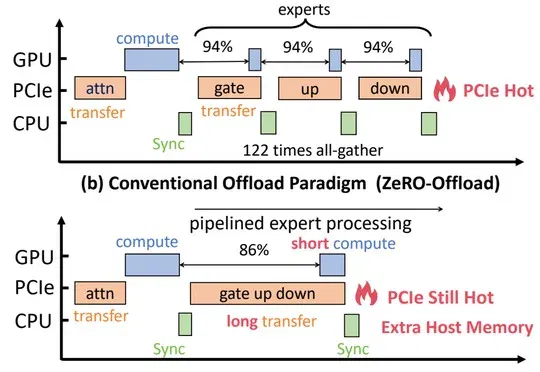
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
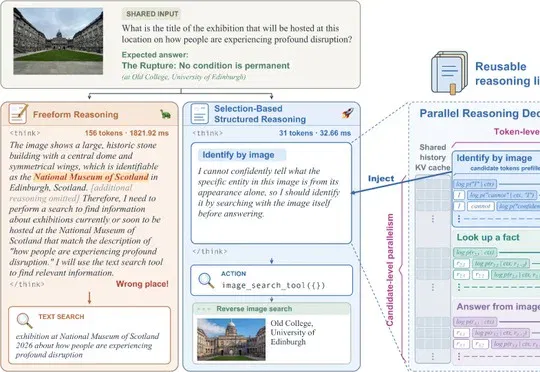
苹果与卡内基梅隆大学团队提出SSR(Selection-based Structured Reasoning),让多模态搜索Agent从预定义选项中选择推理,在7个benchmark上将每轮推理延迟降低超90%,同时保持相当的任务成功率。
香港科技大学周子杰团队与华为 2012 实验室理论部提出 BalanceRoute,通过建模与短期负载预测减少 MoE 模型解码的跨组同步等待,其已部署于 MathBot-Pie,并在 96 张昇腾 910C NPU 实验中使解码吞吐提升约 15%。
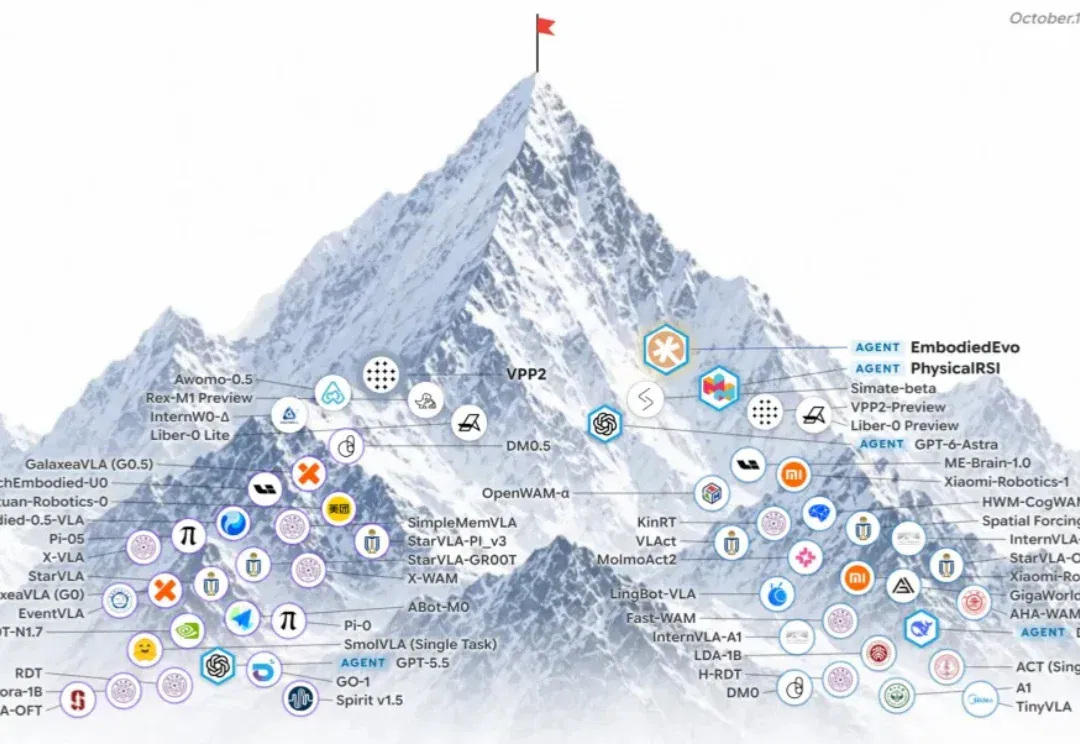
会写代码的 Agent,正在走向物理世界。
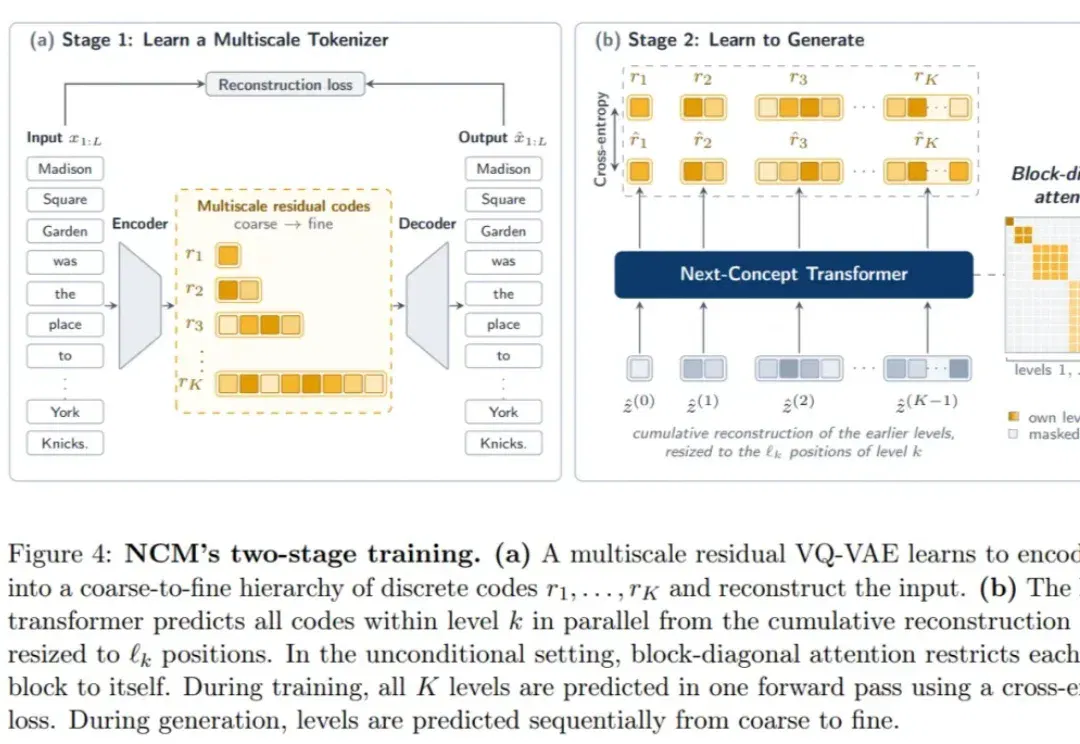
如今的大模型再聪明,输出内容也是一个字一个字往外蹦。有没有一种可能:真正的 AGI 不是这样?
Join the conversation
Read how to join the community. No sign-in is required to read articles.