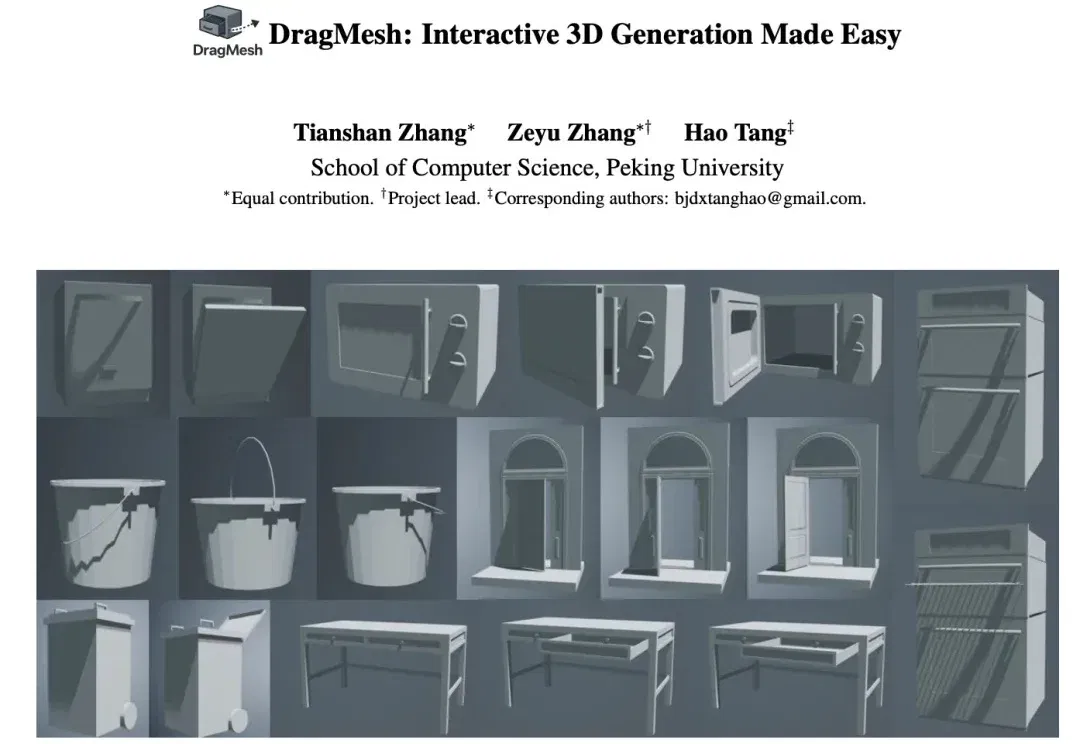
IJCV 2026|北大团队提出DragMesh:一次拖拽,实现可交互的3D关节运动生成 (opens in a new tab)
近年来,3D 生成模型在几何质量和渲染效果上进步很快。从 Mesh 到 NeRF、3D Gaussian Splatting,生成一个外观完整的三维物体已经不再困难。现有不少 articulated 3D generation 工作,更多关注的是从输入中生成一整套可动 3D 资产,包括物体几何、部件划分以及关节结构。
Categories
Practical guides to AI tools, models and related technologies.
近年来,3D 生成模型在几何质量和渲染效果上进步很快。从 Mesh 到 NeRF、3D Gaussian Splatting,生成一个外观完整的三维物体已经不再困难。现有不少 articulated 3D generation 工作,更多关注的是从输入中生成一整套可动 3D 资产,包括物体几何、部件划分以及关节结构。
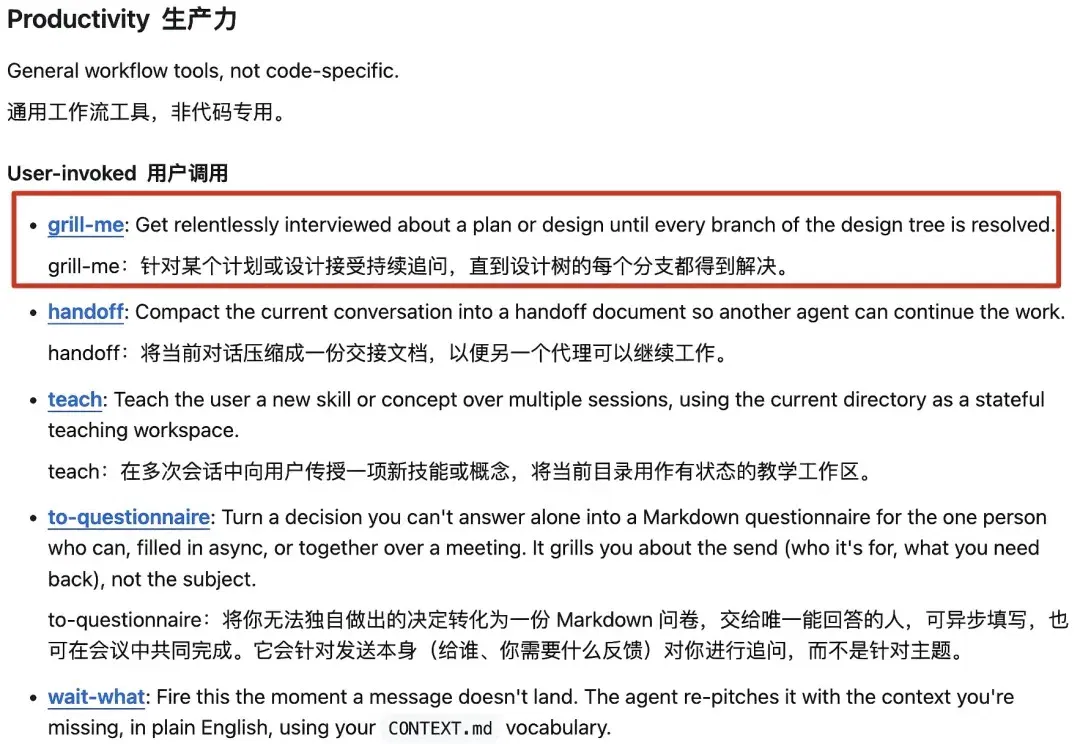
今年我攒了一堆思考类的提示语。 满满25个,有经典的苏格拉底式提问、第一性原理和对抗性审查、双向钢人论证,Anthropic哲学家的寓言记忆法,条条都好用。一般来说我有两条路来存提示语,方法一把有用的点拆出来放到Agent.md,这样可以全局生效但是真存不了太多,塞多了模型就开始阿巴阿巴了。方法二就是存到备忘录,然后用快捷键唤醒复制粘贴,缺点就是贴到对话框之后还要删删改改的。 这个问题困扰了我蛮久的。 问题不在存储,每次都是到了要用的那一秒,我根本就没有想起来自己存过什么,还是要打开备份重新过一遍。要不就是发出去了才想起来,早知道加上某个提示语就不会聊成这样了。 转折发生在我用Matt Poc
这两年大模型圈有一条几乎没人怀疑的信条,Scaling Law。
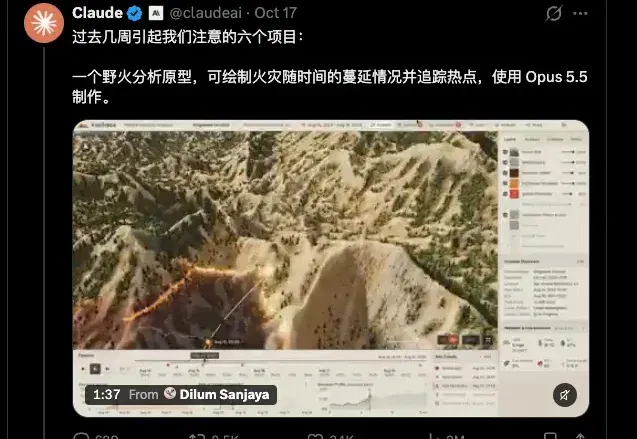
上周末,Claude官方在X上发了一条帖子,分享了在过去几周里,引起他们关注的6个创意项目。
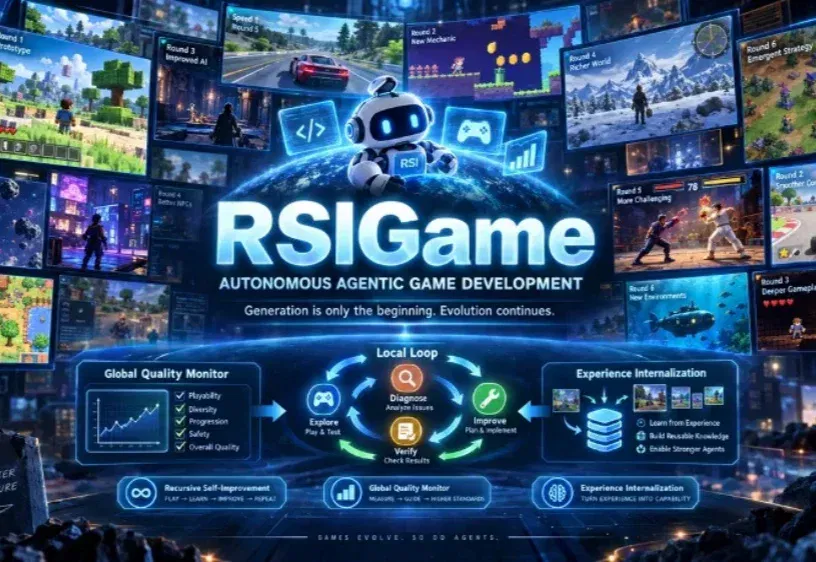
现在的大模型,已经越来越擅长从自然语言直接生成一个可以运行的游戏。
近期,六角未来沿着 Physical Coding 的思路,进一步构建了 HexaShell-Preview。根据官方评测结果,在 RoboDojo 全部 42 项任务上,HexaShell-Preview 取得了 46.9% 的成功率、53.2 的进度得分,成功率高出第二名 7.5 个百分点,领跑 RoboDojo-Agent 榜单。
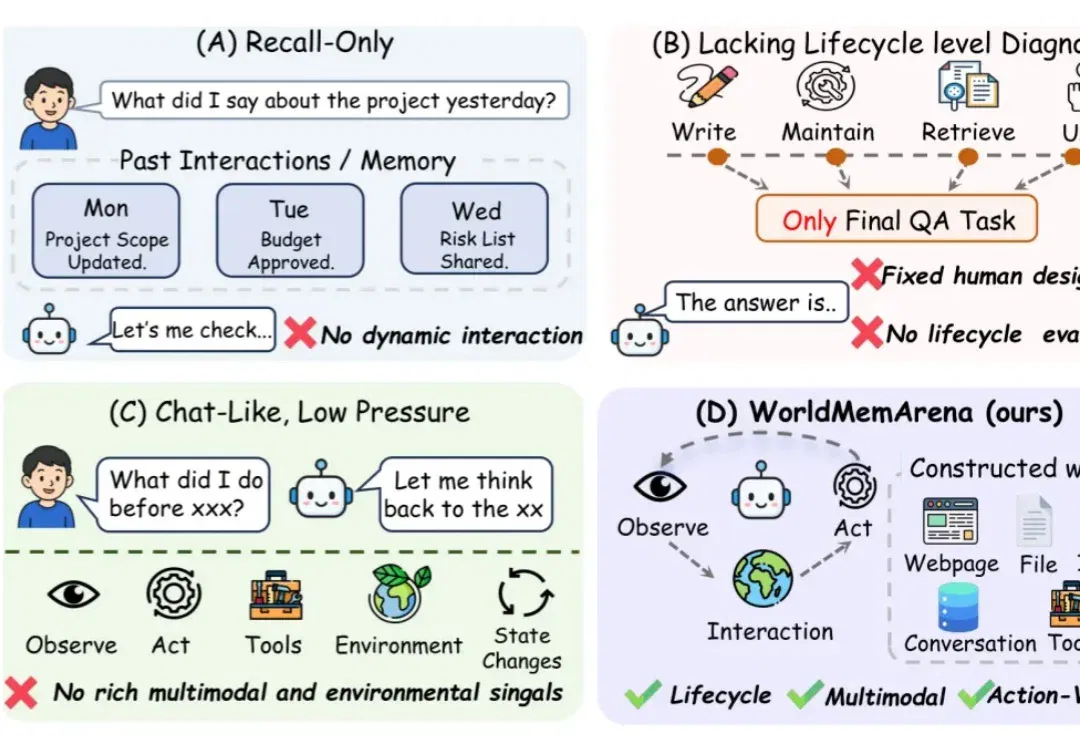
团队盯住的是一个很实际的问题:Agent 明明保存了项目计划,预算更新后却仍按旧版本行动;看过环境截图,下一步又忽略了画面里已改变的状态。它究竟是没记下来、没及时更新,还是找到了证据却没用上?
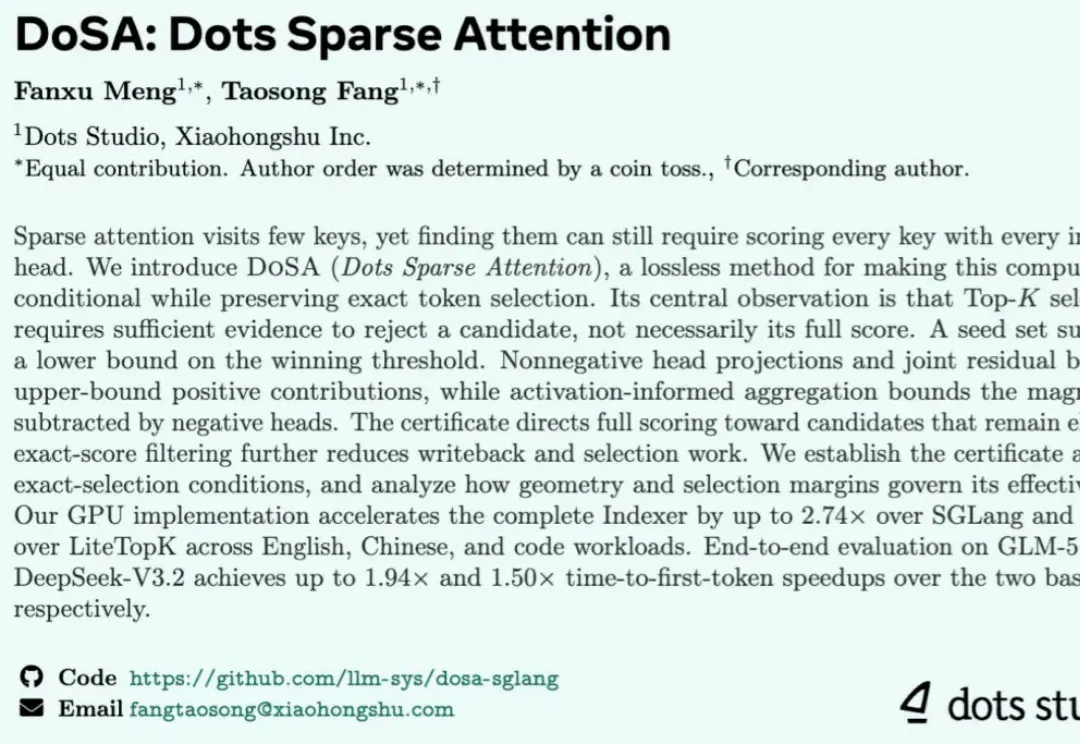
稀疏注意力减少了主注意力的计算量,但负责筛选 token 的索引器仍可能成为长上下文推理的瓶颈。小红书 Dots 团队自研的 DoSA 利用分数上下界,在保持原始 Top-K 选择结果的前提下加速索引器,并在测试中提前过滤了约 97% 的候选。
AI 制药的故事,终于从计算机里的分子结构,走到了实验室的试管里……
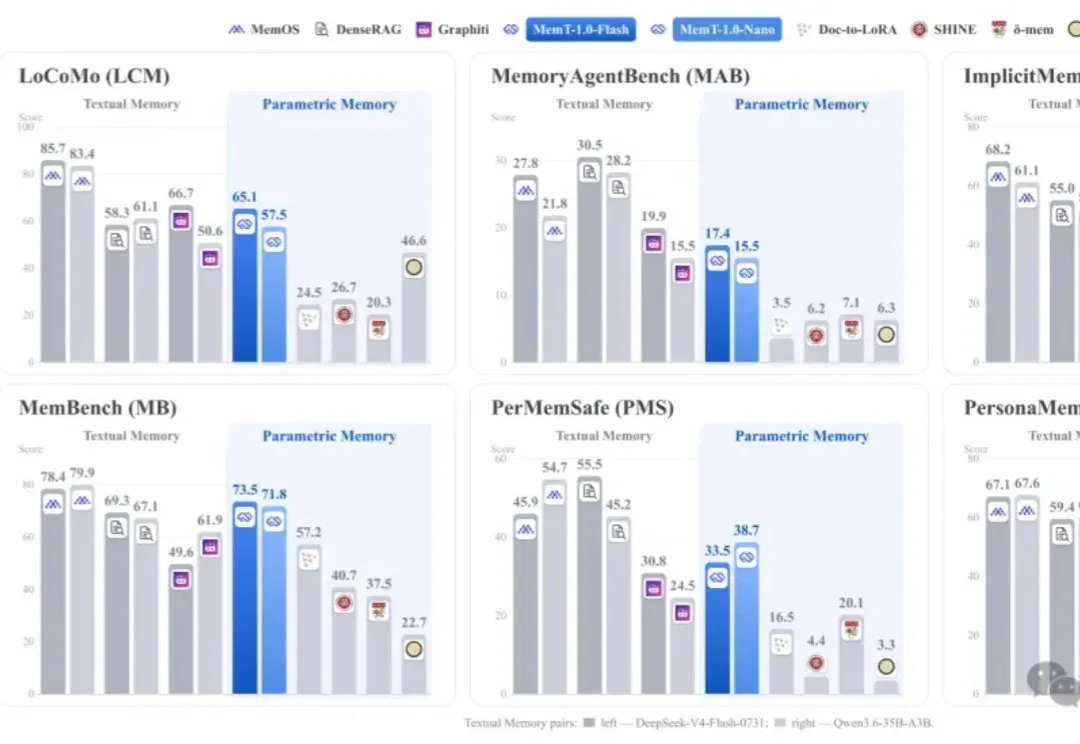
AI圈,最近集体盯上了三个字母:RSI。
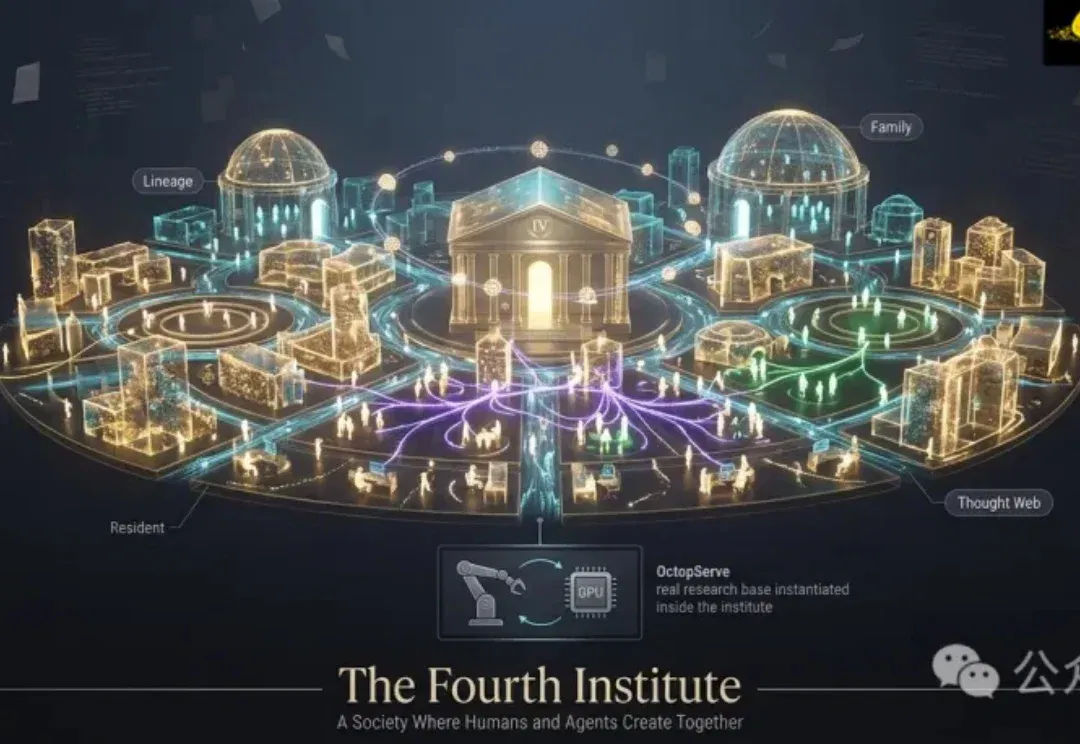
「全球只有大约5,000人,真正见识过顶尖AI的能力。」这是Andrej Karpathy近日分享的一个观察。他说,只有站在漏斗顶端的那一小撮研究者,才能看到数千个AI Agent长时间协作、昼夜不停地做科研。
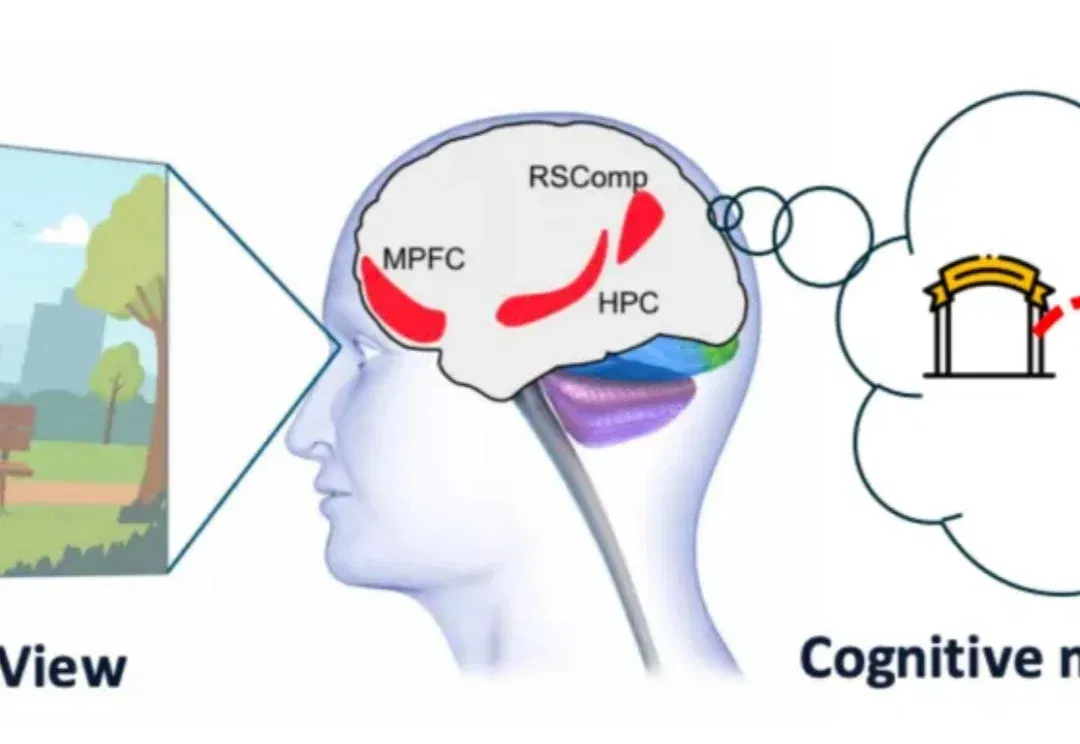
看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?
上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:
近日,由清华大学、原力灵机与极寰时代联合研发的世界动作模型LoopWAM,登顶真机评测榜单RoboChallenge Table30 V2,成功率与过程分双双位列榜首,成绩超过VLA-DM0.5等同期方案。同时,LoopWAM在仿真榜单RoboTwin 2.0和RoboCasa365上同样取得SOTA表现。
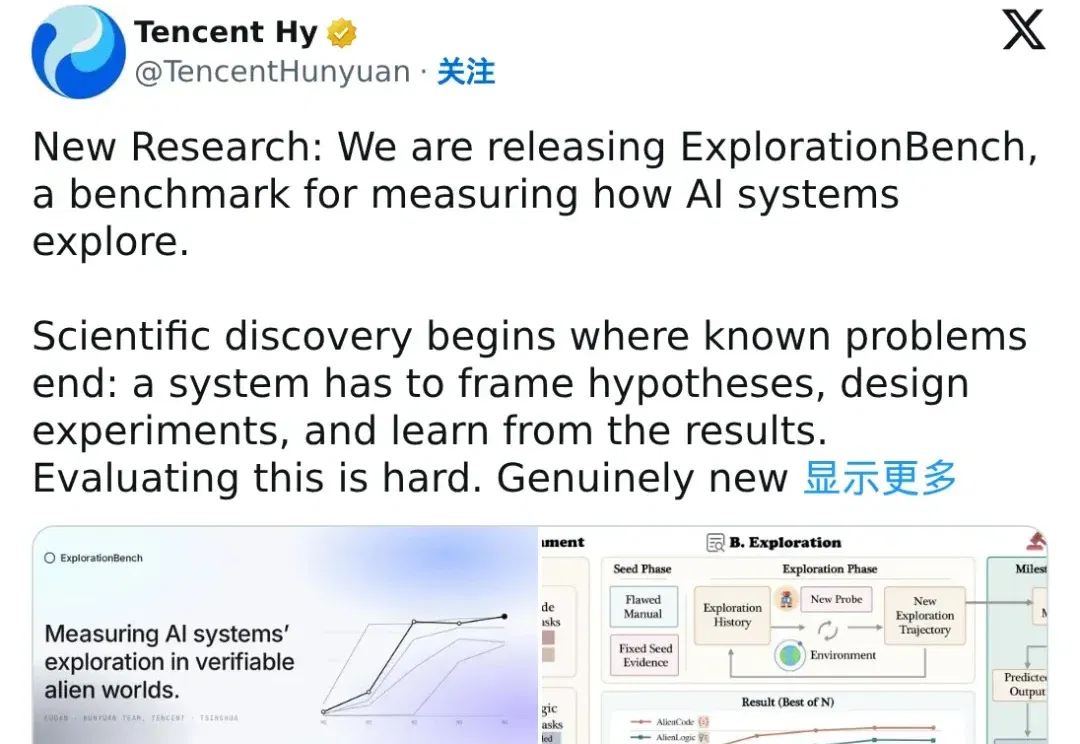
近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。
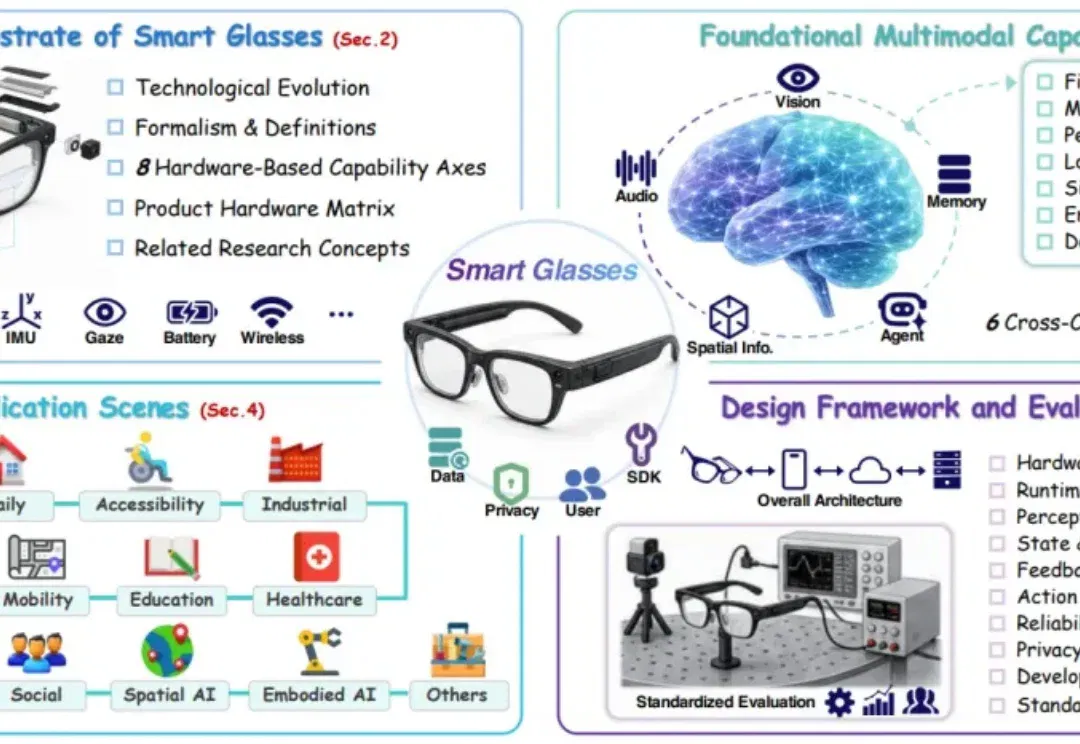
当我们谈论智能眼镜时,许多人的第一反应仍是:它能不能拍照、放歌、导航,或者它就像一个戴在头上的语音助手?
Agent在真实任务中出错,工程师的第一反应往往是给Harness“打补丁”:加一条防错提示词、接入一个新工具、挂一套Skills,或者增加历史摘要和执行检查。这套负责协调模型调用、工具执行与上下文管理的外层系统,就是Agent Harness。
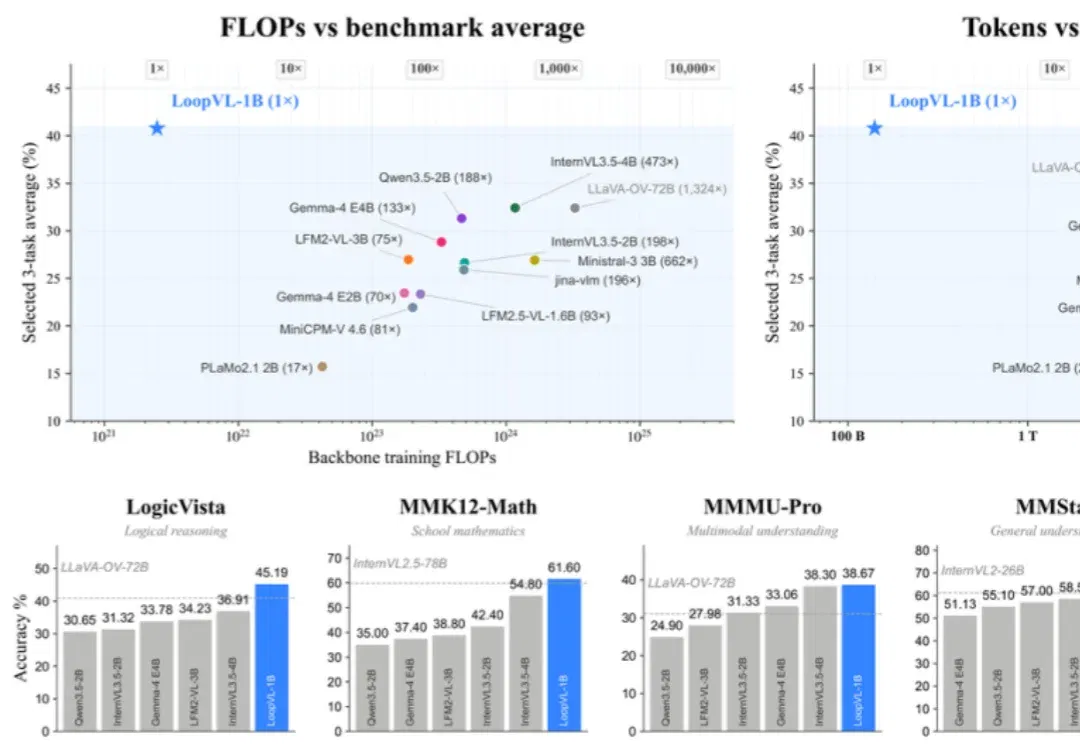
近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?
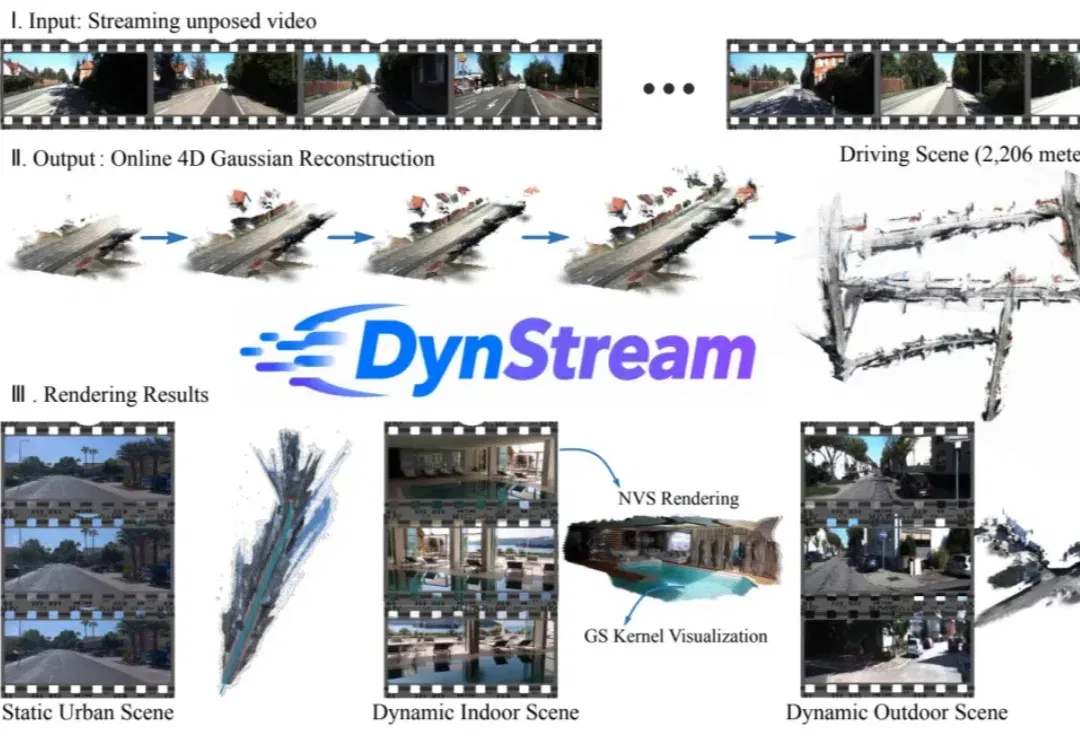
随手拍一段街景,镜头在移动,行人在穿行,街道上的车也在开。如果要边拍边重建这个变化的三维场景,麻烦就来了:未来画面还没到,如何分清哪些变化来自相机移动,哪些来自物体运动?随着镜头不断向前,如何将前一分钟重建的街道与后一分钟看到的路口准确拼接,避免场景错位或动态物体留下重影?当视频源源不断地输入时,系统又如何避免重复计算,让重建始终跟得上拍摄速度?
Claude,竟然排在最后? PhAI Labs 最新公布了一项 AI 研究能力对照,结合后续发表的科学文献,考察不同模型提出的研究假设能否为未来的研究思路与探索方向提供启发。报告所列的 Claude Opus 5 组对应比例为 2.3%,排在图中五个模型组的末位。GPT 组为 2.5%,GLM 为 2.8%,DeepSeek 为 5.4%。 排在最前面的,是 DiscoveryRSI:6.3%,约为 GPT 组的 2.5 倍、Claude 组的 2.7 倍。 图 1|五个模型组对未来研究的启发:DiscoveryRSI 总体比例为 6.3%。 这项比较观察的是:AI 提出的研究假设,能否在后
Join the conversation
Read how to join the community. No sign-in is required to read articles.