游戏开发也能自我进化?RSIGame让AI自主试玩、修复与迭代,27B模型组合超GPT-5.5一次生成
现在的大模型,已经越来越擅长从自然语言直接生成一个可以运行的游戏。
现在的大模型,已经越来越擅长从自然语言直接生成一个可以运行的游戏。
但是,“生成出来” 并不等于 “开发完成”。
一个能够运行的游戏,也可能存在大量问题:角色攻击没有反馈、敌人行为单一、关卡缺乏变化,甚至某些核心玩法根本无法完成。
而真正的游戏开发是一个长期过程:开发者需要不断试玩当前版本,发现 bug、缺失机制和体验问题,判断下一步最值得优化什么,再修改、验证,并继续扩展新的玩法和内容。
对于 AI Agent 来说,长程开发迭代比一次性生成难得多。
传统 coding benchmark 通常有比较明确的 pass/fail signal:代码能否通过测试、任务是否完成。但游戏质量并没有这样简单的判断标准。一个游戏可能没有明显 bug,却依然缺少玩法深度、视觉表现和内容完整性。
更重要的是,Agent 不仅需要知道怎么修改游戏,还需要自主判断下一步最值得改什么,以及什么时候不应该继续修改。例如,一个游戏当前已经可以正常通关,那么下一步应该修复潜在 bug、改善战斗反馈,还是增加新的游戏机制?如果连续多轮修改都没有明显提升,是否应该停止当前方向,转而探索新的玩法?这些问题无法简单依靠预先编写的单元测试来解决。
为了解决这个问题,来自UC San Diego、ByteDance 和 Carnegie Mellon University 的研究团队提出了 RSIGame:Autonomous Agentic Game Development with Recursive Self-Improvement,尝试把游戏开发从 “一次生成” 推进为一个真正的 Recursive Self-Improvement(RSI) 过程:让 Agent 不只是生成游戏,而是能够围绕自己创造出来的游戏持续探索、诊断、改进、验证,并决定后续的开发方向。
而且,这种自我改进不只发生在游戏本身。研究团队进一步发现,Agent 在开发过程中积累的经验,还可以反过来训练底层模型,让模型下一次生成游戏时就做得更好。这意味着,游戏开发不仅可以成为一个持续改进作品的过程,也可以成为 AI 积累经验、提升自身开发能力的过程。
实验结果显示,RSIGame 能够显著提升不同模型生成的游戏质量。以 GPT-5.5 生成的游戏为起点,经过多轮自主开发后,游戏质量评分从 50.26 提升至 64.53。并且,研究团队还将游戏开发过程本身转化为训练数据,积累了 4,003 轮游戏改进记录,其中 2,013 轮经过独立验证,并结合游戏生成与规划轨迹训练底层模型,进一步实现模型参数本身的自进化。最终,经过开发经验训练的27B 模型配合 RSIGame,游戏质量评分达到 61.38,超过 GPT-5.5 一次生成的 50.26。
这说明,通过经验学习与长期自主开发相结合,较小的模型同样能够实现更高质量的游戏开发。这也揭示了 RSIGame 的两层自我改进:一方面,让游戏在持续开发中不断完善;另一方面,让 AI 从开发经验中学习,进一步提升自身的游戏生成与开发能力。
- 论文地址:https://arxiv.org/abs/2609.39045
- 代码链接:https://github.com/WenyiWU0111/RSIGame
- 项目主页 / Playable Demos:https://huggingface.co/spaces/RSIGame/rsigame-page
- Hugging Face:https://huggingface.co/papers/2609.39045
从 “会生成游戏” 到 “会开发游戏”
为了实现这一目标,研究团队设计了两个相互配合的闭环:Local Loop 负责自主发现和解决具体问题,Global Loop 则负责评估长期开发效果、控制开发方向,避免无效迭代和质量退化。
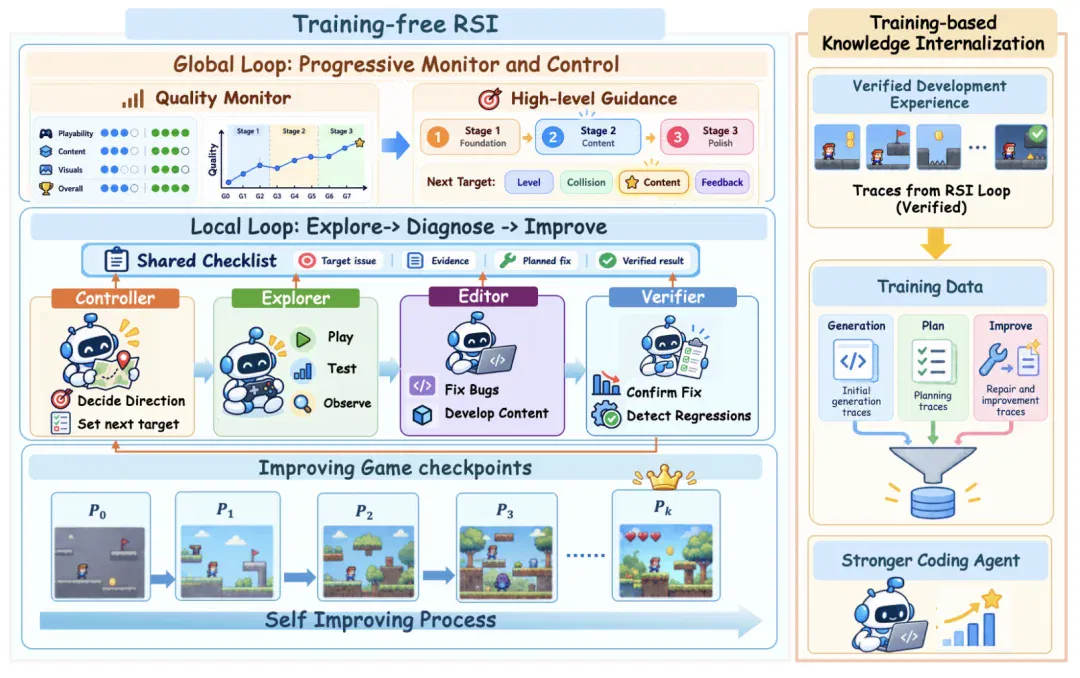
图 1: RSIGame 整体框架:自主探索、修改验证与全局质量控制的双层闭环
Local Loop:自主发现问题,并验证每一次修改
Local Loop 解决的是一个直接的问题:“这一轮,游戏最值得改进的地方是什么?”
与传统方法依赖预先给定的修改目标不同,RSIGame 会让 Agent 主动进入可执行的游戏环境,通过真实交互寻找新的改进空间。
系统中的不同 Agent 承担不同角色。首先,Controller 根据当前开发进度和已有证据,判断下一轮应该优先探索或解决什么问题。随后,Explorer 实际操作游戏,通过键盘、鼠标等交互方式进行针对性试玩,观察游戏中的行为、反馈和潜在缺陷。这些发现不会直接变成未经验证的修改指令,而是被整理进持续更新的 development checklist,记录发现的问题、开发优先级、已经解决的目标以及可能出现的回归问题。
接下来,Editor 根据观察到的证据修改游戏代码和资源。最后,独立的 Verifier 再次与游戏交互,检查修改是否真正解决了目标问题,以及是否引入了新的错误。例如,假设 Agent 发现游戏中的攻击按钮能够正常响应,但敌人并没有受到伤害。系统不会仅仅因为代码中已经添加了伤害处理逻辑,就认为问题已经解决。Verifier 需要通过实际交互,确认攻击能够触发预期的战斗效果。修改代码只是开发动作,验证后的行为改善才是有效进展。
同时,Local Loop 并不局限于修复已有的 bug。当游戏的基础机制已经能够正常运行时,Agent 也可以继续探索新的 improvement opportunities,例如更丰富的敌人行为、交互反馈、关卡内容和玩法机制。这样,游戏开发就不再是机械地执行一份固定任务清单,而是一个根据真实交互不断发现新目标、解决新问题的自我进化过程。
Global Loop:不是一直修改,而是判断是否真的在进步
仅有 Local Loop 显然不够 -- 局部修改成功,并不意味着整个游戏在长期开发中持续变好。
因此,RSIGame 进一步引入 Global Quality Monitor,从更长的时间尺度评估游戏的整体进展。与只检查单轮修改不同,Global Loop 会跨多个开发阶段比较游戏质量,跟踪已经取得的提升,并保留历史最佳 checkpoint。这意味着,即使后续某轮修改导致游戏质量退化,系统也能够避免把退化后的版本直接作为新一轮的开始。
此外,Global Loop 还会检测开发过程是否逐渐趋于饱和。如果连续多轮修改已经难以带来明显收益,继续投入计算资源可能只会增加成本,甚至破坏已有成果。这时,系统可以结束当前开发阶段,或通过新的高层开发指导进入下一阶段,在已有游戏的基础上继续拓展新的开发方向。
由此,RSIGame 不再单纯追求 “更多轮修改”,而是希望 Agent 能够回答三个更关键的问题:哪里还有值得改进的空间?当前修改是否真正带来了提升?什么时候应该停止当前方向,转向新的开发目标?
同一游戏的前后对比
格斗游戏|从简陋的战斗原型到完整的对战体验
赛车游戏|从基础驾驶场景到更丰富的竞速体验
射击游戏|从基础射击原型到更完整的战斗关卡
多跑几轮,并不会自然带来更好的游戏
为了验证这种长期自主开发机制是否有效,研究团队在GameCraft-Bench上进行了系统实验。实验覆盖140 个任务、15 类游戏、Godot 和 Phaser 两种游戏引擎,以及 5 种初始生成设置,对不同模型生成的游戏进行后续自主开发。游戏质量通过 GameCraft-Bench 的评测协议衡量,综合考察游戏机制、交互行为和内容深度等维度。以下 Overall 分数均为该 benchmark 下的质量评分。
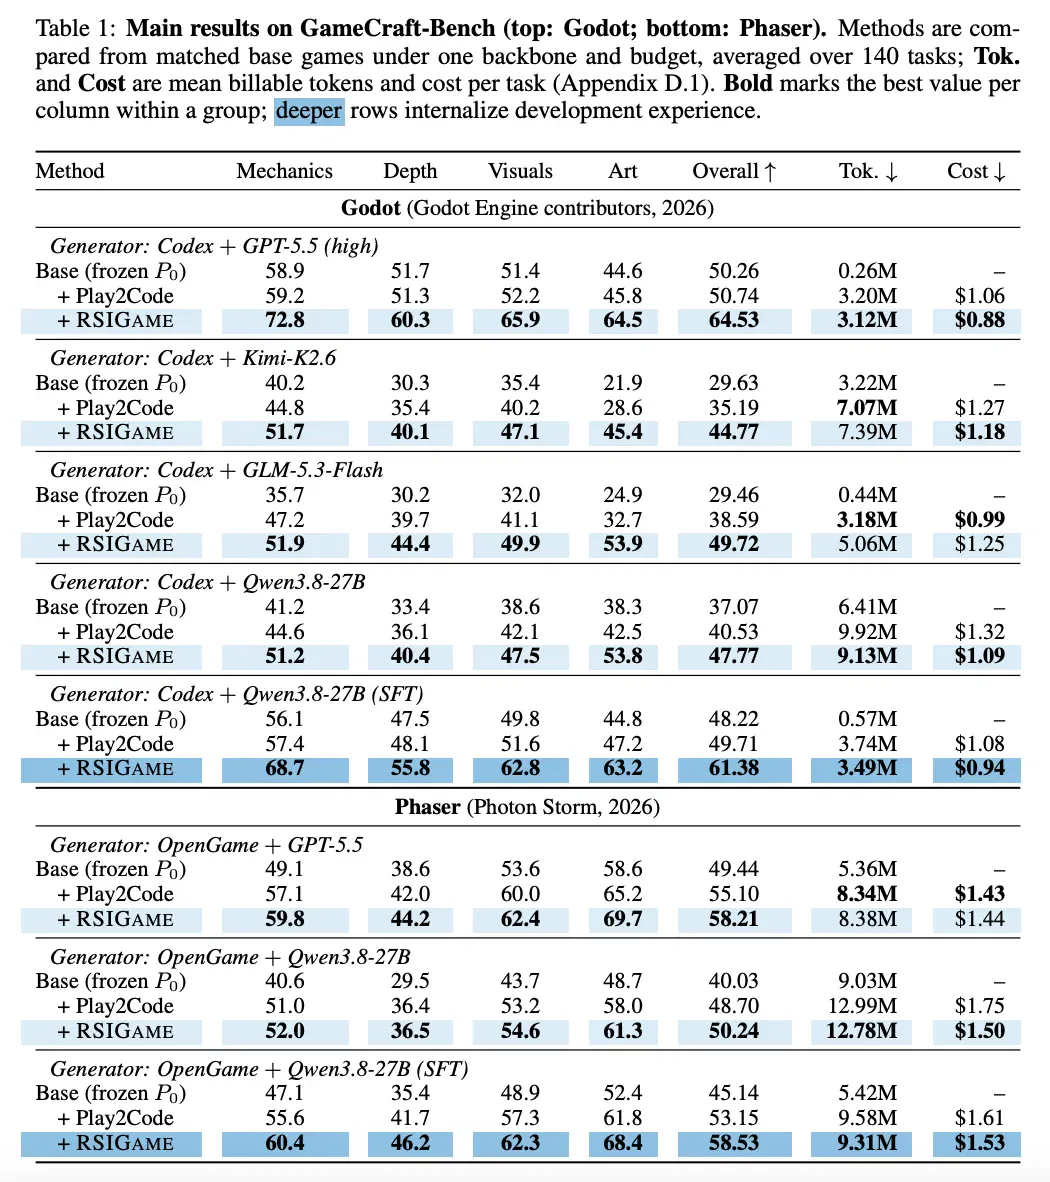
表 1: 不同模型、不同游戏引擎下,RSIGame 均能显著提升游戏质量
结果发现,RSIGame 在不同初始生成模型上都能持续改善游戏质量,而普通 iterative development 往往会较早遭遇瓶颈。在 Godot 引擎上,相比各自未经开发的初始游戏,RSIGame 为所有 generator 带来了10.7~20.3 分的显著整体提升。即使是在相同的开发预算下,相比迭代开发基线 Play2Code,RSIGame 也取得了7.2~13.8 分的优势。
值得注意的是,这种提升不仅存在于较弱的初始生成模型上。即使使用更强的 GPT-5.5 进行初始化,普通 iterative development 也很难继续带来明显收益,而 RSIGame 仍能够将 Overall 从50.26 提升至 64.53。这说明,强大的初始生成能力,并不能代替有效的长期开发机制。
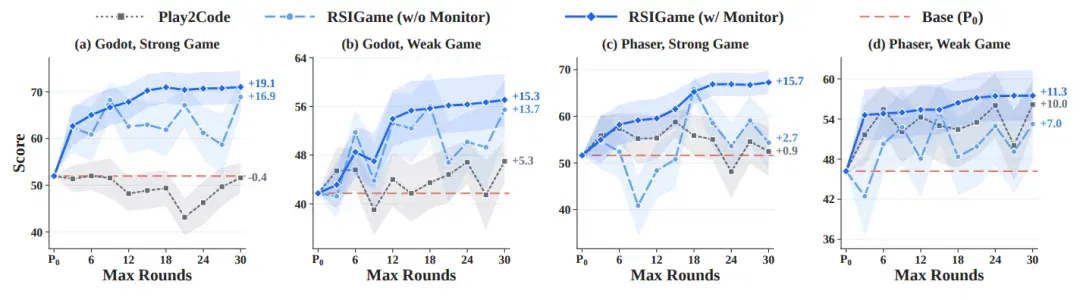
图 2: 开发轮数越多,游戏不一定越好:RSIGame 实现更稳定的持续提升
更进一步,研究团队分析了随着开发轮数增加,不同方法的游戏质量如何变化。结果显示,普通 iterative development 往往会较早进入平台期,部分设置甚至随着修改次数增加而发生退化。相比之下,RSIGame 能够在不同模型和游戏引擎上,更稳定地将额外的开发预算转化为质量提升。Global Quality Monitor 在其中发挥了重要作用:一方面,最佳 checkpoint 的保留机制能够避免后续修改抹掉此前的收益;另一方面,饱和检测机制可以减少低收益开发轮次,在更少的开发预算下获得接近长预算运行的结果。
这也揭示了一个重要结论:AI 自主开发的关键,不是让模型一直工作,而是让它知道什么样的工作真正有价值。
把 “游戏开发过程” 本身变成训练数据
RSIGame 的研究并没有停留在 test-time 的自主迭代上。团队进一步提出了一个问题:如果 Agent 能够在游戏开发中不断发现问题、解决问题,那么这些经过验证的开发经验,能不能反过来提升模型自身的能力?
传统代码生成训练通常关注输入需求与最终代码之间的对应关系。但在真实的游戏开发中,最终代码只体现了结果,无法完整反映开发过程。比如说,一个游戏为什么需要修改?Agent 如何发现隐藏问题?如何决定优先级?哪些代码修改真正有效,哪些尝试失败了?这些中间过程同样包含重要的开发知识。
因此,研究团队构建了一个大规模的 game-development experience corpus,保留游戏从初始生成到多轮开发的完整过程。其中包括:
- 2,213 条游戏生成轨迹;
- 2,108 条规划轨迹;
- 4,003 轮游戏改进记录;
- 其中 2,013 轮改进经过独立验证,确认完成了对应开发目标。
与只收集最终游戏代码的数据不同,这个数据集保留了模型如何规划、如何调用工具、如何诊断问题、如何修改,以及哪些修改最终通过了真实交互验证。
其中,经过验证的 improvement experience 尤其重要。因为它不仅告诉模型 “正确代码是什么”,还提供了从问题发现到有效修复的过程性经验。
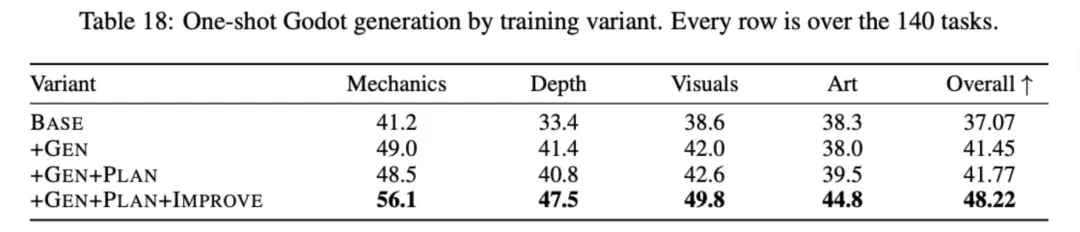
表 2: 开发经验训练消融:验证过的改进经验让 27B 模型从 37.07 分提升至 48.22 分
研究团队随后将这些开发经验用于 Qwen3.8-27B 的监督微调,分析不同类型的经验数据分别带来了多大帮助。结果十分明显。在 Godot 上,原始 Qwen3.8-27B 的 one-shot 游戏生成 Overall 为37.07。仅加入游戏生成轨迹后,分数提高到41.45;进一步加入规划轨迹后,达到41.77。而当经过验证的游戏改进经验也被加入训练后,分数进一步提升至48.22。其中,游戏机制与玩法深度相关指标的改善尤其明显。
也就是说,模型不再只是学习如何从需求直接生成代码,而是能够从大量经过验证的开发过程里,学习如何构建更完整的游戏机制与交互行为。
开发经验不仅改善了当前游戏,还被转化为模型下一次生成游戏时可以直接利用的能力。
27B 模型配合自主开发,超过 GPT-5.5 一次生成
当经验训练与 RSIGame 的自主开发能力结合,研究团队观察到了更进一步的效果。在 Godot 上,经过开发经验训练的 Qwen3.8-27B,one-shot Overall 达到48.22,已经接近 Codex + GPT-5.5 一次生成的50.26。如果继续通过 RSIGame 进行多轮自主开发,Qwen3.8-27B ,将最终游戏质量评分进一步达到61.38。
需要强调的是,这并不意味着 27B 模型单凭自身能力全面超过 GPT-5.5,而是说明:通过开发经验训练,再配合自主迭代框架,较小的模型组合也能够生成质量评分高于强模型一次性生成结果的游戏。
而且,经验训练还带来了生成阶段的效率改善。在对应实验设置中,Qwen 的 one-shot 游戏生成 token 消耗从6.41M 降至 0.57M,约为原来的十一分之一。类似的趋势也出现在 Phaser 引擎上:经过经验训练的 Qwen3.8-27B 配合 RSIGame,最终 Overall 达到58.53,高于 GPT-5.5 one-shot 的49.44。
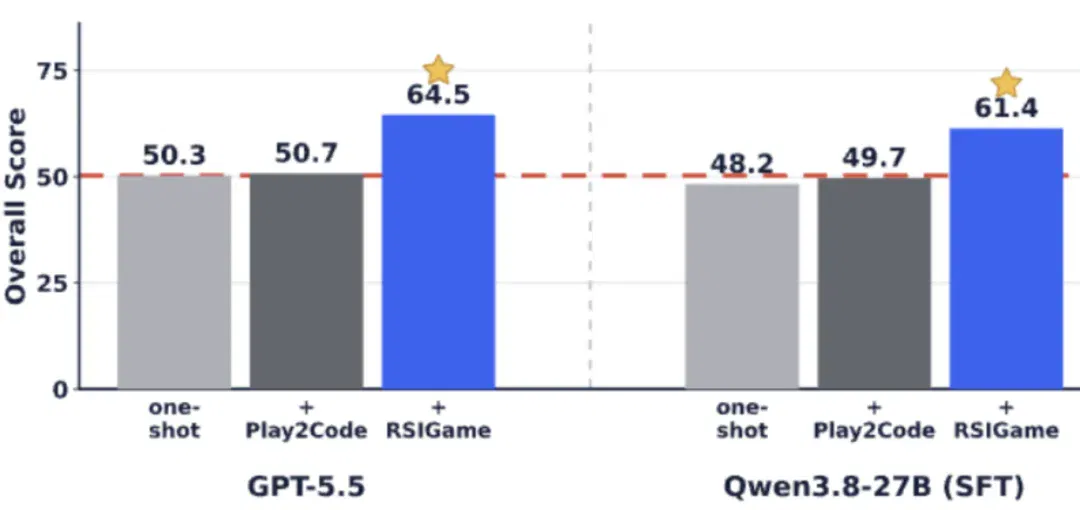
图 3: 27B 模型结合经验学习与自主开发,在游戏质量评分上超越 GPT-5.5 一次生成
这些结果揭示了 RSIGame 更深一层的设计思路:两个相互促进的自我改进过程。
第一个是游戏本身的 Self-Improvement。Agent 通过主动探索、修改和验证,让当前游戏不断完善。
第二个是开发能力的 Self-Improvement。Agent 在开发过程中产生的经验被收集、筛选并重新用于训练,使模型能够在未来更高效地生成和开发游戏。这两个过程结合起来,使得 AI 不仅能够通过投入更多开发轮次改善当前作品,也能够通过积累开发经验提升未来的起点。
从 “一次性生成”,走向真正的长期自主开发
RSIGame 最终想探索的,并不只是如何让 AI 生成更多、更好的游戏。
它关注的是一个更普遍的 Agent 问题:AI 能否从一次性生成作品,走向真正的长期自主开发?
过去的生成式 AI 主要关注如何根据输入需求产出对应的结果。而在更加开放、复杂的开发任务中,生成结果往往只是整个过程的开始。一个真正能够自主开发的 Agent,需要持续理解当前作品的状态,主动寻找新的改进机会,根据环境反馈判断哪些修改有效,并在长期迭代中保留已经获得的成果。
RSIGame 在游戏这一可执行、可交互的复杂环境中,对这种能力进行了系统探索。实验表明,合理组织探索、修改、验证和全局质量控制,可以让 AI 在多轮开发中持续改善游戏质量;而将这些经过验证的开发经验重新用于训练,又能进一步提升底层模型的生成能力。
当然,目前的结果仍然建立在特定游戏引擎、开发环境和自动评测协议之上。要让 Agent 真正接近人类游戏开发者,在玩法创意、玩家体验理解和复杂长期设计等方面,仍有进一步探索的空间。
但 RSIGame 展示了一种值得关注的方向:未来的 AI Agent 或许不再只是一次性完成任务,而是能够持续改进自己创造的作品,并从每一次经过验证的改进中积累新的能力。
作者介绍
Wenyi Wu,加州大学圣地亚哥分校(UC San Diego)数据科学博士生,来自 Biwei Huang 教授领导的研究团队。团队主要研究因果学习、世界模型与自主智能体,探索 AI 的自主决策、环境交互与持续学习能力。近期,团队与字节跳动(ByteDance)、卡内基梅隆大学(CMU)的研究人员合作开展 RSIGame 研究,探索 AI Agent 如何实现游戏的自主开发与递归自我改进。
文章来自于"机器之心",作者 "Wenyi Wu"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
把 Gemini 和 GPT 放到《我的世界》当教练,谁能看懂机器人的微操? (opens in a new tab)
Gemini 领跑,GPT表现平平,国立清华、英伟达提出双奖励孪生网络,告别算力焦虑。
字节发布通用游戏智能体!5000亿token训练,用鼠标键盘吊打GPT-5! (opens in a new tab)
Game-TARS基于统一、可扩展的键盘—鼠标动作空间训练,可在操作系统、网页与模拟环境中进行大规模预训练。依托超5000亿标注量级的多模态训练数据,结合稀疏推理(Sparse-Thinking) 与衰减持续损失(decaying continual loss),大幅提升了智能体的可扩展性和泛化性。
7个AI玩狼人杀,GPT-5获断崖式MVP,Kimi手段激进 (opens in a new tab)
一群AI玩狼人杀,GPT-5断崖式领先,胜率达到了惊人的96.7%。 OpenAI的总裁格雷格·布罗克曼转发了这样的一个基准测试:让7个强大的LLMs,包括开源和闭源,玩了210场完整的狼人杀。
27小时通关《我的世界》!4个Gemini Agent累计阵亡605次,烧掉520美元 (opens in a new tab)
Google Deepmind让4个Gemini 4 Argon Agent在随机《我的世界》地图中自主协作27小时,累计阵亡605次、耗费约520美元后击败末影龙,展示其长程任务中的分工、纠错与恢复能力。
四大顶级AI对决《文明VI》!Claude「核平」法国,结果还是输了 (opens in a new tab)
就在最近,英国前首相府数据科学家Liam Wilkinson,花一个周末搭了76个MCP工具,把Claude、GPT、Gemini等四个顶尖模型扔进了《文明VI》。结果,23场对局打完,其中一个AI造了核弹炸了法国——然后输了。