深度拆解沐曦MXMACA软件栈功能,算力自主+生态兼容,破解国产GPU落地难题
近日,刚刚 IPO 的国产 GPU 公司沐曦股份,完成了自上市后的首个重大技术发布。
近日,刚刚 IPO 的国产 GPU 公司沐曦股份,完成了自上市后的首个重大技术发布。
该公司旗下的 MXMACA 软件栈(MACA)正式发布了全新版本 3.3.0.X,沐曦发布了一份 23 页的技术报告,机器之心围绕该报告对 MACA 进行解读。
在全自主硬件体系的支撑下,沐曦已经构建起「全栈软件」体系,其对于提升计算引擎的效率起到了关键作用。同时,新一代 MACA 宣告了沐曦软件生态的一次重要跨越,它的核心理念,是如何让国产 GPU 真正「用起来」。
GPU 生态适配的「万能接口」
MACA(MetaX Accelerated Computing Architecture)被定义为「异构计算软件栈核心计算平台、引擎、运维工具和规范化操作范本」,内置了全套自研工具链,涵盖编译器、性能分析工具、格式转换组件等,可实现多语言支持、算子自动优化与跨框架平滑适配。
它面向沐曦的曦云 C 系列、曦思 N 系列 GPU 研发,其定位是连接沐曦自研 GPU 硬件与上层应用生态的关键纽带。
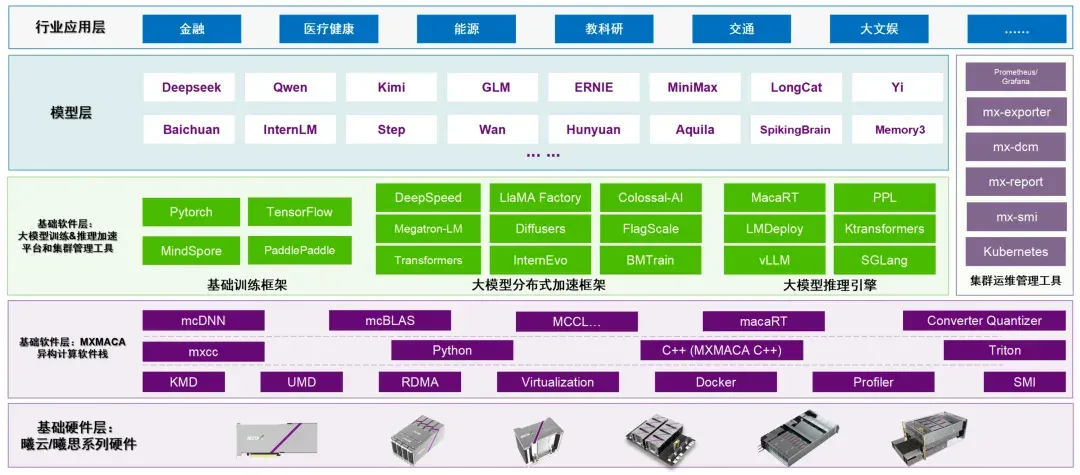
MACA 承担着连接硬件算力单元与上层应用生态的纽带作用。据介绍,它覆盖了 AI 芯片工作流程的底层驱动、用户态接口、编译器、算子适配、训练框架、推理框架、行业场景优化等全链路能力。
在芯片行业,硬件决定算力基础,而软件栈则决定了算力能否被有效释放。长期以来,国产 GPU 落地面临的最大挑战并非纯粹的性能,而是生态兼容问题 ——AI 开发者早已习惯在英伟达的 CUDA 生态中开发新技术、构建应用,迁移到新的硬件上意味着高昂的迁移成本。
MACA 3.3.0.X 直击这一痛点,它是一套「生态强化版」软件栈,聚焦场景的深度适配,涵盖底层基础能力的迭代与主流 AI 框架、大模型训练推理、搜索、广告、推荐、科学计算等多维度生态适配,其核心逻辑是构建一个「万能接口」,让现有生态能够近乎无缝地迁移到沐曦平台上。
具体有多万能?技术报告显示,沐曦团队对 GitHub 上大量 CUDA 项目进行了适配测试。他们筛选了 4490 个「含 CUDA 关键字」的活跃代码仓库进行验证,按应用领域包括 AI 模型 / 应用、高性能并行计算、气象模拟、计算化学等场景。
测试结果显示,4173 个项目可以直接适配运行,成功率高达 92.94%。仅有 260 个项目需要微小调整,占比不足 6%,且修改主要涉及编译配置优化,而非核心业务逻辑。
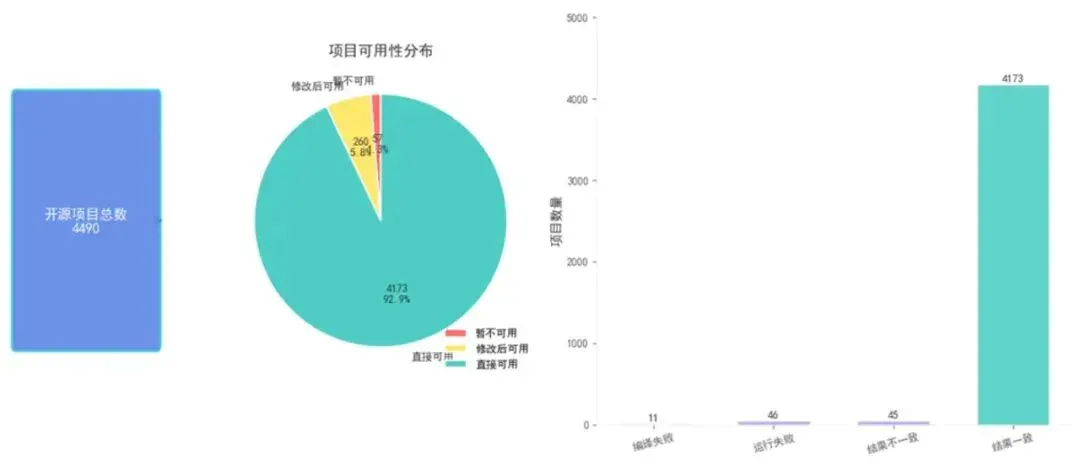
这意味着,几乎任何现有的 CUDA 项目都可以近乎「开箱即用」地迁移到沐曦平台上,目前在市面上,还没有第二家能够做到。
在 MACA 的这一通适配之后,GitHub 上海量的 AI、数据处理、科学计算应用工具,可以快速适配在国产异构计算平台上。对于开发者而言,这就意味着面对国产 AI 硬件体系时,学习成本和迁移工作量可以大幅降低。
框架兼容
拥抱主流 AI 开发生态
除了能够无缝迁移已有的项目工作,新版本 MACA 也强调了对于 AI 框架兼容的特性,它能够帮助开发者构建和探索新技术。
在 AI 开发领域,框架兼容能力决定了平台的可用性。MACA 3.3.0.X 版本完成了对 PyTorch 2.8 的深度适配,覆盖了全部 2650 个核心算子(其中 GPU 算子 2410 个)。涵盖从基本算术运算、线性代数操作、卷积 / 池化类算子、规约操作、随机采样、索引与切片快速傅里叶变换(FFT)、Attention 等所有关键算子类别。它支持多种数据形态,保障了算子能力的完整性与场景适配性。
除了 PyTorch,MACA 还兼容 TensorFlow、PaddlePaddle、JAX 等主流开源框架,以及 Megatron-LM、DeepSpeed 等大模型训练框架,在推理端支持 vLLM、SGLang、Transformers、KTransformer 等推理框架。
在操作系统方面,MACA 兼容了 Ubuntu、CentOS、RHEL、openEuler、Anolis OS 、银河麒麟等主流 Linux 发行版。它同时完整支持混合精度训练、分布式训练、torch.compile 编译优化与图模式任务下发的深度集成等关键特性。
简单来说,这一兼容性列表几乎涵盖了当前 AI 开发的所有主流工具链。技术报告中还特别强调,这种适配是「无需调整工程构建逻辑,即可实现现有模型的无缝使用」。
搭配性能分析与优化工具链,MACA 配合沐曦 GPU 在核心场景上的性能可以对标主流 GPU 水平。
MACA 不仅仅是一个兼容层,而是一个完整的软件栈。它包含了开发效率引擎层和垂直场景赋能层两大核心部分。
在开发效率引擎层,MACA 提供了一系列高性能算子库,如针对矩阵计算的 mcBLAS、针对深度神经网络的 mcDNN、针对注意力机制的 mcFlashAttention 等。
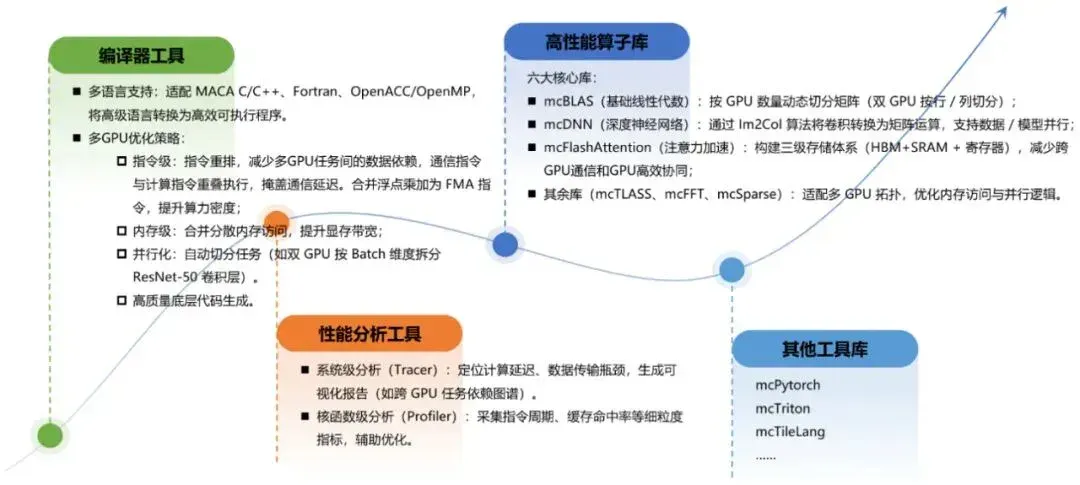
MACA 套件中开发效率引擎,其旨在降低异构开发门槛。
这些工具针对沐曦 GPU 的多卡拓扑进行了专门优化,编译器工具支持 MACA C/C++、Fortran 等语言,能将高级语言转化为高效的可执行程序。
在垂直场景赋能层,MACA 针对 AI 与科学计算两大方向,通过针对性的优化策略与框架适配解决需求。
其中在 AI 领域,MACA 的训练优化兼容 PyTorch、BMTrain 等框架,通过硬件流水线并行实现通信与计算重叠,优化分布式并行策略。推理优化则适配 ONNX Runtime、vLLM、SGLang 等框架,采用 INT8 量化、KVCache 跨卡管理提升长序列处理效率。
在科学计算领域,MACA 通过重构 MPI、BLAS 库提升内存带宽,定向移植 OpenFOAM、GROMACS 等科学计算框架,结合容器化部署方案,能够确保算力能高效支撑流体仿真、分子动力学等垂直场景。
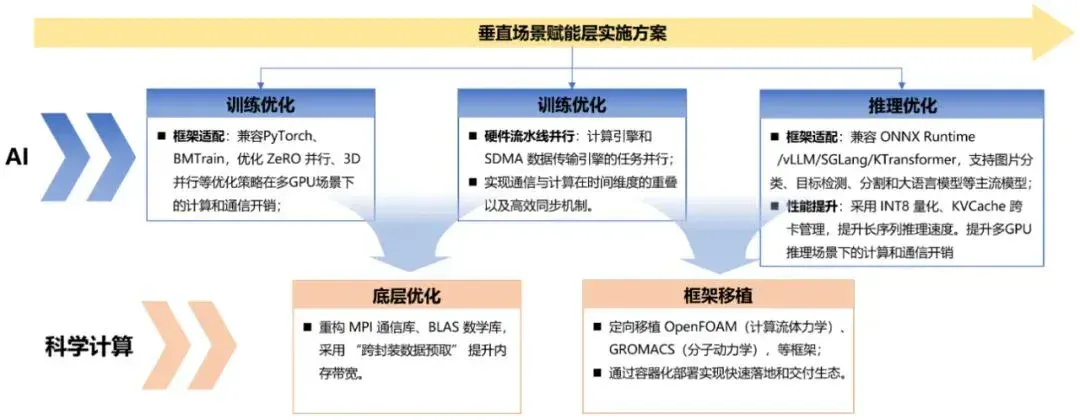
此外,MACA 的性能分析工具提供了系统级追踪和核函数指标采集功能,能够帮助开发者定位计算瓶颈。全栈工具链的完整性,使得开发者能够在沐曦平台上完成从开发到部署的全流程工作。
此种能力的背后,是沐曦构建的大模型训推一体化能力。
算力到生产力的转化
MACA-3.3.0.X 版本为开发者们构建起了一套全流程的一体化算力支撑底座,通过软硬件协同、核心算子优化以及分布式架构的升级,旨在实现训推效能的跨越式突破。
这一底座的基础是沐曦自研的 GPGPU,其高算力密度与高内存带宽确保了单卡能够高效处理千亿参数模型。通过自研的 MetaXLink 高速互连技术,沐曦在硬件层面构建了低时延、高带宽的分布式通信网络,使得算力供给扩展至万卡级集群,为 AI 大模型的超大规模分布式训练与推理奠定了基础。
在软件层面,MACA 构建起端到端的协同体系。其首要特点是极致的生态兼容性,除此之外,MACA 通过拓扑感知的 MCCL 高性能通信库和自研的编译器优化模块,能够智能地优化多机多卡的数据通信策略,实现算子自动融合、循环展开等编译级优化,深度挖掘出硬件底层潜力。
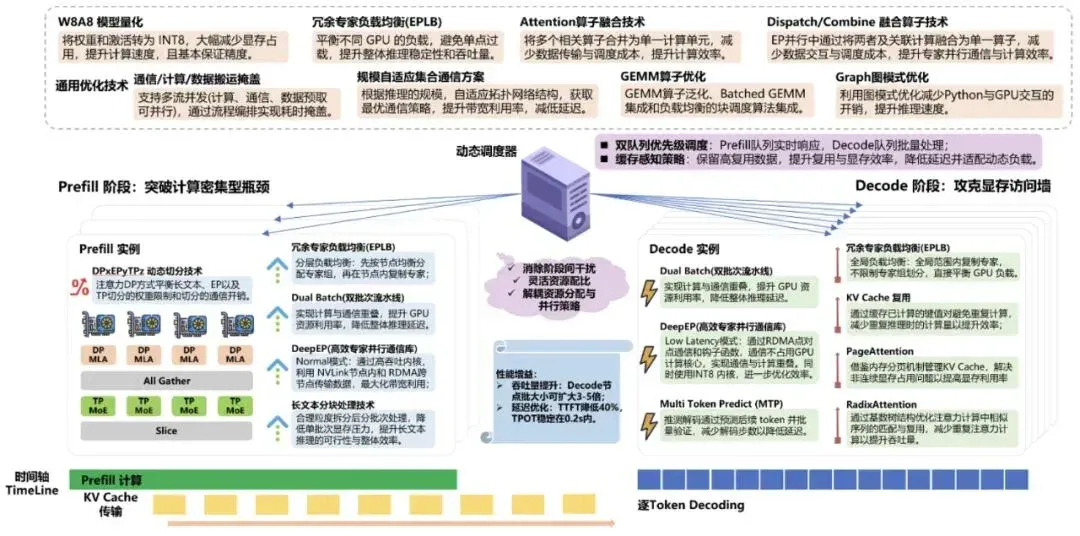
MACA 套件大模型推理优化技术。
一体化设计的重要优势,在于打破训练与推理之间的场景壁垒。MACA 支持模型训练后的轻量化转换与直接部署,无需二次适配。通过统一的模型格式与接口规范,它实现了「训练 - 微调 - 推理 - 部署」全流程链路贯通,大幅缩短了大模型从技术研发到业务落地的周期与成本。
在技术层面上,MACA-3.3.0.X 版本针对几个关键瓶颈进行了深度调优。
在关键算子上,MACA 针对 FlashAttention 优化,大幅减少了向 HBM 显存的数据搬运开销;通过对于分布式集合通信库的优化,MACA 将千卡集群的训练、推理线性度稳定在 95% 以上,专家并行效率提升了 15%;通过异步通信机制,还有通信 - 计算重叠优化,MACA 将数据传输任务与 GPU 计算任务解耦并行,缩短了端到端延迟,提升 GPU 利用率 15%-30%,解决了因等待数据通信而导致的芯片闲置问题。
在软件栈上层,沐曦进一步做了面向易用性和部署的优化:其深度支持 PyTorch 2.0 的 torch.compile 动态图编译,以最大化硬件利用率;针对推理场景打造轻量化引擎,优化批处理策略以同时降低延迟、提升吞吐;全面兼容容器化与云原生架构,支持企业级的大规模弹性部署与便捷运维。
MACA 全面兼容当前主流的大模型生态体系,无需代码修改即可开展训练、推理;针对大规模大模型训练场景,其工具链可以缩短训练周期,在分布式训练中展现出优异线性度,可以长周期无故障稳定运行;在推理时,MACA 针对主流大模型的深度优化降低了延迟,提升了吞吐量;与此同时,MACA 还具备从小规模调试到大规模训推的全场景平滑扩展能力。
实测数据表明,沐曦通过 MACA-3.3.0.X 构建的一体化算力底座在曦云 C 系列 GPU 上的训推效能已经展现了与国际旗舰 GPU 产品 A 正面竞争的实力。
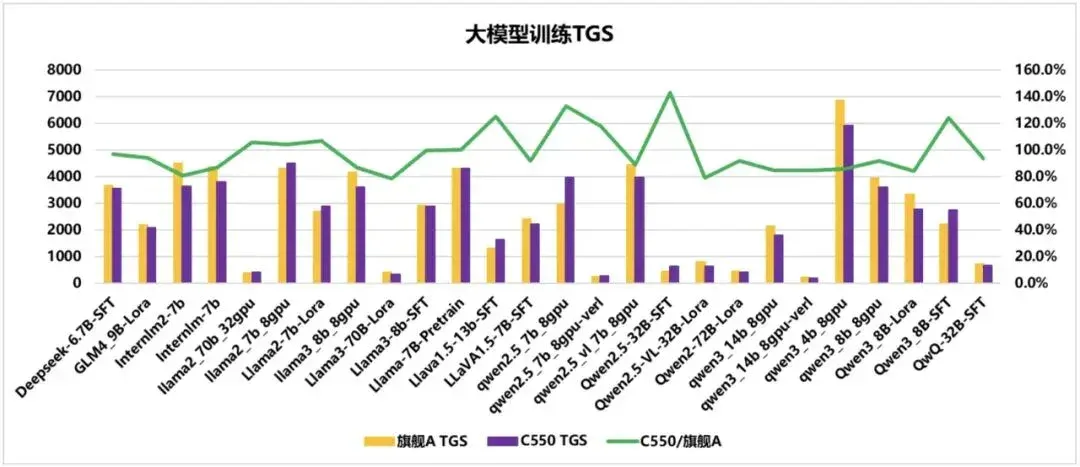
DeepSeek、GLM、InternLM、Llama、Qwen 等多系列大模型,在不同参数规模(如 7B、13B)及任务类型(SFT、Pretrain)下的训练 TGS 数据,包含「旗舰 A TGS」(黄色柱)、「C550 TGS」(紫色柱)及两者效率比值(绿色折线)。
MACA 不仅是一个技术平台,更是沐曦「1+6+X」战略的重要组成部分。在这一战略中,「1」代表数字算力底座,「6」代表对于六大核心行业的赋能,包括金融、医疗健康、能源、教科研、交通和大文娱等行业的 AI 场景应用及开源生态建设,「X」代表具身智能、低空经济等新兴行业。
技术报告详细介绍了 MACA 对于多个垂直场景的优化:
- 在搜广推场景,MACA 针对 TensorFlow/JAX 与 XLA 技术栈进行了深度协同适配。在部分模型中,沐曦平台的性能已达到甚至超过国际旗舰产品。
- 在传统小模型支持方面,MACA 提供了多模型格式兼容和底层计算优化,覆盖计算机视觉、自然语言处理及传统机器学习等核心场景。
- 在 AI for Science 领域,MACA 适配了 PaddleScience、WRF 数值模式等科学计算工具。
- 除此以外在材料、技术科学、天气模拟、药物研发等领域,MACA 对领域主流 AI 框架都进行了适配。
这种场景化优化能力,使得沐曦 GPU 不再仅仅是提供原始的算力,而是能够针对特定行业需求提供优化方案,实现从算力到生产力的高效转化。
构建生态的长远布局
作为衔接自主 GPGPU 硬件与全栈软件体系的核心载体,MACA 3.3.0.X 的推出不仅是产品版本的常规迭代,更是国产芯片厂商在经历硬件破冰后,试图通过软件定义算力、通过标准重塑生态的长远布局。
值得肯定的是,沐曦提供的从 AI 芯片到软件核心平台的能力,是全栈自研的—— 与部分厂商选择兼容 CUDA 或基于现有开源 ISA 进行微调的方式不同,沐曦选择了最具挑战但也保证了长期安全性的路线:自主指令集。MACA 软件栈具有自己的编程模型和使用范式,但也深度兼容 CUDA 生态,无需大幅修改即可适配海量 CUDA 项目。另外,沐曦的 GPU 基于全自研 GPGPU 核心 IP 及架构,原生支持全精度计算、MetaXLink 高速互连等特性。
凭借自研的体系,沐曦保证了算力体系的安全合规、性能针对性以及演进自主权。与此同时,MACA 并没有将全自研等同于「生态完全推倒重来」,而是通过 MACA 软件栈构建了高度兼容的体系。
这种策略,保证了「算力自主」的战略目标。通过一并兼容已有生态海量的算法模型、软件资产与开发者技能,让更多开发者们无需重复造轮子,就可以在自主算力的底座上跑通业务。这种「高门槛自研、低成本迁移」的模式,最大化地保证了用户的商业效率与效益。
随着技术的不断进步,沐曦正在以最低的迁移成本,将 AI 开发者引入自己的生态轨道。
文章来自于“机器之心”,作者 “泽南”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Hygon outlines agent compute architecture with separate orchestration, inference and memory nodes (opens in a new tab)
The report covers Chinese CPU/DCU platforms, modular data centers and AgentServer Flex private deployment, examining how to match resources to different agent workloads.
九章云极谈智算云运营:从 GPU 卡时到 Token 双账本 (opens in a new tab)
报道介绍九章云极以DCU核算资源投入、以Token记录交付,并通过异构调度及推理优化比较单位成本。公司披露的利用率、客户案例和收入变化反映其经营口径;统一内部计量不等于行业已形成通用结算标准。
CVPR 2026 公布算力报告:录取论文与拒稿论文的资源差异 (opens in a new tab)
CVPR 2026 汇总16034份投稿算力表,录取与拒稿组的GPU数量中位数分别为4张和2张,研发计算投入也有差异。统计反映相关性,算力数据不向审稿人提供;报告同时展示低算力创新与效率奖励,不能据此推导录取所需的最低卡数。
算力的尽头是电力?从第一性原理看AI基础设施 (opens in a new tab)
文章从电力、芯片与内存、散热、电网建设、融资和地方许可梳理 AI 基础设施的约束。结合 IEA 等资料,讨论任务能效提升为何未必降低总用电,以及芯片、数据中心和电网不同建设周期如何形成瓶颈,区分签约容量与实际通电能力。
AI 短剧,未必是「算力泔水」 (opens in a new tab)
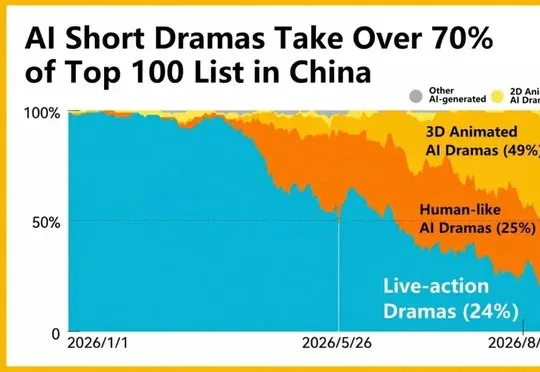
文章指出,AI短剧消耗国内55% Token和占据一半算力的说法并不准确,但其快速增长正创造新增推理需求,并推动视频模型与算力基础设施扩张。