
揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26(在新窗口打开)
当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。

给一个需要长期维护的知识库做数据库选型,通常会碰到两类问题:内容持续更新以后,框架能不能方便修改和回退;数据量和负载上来以后,底层向量数据库能不能根据需求切换。

AIGC相关创作中,多个LoRA合并到一起,画风串味、角色崩坏几乎是必然。

If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。

不得不说,国内Agent大战已经到了白热化阶段,就在昨天,小米也正式下场。开放桌面端应用:MiMo Desktop。目前是邀测阶段。

文章拆解了 Astra 模型与 Codex Harness 的配合方式:Codex 启动一个持续运行的代码环境,接入浏览器和桌面操作工具;Astra 通过无障碍模式读取界面中的文字、按钮结构,并通过截图综合判断。模型把准备执行的操作写成代码,交给 Codex 的工具完成。

「麻烦你,帮我看一下。」 一副 AI 眼镜的价值,可能就藏在少说一次这样的话里。 到了陌生的地方,视障用户最需要的不是一个什么都能聊的 AI,而是一个能告诉他周围有什么、该注意什么的帮手。该提醒时及时提醒,没必要时就安静,别在耳边说个不停。 京东在本次 JDD 上展示的 AI 眼镜,瞄准的正是这个需求:接入 JoyAI-VL-Interaction 模型,通过第一视角持续理解周围环境,为全盲及低视力人群提供辅助,减少「必须问人」的时刻。 这是一副充满爱与希望的智能眼镜。它也是观察京东 AI 路线的一个小切口。 JDD 期间,京东发布并开源JoyAI-Echo WM 实时可交互世界模型,并带来一

个性化在通用AI产品中一直是个加分项。无论是ChatGPT、Gemini还是Claude,还是今年的Openclaw、Harmes都把记忆和个性化当成核心卖点,理由是它能提高可用性、参与度和用户满意度。学术界对个性化的研究,也几乎全部集中在"如何做得更好、更准、更符合用户口味"上。

AI教师已经可以完成不少单次教学任务。 一道数学题,它能拆解步骤;一篇英文作文,它能指出语法问题;一盘棋,它也能讲出下一步思路。很多场景里,模型输出已经足够像一位耐心助教。 但教学效果不能只看教师端。学生听完之后有没有改正错误,是否只是照着提示走,同一句讲解对不同学生是否产生不同效果,这些都发生在学生端。 AI教师如果要学习个性化指导,也需要反复观察学生反应。 现实里,这些反应主要来自human study。每次调整教学策略,都要组织学生参与,收集交互,再由人工评估。 AI模型可以快速更新,但教育反馈的获取速度受human study实验周期限制。 AI tutor需要学生反馈来改进教学,但真

近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。

进入到 2026 年,可交互世界生成面对一道更难的考题:AI 生成的世界能否经得起用户反复探索?一扇门画得逼真,只是起点。往前走,它要自然靠近;穿过走廊再回头,它还应该留在原来的位置。用户每一次移动、转身和折返,都在检验模型是否有能力记住已经生成的世界。

刚刚,DeepSeek 开源了 V4.1 Flash,原生支持视觉理解,也是全新架构系列中最小的一款模型,550B 总参数,输入时激活 8B,输出时激活 16B(你没看错,输入输出激活不同)

大模型在直播场景模拟用户行为,理解真实的社交动态和风险演化,是当前一个非常热门的研究话题。
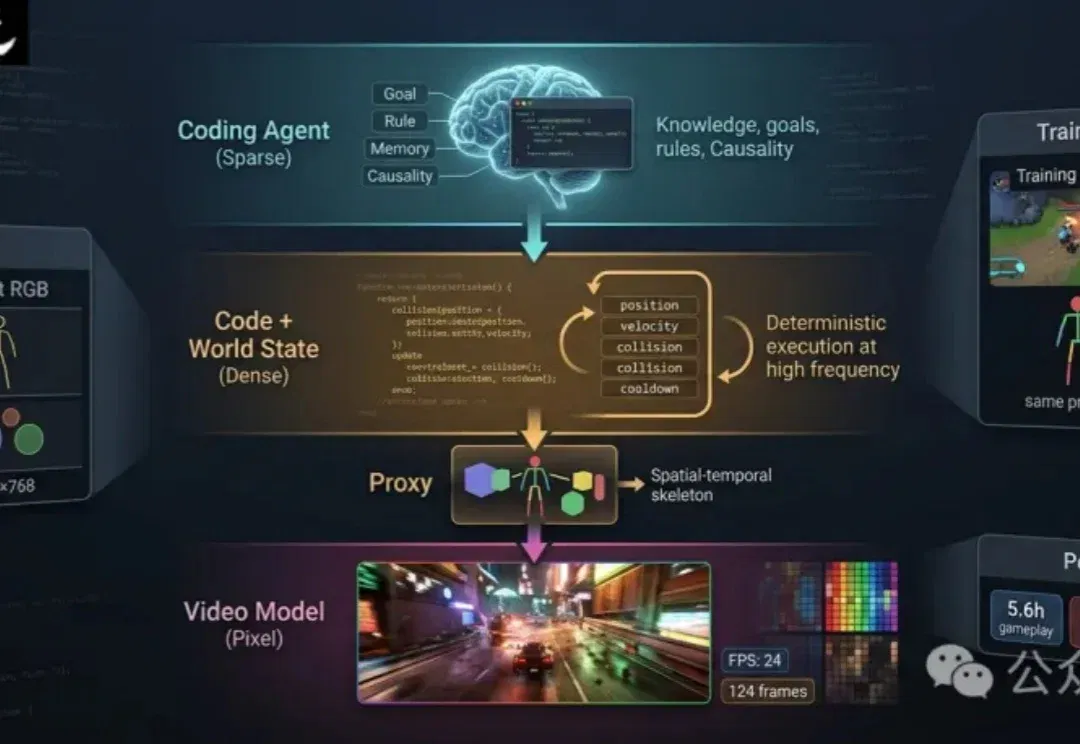
近年来,视频生成模型在清晰度、时序一致性和可控性上快速进步。给定文本、图像、相机轨迹或玩家动作,模型已经能够合成连贯的后续画面,也让「可交互视频世界」逐渐从概念走向可观看、可操作的原型。
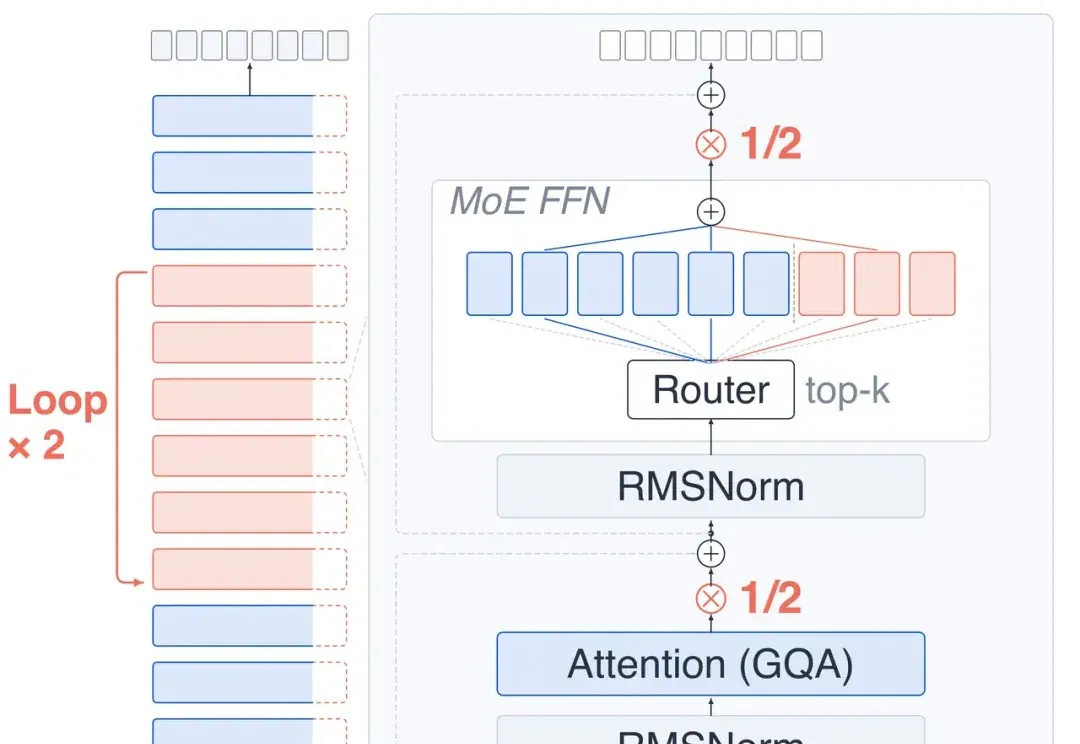
在大模型的发展中,提升能力的主要手段一直是 "做大"—— 更多参数、更多数据、更多算力。如今,另一条思路开始受到关注:与其不断堆叠新的层,不如让已有的层再跑一遍。这就是 Looped Transformer。普通 Transformer 的每一层只执行一次,而 Looped Transformer 会把其中一部分层重复执行,让模型在不增加参数的情况下获得更深的计算。
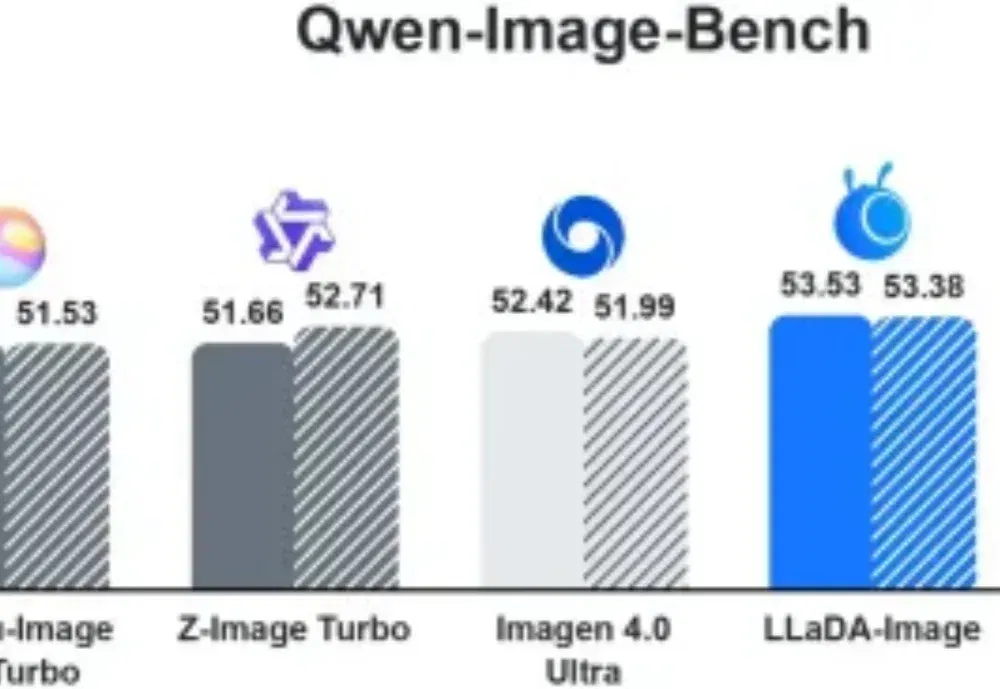
先学会画,再学会听话。 LLaDA-Image 在预训练和中期训练阶段直接从图片学习视觉先验,超过 90% 的累计生成训练样本采用 image-only 监督;图文对则集中用于后续语言对齐。模型权重、训练代码和完整配方同步开放。
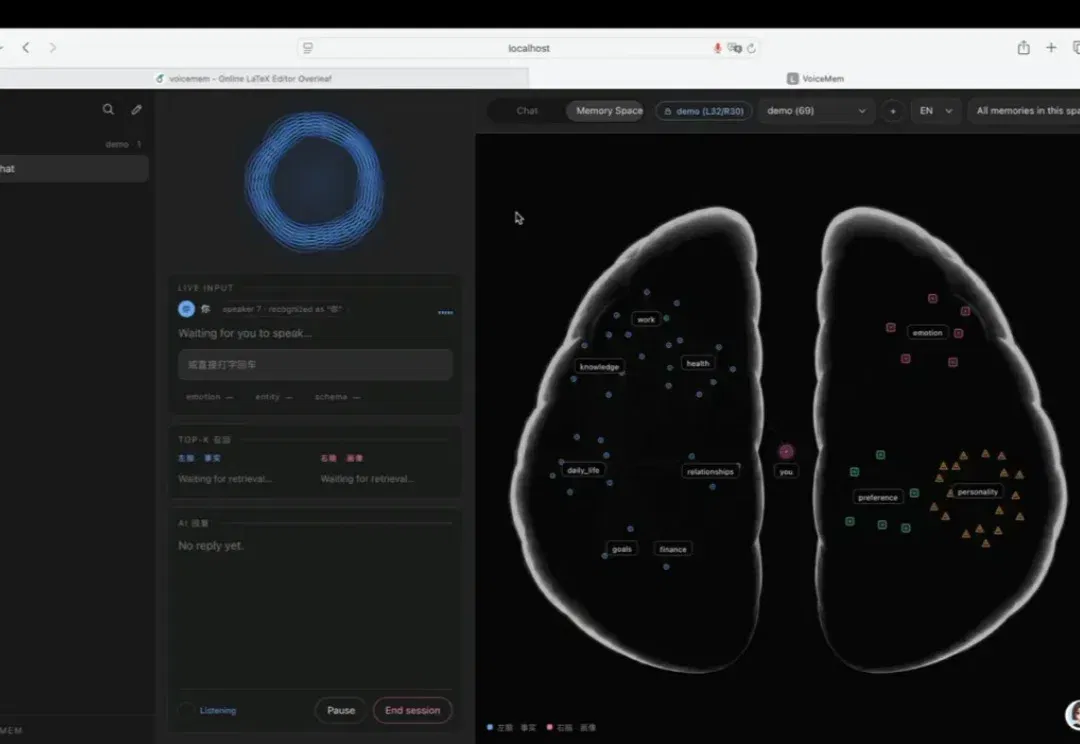
科幻早就预演过这一天,而这两年 AI 的真实进展,正把它推成一个可讨论的命题:AI 或许不会停在「工具」上,而会成为与人类共生的存在 ——AGI Being。
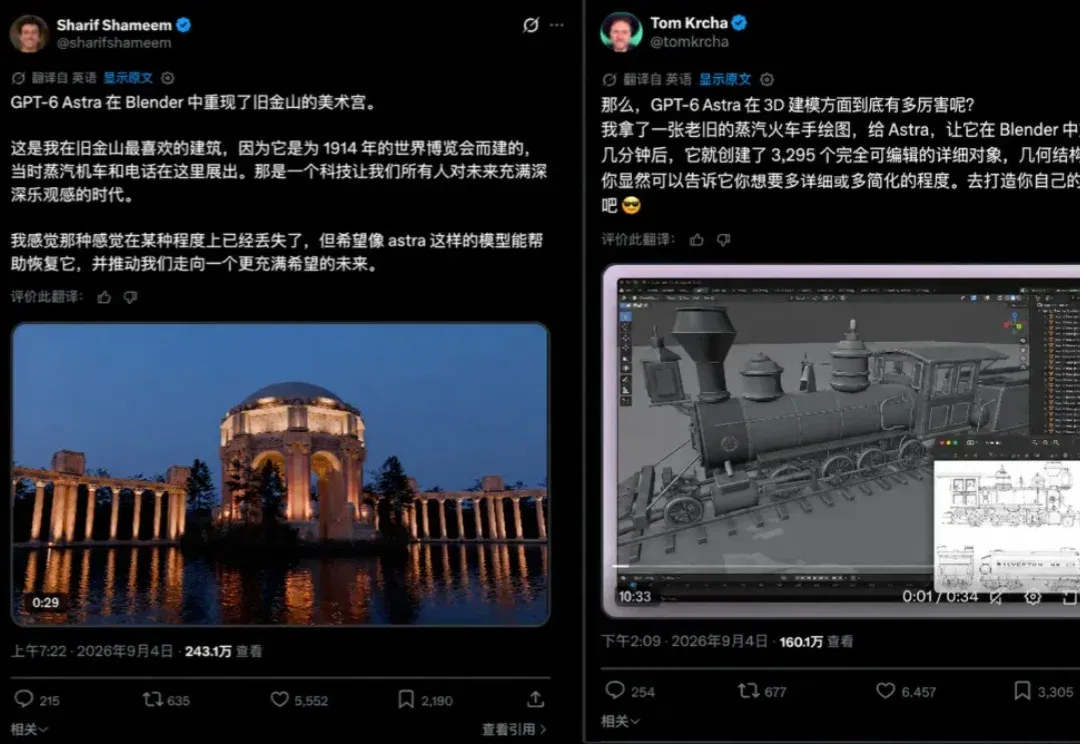
Blender,可能就是这次GPT-6 Astra上线后的最大受益者。
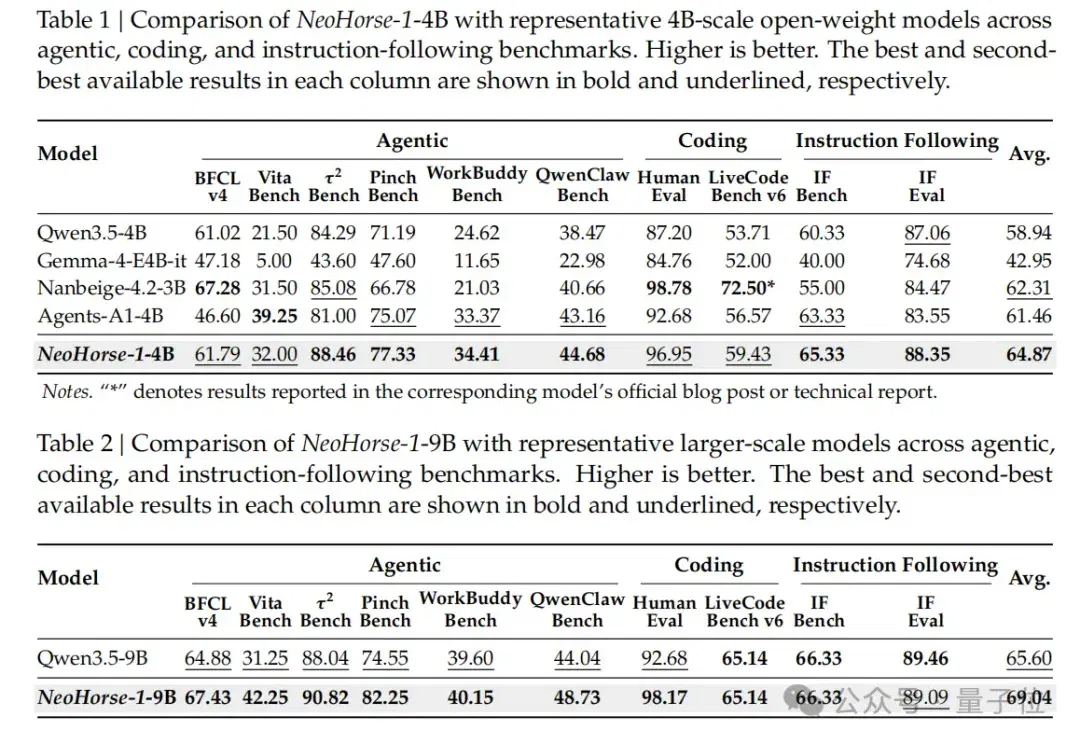
王云鹤创业后,首次交卷了大模型成果。 量子位获悉,华为诺亚方舟实验室前主任、盘古大模型负责人王云鹤创办的基元律动,发布首个Agent-Native模型NeoHorse。 该模型由无问芯穹提供底层基础设施支撑与Infra优化技术能力,清华大学、北京大学团队参与算法和训练方法研究,共同探索提升Agent后训练的数据利用效率和训练效果。 NeoHorse-1包含4B和9B两个版本,重点面向Agent工作过程中需要的一组能力,包括调用工具、读取环境反馈、发现错误、调整路径,并最终完成任务。 在覆盖Harness Agent、工具使用、代码和指令遵循等10项评测中,经过Agentic Post-Trai
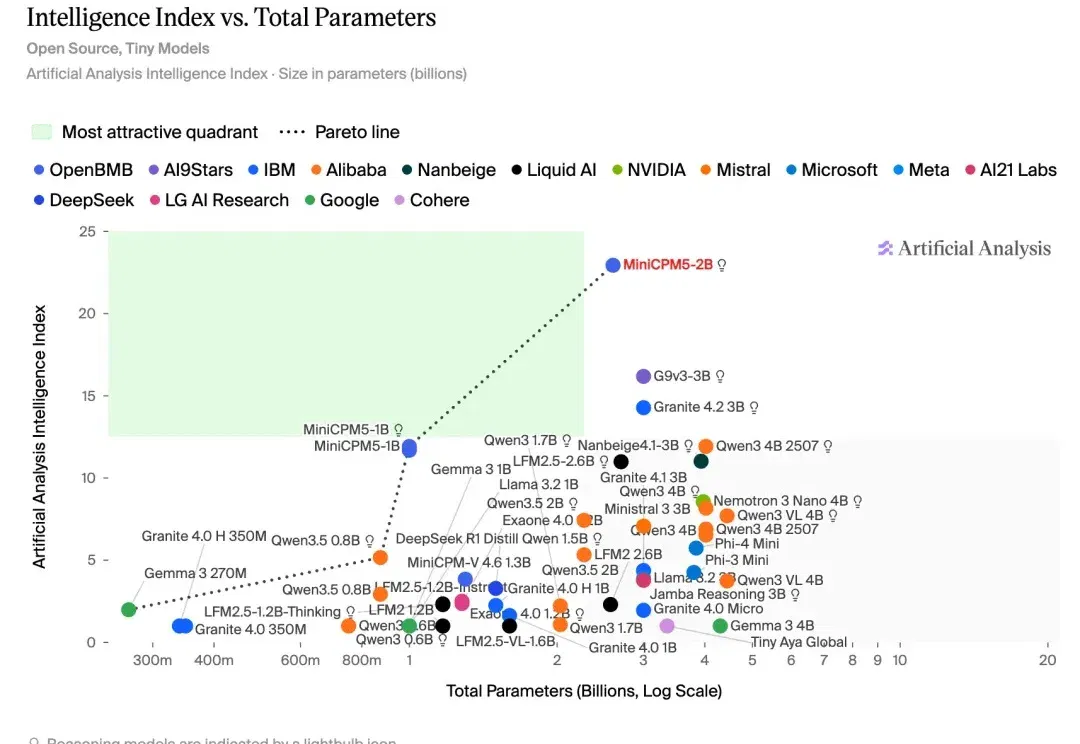
过去几年,端侧大模型一直在不断突破能力边界。
参与交流
了解加入交流群的方式,阅读内容无需登录。