启元发布 PrimeSim,探索面向机器人操作的世界模型仿真器
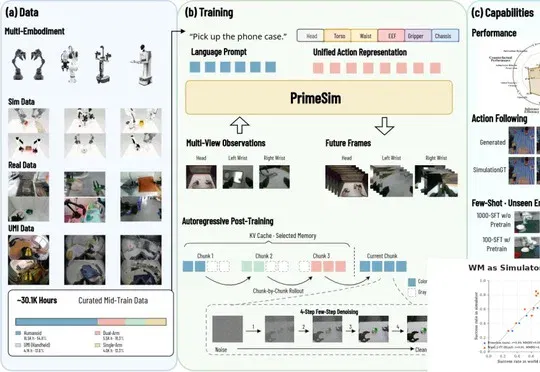
PrimeSim 将预训练视频模型经中训练与后训练改造为动作条件仿真器,关注跨视角一致性、长程状态和生成速度。团队报告了仿真基准及在模型内训练后向传统仿真迁移的结果;这仍不同于已验证真实机器人泛化,权重与代码在报道时属于即将开放。
训练机器人控制策略高度依赖仿真环境,但传统手工搭建的仿真器规模化落地门槛极高。
今日,启元具身研究中心正式发布 PrimeSim,一款面向机器人操纵任务的世界模型仿真器。它基于预训练视频生成模型,经由中训练、后训练两阶段改造,具备替代传统仿真器的交互推演能力。
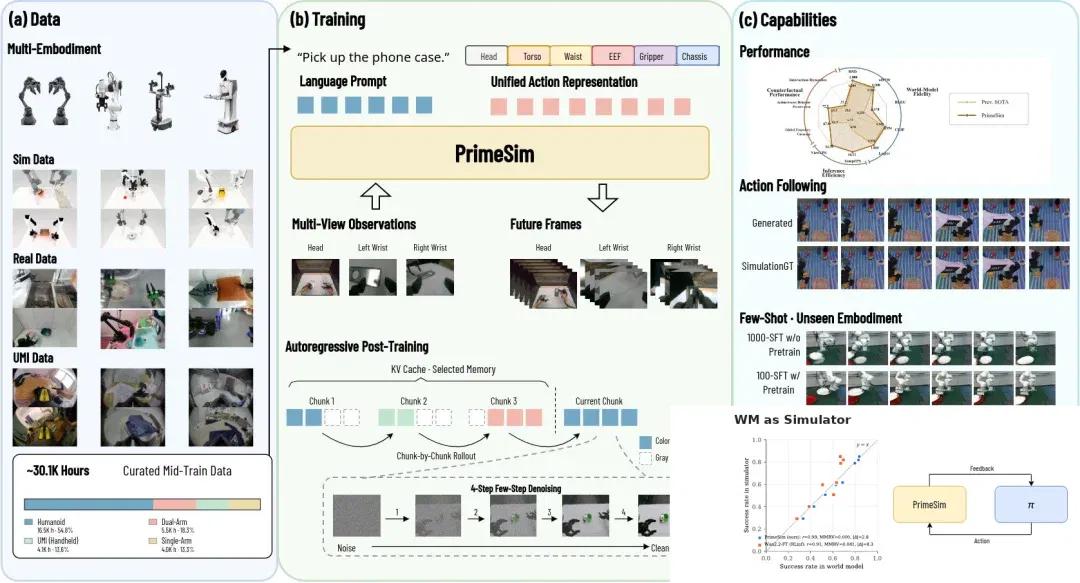
在 EWMBench 基准上,PrimeSim 拿下 6.09 的综合得分,位列榜首;在 WorldSimProbe 的五项评测维度中,斩获三项第一。
PrimeSim generated demos
为什么机器人需要「从数据中学出来的仿真器」
理想的机器人仿真器,应当满足几个核心特质:能够并行调度上万条轨迹 rollout、支持场景精确重置且无硬件损耗、无需针对不同场景大量工程定制,同时尽可能缩小现实鸿沟(sim-to-real gap)。
但只用视频生成模型做这件事,「视觉逼真」远远不够。作为仿真底座,它必须同时守住三重约束:
- 严格服从策略输出的动作指令;
- 多相机视角之间保持几何、语义一致;
- 在远长于训练上下文窗口的长时间推演中维持状态连贯。
在团队看来,现有的通用世界模型大多只能满足其中一到两项,很难同时兼顾三者。
技术路径:先中训练,再后训练
PrimeSim 采用两阶段改造范式,将原生双向视频生成模型逐步转化为可交互、可自回归滚动的世界模型仿真器。
第一阶段:中训练|从视频生成模型到机器人世界模型
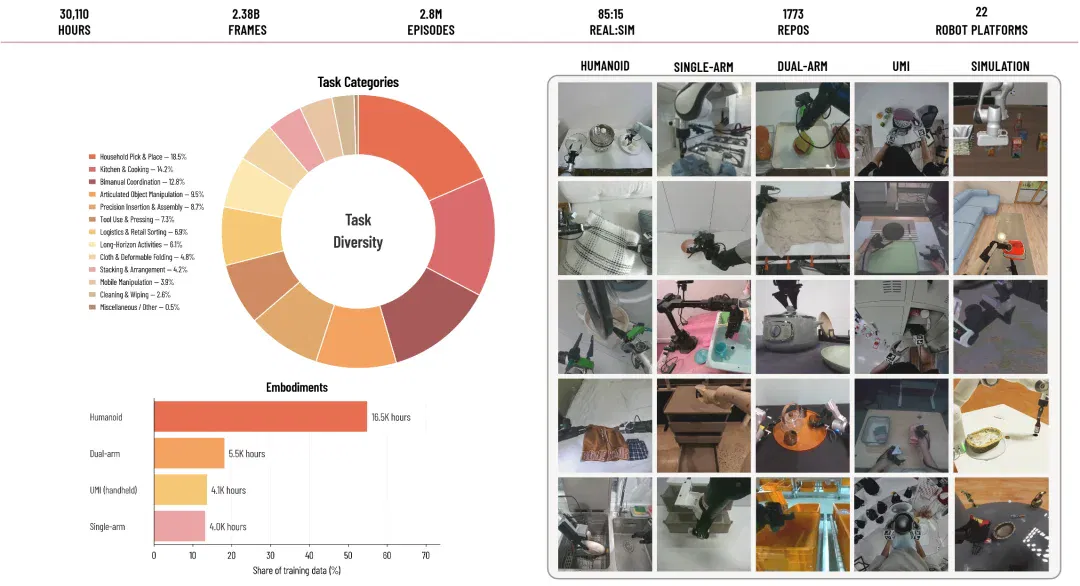
模型训练基于 30110 小时精选机器人演示数据,覆盖人形、双臂、单臂、手持 UMI 设备等 22 种异构机器人平台,混合真实采集数据与传统仿真数据;其中人形机器人样本占比 54.8%,真实世界数据占比 84%。核心设计包含三点:
- 统一动作表征:将头部、躯干、腰部、末端执行器、夹爪、底盘的控制信号编码至同一动作向量,实现跨本体兼容;
- 帧对齐双路径条件注入:结合时序对齐注意力机制与直接动作注入,强绑定控制指令与生成运动;
- 视角感知交错注意力:引入显式相机标识完成跨视角信息交互,保证多视图一致性,避免不同视角画面互相坍缩。
第二阶段:后训练|高速生成 + 长时序记忆
自回归仿真的难点在于,模型需要基于自身上一步不完全精确的预测继续推演,而原生视频生成模型仅在固定长度真值上下文上训练。团队针对性设计三项机制:
- 高速生成链路:分块因果适配 + 四步一致性蒸馏,支撑长序列连续仿真;
- 自条件稳定性:以冻结双向教师模型作为参照,开展 Self-Rollout 的世界模型仿真器训练与非对称分布匹配,缓解误差累积;
- 分层时序记忆:在有界 KV Cache 内分层存储初始场景、稀疏长程历史、稠密近期运动,支撑超长推演。
这套方案最终把双向生成模型改造为因果、Self-Rollout 的世界模型仿真器:超过固定的训练上下文窗口后依旧可以稳定推演,最长支持两分钟以上连续 rollout。
在 RoboTwin 2.0 留出集、单张 A100 环境下,50 步去噪的因果自回归扩散基线速度仅 1.12 FPS,PSNR 26.15;CD 将去噪步数压缩至 4 步,速度提升至 10.04 FPS,PSNR 回落至 24.40;叠加 DMD 后,保持 4 步去噪,PSNR 回升至 24.87,LPIPS 由 0.193 优化至 0.176,相较 50 步教师模型整体提速约 9 倍。
实验结果
EWMBench:综合得分第一
PrimeSim 在 EWMBench 拿到 6.09 综合分,高于 GE-Sim(LTX,5.82)、GE-Sim(COSMOS2,5.79),同时领先 Thinker-WM、EnerVerse-FT、Qwen-RobotWorld、Sora2。分项上,HSD(1.000)、nDTW(1.000)、BLEU(0.570)、CLIP(0.954)、Logics(1.000)均取得第一名。
WorldSimProbe:五项指标三冠
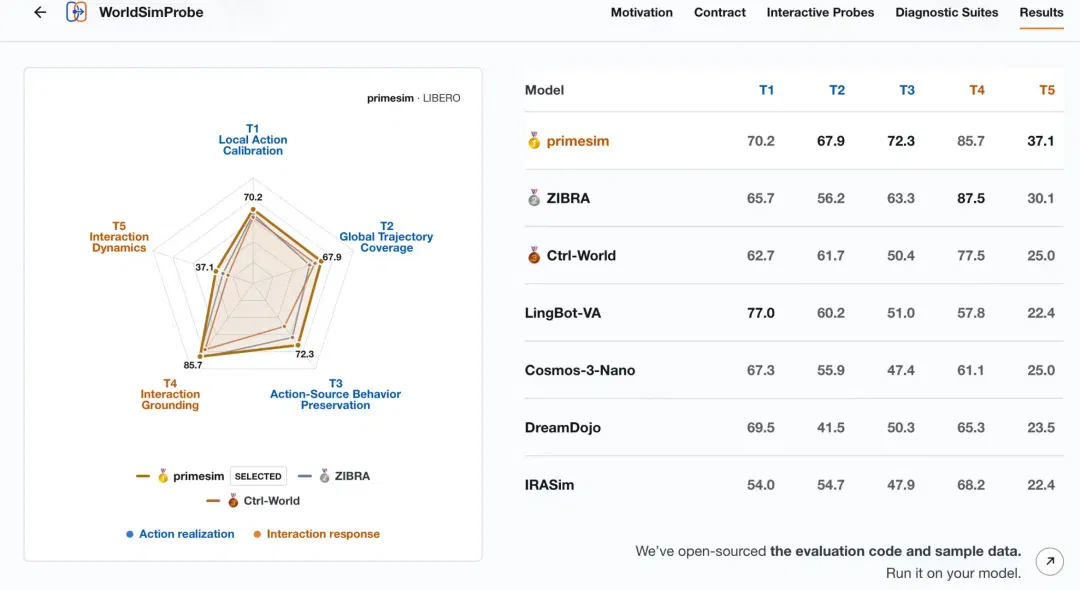
WorldSimProbe 基于 LIBERO 设计五套评测套件,刻意剥离视觉观感、任务成功率的干扰,聚焦仿真器本身的动态保真度。PrimeSim 在全局轨迹覆盖(T2,67.9)、动作来源行为保持(T3,72.3)、交互动态(T5,37.1)三项登顶。
作为策略仿真底座:和传统仿真器高度对齐
实验选取 8 个 OpenVLA-OFT 策略,基线仿真器成功率区间 29.3%–85.0%,在 300 个共享初始状态的设定下,PrimeSim 与 LIBERO 原生仿真器的策略成功率相关系数 r = 0.99,MMRV = 0.000,平均绝对误差 |Δ| = 2.8。作为对照,Wan2.2-FT 对应指标为 r = 0.91、MMRV = 0.041、|Δ| = 8.3。
团队更进一步,直接在 PrimeSim 内部对 OpenVLA-OFT 做 GRPO 强化学习,每轮采样 512 条 episode,共计 200 轮更新。策略在原生仿真器上的成功率提升了 11.5%,在 PrimeSim 内的评估指标上涨了 11.8%。这证明:在该神经仿真器中得到的策略增益,可以有效迁移到传统物理仿真环境。
counterfactual action following demos
少样本本体迁移:新本体仅需 100–200 步微调
中训练赋予模型很强的跨本体迁移能力。适配 xArm 7、ViperX 300、UMI 夹爪分别只需要 200、100、200 步梯度更新;而仅经过通用预训练的模型,在 2000 步更新后仍无法产出可用效果。在 AgileX Piper 的 XVLA 场景中,布料、相机位姿、场景均未出现在训练集内:零样本推演时密集接触的布料形变会快速漂移;在单卡 A100,仅需不到 3 分钟,200 步微调后,布料形变跟随动作指令,多视角状态保持一致。
PrimeSim unseen embodiment few-shot demos. Left side is PrimeSim, right side is Wan2.2 5B
unseen camera and environment zero-shot demos
推理性能:单卡 A100 可达 10.12 FPS
单张 A100-80GB,三视角、单图分辨率 288×384、一次预测 32 帧未来画面、4 步去噪配置下,PrimeSim 实现 10.12 TempFPS、30.35 ViewFPS;吞吐能力约为 GE-Sim 2.0 的 4.5 倍、Ctrl-World 的 11.6 倍。
消融实验:各模块设计均带来明确收益
多视角机制消融显示:仅做帧拼接时 PSNR 仅 16.30;加入视角 token 条件后提升至 23.78;叠加视角内交错注意力后达到 24.56,LPIPS 由 0.58 降至 0.15。
工作小结
团队基于实验得出四点核心结论:
- 这是一套可复现的工程配方,而非单点模型:「中训练 + 后训练」渐进式流水线,能够把通用视频生成模型改造为可交互机器人世界模型仿真器;
- 动作保真度可以通过数据规模习得:统一动作表征搭配双路径条件注入,在 22 种异构本体上实现控制信号与运动生成的强绑定;
- 世界模型具备替代传统仿真器的潜力:和原生仿真策略成功率相关性高达 0.99,在模型内部做强化学习的收益可迁移;
- 兼顾精度与工程实用性:10.1 FPS 推理速度、超两分钟长时序推演、新本体仅需百级步数微调。
据机器之心了解,PrimeSim 的权重、推理代码、训练代码即将开源。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。
Syncere raises $11M for Lume, a household robot shaped like a floor lamp (opens in a new tab)
Syncere uses a floor-lamp form for Lume: one robot handles some pick-and-place tasks, while two work together in Duet mode on tasks such as folding clothes. Demos are edited; pricing and delivery reflect the source date, and home reliability remains unproven.
Genesis AI raises $500M Series A to advance its full-stack robotics and Eno (opens in a new tab)
Genesis AI announces funding at a $3.5B post-money valuation, outlining a stack of data gloves, simulation, models and the Eno robot. Production and customer deployments are planned; demonstrations and correlation experiments do not establish delivery at scale.

Oxford researcher proposes cognitive symbionts for wearable AI augmentation and governance (opens in a new tab)
Hao Fei's perspective paper proposes cognitive symbionts and AI-Augmented Human Intelligence, covering long-term memory, wearables, proactive help and governance. Privacy, low latency and lifelong companionship are design goals, not verified product guarantees.
Huawei Cloud unveils CloudRobo-WM1.2, plans November 30 release of weights and code (opens in a new tab)
Huawei Cloud presents its Ascend-native embodied world model CloudRobo-WM1.2 and development platform, with two benchmark results and industrial demonstrations. Model weights, inference and post-training code, and pretraining practices are scheduled for November 30.