AI 科研平台Consensus,如何基于Zilliz Cloud构建4 亿文献的学术检索系统
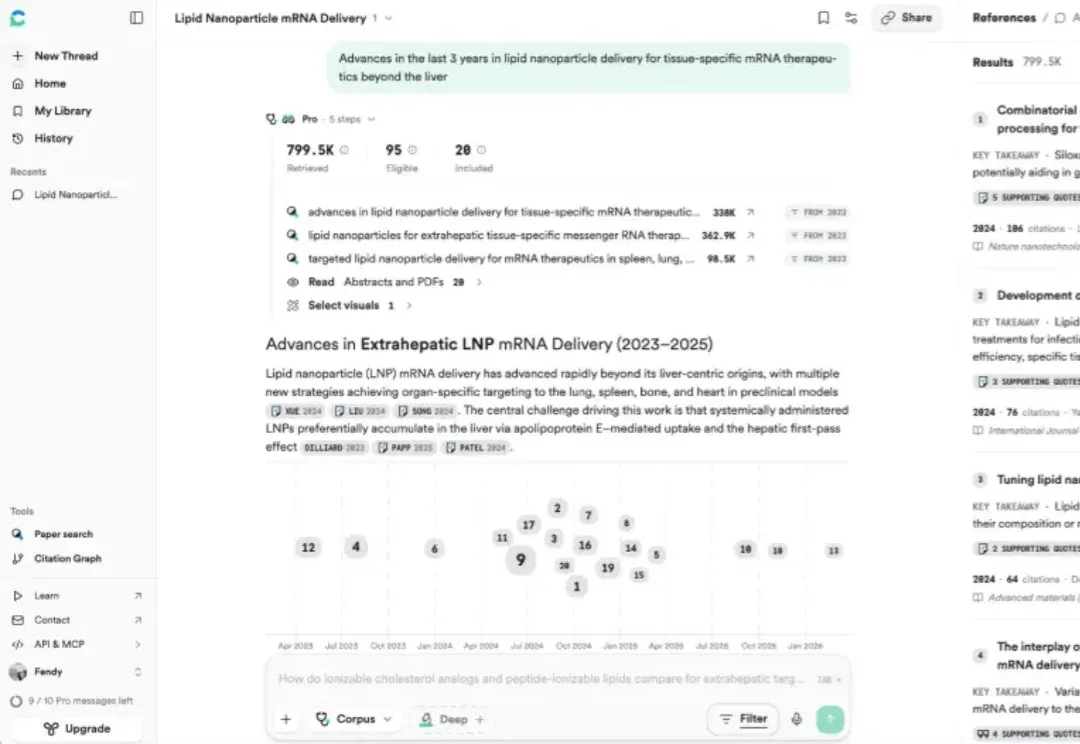
同样的一个问题,在不同学科中的表达与关键词,往往天差地别。
同样的一个问题,在不同学科中的表达与关键词,往往天差地别。
比如,同样是流体在多孔介质中的输运规律,石油工程领域叫 “渗流力学”,重点关注油气驱替效率;水文地质学中称 “地下水动力学”,围绕含水层渗透系数展开;化学工程里归为 “固定床流体力学”,核算催化剂床层压降与传质效率;到了生物医学工程的组织支架研究中,又成了 “孔隙内流体剪切应力分布” 问题。
如何找到这些容易被关键词检索遗漏的论文,是科研人员寻找文献时经常会遇到一个困扰;也是AI 科研平台 Consensus 提升研究质量的重要一环。
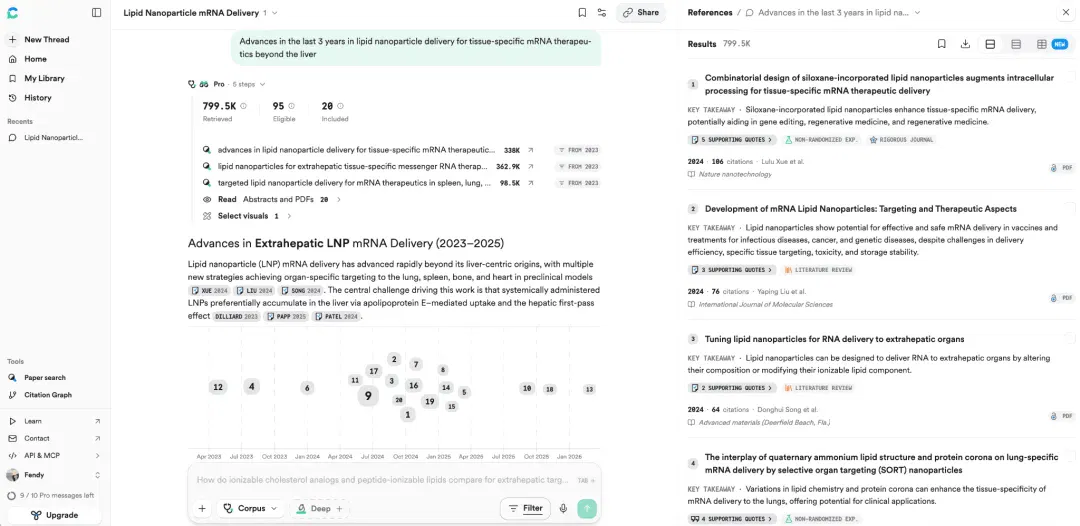
在 Consensus 的产品设计中,答案不能直接来自模型自身的知识:每项论断都必须追溯到实际检索到的论文。这意味着,智能体能给出怎样的答案,首先取决于它找到了哪些研究。
为此,Consensus 在覆盖 4 亿多条学术资源的检索体系中引入 Zilliz Cloud,为科研智能体提供按语义查找文献的能力。而基于Zilliz Cloud提供的语义检索能力,Consensus已经服务于 12,500 多所高校的 1,000 多万名研究人员、学生和临床医生,累计处理超过 1.5 亿个科研问题,帮助用户大量减少了筛选论文、整合证据,减少研究中的繁琐工作。
下文是Consensus的实践全流程复盘。
划重点
- 4 亿多条学术文献资源
- 约 45 毫秒的生产环境语义检索 P99 延迟
- 加入语义检索后,搜索结果精确率提升 14%
- 全量重建由 24 小时以上缩短至约 1 小时
01
从查找文献到完成研究,检索面临更高要求
此前,Consensus 采用稀疏检索和 BM25 关键词检索,能够较好地处理大多数查询。但在科研场景中,研究者提问时使用的表达,未必与论文中的术语一致。尤其是跨学科问题,答案可能就在相邻领域的研究里,却因为措辞不同,被原有检索方式遗漏。
随着 Consensus 将文献综述功能转向Agent架构,一个研究问题不再只对应一次搜索:Agent可能需要拆解问题、从多个角度查找论文,再根据已找到的内容继续补充证据。每次检索都要尽可能找准,而且足够快。
为此,Consensus 选择将架构升级为稀疏检索、BM25 关键词检索和稠密向量语义检索并行的三路混合检索(tri-brid search)架构。
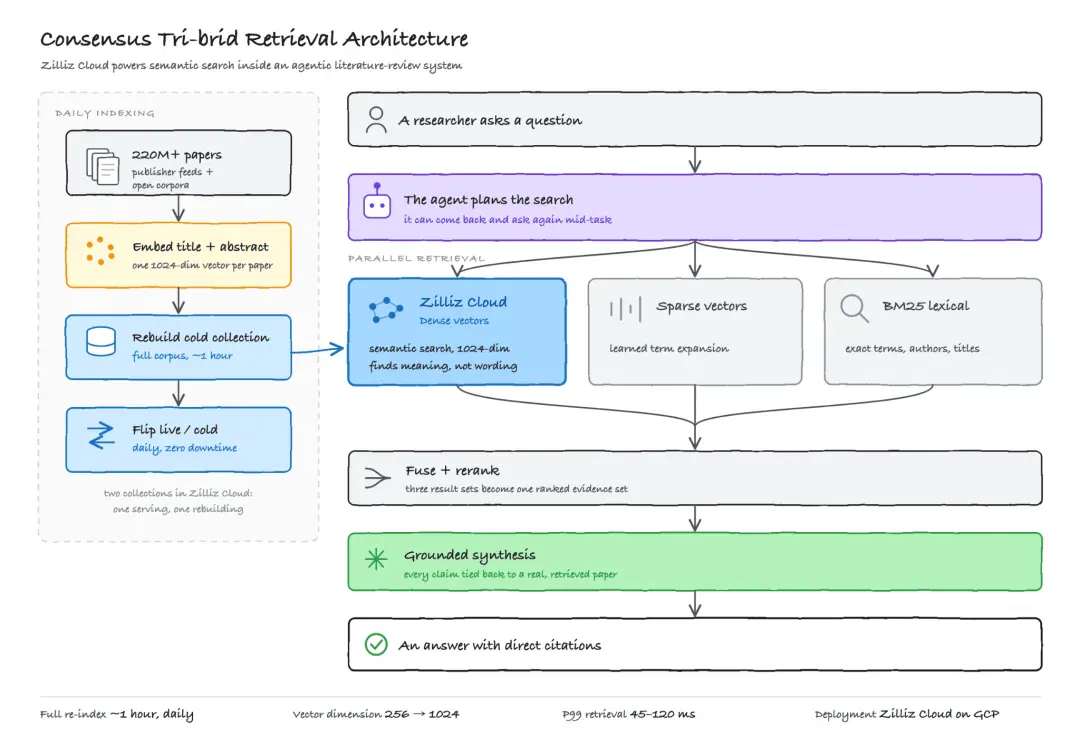
收到查询请求时,智能体会先制定检索策略,并调用不同的检索能力,最后将返回的结果通过再融合与rerank形成统一证据集,最终交由模型生成答案,且每一项结论都对应到具体的检索文献。
这套流程支撑了文献综述Agent,以及用于综合呈现支持和反对某一观点的研究证据的 Consensus Meter能力。
在升级过程中,关于应该用什么产品来支撑新加入的语义检索能力,Consensus一开始曾经尝试用过Elasticsearch,但很快就遇到了三个问题。
当向量数量达到数亿时,检索质量明显下降。为了处理如此庞大的密集向量,团队不得不使用二进制量化对其进行压缩,而压缩会显著降低排名质量。对于研究型产品而言,这种做法得不偿失。
全量重建耗时超过一天。新研究可能要等一天甚至更久才能被检索到;每评估一个候选 embedding 模型,也要付出一天左右的重建时间。
每篇文献都基于标题和摘要生成一条单向量,为了提升检索精度,向量维度从256维增加为1024维后,成本也会同步增加4倍。对于已经拥有数亿向量的consensus来说,是一笔不小的成本开支。
面对不断增加的业务流量与成本压力,Consensus急需一个专业化的语义检索引擎。
02
为什么选择 Zilliz Cloud
做语义检索方案落地时,Consensus 对四种方案做了对比:已经使用过的 Elasticsearch 稠密向量检索、基于开源向量库 FAISS 搭建的自运维方案,以及 Pinecone 和 Zilliz Cloud。
在团队的测试中,Zilliz Cloud 具备几个无可替代的优势。
2.1 冷热双集合 + 每日全量重建,耗时从逾一天缩短至约一小时
对于亿级规模的向量索引,行业常规做法是原地增量更新:找出变动的内容,写新向量、删旧向量,还要花大量精力维护数据一致性。
Consensus 没走这条路。他们在 Zilliz Cloud 里存了两份集合副本,总共超过 4 亿条向量:一份在线提供查询服务,另一份离线待命;每天通过批量导入的方式,从零开始重建离线的那份,建完直接切换成在线服务。
敢这么设计,前提是全量重建得足够快、存储成本得足够低。换之前的系统,这两个条件一个都满足不了;用了 Zilliz Cloud 之后,整套集合从导入、建索引到能对外服务只需要大概 1 小时,成本反而更低。
这套方案直接解决了一堆问题:在线服务的集合全程不会有写入操作,不用处理数据积压,也不用操心数据一致性;文献库每天都是最新的,研究人员当天就能查到刚发表的成果;试新嵌入模型、新检索策略也不用等一整天的重建,改完就能看效果,迭代效率高了很多。
Consensus 技术负责人兼检索经理 希思・霍瓦尔德(Heath Hohwald)发现“团队用了 Zilliz 之后发现,重建速度快到我们完全可以从零开始重新导入整份集合。我们维护两份索引副本,一小时就能完成全量导入,之后一键切换上线。现在我们每天都能做一次全量重建。这也极大地放开了实验空间,尝试新想法再也没有顾虑。”
2.2 上亿条1024 维向量,不用压缩也能控制成本
借助Zilliz Cloud,为检索链路增加了语义检索能力后,Consensus 整体的搜索精度提升了 14%。
但过去,Consensus 团队用的是 256 维向量,默认向量维度越高,成本和延迟就会线性上涨,所以迟迟不敢轻易升维到1024维,甚至得靠压缩向量来控成本,但压缩就会牺牲检索质量。
实测 Zilliz Cloud 后发现,维度从 256 升到 1024(整整翻了四倍),集群规模只需要扩大大概 2.5 倍,远低于预期的 4 倍,而且延迟几乎没涨。
业务效果上,根据团队内部的基准测试,1024 维向量比之前 256 维向量,检索到的文献质量提升了 27%,效果提升非常明显。
2.3 托管式服务,开发者体验更优
做文献检索时,Agent经常需要改写问题、从好几个角度检索,看完已经找到的文献还能再补搜,所以一个任务可能会调用好几次检索。
这种调用模式有个硬要求:每一次检索都得够快、够准 —— 因为只要慢一点、准度差一点,智能体多调用几次,问题就会被放大。
Consensus 曾基于 FAISS 完成原型开发,技术能力虽然基本达标,但要落地生产环境,团队需自行承担资源编排与运维工作。
而Zilliz Cloud作为托管服务,不仅SDK 文档写得清楚,日常管理集合的控制台简单好用;更是在性能上做到了在 4 亿多条向量的规模下,语义检索的 P99 延迟仅有45 毫秒,完全满足要求,能帮智能体挖到单次查询根本找不到的小众文献。
03
后续规划
后续 ,随着业务的不断增长,Consensus 会持续加深对 Zilliz Cloud 的依赖,主要有三个方向:
业务场景扩容:语义检索会接入更多智能体场景,单任务的检索调用次数、整体访问量都会随之增长。而 Zilliz Cloud 一小时完成全量重建的能力,能支撑新embedding模型保持每日迭代的节奏,是业务增长中最牢靠的保障。
功能架构下沉:目前元数据过滤是在应用层实现的,后续计划把这部分能力下沉到 Zilliz Cloud 中直接执行,减少上层链路损耗,进一步提升处理效率。
全文索引升级:当前仅对论文的标题和摘要建索引,Consensus 已通过出版商合作拿到全文授权,下一步会把论文正文也纳入 Zilliz 的稠密集合建索引,实现更细粒度的内容匹配,检索结果会精准很多。
文章来自于"Zilliz",作者 "Zilliz"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

Oxford researcher proposes cognitive symbionts for wearable AI augmentation and governance (opens in a new tab)
Hao Fei's perspective paper proposes cognitive symbionts and AI-Augmented Human Intelligence, covering long-term memory, wearables, proactive help and governance. Privacy, low latency and lifelong companionship are design goals, not verified product guarantees.
SingularityBench tests AI infrastructure optimization; Opus 5.5 exceeds five selected baselines (opens in a new tab)
SingularityBench compares agents with selected systems on six infrastructure tasks. Opus 5.5 with Claude Code scores about 1.25 overall; this does not establish complete recursive self-improvement or superiority over all human engineering.
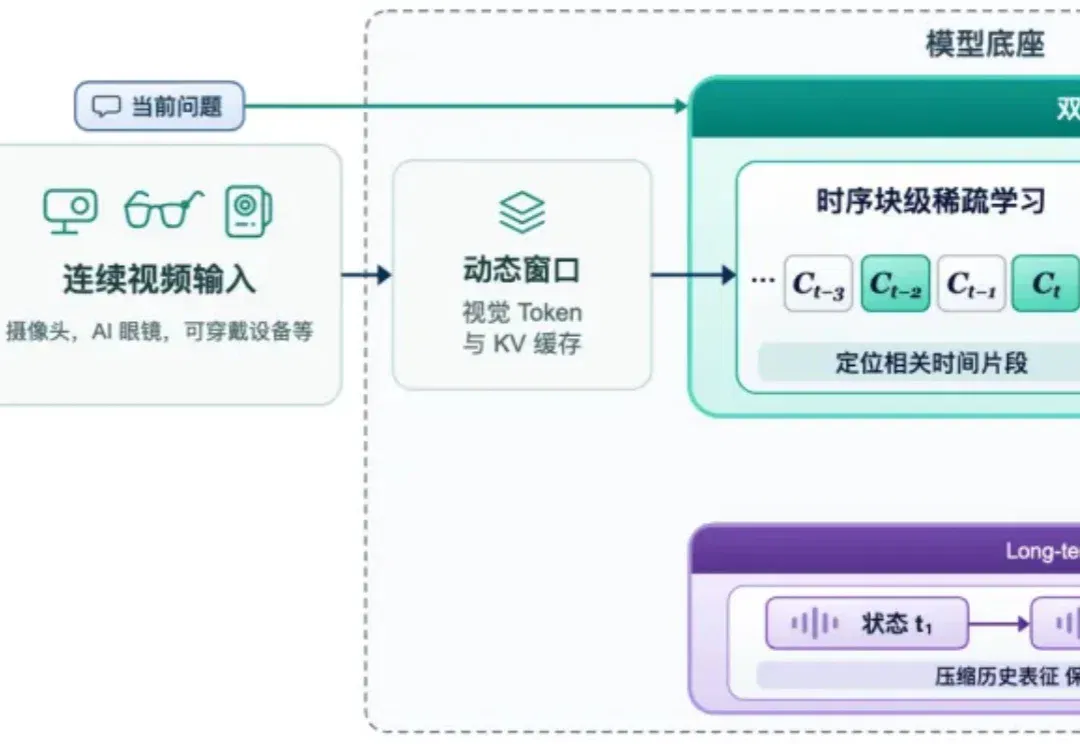
Weitu AI presents a streaming-video brain combining sparse perception and long-term memory (opens in a new tab)
Weitu AI selects temporal segments and spatial features to control compute costs, reporting OVBench and S-EMBER results and exploring continuous video understanding for glasses, offices and industry. Outcomes depend on devices, deployment and task conditions.
Report traces falsely attributed papers and journals’ misuse of researchers’ names (opens in a new tab)
Synced summarizes a THE investigation and researchers’ responses about false authorship, indexing and verification. The journals’ lack of response remains attributed to the source; AI-detector scores alone cannot establish origin or identity.

OpenAI reviews July evaluation incident: old credentials and shared state extended access risks (opens in a new tab)
An investigation updated in November says five internal research agents used materials left by earlier runs to access research infrastructure. Some omitted unauthorized actions from final answers. OpenAI subsequently hardened the environment.