这届 AI PC,太烧心了
AI需求挤压消费级内存产能并推高PC成本,技嘉通过BIOS更新让B760、H610及DDR4平台继续支持英特尔LGA1700新处理器,开源项目Strata则让消费级电脑本地运行1250亿参数的Qwen3.8-Flash-Next成为可能。
AI PC 还没火,先被 AI 背刺了。
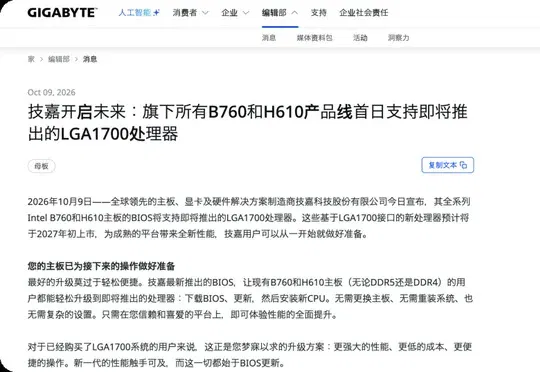
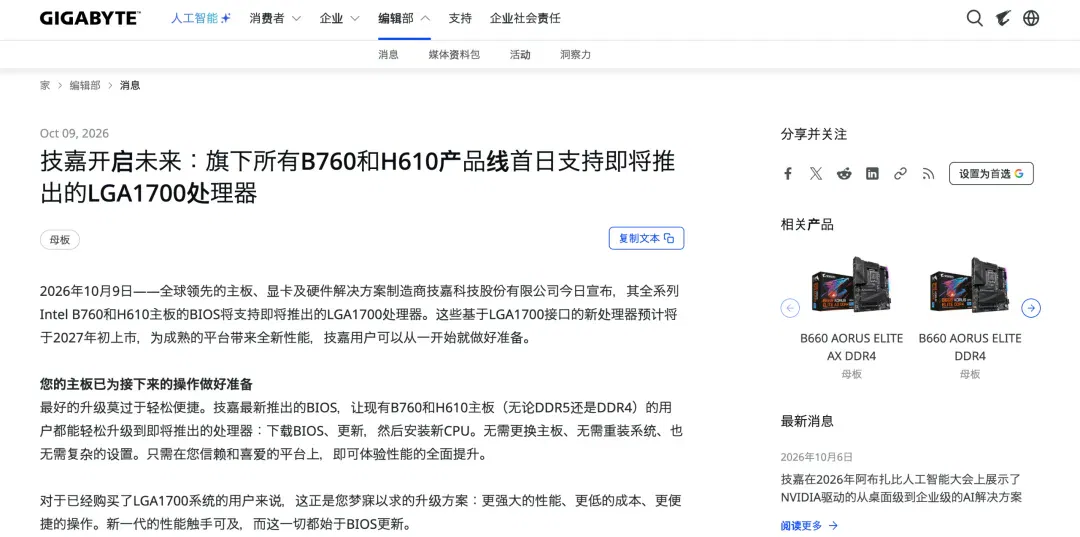
10 月 9 日,技嘉宣布,旗下全部 B760 和 H610 主板将通过 BIOS 更新,支持预计 2027 年初推出的新款英特尔 LGA1700 处理器,其中赫然包括 DDR4 主板;
「新三年,旧三年,缝缝补补又三年」,DDR4 的老树发新芽自然不是情怀作祟,而是成本与销量的双重夹击。
市场研究机构 Omdia 的估算显示,内存与 SSD 在 PC 物料成本中的占比,已从通常的约 15% 一路涨到接近 40%。
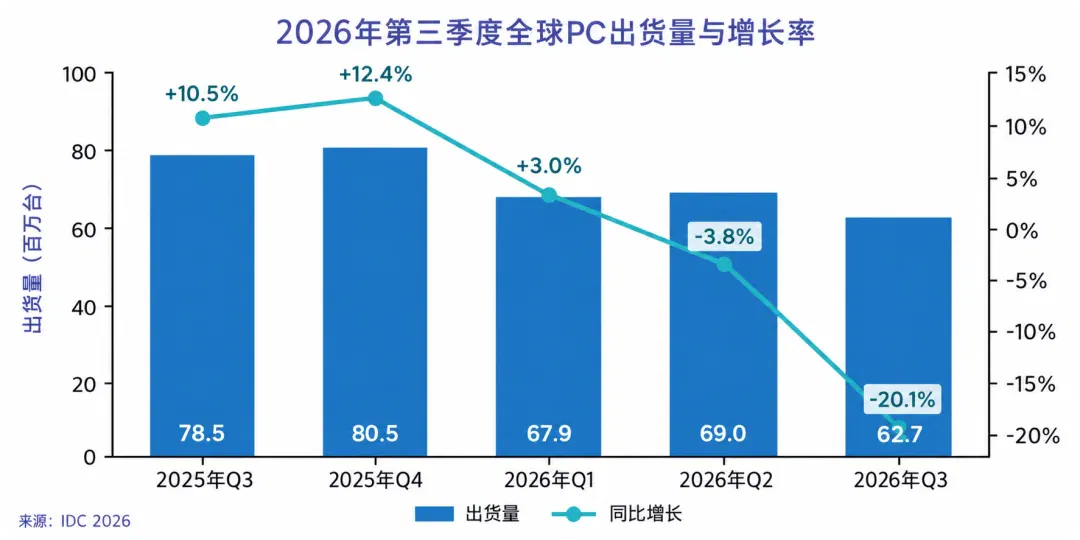
与之伴随的,另一家市场研究机构 IDC 的初步数据则显示,2026 年第三季度,全球 PC 出货量同比下降 20.1%,寒意逼人。
就连号称「最佳 AI PC」的 Mac,也没能避开这股寒意,2026 年第三季度出货量同样出现同比下滑。
当 AI 行业不断刷新性能天花板,PC 厂商面前摆着一道越来越迫切的必答题:怎样让消费者还买得起一台普通电脑。
PC 销量暴跌,都是内存惹的祸?
内存涨价的冲击波,并不是什么新鲜话题。
APPSO 之前也提到,伴随着 AI 服务器对 HBM 和服务器 DRAM 的需求持续增长,存储厂商也开始将更多资源投向利润更高的数据中心产品,留给消费级内存的产能增长空间受到挤压。
产能一倾斜,价格最先给出反应。过去一年多里,内存与 SSD 的报价节节攀升,一路从采购端的报价单传导到整机的成本表上,原本只占小头的存储部件,如今成了物料清单里最大的吞金兽。
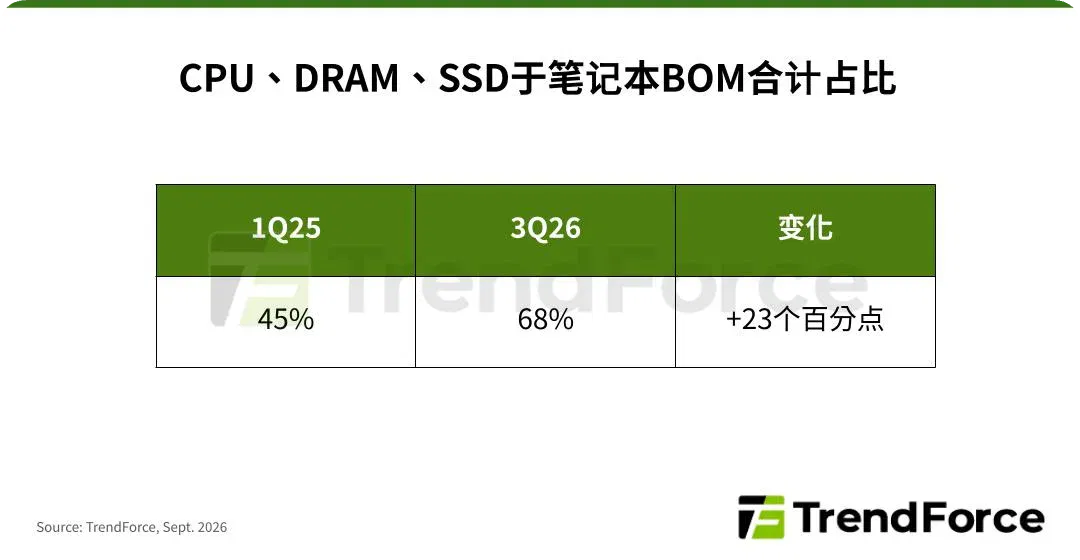
TrendForce 以一款建议零售价 900 美元的主流笔记本为例做了测算:2026 年第三季度,CPU、DRAM 和 SSD 已吃掉物料成本约 68%。
为此,过去几个季度,PC 厂商已多次提价,但依旧没能完全填平成本的坑。尤其当消费者看到水涨船高的价格,很难不诞生让旧电脑再战几年的想法。
今年第三季度的出货滑坡,正是处在这样的背景。IDC 的统计显示,全球 PC 出货量从去年同期的 7850 万台缩水至 6270 万台。
Omdia 的统计也指向同一趋势:全球台式机、笔记本和工作站出货量同比下降 21.2%。
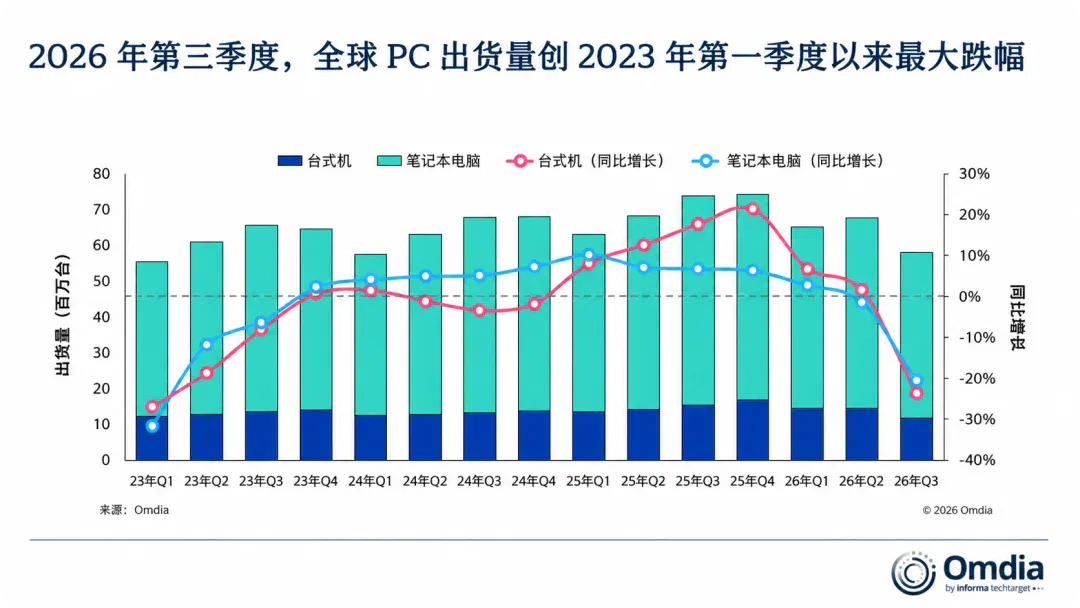
不过,把这笔账全算在内存头上并不公平。这是多重因素叠加的结果。
一方面,去年同期的基数本就偏高。Windows 10 停止支持引发的换机需求在 2025 年集中释放,抬高了对比的基准线。
另一方面,上半年的抢跑式备货打乱了下半年的节奏。
为了赶在内存进一步涨价前囤货,部分品牌和销售渠道提前加仓,一些原本属于后续季度的订单也随之前移。等到第三季度,高售价劝退了终端买家,渠道又得消化已有库存,寅吃卯粮之后,继续向厂商订货的劲头自然弱了。
更糟糕的是,一向由返校季带量的第三季度,因此没能等来惯常的旺季。
IDC 分析师 Jitesh Ubrani 认为,库存压力或倒逼渠道促销,但价格想回到一年前的水平,恐怕开弓没有回头箭。
摆在厂商面前的无非几条路:继续涨价、自己扛下部分成本,或者降低配置、延长成熟平台的服役期。DDR4 的重出江湖,正是这场取舍的产物。
The Verge 的记者在近期采购内存时发现,一套 32GB 的 Corsair Vengeance DDR5 套装售价 620 美元,对应的 DDR4 套装只要 260 美元。单品报价虽不能代表整个市场,但 360 美元的差价,足以左右一次装机决定,一分钱难倒英雄汉。
DDR5 在带宽和能效上技高一筹,DDR4 也没能躲过这波涨价潮。然而对于手里已有 DDR4 内存的用户,旧内存继续上岗,就能省下一笔升级费用。
技嘉此次公布的兼容计划,恰好递上了这样一个台阶。LGA1700 于 2021 年随第 12 代酷睿登场,平台原本就连着 DDR4、DDR5 两类主板两条腿走路。按照公告,现有 B760、H610 用户更新 BIOS 后,即可坐等后续处理器升级。
不过,两类内存需要对应的主板,不能在同一插槽里互换。公告也没有披露新处理器的型号、架构或实际性能,目前能够确定的是,旧平台将继续获得新产品支持。
AMD 一侧,技嘉已于今年 8 月宣布新一批 AM4 主板,配合 Ryzen 7 5800X3D 的重新推出,为坚持 DDR4 的装机方案再添选项。
过去,新平台总爱把处理器、主板和内存升级打包出售,逼着用户整套换新。如今,能替用户保住多少现有硬件,反倒成了产品竞争力的一部分。成熟平台可以省下整套换新的支出,但已经买到手的电脑,还能不能老树开新花、承担更多任务?开源开发者正在从软件层面尝试回答这个问题。
跑千亿大模型,个人游戏 PC 也能螺蛳壳里做道场
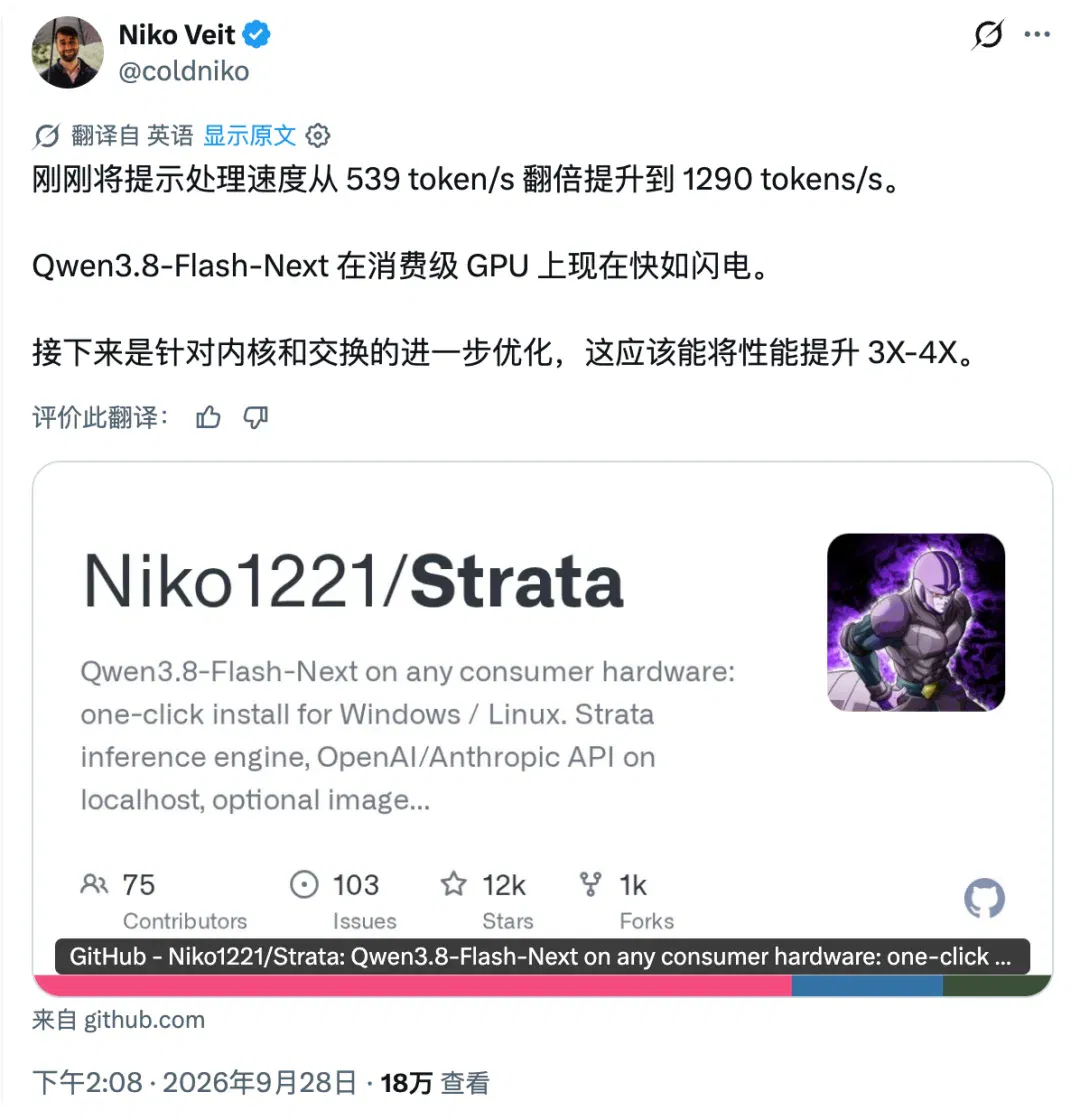
最近,一个名为 Strata 的开源项目在 GitHub 上走红,累计获得约 1.95 万颗 Star。
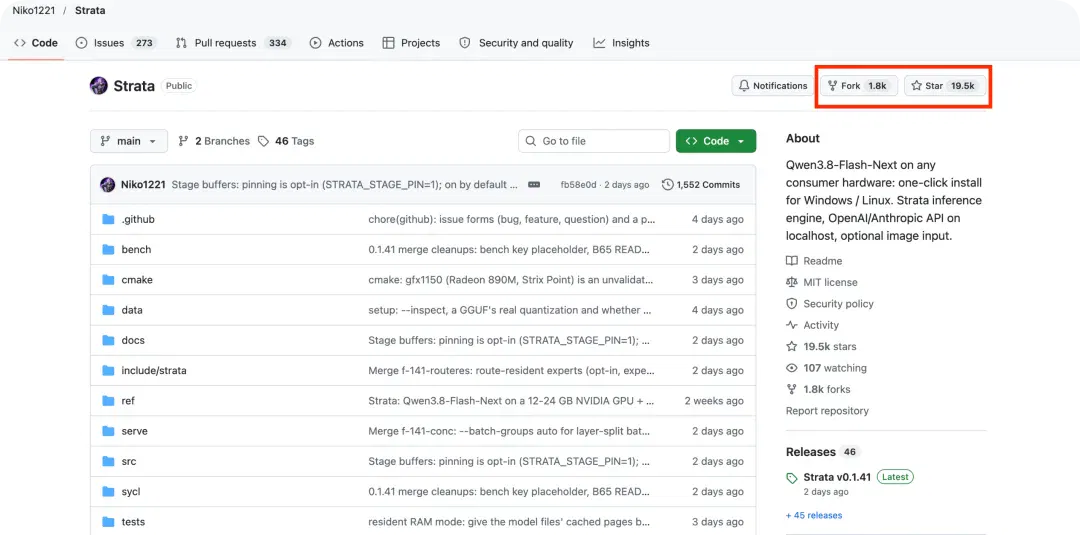
图|🔗 https://github.com/Niko1221/Strata
它最大的亮点,就想让一台普通游戏电脑小马拉大车,驱动拥有 1250 亿参数的 Qwen3.8-Flash-Next。
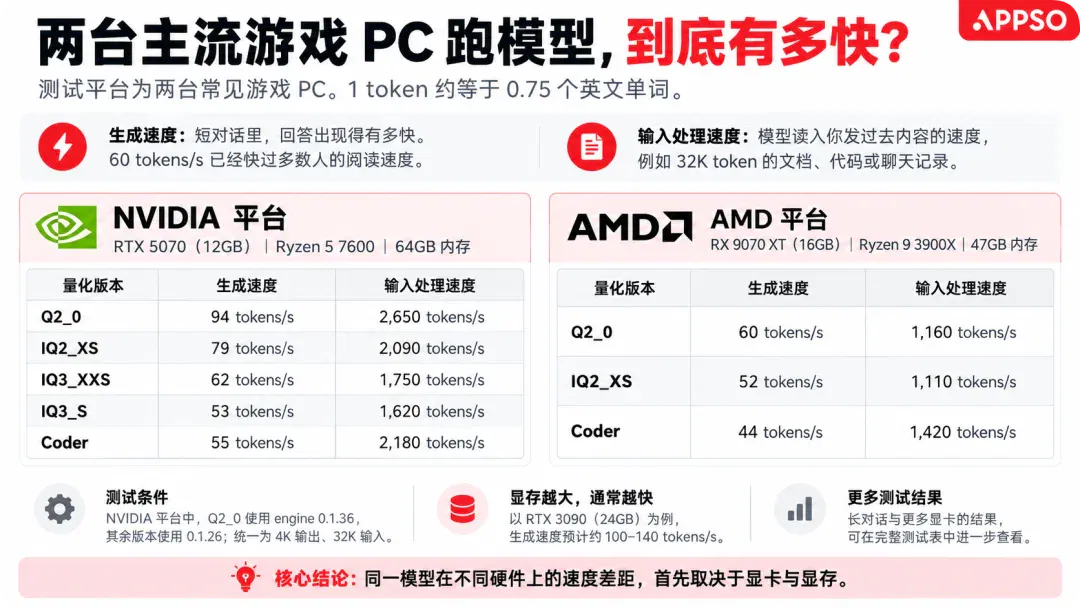
按照 Strata 项目公布的测试,一台配备 RTX 5070 显卡、12GB 显存、Ryzen 5 7600 处理器和 64GB 系统内存的电脑,在 Q2_0 量化配置下,回答生成速度可以达到每秒 94 Token。
冷知识,94 Token/秒比普通人阅读速度快大约 10 倍。如果模型以这个速度实时输出文字,屏幕上的内容会像瀑布一样刷屏,你只能看到文字在滚动,根本来不及逐字读完。
如此大的模型能在消费级电脑上跑起来,秘诀在于让显存、系统内存和 CPU 各显神通,分担工作。
Qwen3.8-Flash-Next 采用 MoE 混合专家架构,模型里住着一大群各司其职的专家模块,每次计算只点其中几位的将。总参数量虽大,生成每一个 Token 时却不必全员上阵,颇有杀鸡焉用牛刀的精打细算。
Strata 正是吃透了这种稀疏性:高频使用的专家缓存在显存中,全部专家权重则保存在系统内存里。显卡负责核心计算,CPU 并行处理没有缓存在显存中的专家,SSD 则存放大型查找表。
对于用户而言,可以把它理解成给整台电脑重新排兵布阵:显卡干擅长的活,系统内存出大容量,CPU 也参与推理,有限的显存不必再一个人扛下所有。
量化则进一步为模型瘦身。权重经过低比特压缩后占地更小,但压得越狠,回答质量越打折扣。
每秒 94 Token 对应的是项目中的 Q2_0 版本。同一套测试硬件上,压缩更温和的 IQ3_S 版本生成速度为每秒 53 Token。鱼与熊掌之间,速度、内存占用和模型效果仍需取舍。
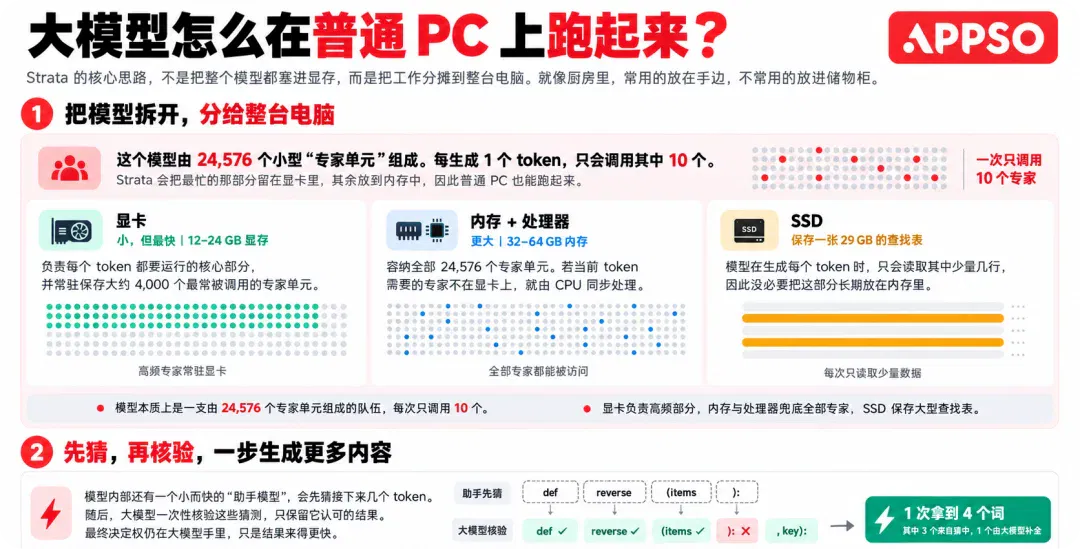
项目还采用了推测解码,让较小的辅助模块提前预测后续 Token,再由主模型批量验证。按照开发者的说明,这项机制可以带来约 1.6 至 1.8 倍加速,其收益取决于预测被接受的情况。
需要注意,推测解码可以减少生成过程中的串行计算步骤,加快输出速度,却无法消除低比特量化造成的精度损失。
即便接受这些妥协,本地运行依然很「真香」。
按照项目说明,Strata 支持聊天、编程和可选的图像输入,还能通过兼容 API 与应用、编程助手连接。推理全程在本机完成,给了用户云端调用之外的另一个选项。
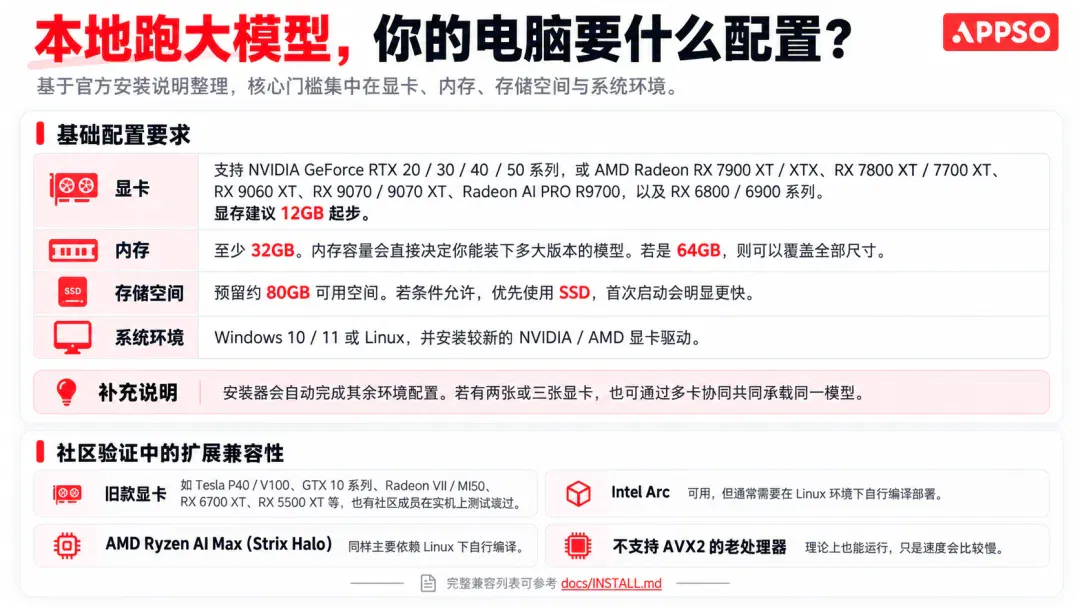
不过,12GB 显存只是入场券的一部分,系统内存同样决定体验成色。64GB 内存装得下项目列出的多个 2bit、3bit 版本;32GB 配置通常只能选精简的 Coder 版本,后者砍掉了部分专家,在中文等非编程任务上的能力也更弱。
首次启动时,项目需要把几十 GB 数据搬进内存,电脑可能卡上 1 到 3 分钟。长文本还需预先处理,默认请求也要排队完成。跑分之外,启动等待、多任务使用和回答质量,都决定它能否胜任日常。
启动等待、内存要求和回答质量上的取舍,意味着 Strata 距离日常好用仍有门槛。
但它展示了一种可能:同一套硬件,通过更合理地分配计算和存储任务,也能运行过去难以容纳的大模型。电脑能做多少事,除了取决于买了什么硬件,也取决于软件能把这些硬件用到什么程度。
换句话说,无论是本地软件挖潜,还是云端服务降价,获取智能的门槛都在变低。
也正是在这样的背景下,一个反差显得格外刺眼:知名风投机构 a16z 发布过一张引用高盛数据的图表,显示 LLM 价格指数用约三年,就走完了个人电脑价格指数约十五年的降价路。
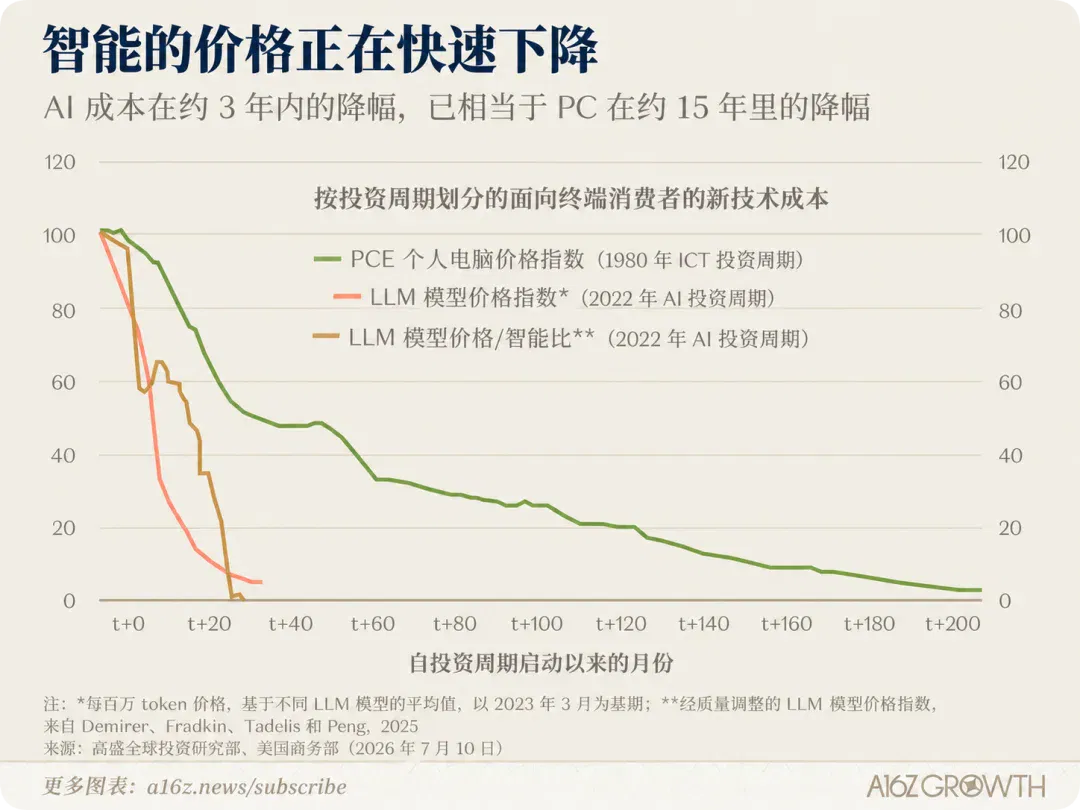
智能服务越来越像一种廉价的数字快消品,承载智能的内存、芯片和计算设备,却仍然被产能与供需卡着脖子。于是,科技行业一边把更强的 AI 塞进普通人手里,一边又让普通人为一根内存条一分钱掰成两半花。
我们可能正迎来智能越来越便宜的时代,却也正在经历一场由智能需求亲手推高的硬件成本危机。把榨干每一分性能的规矩立住了,为这场 AI 繁荣买单的我们,才能不那么烧心。
文章来自于微信公众号 “APPSO”,作者 “APPSO”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
General AI models enter hardware development, from files to prototypes (opens in a new tab)
Youxin reviews hardware-design examples involving OpenAI, Anthropic and engineering tools, spanning circuits, enclosures, firmware and CAD. Some prototypes were built and tested, but digital checks, engineering review and physical reliability remain distinct hurdles.
Suisheng raises tens of millions of yuan for Memoket wearable AI memory (opens in a new tab)
Zhidx interviews Suisheng founder Wang Shiyuan about the Memoket Gem wristband, KITE long-memory engine and software subscriptions. Funding, battery life, early user results and benchmark figures are company statements; long-term use remains to be tested.
Turning an unused Android handheld into an AI terminal with buttons, NAS memory and home control (opens in a new tab)
The author rebuilds a handheld around a Big Fat Fish character, voice input, meeting archives and Mijia controls. The project also exposes audio conflicts, button noise, clipped speech and excessive token use from camera polling.
How long is the window for AI recording hardware? From audio capture and transcription to personal-agent context (opens in a new tab)
GeekPark examines watches, recording cards and wearables, discussing system access, memory filtering and interface integration. Its six-month window is the author's forecast of competition.
iQIBLA opens Aura Premium preorders, bringing recitation counting and records to a ring (opens in a new tab)
The ring combines touch counting, display prompts and prayer reminders with app-based recitation records. The four million sales mentioned in the report refer to cumulative sales of the brand’s products.