于是转身向具身走去|对话王家伟:深朴智能00后首席科学家
深朴智能24岁首席科学家王家伟在播客对话中回顾了从中科大少年班、MSRA、DeepSeek到字节Seed的经历,阐述放弃大模型舒适区转向具身智能创业的原因,认为具身系统既需要通用大模型承担理解与规划,也需要能毫秒级快速反应的动作模型,并介绍了深朴智能在开源HiFi-UMI数据集、自研高精度UMI手套及构建Agentic OS方面的全栈研发进展。
本周「十字路口」的嘉宾王家伟是 24 岁的深朴智能(Simple AI)首席科学家。中科大少年班、MSRA、DeepSeek、字节 Seed——这条路直通大模型的最前沿,但毕业时,他却转身向具身走去。为什么呢?
他想离开的不是大模型,而是只能跟随既定计划的状态。他说:「风浪越大,鱼越贵」——具身的路线、评估和产品都还没有共识,风险更高,却也给了年轻研究者定义问题的空间。
本期播客中,我们从 GPT-6 Astra 出发,讨论了「OpenAI 会不会降维打击具身模型」的问题。王家伟认为,通用大模型会承担越来越多理解与规划,但当杯子开始滑落,机器人仍需要能快速反应的动作模型。
深朴智能因此从 HiFi-UMI 数据、具身基础模型、Agentic OS 一直做到本体:开源 2,000 小时数据,内部积累数万小时;模型已观察到一定的 Zero-shot 泛化;Agentic OS 则把上层意图与底层动作连接起来。
最后,我们讨论了在美国的具身同行们最新发布的各种工作:GEN-1.5 对预训练与自然涌现的验证、π0.7 对 steerability 的强化、以及 Skild AI 为 Demo 专门训练的 In-Context Learning 是否被高估。
微信收听播客:
小宇宙收听播客:
🎬 视频播客已同步上线于 @Koji杨远骋 的视频号、小红书、哔哩哔哩、Youtube 等平台
快问快答
👦🏻 Koji
我们先快问快答。你的年龄?
🧑🏻💻 王家伟
24 周岁,下个月过 25 岁生日。
👦🏻 Koji
求学经历?
🧑🏻💻 王家伟
小学和初中在小县城,高中在合肥一中;高二参加高考进了中科大少年班;2020 年拿到中科大和 MSRA 联合培养 PhD 的机会,2026 年刚刚毕业。
👦🏻 Koji
MBTI 和星座?
🧑🏻💻 王家伟
MBTI 是 ENTJ,不过 E 大概只有 50%。天秤座。
👦🏻 Koji
一句话介绍深朴智能。
🧑🏻💻 王家伟
深朴智能是一家面向家庭的通用具身智能公司。Slogan 是 Keep The World Simple,让世界变简单,这也是英文名 Simple AI 的由来。
👦🏻 Koji
上一场播客和清华叉院助理教授徐梦迪聊,她在李飞飞组做过博士后。她说飞飞特别喜欢引用爱因斯坦的一句话:让事情保持简单,但不要过于简单。你怎么看?
🧑🏻💻 王家伟
这话很有道理。AI 领域有一个著名的奥卡姆剃刀原理,过度设计很多事情反而不 work。保持简单,做好充分的实验验证,才能证明事情真正有效。
过去很多学术研究,比如 NLP 和早期的 CV,都在过度设计模型结构,后来突然发现,一个架构非常 simple 的 GPT 把事情全干掉了。
👦🏻 Koji
前几天遇到一个研究员,OpenAI o1 出来后他们也做类似的训练,因为他是做 Infra 的,他设计了一套非常复杂的架构。结果 DeepSeek-R1 发布,他们团队花了两周删代码,删掉了 90%, 发现根本不需要那么复杂的设计。
🧑🏻💻 王家伟
是的。
👦🏻 Koji
在深朴智能之前的工作经历是怎样的?
🧑🏻💻 王家伟
刚 PhD 毕业,主要经历在博士期间。在 MSRA 待得最久,跟着博导霍强老师做文档智能研究。
2024 年大语言模型展现出很多小模型做不了的能力,我去了 DeepSeek 多模态组实习,参与了 DeepSeek-V3 的预训练数据工作。
后来觉得语言模型开始从 Chat 往 Agent 演进。Chat 很难产生大商业价值,但 Agent 能真正提升工作效率。所以在 2025 年,我去了 ByteDance Seed 内部很早做 Agent 的团队实习。
👦🏻 Koji
现在在深朴智能做首席科学家,小时候梦想过长大做科学家吗?
🧑🏻💻 王家伟
还真想过,过生日时确实许过愿。
👦🏻 Koji
小时候想象的科学家和今天实际的工作,有什么相同与不同?
🧑🏻💻 王家伟
当时想的是在实验室做生物、化学实验,或者在数学这种基础学科里提猜想,对计算机科学家完全没有概念,这是最大的不同。
相似的地方在于,我确实有机会去探索大家还不知道答案的领域。
👦🏻 Koji
现在花时间最多的研究课题是什么?
🧑🏻💻 王家伟
具身基础模型的预训练到底应该怎么做。目前各种技术路线完全没有收敛,我们在走一条自己的路。
GPT-6 能成为机器人大脑吗?
👦🏻 Koji
前两天,GPT-6 Astra 发布,社交媒体上全是它直接驱动机械臂做各种任务的视频。你看到那些演示是什么感受?
🧑🏻💻 王家伟
挺有冲击力的。一开始很难想象一个通用的语言模型,在具身任务比如抓积木上,成功率能做到这么高,能力超乎想象。
其实用 LLM 做 Robotics 并不是新概念,几年前行业里就在做 Code as Policies,前几个月李飞飞老师团队和 Jim Fan 团队也发布了 CaP-X。但早期的 Code as Policies 还要依赖小模型做感知和识别,GPT-6 把小模型的感知定位能力原生融合了进去,充分调动了 3D 空间理解、场景认知、长程规划和试错反思能力。
有一个 demo 让我印象很深:机械爪上绑了一支笔去画金门大桥。看成品会觉得惊艳,但仔细看过程,它其实画了四遍。第一遍明显在摸索如何用笔,第二遍勾出轮廓,第三遍、第四遍细节才真正清晰。很大能力来自任务的试错、理解与经验总结,再结合底层的定位与空间理解。
👦🏻 Koji
画四遍是每画完一遍有摄像头传回去,自己再去调整?
🧑🏻💻 王家伟
它实时读取视频流。画完一张如果不好就丢掉,换一张新白纸,但之前的上下文一直留在上下文窗口里。
它清楚刚才经历了什么、为什么没画好,逐渐调整用笔和控制末端的操作能力。
基模公司会击穿具身模型吗?
👦🏻 Koji
现在有一种说法,OpenAI、Anthropic 这类基模大厂才能做出终极的具身大脑,这对垂直做具身模型的创企可能会是降维打击,你怎么看?
🧑🏻💻 王家伟
具身系统就像人一样,除了负责理解与决策的大脑,必须要有控制肌肉反应的小脑。
GPT-6 确实能直接操纵机械末端,但仔细看,执行频率非常慢,单次推理耗时很久,视频很多经过了 16 倍或 32 倍速快进,静态环境可行,但真实物理世界是动态的,比如桌上有半杯水,如果机械臂抓取的瞬间打滑,杯子一旦倾斜打翻,系统几乎无法 recover。
这种毫秒级的动态调整不能单靠大脑慢思考,必须依赖具备肌肉反应的小脑 Action Foundation Model。
大脑和大模型之间肯定有重叠,但分工很清晰:上层是大模型做复杂场景理解与任务规划,底层必须配上优秀的 Action Policy,做到快速调整和敏捷反应。
👦🏻 Koji
你认为具身大脑未来会在语言模型架构里加入具身数据自然涌现,还是会有全新的架构出来?
🧑🏻💻 王家伟
大脑这一侧大概率已经收敛在 GPT 这一类架构上了。它的常识推理和 Agentic 能力极其强大,从头造一套新范式把它替代掉并不现实。
更合理的路径是沿着现有路线往前推,把第一人称视角和第三人称视角的交互视频转换为可训练的任务形式训进去,强化物理世界理解能力。基模大厂也都在这么做。
👦🏻 Koji
聊聊少年班,一届大概多少人?
🧑🏻💻 王家伟
三十几个人。
👦🏻 Koji
这批人身上有什么共同点?
🧑🏻💻 王家伟
自驱力强,思维敏捷,对新知识的吸收和转化速度非常快。
👦🏻 Koji
少年班是怎么选拔的?
🧑🏻💻 王家伟
高一、高二甚至初三,年龄在 15 周岁以内去参加高考。成绩达到中科大在当地录取线下浮 20 分以内进面试。
面试当天把所有候选人聚在一起,同时上一堂大学难度的数学课和物理课,刚上完立马发试卷考试,直接考验在没有基础的前提下,专注力和短时间内的知识消化转化能力。
通过之后再由院长一对一聊,问一些开放性问题,比如跟不上教学、想换专业怎么办。
👦🏻 Koji
面试淘汰率高吗?
🧑🏻💻 王家伟
大概 100 个人进复试,选三四十个。
👦🏻 Koji
少年班经历留下最大的影响是什么?
🧑🏻💻 王家伟
最直接的是摆脱了高三,没有经历过高强度的题海战术。
👦🏻 Koji
没有被高三荼毒,交大 ACM 班俞勇老师曾说,大学第一年花大量精力帮学生洗刷高三带来的毒害,大二才算真正进入培养。
🧑🏻💻 王家伟
大一全是基础通识课,数理化生和计算机都要学,看清兴趣点再选专业,我大一下就选了计算机。
科大的科研资源很多,本科就跟着老师做很早期的 AI for Science,用计算模拟研究生物分子马达的相变过程。
另外我当了挺长时间少年班班长,学生工作做得多,比较擅长沟通,人缘也还不错。
👦🏻 Koji
很典型的 ENTJ。
🧑🏻💻 王家伟
对。
什么才是真正的聪明?
👦🏻 Koji
在周围全是天才的环境里成长,你现在怎么理解“聪明”?
🧑🏻💻 王家伟
以前理解比较粗浅,觉得是思维敏捷、学东西快。现在看,思维敏捷的人太多了,这不稀缺。
我觉得聪明最核心的特质有两点:第一是会提好问题;第二是清楚自己的不足,并且愿意直面它。
👦🏻 Koji
你的不足是什么?
🧑🏻💻 王家伟
对硬件的理解不够深。我的父亲是计算机老师,我从小对软件极度感兴趣,但对焊板子、搭电路一直提不起劲。
在深朴智能做 Robotics 硬件是绕不开的必修课。我知道这是短板,所以会经常向硬件团队请教,寻求支持。
为什么离开大模型做具身?
👦🏻 Koji
很多人习惯发挥优势,之前在 DeepSeek、Seed 做大模型多模态这种偏软的工作,转到具身意味着要直面大量陌生的硬件和工程挑战,为什么做这个选择?
🧑🏻💻 王家伟
作为一个 New Grad,希望能去到一个能自己定义事情的领域。
大语言模型已经比较收敛、高度工业化了。年轻毕业生进大厂,绝大多数时候是在执行定好的计划,很难按照自己的想法去探索新方向。但具身智能目前整个行业都处在高度未收敛的状态,有太多关键点等待突破。面对没有强认知的东西,我有一种本能的冲动想去彻底搞清楚。
👦🏻 Koji
对多数人来说,技术没有收敛意味着巨大风险,但在你眼里是机会?
🧑🏻💻 王家伟
风浪越大鱼越贵。正因为没有标准答案,才有做出突破性成果的可能。
导师也一直鼓励我:年轻人就该去闯,就算失败了也无所谓,只要积累了足够经验,随时能开启下一段事业。我对风险的承受度比较高,风险和机会永远并存。
👦🏻 Koji
眼下最大的风险是什么?
🧑🏻💻 王家伟
时间。如果底层路线踏错了,探索几年发现完全走在错误的路上,这种打击对个人来说是最大的。
👦🏻 Koji
具身领域的各种探索里,哪些技术路径的风险正在浮现?
🧑🏻💻 王家伟
核心在于大家对具身的“智能”定义模糊。机械臂按固定轨迹抓起一个杯子,根本谈不上智能。
在深朴智能内部,重点关注模型的三种核心能力:
第一是适应能力,包括 Zero-Shot 泛化,以及面对完全 OOD 场景时只需 Few-Shot 就能迅速适应;
第二是 Steerability,可操控性。不仅能听懂自然语言,还能理解图像和视频输入,给一段人类演示视频能立刻 follow;
第三是原生上下文理解能力。很多具身模型只依赖当前单帧 Observation,忽视了时间序列上的因果,而物理世界的 Dynamics 必须依靠 Context 才能涌现。
基础模型完全是沿着这三点去做的。
👦🏻 Koji
回顾读 PhD 这几年,正好赶上大模型和具身飞速发展,怎么划分自己的研究阶段?
🧑🏻💻 王家伟
主要分两个阶段。前半段在 MSRA 霍强老师组做文档智能,也是博士课题。霍老师非常看重研究的实用价值,我们做的 OCR、版面分析、表单理解算法,都部署进了微软云 API 和内部基础设施,我习惯了去思考学术研究能不能对落地产生实际商业价值。
后半段大模型时代来临,希望成为浪潮里的弄潮儿,先后去 DeepSeek 和 Seed 实习,做多模态语言模型、强化学习和 Agent。
DeepSeek:不靠工作强度换成果
👦🏻 Koji
去 DeepSeek 时是在 V2 发布之后、R1 问世之前,当时团队内部是怎样的氛围?
🧑🏻💻 王家伟
研究者心态非常纯粹,不急着考虑商业化落地,注意力都在推动智能边界上。
印象最深的是工作强度并不大,但产出极其惊人。这说明对 Researcher 来说,高强度工作时长不是产出好成果的必备条件。团队少而精,每个人独当一面的 Scope 很大,底层核心的训练和推理 Infra 代码都能接触到。
👦🏻 Koji
当时是怎么加入 DeepSeek 的?
🧑🏻💻 王家伟
一方面有 MSRA 的师兄提供信息,另一方面当时做 DeepSeek-VL2,文档处理是核心应用方向,HR 找到我,背景很 match 就去了。
👦🏻 Koji
DeepSeek 体验很好,后来为什么选择去了 Seed?
🧑🏻💻 王家伟
当时 DeepSeek 核心资源倾斜在语言模型上推 R1,多模态团队资源相对受限,而且继续做下去很多是在复用过去的经验。
我当时已经看到 Agent 的潜力,而 Seed 内部正好有一个很早探索 Agent 的团队,就决定过去实习。
👦🏻 Koji
在 Seed 和 DeepSeek 两家顶尖团队,实习体验有什么不同?
🧑🏻💻 王家伟
DeepSeek 人少扁平,负责的边界更广。
Seed 像一台极其庞大且精密运转的仪器,专业分工极细,每个人都锚定在关键点上,很难 touch 到范围之外的事。
这是一把双刃剑:好处是工程团队把 Data Infra、Training Infra 准备得非常完善,拿来就用;代价是研究人员对底层链路的掌控感相对弱一些。
👦🏻 Koji
后来发生了什么具体事件,促使离开纯软件的大模型领域,跨入具身智能创业?
🧑🏻💻 王家伟
2025 年底在 Seed 实习时,我特别想推模型自进化——把模型部署成 API 对外提供服务,通过收集用户反馈自我迭代。
但在大公司体制下,做这种探索成本极高。API 对外暴露要涉及多部门协同,需要前期做大量充分的 POC,而且探索性项目能拿到的资源其实不多。语言模型已经高度收敛,New Grad 进去很难自己定义事情,更多是跟紧大部队推业务。
正好深朴智能在做具身全栈研发,创始团队给了很大的自由度,加上具身领域还有大量未收敛的课题等待研究,就决定加入了。
深朴智能为什么必须做全栈?
👦🏻 Koji
深朴智能从底层数据、模型、本体一直做到上层的 Agentic OS,全链路都在做,背后的考虑是什么?
🧑🏻💻 王家伟
深朴智能对自己的定位是一家终端产品公司,不是纯数据公司,也不是纯模型公司。
具身产业链极长,从数据、模型、部署到真机,中间任何一个环节缺失,都无法产生最终价值,因为用户买单的是完整的产品。
做全栈不是为了做全栈而做全栈,而是为了达成目标不得不做全链路。全栈会形成很大的壁垒:如果行业上游模型突然爆发,因为我们拥有完整的数据与真机链路,可以快速 follow、迭代进自己的产品,迅速从真实场景中拿到用户反馈。
👦🏻 Koji
深朴智能前阵子开源了数据集?
🧑🏻💻 王家伟
上月底开源了预训练数据集 HiFi-UMI,这是训练基础模型的基石。在 Hugging Face 和 ModelScope 上的累计下载量已经超过 50 万了。
👦🏻 Koji
开源了多大体量?
🧑🏻💻 王家伟
开源了 2000 个小时的高质量数据,内部储备已经到了几万小时量级,大概做了半年时间。
最开始没想过自己做这么精细的数采硬件,希望能采购现成设备,但测了市面上很多数采设备后发现,精度和时间同步根本达不到预训练要求。
👦🏻 Koji
自研的数采设备是什么样的?
🧑🏻💻 王家伟
自研了一套超高精度的 UMI 手套。UMI 是斯坦福宋舒然老师团队提出的通用操作接口,数采员戴着夹爪手套操作,把轨迹记录下来作为训练语料。
中间攻克了两个关键点:
一是彻底抛弃基站。过去业内做高精度轨迹恢复,必须在桌上架设多个基站,我们通过自研视觉方法,只用机载相机就做到了毫米级定位;
二是微秒级的时间戳同步。很多团队做 UMI 会遇到时间戳不同步的问题,只能靠后处理算法去补,而我们在源头上保证了数据绝对精准。只有这样,模型侧做实验时才能有效控制变量。
👦🏻 Koji
整套设备上有几路相机?
🧑🏻💻 王家伟
一共六路相机:头部有一组双目相机;两个手腕部分别有朝上和朝下的两对相机。上下双视角是为了防止操作时出现视觉遮挡。
👦🏻 Koji
为什么采这么多视角?平衡点在哪里?
🧑🏻💻 王家伟
腕部相机是必需的,两指夹爪在精巧操作时必须保证视野无遮挡,光靠头部极容易被遮住;头部相机最主要的原因是做 SLAM 高精度空间定位以抛弃基站,未来还可以迁移到 Egocentric 数据采集上。在这个项目上我们没有做过度设计。
👦🏻 Koji
最初怎么验证采集到的数据有真正的训练价值?
🧑🏻💻 王家伟
国内真正把 UMI 跑通的团队非常少,中间踩了很多坑。
第一批数据采回来后,在开源基座上做 Fine-Tuning,直接做真机评测看任务成功率。验证通过后确信只要采集方式正确,就能扩展到更多任务。
另外在仿真环境里做轨迹 Replay,看采回来的轨迹在机械本体上能不能顺畅做出来,发现 95% 以上都能复现,坚定了大规模采集的信心。于是扩充设备、租赁场地展开大规模采集。
👦🏻 Koji
目前采集数据和标注清洗的投入比例大概是怎样的?
🧑🏻💻 王家伟
早期采数据投入更高,除了在专用场地采,还去家庭、酒店、民宿做外采,扩充数据分布的多样性。
但最近在标注清洗上的投入反超了采集。直接拿粗糙原始数据训练虽然也能 work,这证明数据精度高,但由于存在标注和实际动作的mismatch,非常影响模型的学习效率。所以现在的重点是建立标准化、自动化的数据清洗管线。
👦🏻 Koji
Astra 让自动标注成为可能?
🧑🏻💻 王家伟
我们试着用 GPT-6 Astra 做了一批清洗和标注,发现比人工标得还好,能 24 小时运转,成本和人工差不多。
唯一的限制是 API 额度和单次效率,所以我们用类似 Astra 标出的高质量数据去训练自研的标注小模型,小批量持续迭代,效果已经很不错。
👦🏻 Koji
把投入巨大的 2000 小时数据开源,你们是出于什么考虑?
🧑🏻💻 王家伟
做研究出身的人都有开源情怀,希望自己的工作被社区看到和使用,推进社区发展,2000 小时对高校 lab 已经很实用了。
另一方面,也是希望从社区收集反馈,持续迭代数采硬件。
👦🏻 Koji
开源后收到了哪些反馈?
🧑🏻💻 王家伟
很多海内外公司发邮件想买数据。
技术反馈主要有两点:一是手部用来定位的二维码 Marker 太大,对视觉算法有干扰,希望能做小;二是手套在真机上长时间运行发热有点明显,涉及相机模组供应商的问题。这些反馈很实用。
机器人真能 Zero-Shot 吗?
👦🏻 Koji
你们年底将发布的模型,有哪些可以提前透露的进展?
🧑🏻💻 王家伟
模型在预训练后已经展现出了很强的 Zero-Shot 泛化能力。
行业里之前很少有模型能直接 Zero-Shot,大多依赖真机后训练在 Benchmark 上刷分,我们做 Zero-Shot 验证是为了看清模型底层的真实能力。几千个任务预训练完后,不需要后训练微调,就能直接泛化完成一些全新的任务。
👦🏻 Koji
类似 GEN-1.5 看 3 秒视频就能学会的能力?
🧑🏻💻 王家伟
GEN-1.5 是 One-Shot,需要给一段参考视频。我们能有一定的 Zero-Shot 能力,我们内部讨论认为核心原因在于底层预训练数据的质量极高。
👦🏻 Koji
你们在做世界模型吗?
🧑🏻💻 王家伟
取决于怎么定义世界模型。不刻意追求概念,而是从核心能力倒推架构:无论 World Action Model 还是 VLA,只要有适合的能力点都会吸收进模型设计里。
我们不是 follow 型工作,我们会从第一性原理出发设计最适合物理智能的模型,同时充分利用已有的预训练知识。
👦🏻 Koji
刚才强调模型的三大基础能力之一是 Context,为什么 Context 这么重要?
🧑🏻💻 王家伟
做语言模型和 Agent 的人都知道 Context 是决策的核心。但具身领域过去很多人假设只靠当前单帧 Observation 就能决策,忽视了 Context 蕴含的物理因果。
具身的 Context 至少分三个层级:
短时 Context,蕴含高频的因果。比如拿咖啡杯第一次没夹紧打滑下坠,再加力重新抓稳,这一秒内发生的视觉下滑到重新夹紧的闭环,就是丰富的因果 Context。模型能自然学到刚才是怎么做错的、下一次如何纠正;
中时 Context,更偏向工作记忆。桌上有几个一模一样的杯子,抓第一个经历过试错,抓第二、第三个时模型已经清楚杯子宽度,可以直接迁移,不需要重复试错;
长时 Context,长程任务的记忆。做家务时半小时前把东西收进了某个抽屉,人类下达指令时能立刻找到,不需要人每次重复提醒。
👦🏻 Koji
针对 Context 在数据和模型层做了哪些设计?
🧑🏻💻 王家伟
数据层面要构造能激发 Context 利用的样本;模型层面要高效建模 Context。
长 Context 会带来巨量的 Token,导致推理延迟上升。机器人对执行延迟极其敏感,所以我们在时序建模和注意力机制上做了特殊设计,解决推理延迟和训练效率问题。
👦🏻 Koji
HiFi-UMI 数据集中没有包含触觉数据?
🧑🏻💻 王家伟
现在有些方向尝试从视频直接预测视触觉,但精度不够,很难用于真机控制。
开源数据没带触觉有两个工程考量:
第一,对于二指夹爪,配合上下双相机的无盲区设计,视觉在绝大多数情况下已经能判断是否夹紧,不像灵巧手存在严重的手掌内部遮挡;
第二,目前的触觉传感器在工业界没有收敛,分辨率和位点各不相同。如果花重金采了几万小时数据,几个月后硬件迭代,以前的数据很难复用。触觉一直在实验,但没有贸然大规模铺开。
具身 Scaling Law 出现了吗?
👦🏻 Koji
蛮有意思的。最近录另一期播客,嘉宾是做量子点的科学家,他的博导因为量子点技术拿了诺贝尔化学奖。他们做的事情就是发射出量子点来感受触觉。
回到模型上,刚才提到已经看到了一些 Zero-Shot 能力,你认为这是 Scaling Law 的信号吗?
🧑🏻💻 王家伟
Scaling Law 是非常严肃的事。我们确实观察到了 Scaling 趋势:数据多样性、数据量和算力扩展后,性能有显著提升。
但严格意义上的 Law 需要严谨的实验验证,定量确定数据量、模型规模与算力之间的比例关系,让训练可预测。
行业很多团队喜欢宣称找到了 Scaling Law,我们会克制地称之为存在一定的 Power Law。
👦🏻 Koji
这个趋势在具体任务上有什么体现?
🧑🏻💻 王家伟
预训练一两千个任务,原本以为只有样本量很大的头部任务能具备泛化能力,后来发现占比只有 0.1% 到 0.5% 的低频数据也能做好。
另外涌现出了跨任务的组合泛化。比如训练集里只有“把遥控器放进盒子里”和“把零食放进垃圾桶”,模型没见过“把零食放进盘子”,但输入新指令“把零食放到蓝色盘子里”,它不需要任何后训练,直接就能组合完成。
数据多样性一旦起来,模型能力会展现出超乎想象的跳变。
👦🏻 Koji
深朴智能发布的 Agentic OS 是什么架构?
🧑🏻💻 王家伟
具身必然是一个 Agent System,不是单点模型的事,它需要与人交互、与物理环境交互,核心在于把面向具身场景的 Harness 做好。
它包含语音识别、任务拆解、工具调用等,分为两层:System 2 是大脑,做语义理解与长程规划;System 1 是小脑,做高频精准执行。围绕 System 2 做了大量 Harness 设计,比如在 WRC 上,用户可以用自然语音多轮对话,让它去房间找衣服并送进洗衣机。
👦🏻 Koji
System 2 背后用的是什么模型?
🧑🏻💻 王家伟
之前用的是字节 Seed 的模型,因为我参与过那部分工作,比较熟悉。
👦🏻 Koji
之后会换成自研模型吗?
🧑🏻💻 王家伟
正在尝试。大脑模型对算力消耗极其巨大,对于创业公司,算力非常珍贵,现阶段会把优先级放在 Action Foundation Model 的预训练上。
通用大语言模型迭代极快,从 GPT-5 到 GPT-6 跨度很大。现在的策略是把小脑做成一个 Steerable、可控性极强的接口,借助优秀的 Harness 设计,把行业最前沿的大脑能力借力过来,反哺整套系统的商业化落地。
👦🏻 Koji
System 2 最终会是前沿实验室语言模型的延长线吗?
🧑🏻💻 王家伟
除了基模本身的能力,具身场景最关键的是 Harness。
大脑实时接收高分辨率视频流,如果上下文管理没做好,上下文窗口立刻爆炸,延迟无法承受。大脑和小脑之间的交互协议也需要深度协同设计,把小脑做到极高可控性,大脑才能自然调度。
没有 Benchmark,如何证明模型?
👦🏻 Koji
具身模型评估一直缺乏好 Benchmark,怎么看这个现状?
🧑🏻💻 王家伟
过去 Benchmark 做得确实不够好。纯仿真基准像 LIBERO,靠纯后训练微调就能刷到极高分数,没有太大参考价值。
后来出现像 RoboDojo 这种结合仿真与真机的 Benchmark,但仿真有 Sim-to-Real Gap,真机又很难跨硬件复现,第三方很难直接跑别人模型的真机测试。
具身评估考验的是整条链路在长程任务下的稳定性和成功率,现阶段最扎实的方式是自己搭建严密的真机测试集。
👦🏻 Koji
没有公允的行业标准,你们年底发布模型时打算如何证明实力?
🧑🏻💻 王家伟
唯一的方法是保持真实。
搭建严密的真机 Benchmark,从简单到复杂,测试各种场景泛化、物体泛化扰动,公开真实成功率。用了多少数据做微调就如实公布,标明 Zero-Shot 就绝不掺杂任何一条人工演示。
不同团队由于本体硬件和数据不同很难直接横向对比,最重要的是保持真实。如果有开源计划,希望能开源一个第三方拿去能在自己本体上低成本微调出好效果的模型。
👦🏻 Koji
System 1 和 System 2 未来会收敛到统一的端到端大模型,还是长期分层?
🧑🏻💻 王家伟
下层吃掉上层不太可能,但上层吃掉 System 1 确实有可能发生,只是具体什么节点会发生还很难判断。
即便能看到终局,也不能跳过阶段性必须做的事。大厂可以尝试造一个数万亿参数的端到端统一模型;对于创业公司,最务实的策略是先把 Action 能力做扎实,把小脑做到极度 Steerable,配合上层大模型规划和 Harness,先在商业场景快速落地。
👦🏻 Koji
深朴智能现在的团队规模多大?
🧑🏻💻 王家伟
70 多位同事。
👦🏻 Koji
在 DeepSeek 实习时发现大家下班很早,优秀的成果和工作时长不成线性正比。深朴智能现在加班多吗?
🧑🏻💻 王家伟
没有强硬的加班要求,全凭自驱,正常工作时间是 9:30 到 18:30。想早点走或有事随时可以下班,我自己也不会天天工作到深夜,保持思维敏捷很重要。
在 Agent 加持下,每个人更多要管理好自己的 Agent,清晰定义任务目标去推进。公司对 AI 工具的额度完全无限制。
👦🏻 Koji
内部主要用什么 Agent 工具?
🧑🏻💻 王家伟
主要用 Codex。
👦🏻 Koji
内部开会有什么特别的文化?
🧑🏻💻 王家伟
注重事先规划。CEO 会定期拉技术核心负责人自顶向下推演:什么是具身智能的智能、数据如何准备、算力如何匹配。团队内部做充分的 Context 交换,扁平化共享信息,不让信息只堵在少数人手里。
👦🏻 Koji
GPT-6 Astra 带来的最大启示是什么?
🧑🏻💻 王家伟
通用智能真的有可能外溢到物理世界,System 1 和 System 2 的边界会越来越模糊。
大语言模型视角的从业者相信它是完全有机会做到真实可用的,虽然目前推理慢,但只要把物理交互的 Action 数据融入进去,这个差距是可以填平的。
👦🏻 Koji
国内最看好谁做出类似 Astra 的物理交互能力?
🧑🏻💻 王家伟
看好两家:一个是 ByteDance Seed 的多模态团队,多模态积淀一直很领先;另一个是阿里的通义千问团队,他们内部在具身方向做得很深。
👦🏻 Koji
全球范围内,最近大半年让你很有启发的具身发布有哪些?
🧑🏻💻 王家伟
最 respect 的肯定是 Generalist 。
我觉得他们思路非常正确:GEN-0 轰到 20 万小时数据验证 Scaling;GEN-1 做到 50 万小时并跑通 9000 种构型夹爪的泛化;GEN-1.5 展示了惊艳的 In-Context Learning。
另外是 Levine 教授关于 π0.7 的工作,把 Steerability 摆在核心位置,证明只有可控性极高的小脑才能配合大脑完成复杂任务。
👦🏻 Koji
有哪些被社交媒体刷屏,但你觉得被高估的技术?
🧑🏻💻 王家伟
部分团队做的基于 Paired 数据的 In-Context Learning。
Generalist 的 In-Context Learning 让人震撼,是因为它在 30 秒长 Context 数据训练下自然涌现出的泛化,给一段极短的第三人称人类演示视频就能直接 follow。
而有些团队跟风发布的 Demo,是专门构造了配对好的 Paired 数据硬训出来的,这只是一种工程妥协,缺乏本质。真正的 In-Context Learning 必须建立在对 Context 的深刻理解和模型的强 Steerability 之上,缺失这两点,硬刷出来的 Demo 意义不大。
👦🏻 Koji
具身模型发出来别人很难复现,这会导致第三方中立 Benchmark 出现吗?
🧑🏻💻 王家伟
很难。之前有机构尝试过做真机 Benchmark,但它既当裁判又当运动员,最终不了了之。
具身模型的评估很难保证绝对公平,最终还是要看产品说话,看用户买不买账。
👦🏻 Koji
在具身领域深耕了快一年,之前在大模型领域时间更久,这两个领域有什么本质异同?
🧑🏻💻 王家伟
大语言模型整体更 Open、透明,研究成果相对可复现,有 API 可以测,DeepSeek 也会把技术突破完整开源,壁垒相对透明。
具身领域目前噱头大于真实,噪音太多。上半年大家都在吹捧 World Action Model,但真正落地跑通业务的寥寥无几,对比传统 VLA 到底好多少也没有明确结论,容易陷入浮躁。
👦🏻 Koji
在巨大的行业噪音中,怎么筛选真正的信号?
🧑🏻💻 王家伟
看两点:第一是对方讲的观点与呈现出的 Demo 细节是否吻合;第二是剥离包装后,是否符合第一性原理。
正因为具身领域没有彻底收敛,我们完全可以从第一性原理出发做正确的事。比如自研高精度数采硬件,虽然重,但从源头把控了数据质量,反而实现了弯道超车。
👦🏻 Koji
深朴智能的第一性原理是什么?
🧑🏻💻 王家伟
不断追问:到底什么是具身智能的智能?
机械臂按固定轨迹抓杯子不是智能,面对光线扰动、未见过的物体、物理打滑、全新指令时,依然能自如感知、理解并达成目标的能力,才是具身智能。
👦🏻 Koji
有没有哪种外界热捧的路线,是深度推演后主动放弃的?
🧑🏻💻 王家伟
谈不上放弃,但我们暂缓了大规模铺开 Egocentric 第一人称人体视频数据。
Ego 数据多样性极强,但从第一性原理算经济账:原始数据买来只要 30 元一小时,但后续为了将人体动作映射到机械臂上,标注清洗和模型微调的算力成本极其昂贵,泛化收益的斜率是否合算没有被严谨验证过。
UMI 数据虽然有自研硬件门槛,但自采成本可控,90% 以上的数据能直接用于高质量训练,还能在轻量算力下清晰验证参数与数据配比的规律。
在资源有限的阶段,盲目引入没算清账的大变量非常危险。
👦🏻 Koji
聊到这里突然想到,开头问你如何理解聪明,你说很核心的一点是“会提好问题”。做播客最担心的也是自己的 Prompt 不够好,没把嘉宾身上有价值的信息激发出来。
如果听播客的朋友觉得前面的对话里有什么地方可以提出更好的问题,欢迎在评论区留言,我到时候转给家伟继续交流。
现在把提问权交给你,有什么好奇想问我的问题吗?
🧑🏻💻 王家伟
有个很有意思的问题我一直比较好奇,可能和具身没什么关系:做播客和做投资之间的异同点是什么?我之前也动过做播客的念头,觉得能和各行各业的人深入交流很有意思。
👦🏻 Koji
完全可以做,哪怕拿手机在咖啡馆录音,音质都足够用。
做播客和做投资最大的相似点是:都有两个小时的时间去向一个人提问,尽可能看懂他。比如我必问的问题是“人生十字路口做过最艰难的抉择是什么”。
做播客的时候我很喜欢听故事;做投资也极度希望通过极端困难时刻的抉择,看清对方有没有创始人的 Personality。
不同点在于状态:做播客时会非常 Nice,不愿问让对方不适的问题,希望对方保持在舒适的情绪里表达;
做投资时提问必须尖锐,甚至明知会让对方不适也要追问到底,把对方逼进极端状态,因为只有那种反应才能得到更真实的答案。
回到你身上:从少年班到顶级机构再到首席科学家,一路看起来极其顺利,属于典型的别人家孩子。你经历过最艰难的十字路口抉择是什么?
🧑🏻💻 王家伟
最艰难的抉择,是留在语言模型舒适区还是转去做具身。
放弃大厂优渥的薪资和算力卡资源,去创业公司从零开始搭 Infra、设计模型、搭建团队,走出舒适区面对完全未知的不确定性,当时非常纠结。
👦🏻 Koji
当年少年班的同班同学现在都在做什么?
🧑🏻💻 王家伟
挺多人去美国读数学、物理等基础学科博士。但即便是学基础学科的同学,很多也转行来做 AI 了:要么做 AI 交叉学科,要么做 AI 量化,或者做 AI 医疗、AI 制药。甚至有一位同学去了 OpenAI 做理论研究。
👦🏻 Koji
有没有同学做非主流、非共识的选择,完全不碰 AI、不进金融,去做别的?
🧑🏻💻 王家伟
几乎没有。在人工智能的大趋势下,大家都在拥抱它。
三年后机器人能洗碗吗?
👦🏻 Koji
AI 吸光了优秀的顶尖人才。我们常说人总是高估两年的变化,而低估十年的变化,三年是一个很有趣的节点,三年后回头看今天,发生哪件事情会让你觉得进入具身行业是完全正确的?
🧑🏻💻 王家伟
之前博导聊过一个痛点:家里吃完饭虽然有洗碗机,但还是得人工把剩饭残渣倒掉,再把盘子一个个码进洗碗机,每天要花二十分钟。
如果三年后,自研的机器人能在家庭里稳定完成类似收拾残渣、装填洗碗机的事情,就会让我非常兴奋。
👦🏻 Koji
三年内实现这个目标的概率有多高?
🧑🏻💻 王家伟
概率挺高的,我认为能达到 80%。
👦🏻 Koji
非常期待三年之后帮家里洗碗的机器人来自深朴智能。谢谢家伟!
🧑🏻💻 王家伟
谢谢 Koji!
文章来自于微信公众号 “十字路口Crossing”,作者 “十字路口Crossing”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。
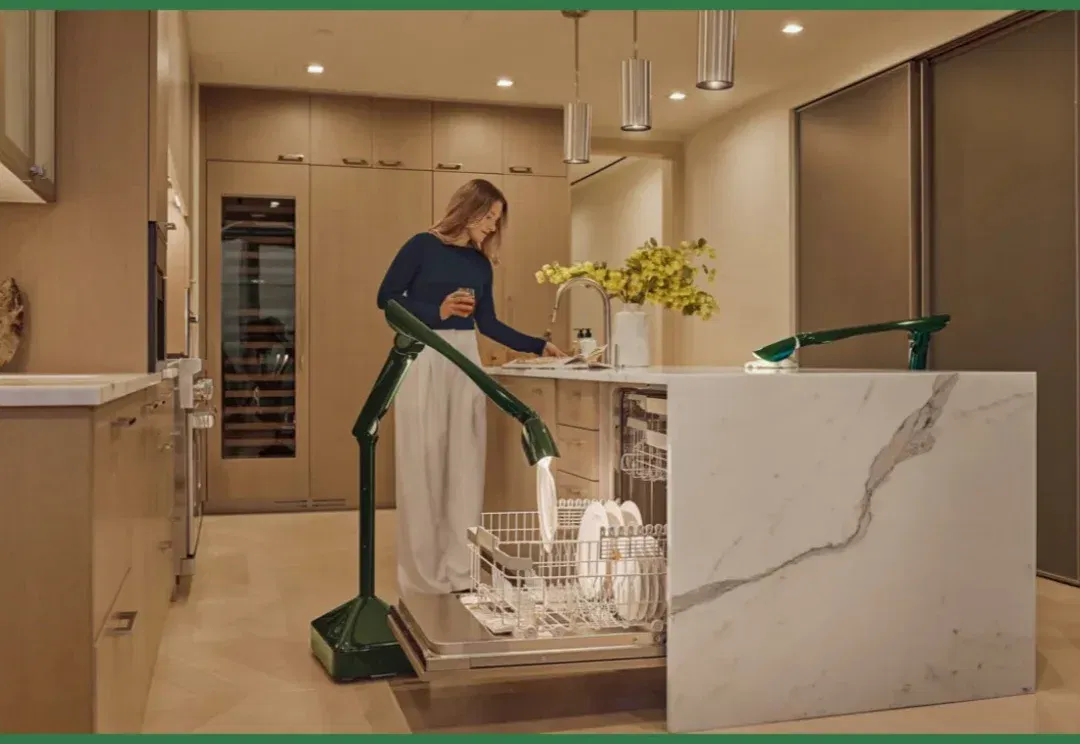
Syncere raises $11M for Lume, a household robot shaped like a floor lamp (opens in a new tab)
Syncere uses a floor-lamp form for Lume: one robot handles some pick-and-place tasks, while two work together in Duet mode on tasks such as folding clothes. Demos are edited; pricing and delivery reflect the source date, and home reliability remains unproven.
Genesis AI raises $500M Series A to advance its full-stack robotics and Eno (opens in a new tab)
Genesis AI announces funding at a $3.5B post-money valuation, outlining a stack of data gloves, simulation, models and the Eno robot. Production and customer deployments are planned; demonstrations and correlation experiments do not establish delivery at scale.

Oxford researcher proposes cognitive symbionts for wearable AI augmentation and governance (opens in a new tab)
Hao Fei's perspective paper proposes cognitive symbionts and AI-Augmented Human Intelligence, covering long-term memory, wearables, proactive help and governance. Privacy, low latency and lifelong companionship are design goals, not verified product guarantees.
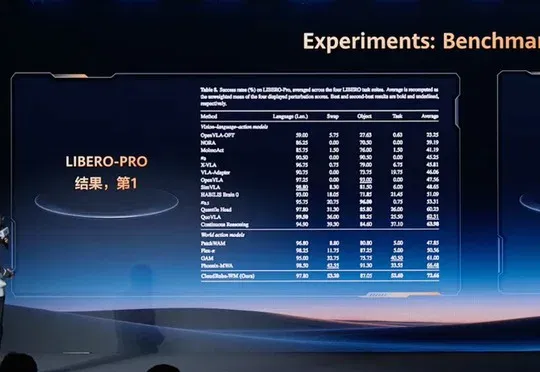
Huawei Cloud unveils CloudRobo-WM1.2, plans November 30 release of weights and code (opens in a new tab)
Huawei Cloud presents its Ascend-native embodied world model CloudRobo-WM1.2 and development platform, with two benchmark results and industrial demonstrations. Model weights, inference and post-training code, and pretraining practices are scheduled for November 30.