10个问答,深入分歧之下的具身机器人|对话苏度科技、蚂蚁灵波、自变量机器人、破壳机器人创始人、首席科学家
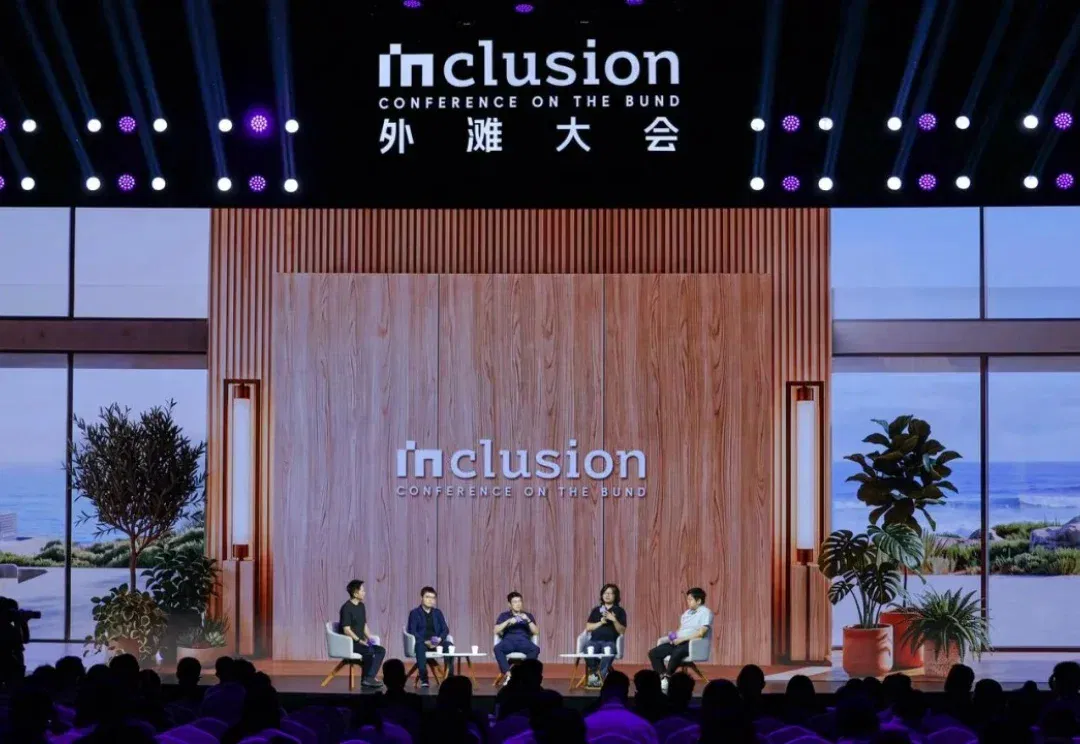
数据从哪儿来?模型怎么做?落地在哪里? 这是一次少见的、没有收敛的、关于具身路线级分歧的公开讨论。 2026 年的具身智能,已经不缺热度。缺的是有人把分歧摆上台面。数据从哪儿来?模型怎么做?落地在哪里? 如果 OpenAI、Anthropic 要做具身,会形成降维打击吗?Astra 的能力边界在哪里?造飞机像造 App 一样简单,是狂想还是触手可及? 9 月 10 日上午,2026 Inclusion·外滩大会上,一场围绕“物理智能——分歧与抉择”的主题圆桌对话拉开。本场对话由 Koji 主持,苏度科技联合创始人兼 CEO 韩铮、蚂蚁灵波科技首席科学家沈宇军、自变量机器人创始人兼 CEO 王潜
数据从哪儿来?模型怎么做?落地在哪里?
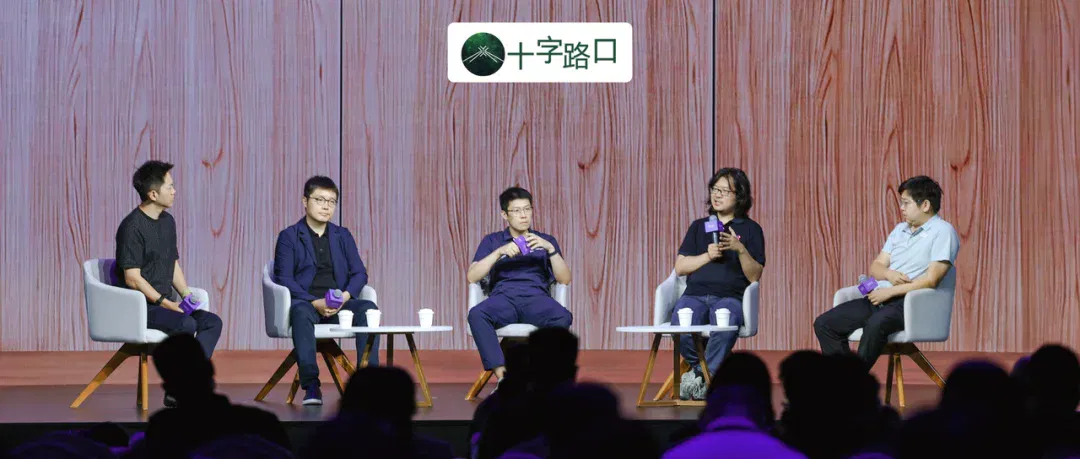
这是一次少见的、没有收敛的、关于具身路线级分歧的公开讨论。
2026 年的具身智能,已经不缺热度。缺的是有人把分歧摆上台面。数据从哪儿来?模型怎么做?落地在哪里?
如果 OpenAI、Anthropic 要做具身,会形成降维打击吗?Astra 的能力边界在哪里?造飞机像造 App 一样简单,是狂想还是触手可及?
9 月 10 日上午,2026 Inclusion·外滩大会上,一场围绕“物理智能——分歧与抉择”的主题圆桌对话拉开。本场对话由 Koji 主持,苏度科技联合创始人兼 CEO韩铮、蚂蚁灵波科技首席科学家沈宇军、自变量机器人创始人兼 CEO王潜、破壳机器人创始人、清华大学交叉信息研究院助理教授许华哲参与讨论。
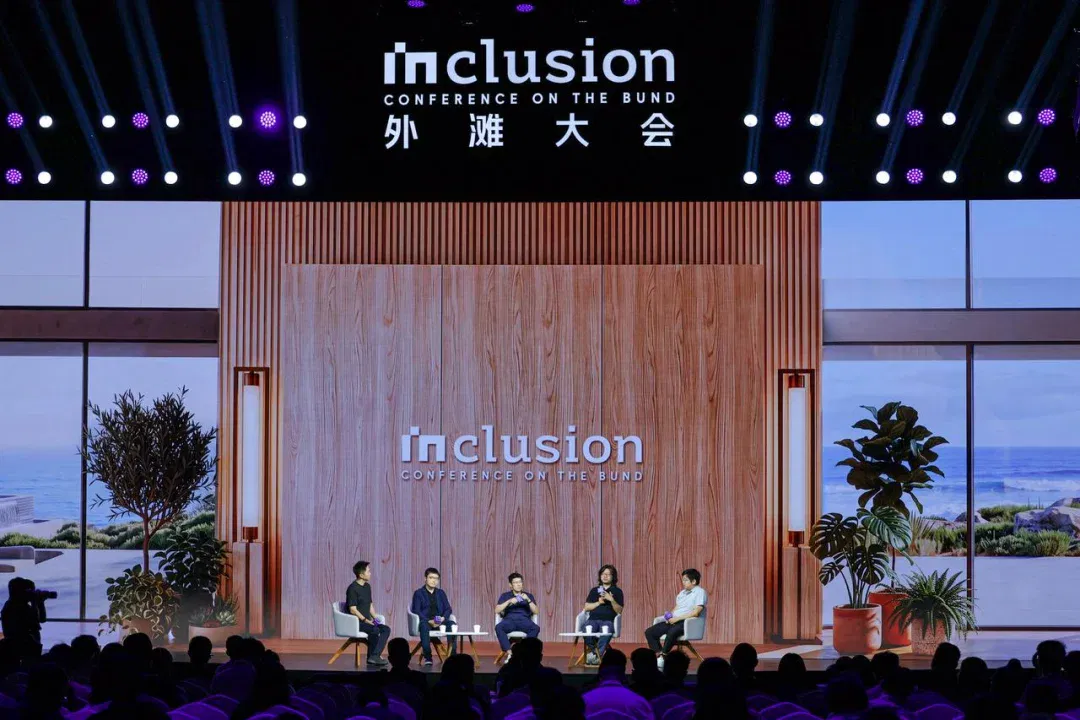
2026 Inclusion·外滩大会|“物理智能—分歧与抉择”圆桌对话
透过这场对话,你会了解到:1)不同路线的核心假设和风险;2)判断哪些指标是领先指标;3)理解语言模型公司进入具身的难度与创业公司护城河;4)具身智能商业化短期 vs 长期逻辑;5)被高估/低估的领域,可能对应投资机会或风险。
当行业不再争论“什么是对的”,而是开始各自用产品和落地去证明“什么是可行的”,一个赛道才真正进入了从泡沫走向产业的阶段。
微信收听:
小宇宙收听:
🎬 视频已同步上线于 @Koji杨远骋 的视频号、小红书、哔哩哔哩、Youtube 等平台:
以下为对谈实录,经编辑整理。
数据之争:仿真还是真机?
👦🏻 Koji(十字路口)
我们直奔主题。今天会聊三个话题:数据之争、智能之争、场景之争。
为什么都是各种“之争”?因为 2026 年,我们正处在一个十字路口,有非常多没有收敛的路径,等着大家去探索。
第一个问题想请教韩铮总:数据方面,有人押注仿真,也有人坚定押注真机,你们坚定押注仿真,当初看到了哪些信号?今天,有哪些新的增强信号?
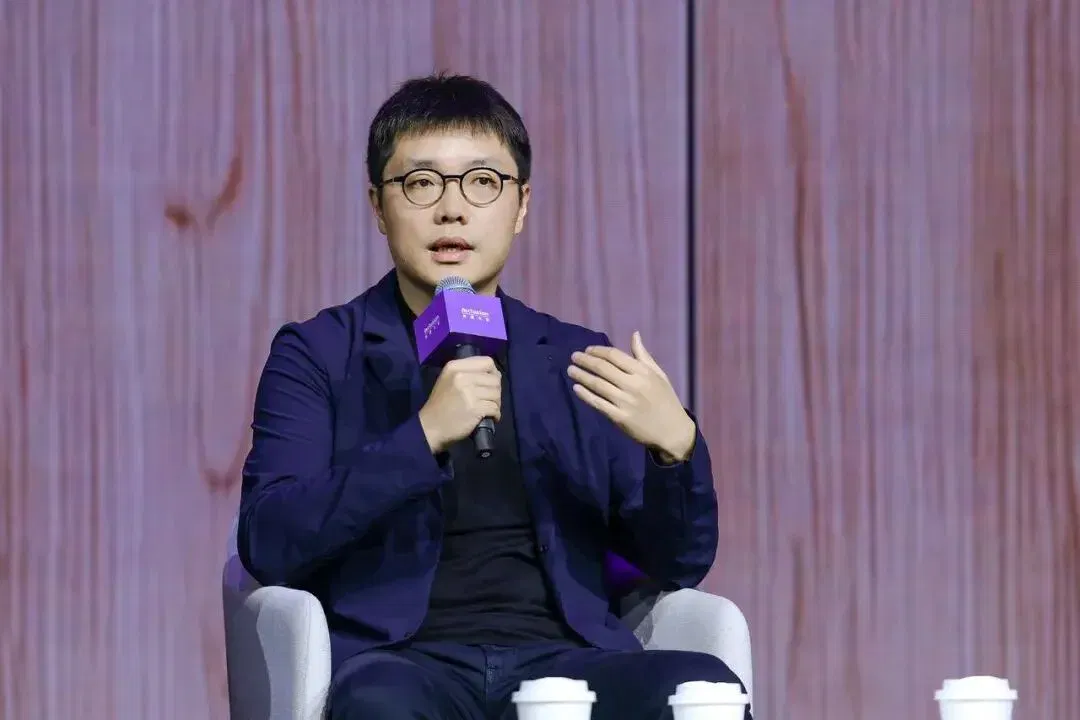
Koji 十字路口创始人
👨🏻💻 韩铮(苏度科技)
我们坚信要使用仿真,但同时,我们也坚信真实世界的数据也非常有用。
我们的出发点比较朴素,从最早 2015、2016 年开始做机器人仿真器、合成数据,到成立公司做商业化版本,经历过两轮迭代。
首先,科研和商业化不一样。科研可以用开源项目、数据和算法去做实验,但大家通常试一下之后,不知道接下来怎么大规模修改技术模型,一般就停在那里了。
但事实上,基于模型的强化学习、做大规模预训练,不管是我们之前开源的仿真器 CPM、Skill,还是英伟达的 Isaac,在我们内部看来,都有一定局限性。
所以 2024 年之后,我们坚定做了一个大规模、完全重构的闭源数据,包括数据管线和仿真器管线。仿真,包括基于模型的强化学习,在仿真器里进行大规模强化学习。
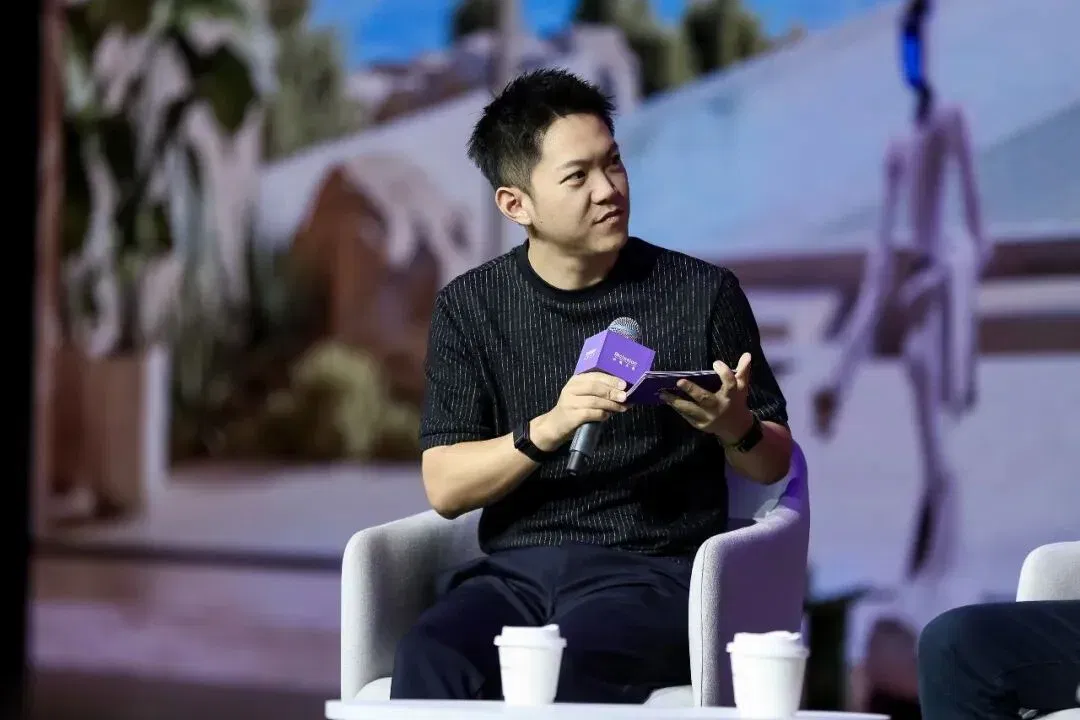
韩铮|苏度科技联合创始人兼 CEO
今年 4 月做演示,我们可以实现,对于物体、环境、光线等组合在一起的强泛化下的某些技能操作(比如抓、放置、组装类任务),在物体和环境几乎没有限制的情况下,几乎能达到 100% 成功率。
在数据方面,我们坚持:仿真是绕不过去的。因为光靠真实世界数据收集,效率比较慢,质量有时也受限。
最近在美国的一些同行也开始加强仿真器的能力,虽然各自使用方法不太一样,但这也是给业内的信号。
👦🏻 Koji(十字路口)
灵波在数据路线上明确选了真实数据,宇军总在你看来,真实数据哪些方面是仿真不可替代的?相比仿真数据,它提供的最大价值是什么?
👮🏻♂️ 沈宇军(蚂蚁灵波)
不能说是坚决选择真实数据。我们从来不觉得哪一种数据一定要选、或一定不要选。
不同数据在不同阶段起不同作用。比如,预训练阶段,我们认为互联网数据以及真实物理世界采集的数据,作用可能更大。但如果回归到做某一个具体任务,仿真数据还是有价值的,尤其是自动驾驶。
沈宇军|蚂蚁灵波科技首席科学家
为什么我们坚持在预训练阶段,部分数据更多从真实场景来?
设想有一天,机器人真的来到现实世界干活,它和在数字世界的工作方式是不一样的。它唯一的观测,一定是基于身上的传感器,我们不可能给机器人接一个键盘打字输入。但真实世界传感器一定有误差,没有完美的传感器,这是物理条件的限制。这种情况下,机器人只能依赖身上传感器做输入,然后做事。
仿真现在可能存在一个问题,大家讲得比较多的是 Sim to Real 的 gap,但从第一性原理出发,我觉得更多的反而是Real to Sim 的规模化。
换句话说,我们能不能把传感器噪声、更底层的东西真的很好搬到仿真器里,以及搬进去这件事,可不可以规模化复制。如果 Real to Sim 这一步不可规模化,只谈 Sim to Real 的 gap 的逐渐变小,可能价值不大。
关于哪些数据一定要来自真实数据、仿真替代不了?我觉得更底层是因为,机器人必须在物理世界中工作,而物理世界很多不完美是不好仿的。
👦🏻 Koji(十字路口)
举一个具体例子,什么样的不完美在仿真器里确实非常难做到?
👮🏻♂️ 沈宇军(蚂蚁灵波)
比如触觉信息、触觉信号。
现在很多触觉传感器公司也提供触觉仿真,但我们测过,很多真实传感器拿到的信号,跟它仿出来的千差万别。
信号频率、幅值、传感器之间一致性等等,很难搬到仿真器里做比较完美的复刻。
智能之争:Astra 会降维打击具身智能吗?
👦🏻 Koji(十字路口)
最近 GPT-6 的 Astra 发布之后,社交媒体上出现大量用 Astra 控制机械臂做各种任务的测试。甚至有个说法:具身智能要被通用的语言大模型降维打击了。王潜总你看到那些视频时感受是什么?
💂♂️ 王潜(自变量机器人)
这确实是行业里最火的话题。今天早上我还看到一个用 Astra 控制灵巧手的视频。
这个版本的模型其实训进了大量的机器人数据。去年年初开始,OpenAI、Anthropic 在大量采购机器人数据,他们自己也有小规模数据工厂采集机器人数据。所以这不是特别奇怪的事,在预期中。
王潜|自变量机器人创始人兼 CEO
我一直有一个“暴论”,但在大模型一线的同事应该能认可:
今天智能的本体是存在于数据里面的,当然一部分存在于 evaluation 里面;模型更多是一个蒸馏器和一个容器,在训练时,它是一个蒸馏器,在部署时,它是一个容器。
今天我们要做一个前沿的 AI 系统,模型的作用其实已经变得极其小了,更大的原因在数据,需要越来越好的数据。怎么造数据、挑数据、验证数据、标注数据,恰恰是这些东西推进了 AI 系统的发展。
所以问题变成:如果 OpenAI、Anthropic 要做具身,它是否需要依赖和我们一样的数据基础设施、验证基础设施和其他 infra?它是否需要从现实世界里收集数据、做仿真器、在现实世界做 evaluation、和硬件结合等等?
如果它还是要做这些事情,那它只是另外一个具身智能公司而已。因为这些难度不会因为它在基础模型上的优势而降低,反而是具身智能公司,可能有实质上的优势。
👦🏻 Koji(十字路口)
因此,你认为 GPT-6 Astra 不会对具身行业形成降维打击?
💂♂️ 王潜(自变量机器人)
大家担心的问题实质是:大语言模型是否可能通过其他领域的通用智能泛化到具身智能上面、形成降维打击?
我觉得可能性不大。
第一,在语言模型历史上,从来没有发生过这种事情。最近 3D 也是一样,包括 computer use,即便今天视频生成模型已经做得非常优秀,但它并没有直接转化为动作层面、机器人控制层面的天然优势。
反过来,这件事对我们的启示是:预训练确实是 work 的。
行业里有很多人在顾虑,我们做了大量预训练,加了大量通用数据,是不是反而有害?是否可能影响模型效果?在 Astra 上,我们看到它至少是一个 bonus,至少不是一个坏事情,我们应该坚定把这条路走下去。
最后,我们和 Anthropic、OpenAI 唯一的差距可能是:他们把这套 infra 融入通用大模型,而我们在做特定的专用模型。
事实上,通用语言大模型,是没有办法在机器人上以合理速度做推理、做部署的,我们确实需要一个单纯的具身模型来做这件事,才是更高效率的做法。
👦🏻 Koji(十字路口)
最近破壳机器人发布了一个“机器人做麻婆豆腐”的视频。华哲,在你看来,用 Astra 是不是也可以完成这样的任务?从更本质来看,通过机器人完成某个特定任务,能证明它的底层模型真的变强了吗?如果不能,我们应该看什么指标?
🤵🏻♂️ 许华哲(破壳机器人)
Astra 确实非常惊艳。我们内部在它能用的当天立刻做了测试。
许华哲|破壳机器人创始人、清华大学交叉信息研究院助理教授
如果把具身任务看成需要语义泛化、空间泛化加上物理泛化,Astra 只有物理做得相对很弱,语义和空间做得相对很强。
我们给 Astra 一个 prompt,它全认识桌面上的东西,无论任何类别,它一定往对的地方走。原来 VLM 模型或大模型,基本上机器人走到那,然后开始乱动,就结束了。
但 Astra 很独特的一点是它能抓起来,而且能抓非常难抓的东西。比如,一根筷子放在桌面上,对机器人来说,这种小物体它都得顶到桌子上、甚至打滑才能抓起来。Astra 现在也能抓起来。
测到这里,我们在想,它会不会旋转不太行?所以我们尝试让它把筷子立起来,插到一个杯子里。发现它竟然也可以。所以,不光是二维空间,它在整个三维空间,效果也都很好。但当我们让它做带物理接触的复杂任务时,比如用筷子挑开什么东西,它就不太行了。
我觉得,这也是具身机器人公司最后的阵地:理解物理的变化。
我们也用 Astra 去尝试叠盒子、叠衣服这类具身公司很喜欢测的事,发现 Astra 都做不了。那么在所有极复杂任务中,做麻婆豆腐,肯定是其中最复杂的任务之一了。
回到 Astra 上,Astra 现在能做的相对来说,还是空间语义上的具身任务。在复杂的 contact-rich 任务方面,它能做的一个是把筷子放杯子里,另一个是 handover,把一个东西拿起来递到另一只手上,再放到另一侧。我们测了很多次,有一两次成功。
Astra 给我的启发是,有点像刚才王梦迪老师(普林斯顿大学人工智能创新中心主任)主旨演讲聊到的,应该把具身模型也接到 Codex 里,或接到一个 harness 环境里。
因为具身模型是在通用场景干活,但 harness 需要很强的语义能力,harness 的语义能力越强,具身模型才能被用得越聪明。
比如抓水果。大家训模型最开始是拿泡沫水果,但这些数据非常有害:泡沫水果可以靠加大力,抠着一点点揪起来;但真水果无论如何不能那么抓。所以这时候,我们让模型去抓一下,如果是泡沫,就用原来那种抓法;如果是真水果,比如菠萝,就想办法揪上面那个绿叶子,不能再去抓它的身体。
但大多数具身模型没有这个识别能力,但我们需要模型先通过 CoT(Chain-of-Thought 思维链)告诉机器人这是真菠萝还是假菠萝,再去抓。
所以我觉得,最后应该是大模型、具身模型和物理世界连接在一起的一个完整系统。
👦🏻 Koji(十字路口)
宇军总,在你看来,Astra 现在涌现的能力,是我们今天具身智能 scaling law 的某种信号吗?
👮🏻♂️ 沈宇军(蚂蚁灵波)
我跟华哲观点差不多,可能再激进一点。我觉得,具身慢慢会影响大模型、云端模型的发展路径。
首先,具身模型最终的工作方式,一定是部署在机器人上,它跟数字世界模型的“轮式对话”方式不一样。
在数字世界,你问它一个问题、它回答你,它回答时你不能继续追问——交互是线性的。但机器人做事依赖身上传感器的输入,而这些传感器的输入是持续不断的,哪怕机器人正在做操作,输入还是源源不断地进来,机器人需要基于新输入,随时改变推理。
我认为,具身模型最后可能会成为更高阶模型使用的一个工具。
从工具层面讲,它需要自己的训练范式。因为它要面对源源不断输入的场景,持续输出 policy。
为什么说具身场景可能会给更高级的、能交互的 expert 类的模型,提供更多的发展方向?
我举个例子,人和人之间对话,其实是很多模态的,不只有语言、视觉,还有很多外在因素。比如,我跟一个人聊天,外面突然下雨,我看到下雨,可能会改变心情、改变聊天方式。或者我看到这个人脸色不好,接下来要说的话很多我就不说了,马上换一句。
这是现在云端的数字世界模型还没有考虑的,因为它目前不会用到,交互是藏在屏幕后面的,大家只需要通过视觉和语言进行交流。
但以后,如果机器人真的要跟人对话,那它能囊括的信息量会非常多,很多信息一定来自现实世界中的传感器。我们会观察天气、感测温度……这些都会影响模型的输出结果。
未来,当机器人逐渐走入生活,带来更多关于物理世界、现实生活的数据,这些数据会成为大语言模型公司的新的语料,它们可以基于这些数据变得更加智能。
机器人不再是一个冷冰冰地躲在后面的智能体,而是可以像人一样感受周围环境,根据变化随时调整跟人对话方式的智能体。
👦🏻 Koji(十字路口)
刚才三位普遍非常乐观,看到的都是机会和启发。韩铮总有没有补充?
👨🏻💻 韩铮(苏度科技)
其实跟我一直讲的一个观点越来越接近:上下会分层。上层的抽象理解会分层。
从几年前我就这么讲:Facebook AI Research(FAIR)最大的对手实际上是 OpenAI,最近还有 Anthropic。DeepMind 另外一位 Robotics 研究员也刚加入了 Anthropic。
另外还有一点,机器人的基础是 skill。底层技能的泛化性和高成功率,一定要跟上层模型同等水平。不能成功率不高,然后有一些泛化性,这是上下层衔接时非常致命的问题。
所以,具身公司和上层模型去接的时候,一定要注意这个问题:高成功率下的泛化性。
去年底,我们当时做演示,跟千问模型做语言交互,它通过对周边环境和物体理解,最终拆成一些 reasoning 生成的操作步骤,但它一定要靠对环境和物体有极其可靠稳定的底层操作,才能去完成整个动作的 training 。
今年这个理念重新被大家拿到前台,我觉得也是大趋势,特别是 Astra 出现之后。
场景之争:什么指标证明具身跨过泡沫?
👦🏻 Koji(十字路口)
现在外界对具身行业有一些现实质疑,更多在商业化上:demo 很多,融资火热,但真正规模复制并持续让客户付费的场景到底在哪里?
下面的问题提给三位在具身公司的 CEO,如果只看某一个指标,你们觉得哪个指标最能证明具身已经跨过泡沫质疑、真正进入产业阶段?
👨🏻💻 韩铮(苏度科技)
科研和商用化对机器人的要求,跟之前工业机器人和自动化一模一样——高成功率是绝大多数任务的前提。
在商业化场景里,绝大多数任务对机器人成功率的要求接近 100%,只有极少数任务可以容忍 80% 的成功率或者允许二次纠正。
在这个前提下,我们跟自动化设备的区别是:还要对物体和环境有一定泛化性,而且不能靠大量后训练去弥补。否则,每来一个场景就要做大量过拟合,那就失去了具身智能的意义。
所以走到商业化,对我们最大的考验,首先在算法上:高成功率下还要有泛化性。当然,后面设备的可靠性、怎么做服务,这些挑战也绕不过去。
💂♂️ 王潜(自变量机器人)
如果非得说一个指标,那就是:客户可持续地付钱,为前沿技术付钱。
这是最终极的判断标准,也是最现实的标准。
现在大家做商业化,很多时候并不是客户可持续付钱的合作。可能在某一个特定历史阶段,用特定方式合作。也可能是沿用上一个历史阶段的方式,比如传统的自动化、上一代机器人。
但大家还是应该真正去想想,这代机器人比上代机器人强在什么地方?它能给客户提供什么样的真实价值?
这个事现在已经开始实现了。最近我们在物流场景里,确实做到了以前传统机器人做不到的一些事情,并且超过了人类 ROI 水平。这种真正意义上能落地、能持续产生生产力的,才是最重要的。
另一方面,作为公司一定要赚钱。有了钱,才能做更大的模型,才能持续探索 AI 最前沿。
语言模型公司也经历了类似发展路径。一开始完全不赚钱,但到了某一个阶段、真的有一些用处时,开始积极商业化。商业化和前沿推进,是一个互相促进的过程。
某种意义上,过早商业化是有害的。但我们也许已经过了那个时间段,现在进入了产生飞轮效应、相互促进的阶段。
🤵🏻♂️ 许华哲(破壳机器人)
具身商业化有好多类。
一类是后训练类:我跟某一个品牌、某一个工厂合作,在它里面做闭环。比如我在家门口搭一个小吃摊做关东煮,核心指标就是看,我需要花多少个小时,能把这个事情稳定地部署落地,以及我能开多少个小吃摊。这跟传统机器人部署逻辑一样,就是看效率和 ROI 换算。
第二,我觉得,我们这一波具身智能的另外一个商业化指标,跟语言大模型的商业化路径相似。短期内,这件事可能看不到经济收益,但它会是一个“阶跃式”的商业化路径。
为什么体感上,大家觉得语言大模型很有用?
因为容错成本不同。假设 GPT 以 50% 成功率输出一个答案,那么我只要跟它对话几轮,大概率就可以拿到好的结果。但如果机器人以 50% 的成功率完成一件事,那它有 50% 概率会把一个杯子打碎,那大家会觉得它真没用。
即使这样,我们仍然要矢志不渝地追求具身智能的大模型化,因为当前 50% 的成功率,是面对所有任务的 50%。我们要等到它从 50% 到 60%、 70%,一直到 99.9% 的时候,那时的商业化才是这一波具身智能真正意义上的商业化。
这也是我们真正期待的:基础模型在一瞬间达到某个阶段,开始吃掉物理世界很多东西。
五年后回看:什么被高估,什么被低估?
👦🏻 Koji(十字路口)
最后一个问题。有句话说:人们总是在科技领域高估未来两年的变化,但低估未来十年的变化。假如站在五年之后回头看此刻,你们觉得哪些在具身领域被低估了?又有哪些被高估了?
👨🏻💻 韩铮(苏度科技)
我觉得最被高估的一点是:中国的供应链的先进程度。
选择确实很多,但具身智能现在需要的供应链、距离能满足我们实际迭代的成熟程度的,还是有一点工作要做。
第一,我们要有一些数量去支持。第二,供应链里有很多传感器、关键组件,可能散落在成熟行业里,比如汽车供应链、工业机器人供应链,实际到具身里,现在供应链水平距离大工业制造水平还有一定差距,不过肯定可以被解决。
关于被低估的,我也回应华哲老师刚才讲的达到 99.9%的成功率,时间可能会很长,但难度大家不用太悲观。
我觉得,未来 1—2 年里,大家会看到很多行业的某一大类的任务,都可以被机器人处理掉。
当然如果是 99.9% 的任务机器人都能做,那确实需要很长时间。
👮🏻♂️ 沈宇军(蚂蚁灵波)
具身是一个复杂系统工程,大家可能还是低估了这个系统的能力,而把很多问题,比如能不能落地、解题成本,都跟模型的性能挂钩了,但其实不是的。
因为机器人商用最后回归的其实是成本、整个系统的鲁棒性,以及商业模式等等。模型只是其中一环。
比如做落地,商家肯定还是看成本:我到底是不是一定要用这款机器人?是不是要用完整机器人?是不是只用双臂就可以?
关于被高估的一件事,我们现在有点高估了“训练模型的技术”。
我也听到一些声音说,具身要被数字世界模型降维打击了,好像攒一波物理世界的数据,然后按之前的训练方式,就能训出一个具身模型。这在我看来不太成立。
具身有可能会走跟数字世界相同的模式,但一定不会走相同的技术路线。因为最后的应用场景,决定了模型的不一样。数字世界是对话式的,但具身一定是机器人一边工作一边推理。
具身一定会有自己的新训练范式。这种范式可以支持对物理世界信息的持续处理,可能是 7×24 小时、甚至 365×24 小时,全年无休处理数据。
💂♂️ 王潜(自变量机器人)
五年之后回过头看,大家应该会觉得,我们还是低估了具身的重要性和潜力。
虽然今天我们已经认识到具身很重要、是非常重要的 AGI 组成部分,但我觉得大家还没真正理解这件事情。
接上面 Astra 的问题,为什么数据很重要?
因为确实它包含了一些其他方式无法获得的智能能力。比如复杂物理交互、各种物理过程,以及沈老师提到的传感器噪声、物理世界本质不可控的东西等等,我们确实没办法通过视频、3D获得,更不用提 code 。
我以前研究物理,会发现大量创新或想法,很多时候来自所谓物理直觉。当然还有另外一条路,逻辑推理,所谓数学的深度搜索能力。
过往人类科学研究过程确实发现,这两个事情没有办法互相弥补。做某些事情数学思维方式更快,做另外一些事情,物理思维方式更快。
所以要构建真正意义上的 AGI,这部分肯定没办法避开。你可以把它训到同一个模型,或者训到不同模型做分层。但更主要问题是,这部分能力确实要从真实世界或仿真,或者其他方式中获得,然后注入 AI 系统。
在应用层面,大家也有点低估利润具身的重要性。
现在最近不管是硅谷还是国内,大家对 RSI 都产生了非常大的 FOMO 情绪,狂热和恐惧都在。
我的看法是,以目前语言模型能力,其实不足以实现完整 RSI。因为它缺了最重要环节:物质上的重制造(物理世界的自我复制),这是语言模型不能触及的。
另外,语言模型可以修改自己的训练方式,修改很多训练流程,但本质上,我们需要走 scale up,需要更多算力、更多芯片、更多电力,这些语言模型也没法做。
所以我们现在看到,在美国,数据中心建设已经成了一个很大阻碍。因为还是需要人去和钢筋混凝土打交道,还是需要人去调工厂半导体的参数。
但如果放到五年之后,我相信大家会意识到,具身智能在不远将来是可以做这件事的。那一天,真正意义上的 RSI 才到来。
现在数字世界,走得比物理世界快太多了。
我经常开玩笑,如果 Anthropic 今天把所有员工都干掉,全都用 agent 开发下一代模型,进程肯定会减慢,因为现在人的 taste 还是很重要,但你说它就开发不出下一代模型了吗?我觉得不是,肯定能开发出来。但如果半导体工厂没有人,全靠 AI 来做,这肯定不行。
另外,今天我们要做一个 App,已经不需要像五年前那样搞很大的团队、花很长时间、做很多协同工作,比如花一年做一个 App。今天可能一个人,只要额度足够,开一堆 agent,几个小时就能做出来。
现在造一架飞机,可能还需要 1000 个人、非常大的供应链、很多工厂。也许五年之后,在具身智能和通用语言模型的辅助下,造一架飞机也可以像今天做一个 App 这样简单。
那时候,整个生产全流程都可以闭环,人类经济实现真正意义上的硅基脱离碳基的这一天。
也许有朝一日,我们还是要走出一条中国的 AI 发展之路,具身可能是其中很重要的起点,或很重要的部分。也许之后每一家公司都会训一个自己的语言模型,也说不定。
🤵🏻♂️ 许华哲(破壳机器人)
我觉得被高估的,很明显是大家对数据量的追求。
现在市面上,有人说我有一百万,有人说我有几百万小时的数据,还有人说谁谁谁已经买了多少数据,你不买就落后了。
我也看到市面上一些训出来的模型,真的用了非常非常大体量的数据,其实没有训出来特别超越预期,或者没有比几万小时训出来的模型更好。单纯盲目追求量这件事,严重被高估了。
被低估的,我觉得是整体智能模型的进展,具身智能模型的进展。
大家一提具身智能解决通用的事情,可能要 5 年、10 年。我觉得 3 年内,具身智能就可以在很多地方开始服务,是通用的服务,不是那种后训练好的服务。
👦🏻 Koji(十字路口)
大家都描绘了一个非常让人期待的未来。甚至像王潜提到的,未来会不会造飞机变得像造 App 一样简单?
谢谢四位嘉宾,也谢谢现场各位观众的时间。咱们明年外滩大会再见!
文章来自于"十字路口Crossing",作者 "十字路口Crossing"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
PaXini's Xu Jincheng on tactile sensing, embodied data and robotic execution (opens in a new tab)
In an ALIGNMENT conference talk, PaXini founder Xu Jincheng describes tactile sensors, data collection, VTLA models and execution hardware, discussing how perception, intelligence and execution work together. Product capabilities are claims disclosed in the talk.

智动未来据报完成亿元级Pre-A+融资,资金用于产线与服务机器人部署 (opens in a new tab)
机甲觉醒报道,智动未来宣布完成亿元级Pre-A+轮融资,由中美绿色基金领投、南曦创投联合领投,资金拟用于广州产线、服务场景部署和世界模型研发。“智子世界”仍属技术预览,商业化效果待更多应用数据检验。
Syncere raises $11M for Lume, a household robot shaped like a floor lamp (opens in a new tab)
Syncere uses a floor-lamp form for Lume: one robot handles some pick-and-place tasks, while two work together in Duet mode on tasks such as folding clothes. Demos are edited; pricing and delivery reflect the source date, and home reliability remains unproven.
Genesis AI raises $500M Series A to advance its full-stack robotics and Eno (opens in a new tab)
Genesis AI announces funding at a $3.5B post-money valuation, outlining a stack of data gloves, simulation, models and the Eno robot. Production and customer deployments are planned; demonstrations and correlation experiments do not establish delivery at scale.

Oxford researcher proposes cognitive symbionts for wearable AI augmentation and governance (opens in a new tab)
Hao Fei's perspective paper proposes cognitive symbionts and AI-Augmented Human Intelligence, covering long-term memory, wearables, proactive help and governance. Privacy, low latency and lifelong companionship are design goals, not verified product guarantees.