现在说Hy4 preview+WorkBuddy是靠谱的办公搭子还来得及吗
AI博主在WorkBuddy中实测腾讯混元Hy4 preview,通过研究检索、Excel+PPT交付、播客报价系统和3D小游戏四个办公场景验证其能力,认为该模型在长程任务中对信息冲突与规则歧义的审慎处理是其核心亮点,适合作为办公搭子。
Hy4 preview在发布策略上还是有小巧思的
错峰了Deepseek v4pro、Qwen max3.8、GLM5.3这一众大热旗舰模型的抱团互殴,各个领域的AI老师们还在兴奋的劲头上
Hy4 preview一发布,原本跟Hy模型感情基础较为薄弱的AI博主们开始主动和它发生关系,当然也包括我
网上在发布前有了很多灰测,名字反复来回横跳,也不知道摸到的是哪一版
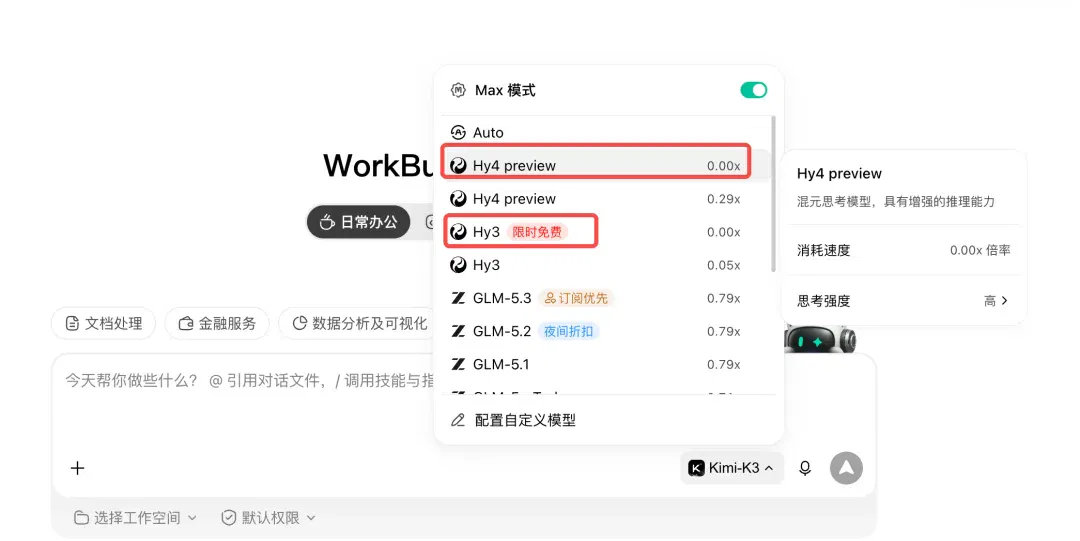
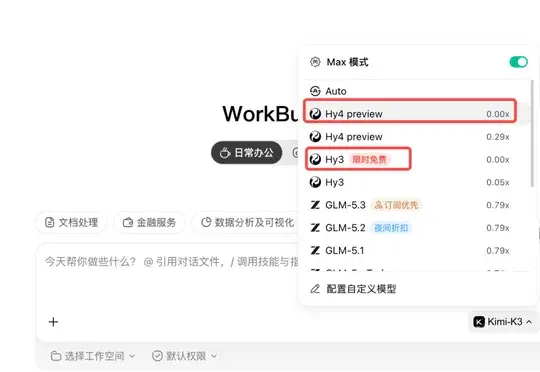
目前在 Workbuddy ,混元 4 preview 免费使用两周,混元 3 免费到月底
但作为一个测评AI 博主哪能等,就花了68先让Hy4 preview 给孙割解答了这两天最热的互联网公案:那5kw美金要不要给
当然给不给这件事儿不那么重要了,但Hy4 preview :烂账才是真正会腐蚀关系的东西。多少有点Claude
Hy4 preview 官方给的盲测平均分是 2.99,Kimi K3 是 2.94,GLM-5.3 是 2.92
虽然我之前写过模型榜单的分数都挤在一块儿,谁也拉不开谁,但毕竟现在测的是之前在模型赛道处于逆风位的Hy
我甘愿暂时放弃当一个不评测就能发稿子的 AI 博主,挑了四件办公和假装学生平时能用到的场景,在 WorkBuddy 里跑了一下午
用了四个case,除了提示词,我一共发了9句话,其中4句是"可以,继续"
可能是因为有 WorkBuddy 的加成,几款模型测下来,Hy4 preview 给我的感觉很像包工头
其他模型更愿意把能力压在最终成品上,比如报告信息的全面性,生成的网页审美好不好,做的游戏稳不稳定
Hy4 preview 在workbuddy里把手伸得更长,先确认口径,然后再做任务拆解,做完再跑公式、边界条件和异常环境
能看得出来,它是真怕掉链子
研究类Agent需要时刻保持清醒
先从最麻烦的研究型搜索开始。我想看的是它多源信息抓得准不准,以及会不会因为自己测自己就开始瞎编
提示词:
帮我调研最近30天国产大模型的发布和更新动态(包括但不限于通义、豆包、Kimi、混元、DeepSeek、GLM),整理成一张对比表:模型名、发布时间、参数规模、主打能力、定价(如有)。每条信息标注来源链接。找不到确切信息的直接标"未公开",不要猜
14分钟跑完,主流的厂商都在的。哪家不在自己反思哈
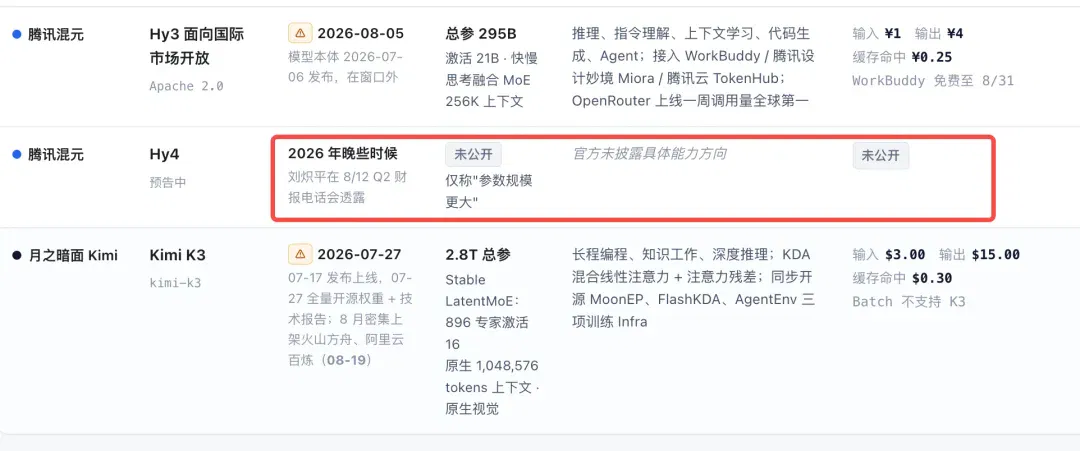
表里当然也有腾讯混元这一行。参数栏填的是"未公开"
我测的时候 Hy4 preview 还没正式发,网上确实什么都搜不到。但还是在已有的信息里标了官方唯一说过的原话"参数规模更大",出处是财报电话会
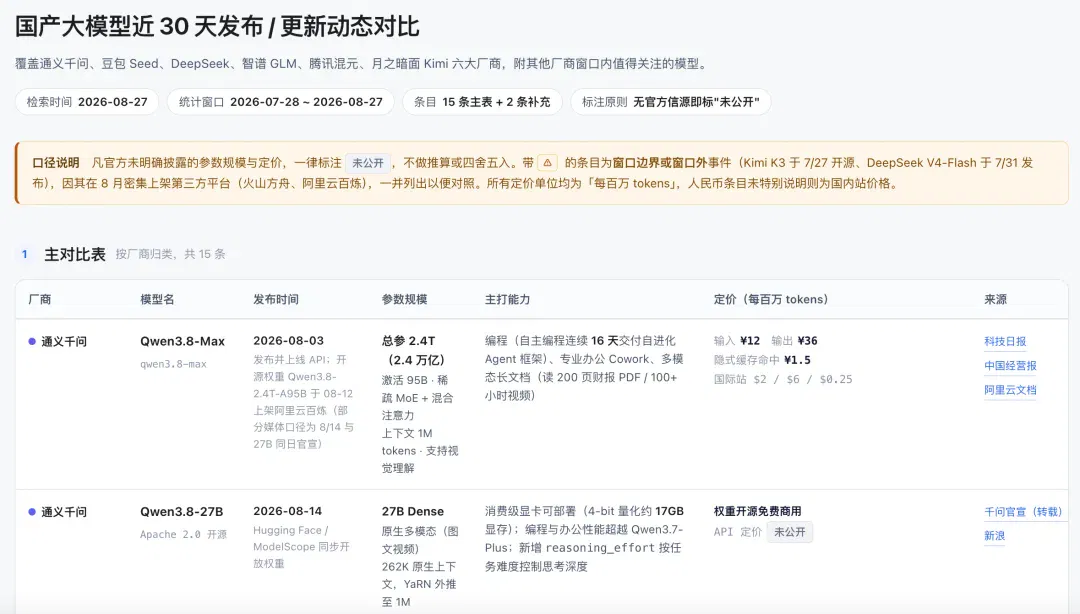
找的数据源可信度比较高,也没硬给自己往好了写,算准确客观
但作为事实客观的AI 博主,我还是一条条点开做了核验
参数那几条是没问题的。Qwen3.8-Max 的2.4T、Kimi K3 的2.8T、DeepSeek V4-Flash 的284B,我后来换另GLM-5.3 跑同一道题的结果对得上
日期和出处的部分有一些瑕疵
首先是Seed 2.1 的发布时间,给的结论是:两边时间对不上,我标存疑,不替你选
这个态度还挺好的,摆出两个选项让我知道它没瞎编
然后我查了一下。Seed 2.1 真正的发布日是6月23日,08.10 只是换了个构建版本算不上发布
其次是 DeepSeek 那个"最高涨1100%"。数字是对的,但它挂的那条来源链接里没有这个数
还有一条我一开始也觉得不太对。GLM-5.3 的参数它写"未公开",是能搜到743B、753B几个数字的
结果我拿 GLM-5.3 自己跑了一遍,它给自家参数填的也是"未公开"
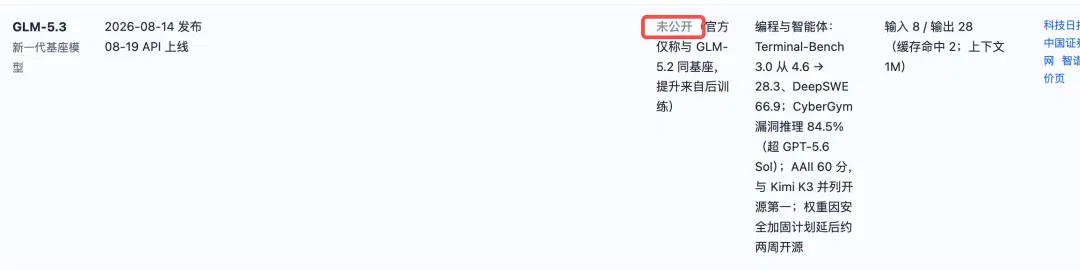
网上的数字全是媒体报道,不存在官方披露
横评我用了 GLM-5.3 跑同一道题,覆盖10家厂商,然后还有补充,美团、商汤、讯飞的预告都抓到了,整体结果覆盖还可以
但GLM-5.3漏了 DeepSeek V4-Pro 正式版。1.6T总参、激活49B,8月13号发的,这轮 DeepSeek 最重的一条。旁边那个 V4-Flash 它写进去了,把旗舰漏了
对实际工作来说,漏比错麻烦。错的地方你核实一遍能发现,漏的地方就要花大力气找了
回到 Hy4 preview 在研究交付层面的逻辑是,我可以说“我不知道”,你来判断。也不会给一个不确定的答案
最怕糊弄的两件事没发生
接着丢了一段乱格式的投放流水进去,大概90行
提示词:
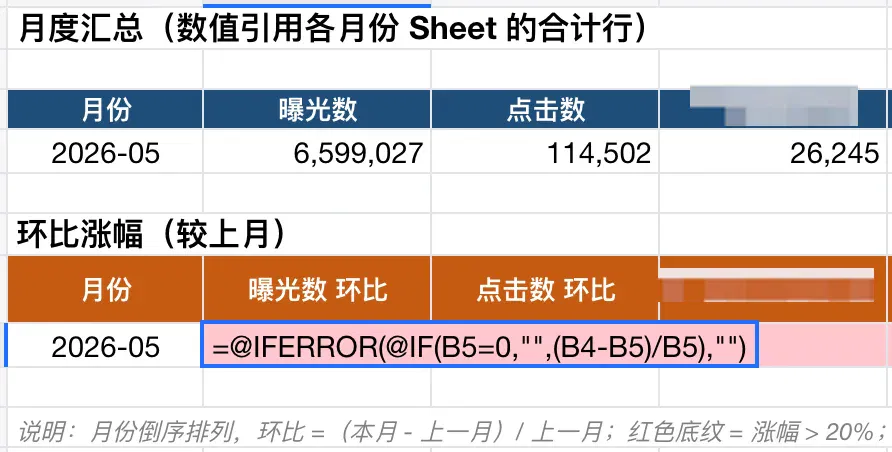
把上面这段记录整理成Excel:按月份分sheet,每个sheet加合计行,环比涨幅用公式算不要手填数字,涨幅超过20%的单元格标红
把这份Excel的数据做成一份8页的汇报PPT:深色背景、每页只讲一件事、数据图表不要用Office默认样式、封面标题写"饭后服用AfterHours 数据月报"
我只给了一个月的数据,月环比没法算,就把公式空着了,等我补了别的月份能直接跑
PPT 我原本预期不高,我自己也不爱做 PPT,这活儿 AI 干出来一般是"汇报五分钟、排版两小时"的反效果
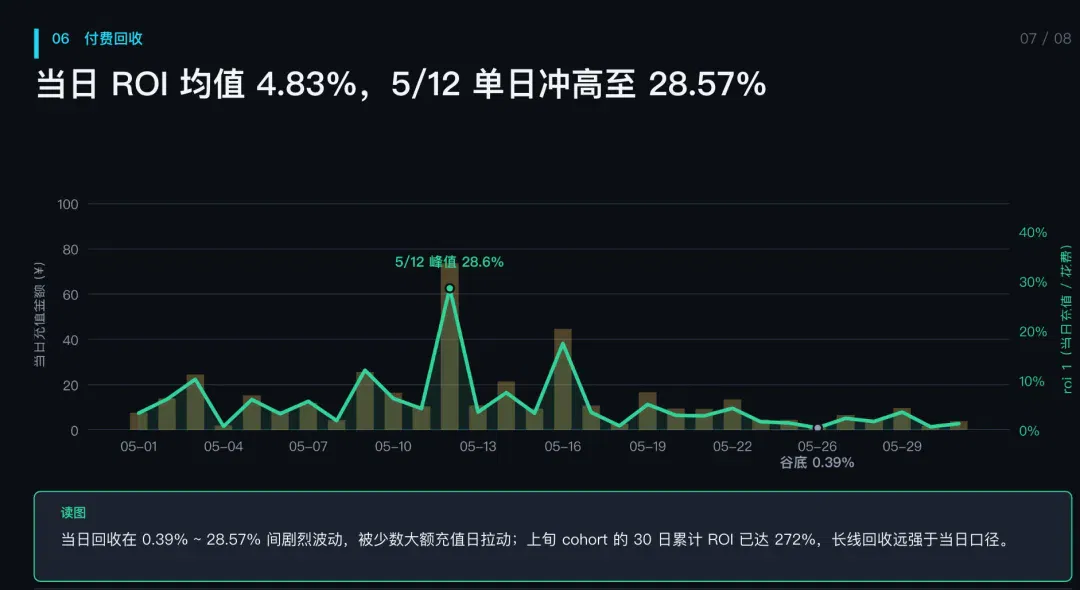
结果确实没有Office 的样式,图全是自己画好导成透明底图片再贴进去的
结论部分,在两页里都标了"两个字段口径显然不同,建议与数仓复核后再作为考核基准"
自己确定不了的让你二次确认,这点在办公场景里还是比较重要的
另外 Excel 做完直接接着做 PPT,这是 WorkBuddy 自带的 Agent 在干活。说是做了不少适配,配合下来确实顺畅许多
数据处理我故意埋了坑
然后我测了一下做账号报价,这轮看的是分步规划、指令遵循,还有跨多轮能不能保持状态
提示词:
帮我做一个播客数据后台,分三期交付,每期做完停下来让我确认再继续。一期:网页端Dashboard,展示每期节目的播放量、完播率、涨粉数(先用mock数据)。二期:加一个"广告报价计算器",规则是:基础报价=近5期平均播放量×0.8元,完播率超过60%上浮20%,粉丝数超5万再上浮15%,但总上浮不超过40%。三期:把整个页面做成移动端自适应
规则看起来复杂,主要是为了故意往里面埋两个坑
一个是两笔上浮撞一块儿该怎么算。是把20%和15%直接加起来算35%,还是先涨20%再在这基础上涨15%?后者是38%。三个点听着不多,落到我这个体量上差两千多块
另一个是"最多加40%"那条上限,按我给的数据怎么算都够不到
以前在字节写需求文档,这种嵌套条件大家能开一下午会
结果自己看吧,还是把我埋的部分找出来让我确认,然后自己跑了边界逻辑
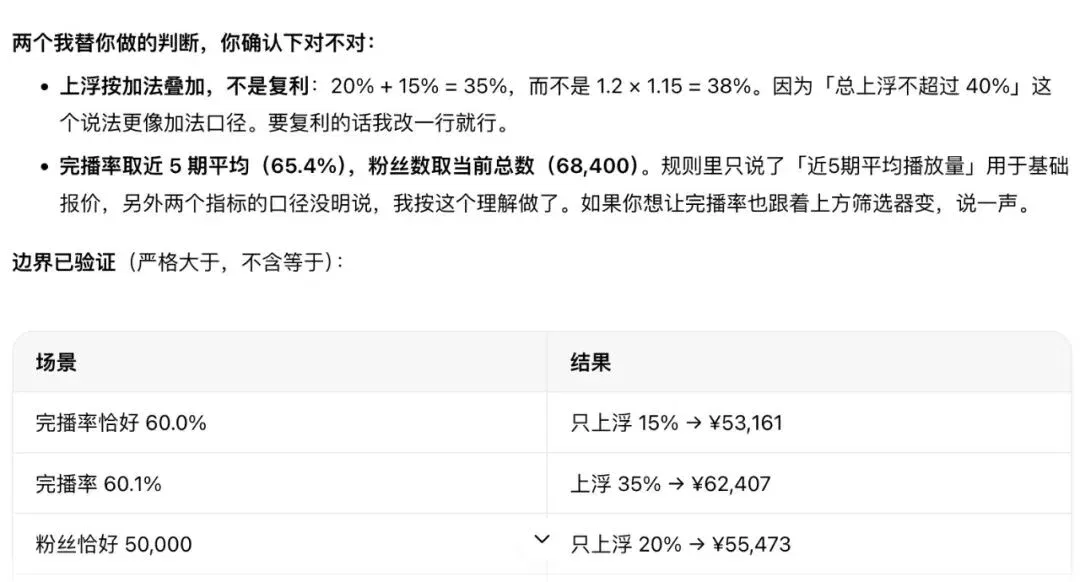
最后跑出来单期报价¥62,407。三期改完移动端自适应,然后再跑了一遍数据是一致的。现在跑的都是 mock 数据,回头把真实的填进去就能用
3D小游戏,意外的自己调了跳跃手感
提示词比较简单:
用three.js做一个单文件HTML的3D网页小游戏:一个可以用键盘WASD控制的小球,在悬浮平台上滚动跳跃收集金币,掉下平台就重开。要求:有计分、有物理惯性手感、有简单光影、手机端也能用虚拟摇杆玩。做完自己在浏览器里跑一遍确认能玩再交付
当然我玩的菜不代表人家模型不行哈。直接看效果,我就不多比比了
可玩性有的,不是那种"能用就行"的MVP版本
其实整个设计我自己看起来很"跳一跳",不知道是不是直接拿自家产品训练过的
手感也调过。平台边缘起跳留了0.13秒缓冲,不会吃操作。空中操控故意做弱,松手才有摩擦,惯性明显但不飘
金币收齐之后弹了个结算面板,除了分数和用时,还记了掉落次数。下面两个按钮:再来一局(新地图),或者重玩这张地图
它默认就想到要区分这两种重开,这个让我比较意外
交付前它还把40张随机地图挨个体检了一遍,确认没有跳不过去的坑、没有吃不到的金币,又写了段脚本让电脑自己玩60秒
同一道题我给了 Kimi K3。9分钟交付,也能玩
当然在用Hy4 preview 做这个3D 游戏的时候也不是全无问题。中间有一版我这边没打开,我让它自己复盘了一下:
我所有自动化测试都跑在"网络正常"的环境里——本地服务器 + 能连通的 CDN,所以"加载成功"根本不是被测出来的,是被环境保证的
顺着这个它又自己查了一遍,发现无痕模式下不让存数据,而它初始化时是裸调用的,一调就白屏。这个我根本没提,它自己找出来自己修了,然后补了三类以前从来不测的环境,断网、存储不可用、加载超时
跑了半天其实也没消耗特别多积分。顺手做了个价格对比,目前Hy4 preview 也是国内主流大模型中最便宜那一档了
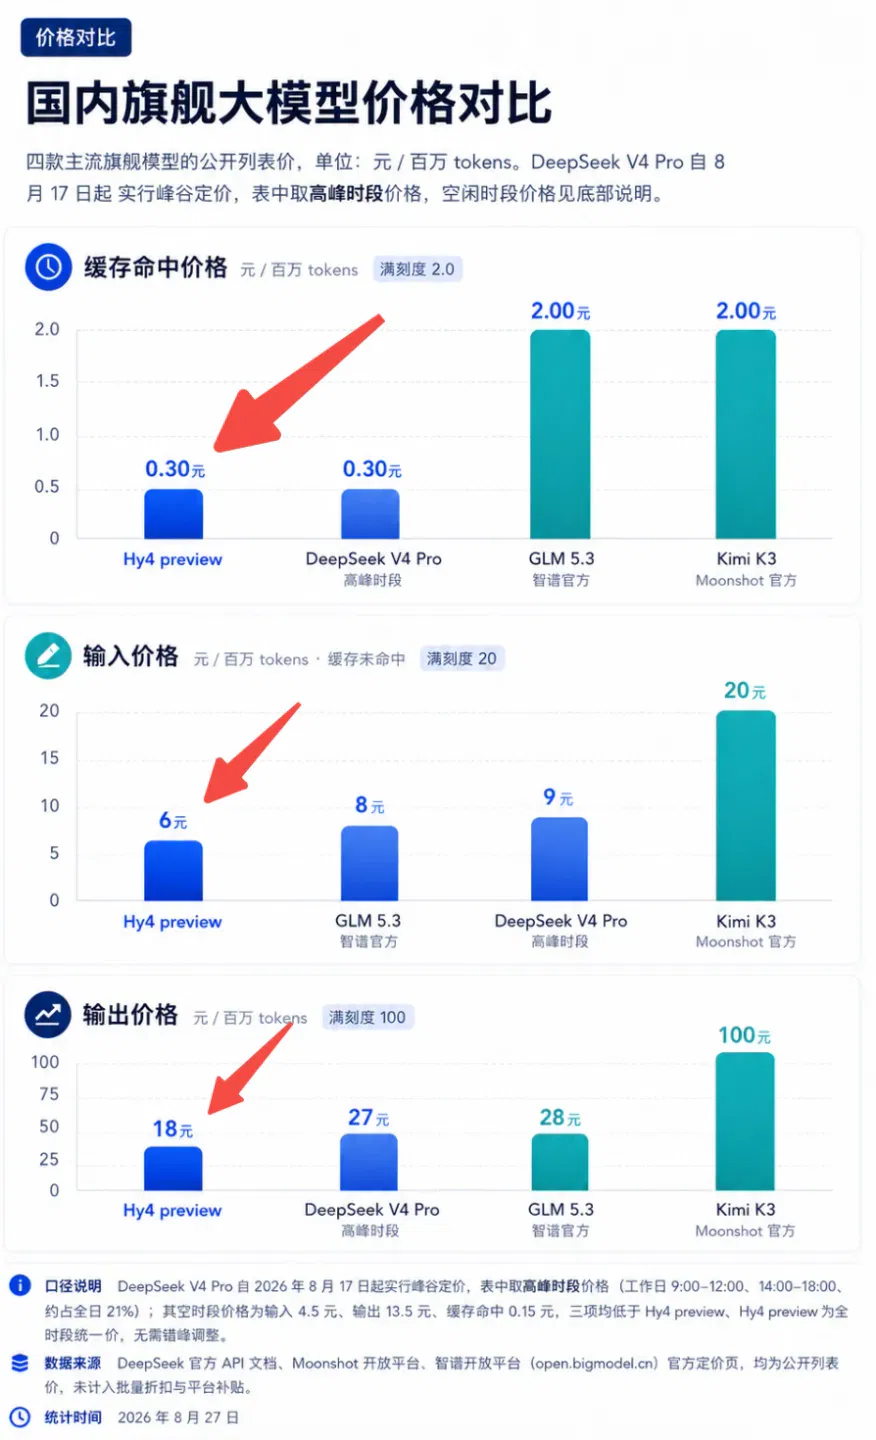
四个case下来,Hy4 preview 没有让我看到能把其他模型整体甩开的压倒性能力
官方盲测也只有 0.05、0.07 的差距,这很正常
今天的模型榜单已经挤得像早高峰,再去拿分数来高喊模型存在代际差,肯定不会有以前那种看到原子弹爆炸瘫坐在办公椅上的震撼了
它这次真正让我记住的,是在长程任务中对不确定性的处理,有信息冲突就把冲突摆出来,有规则条件存在不同算法就停下来问
如果放在平时的chat模式里,这可能会显得思考时间长,过度自我验证
但如果在workbuddy这种办公交付的场景里,我更偏向于它是一种保险
看得出这潜心修炼的大半年,混元真的背了不少锅,才让Hy4 preview 的表现能这么共情打工人
人类和模型的反复拉扯,其实就是在反复确认到底楚门的世界里立在海面上的那块巨幕是否存在
Hy4 preview 知道测试环境里不可能是永远波光粼粼的海面
它喜欢把船开到尽头,确认那片蓝究竟是天空,还是贴了壁纸的墙
文章来自于微信公众号 “饭後服用AfterHours”,作者 “饭後服用AfterHours”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

腾讯Q3资本开支814亿元,称WorkBuddy日Token用量居国内首位 (opens in a new tab)
腾讯三季报显示营收2073.36亿元、资本开支814.33亿元。公司称WorkBuddy日活超1000万,按用户每日大语言模型Token消耗总量居国内首位;报道还讨论云业务增收与AI投入对盈利、现金流的影响。
Claude Meetings brings collaborative documents into calls, with efficiency and recordkeeping tradeoffs (opens in a new tab)
APPSO describes visible participation, live notes and whiteboard collaboration in Claude Meetings, examining how notifications, external guests, retention and AI summaries affect teamwork, privacy and the room for open-ended discussion.
Doubao Work vs. WorkBuddy: task times and usage with the same models (opens in a new tab)
The author compares profiles, calendars, sales reports and presentations, then tries Flash research followed by Kimi drafting. Results depend on plans, temporary offers and the specific task.
LobsterAI Team hands-on: how shared credits affect a small team's office AI bill (opens in a new tab)
The author examines zero seat fees, credit allocation and local workflow handover, comparing team spending using recorded prices. Actual costs still depend on usage, credit validity and model connections.
Trying Baizhi Office: shared configuration for models, knowledge bases and team usage quotas (opens in a new tab)
The author explores resource distribution, permissions, billing and task review from managers’ and employees’ perspectives, then tests document and web-page generation with a mock product brief.