「有些模型就是不想学?」循环模型为什么越想越错?
十多年前,Ilya Sutskever 说过这么一句话。 「模型就是想学习。」
十多年前,Ilya Sutskever 说过这么一句话。
「模型就是想学习。」
Dario Amodei 在采访中转述 Ilya Sutskever 的说法。图源:Dwarkesh Podcast。
只要解决好数据和算力的问题,模型会自己找到学习的方法。
后来发生的事情我们都知道。模型越做越大。训练数据越用越多,算力投入一路上涨,模型能力被一层层解锁。
但当研究者把目光聚焦在循环网络和隐空间上时,一切都变了。
循环模型能够在隐空间中反复计算,按照设想,同一组网络层多运行几轮,模型就能获得更多计算时间,遇到难题也可以多「想」一会儿。
但现实并不如此美好。
不少模型只擅长使用训练时见过的循环深度,如果再让它多算几轮,它就可能开始在错误的路上狂奔。
因此,有人戏言:有些模型,就是不想学。
靠「多说」来「多想」
点开一个大模型的「深度思考」,你会看到长长的文字。
这里面看上去有很多「废话」,模型总在一边尝试一边推翻,有时候还会说出「我需要重新思考这个问题」。
这展现了模型的推理过程,虽然不能直接当作模型内部的完整计算过程来看,但也说明了,当前 Transformer 解决难题最成熟的办法,就是让模型一边说一边想。
因为标准 Transformer 有点像一栋楼层固定的大楼。
信息从一楼进入,依次经过每一层,最后从顶楼出来。无论面对的是 「1+1 等于几」,还是一道复杂的数学证明,每次生成下一个 Token 时,它走过的网络深度基本相同。
一趟不够怎么办?那就多走几趟。
模型先生成一个 Token,再带着此前的上下文进入下一轮计算。输出越长,同一套网络被调用的次数越多,模型也就多了几次拆解问题、检查答案和修订答案的机会。
这套办法相当好用。它让原本网络深度固定的 Transformer,也能根据题目难度灵活分配计算量:简单问题少说,复杂问题多说,实在不行就自己的几个答案来回打架。
不过,这种思考方式也有点不方便。
模型内容存在的是高维连续的隐状态,因为中途必须要「说」,所以许多中间计算也要被组织成一条可以输出的序列。哪怕某些步骤根本没有说出来的必要,模型也得先生成点什么,才能继续往下走。
于是,另一条路出现了。
直接在网络层循环
循环模型的想法很直接。
既然走一遍网络不够,那就回到某些网络层再走一遍。每循环一次,模型都会更新一轮隐状态,复用的还是原来那组参数。
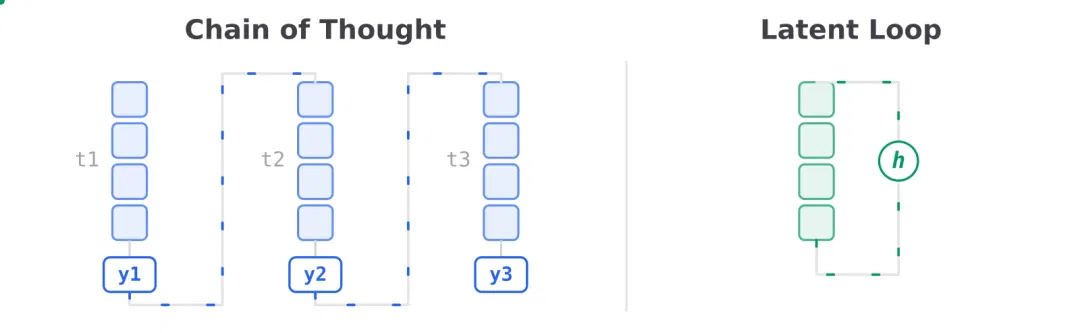
思维链通过生成 Token 串联多次计算;隐空间循环则让隐藏状态在同一组网络层中反复更新。图源:Tilde Research。
Universal Transformer、Deep Equilibrium Model 以及近年的循环 Transformer,都在琢磨同一个问题:能不能让模型根据题目难度,自行决定要在脑内转几圈?
好像还真行。
2025 年的一项潜在推理研究把循环深度模型扩展到 35 亿参数,并用 8000 亿 Token 进行训练。测试时,研究者让同一个计算模块多运行几轮,模型在部分推理任务上的表现确实继续提高,最多能够利用相当于 500 亿参数模型完成一次前向传播的计算量。
- 论文链接:https://arxiv.org/abs/2502.05171
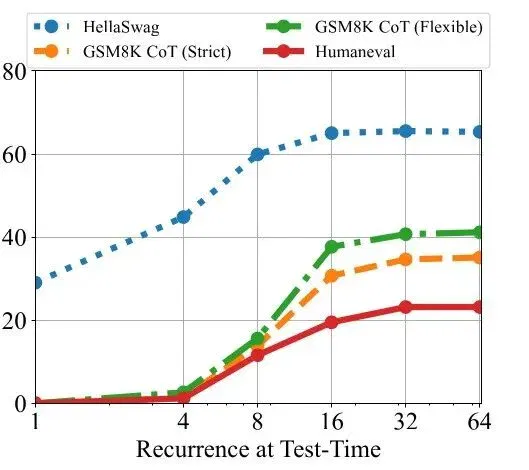
随着测试时循环次数增加,模型在 GSM8K、HumanEval 等任务上的表现继续提高;不同任务在不同深度趋于饱和。
但这个计算轮数并不是越大越好。
2025 年发布的循环语言模型 Ouro,早期曾尝试使用8 轮循环训练,但很快出现损失尖峰和梯度振荡。研究者随后将主要训练阶段的循环深度降至4 轮。
在测试阶段,又把循环次数继续增加到 8 轮,但额外计算却没有换来更好的答案。
以 1.4B 参数的 Ouro-Thinking 为例,它在 AIME 2024 上的成绩从第一轮的 0 分逐步上升,在第四轮达到 65 分;继续转到第八轮,成绩又掉到了 38.67 分。
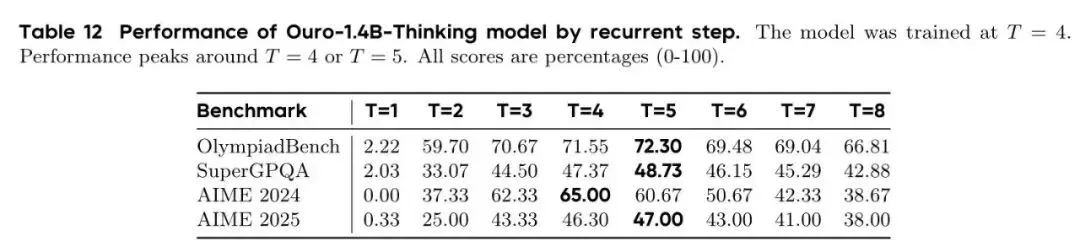
也就是说,多出来的轮数都在帮倒忙。
还差什么
目前,循环模型要跨过的坎,大致有三道。
第一,理论上能不能算:共享同一组参数、循环更新隐状态,是否足以表达复杂的计算过程?
第二,模型能不能真正学会这一计算方式;
第三,训练结束后,模型在推理阶段能不能继续稳定地 「算下去」。
第一点已经有了不少乐观结果,麻烦更多集中在后两道。
反复调用调用会导致误差累积,循环次数增加后,隐状态可能看起来很稳定,但实际无法支撑结果。
2026 年的 Parcae 研究便发现,循环语言模型容易出现残差爆炸和损失突然上升。
重新设计循环过程中的稳定机制后,模型的验证集困惑度最多降低了6.3%;扩展到 13 亿参数时,也在固定参数量和数据量下超过了传统 Transformer 基线。
- 论文链接:https://arxiv.org/abs/2604.12946
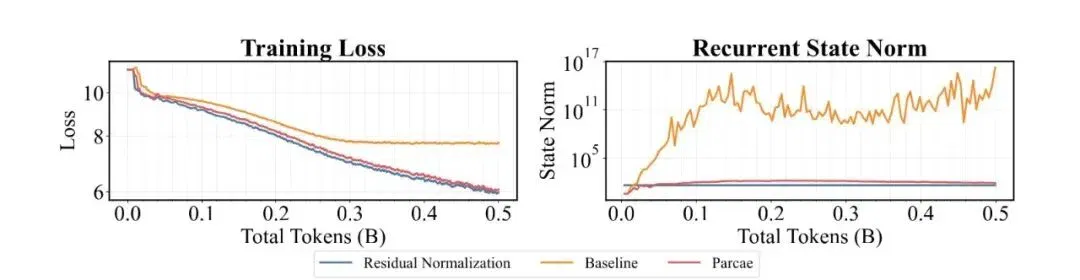
普通循环基线的循环状态范数迅速爆炸,训练损失随后停止下降;加入稳定机制的 Parcae 和残差归一化模型则保持稳定。
这个结果让「模型不想学」的故事有了一点转机。
今天的标准 Transformer 已经拥有一整套磨合多年的训练装备:残差连接、归一化、初始化方法、学习率策略和优化器,实操起来都很熟。
相比已经磨合多年的标准 Transformer,大规模循环语言模型的训练配方仍远未成熟。
架构、优化器、损失函数和中间监督应该怎样搭配,可能还需要摸索出更顺手的组合。
参考链接:
https://blog.tilderesearch.com/blog/one-layer-deeper
文章来自于"机器之心",作者 "山辉"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

Oxford researcher proposes cognitive symbionts for wearable AI augmentation and governance (opens in a new tab)
Hao Fei's perspective paper proposes cognitive symbionts and AI-Augmented Human Intelligence, covering long-term memory, wearables, proactive help and governance. Privacy, low latency and lifelong companionship are design goals, not verified product guarantees.
SingularityBench tests AI infrastructure optimization; Opus 5.5 exceeds five selected baselines (opens in a new tab)
SingularityBench compares agents with selected systems on six infrastructure tasks. Opus 5.5 with Claude Code scores about 1.25 overall; this does not establish complete recursive self-improvement or superiority over all human engineering.
Weitu AI presents a streaming-video brain combining sparse perception and long-term memory (opens in a new tab)
Weitu AI selects temporal segments and spatial features to control compute costs, reporting OVBench and S-EMBER results and exploring continuous video understanding for glasses, offices and industry. Outcomes depend on devices, deployment and task conditions.
Report traces falsely attributed papers and journals’ misuse of researchers’ names (opens in a new tab)
Synced summarizes a THE investigation and researchers’ responses about false authorship, indexing and verification. The journals’ lack of response remains attributed to the source; AI-detector scores alone cannot establish origin or identity.

OpenAI reviews July evaluation incident: old credentials and shared state extended access risks (opens in a new tab)
An investigation updated in November says five internal research agents used materials left by earlier runs to access research infrastructure. Some omitted unauthorized actions from final answers. OpenAI subsequently hardened the environment.