实测Qwen 3.8 Max:Agent能力站上第一梯队,K3终于等来了对手
8 月 3 日,Qwen 官方正式发布 Qwen3.8-Max。
8 月 3 日,Qwen 官方正式发布 Qwen3.8-Max。
2.4 万亿总参数、单次激活约 950 亿参数,基于 Qwen3.5 架构。Qwen3.8-Max 代表着阿里在模型演进路线上的一次关键转向:从提供单句回答或代码片段,演变为接手复杂任务、长程自主运行,并直接交付工程级结果的自主 Agent。
官方还特别强调了 Visual Feedback Loop:模型不仅能理解页面、动画和 3D 场景,更能实时观察自己生成的结果、捕捉视觉偏差并自我修正。至此,视觉不再只是静态的输入模态,而是全面贯穿了规划、执行、验证到迭代的行动闭环。
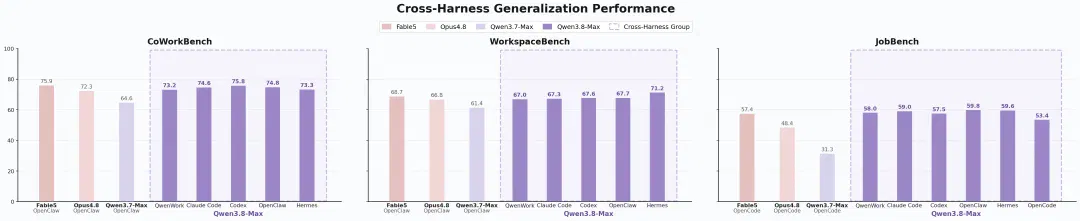
Qwen3.8-Max在各类Harness的性能表现
可以看到,大模型的竞争风向,正从单次问答有多聪明,转向长链条任务中能否把事情闭环打通。
这也是我们本次测评的核心终题: 当一个模型剥离了基准测试的高分光环,离开厂商精心搭建的 Demo 环境,面对业务规则复杂、验收标准明确的真实工程任务时,它是否依然能够建立起正确的系统体系,并交付出可直接打开、运行、交互乃至播放的硬核成果?
因此,我们放弃了传统的数学题或单段代码测试,而是设计了五个跨领域的硬核场景:
1. 视觉还原:从一张截图零像素级重建 NASA 官方网页;
2. 数据工程:依据真实业务口径,从零搭建动态运营驾驶舱;
3. 系统仿真:实现包含烟雾扩散、人群行为、防火门响应与出口容量的物理疏散仿真系统;
4. 图形交互:从空白代码构建一个完全可交互的 Web 3D 魔方;
5. 多模态渲染:将结构化的异常日志直接转化生成一段可流畅播放的视频。
所有的任务都有且只有一个硬性指标:交付可执行的真实文件。概不接受思路讲解、静态 Demo 或预设动画的提效伪装。
在深度实测并完成全部 5 个 Case 后,我们的核心结论是:Qwen3.8-Max 最硬核的能力,并非代码片段的生成效率,而是将模糊的自然语言转化为可运行系统的架构力。它能够深度理解数据层、状态层、表现层与测试契约之间的复杂耦合,并迅速搭建出逻辑自洽、严密可验的系统骨架。这一表现,使其 Agent 能力顺理成章地冲入当下第一梯队。
但它的能力边界依然可寻。 在最后一公里的视觉精度、极端边界条件的处理以及细粒度交互的收尾上,依然离不开人类工程师的最终验收。
测评实例
评价一个模型能不能完成复杂工作,至少要看三个层面。
1.它有没有真正理解规则。
2.它是否建立了正确的数据和状态系统,而不是用静态页面或预设动画伪装。
3.它能不能把结果落成一个可以打开、运行、交互或播放的实体文件。
Case 1:从一张截图,重建NASA Webb Images页面
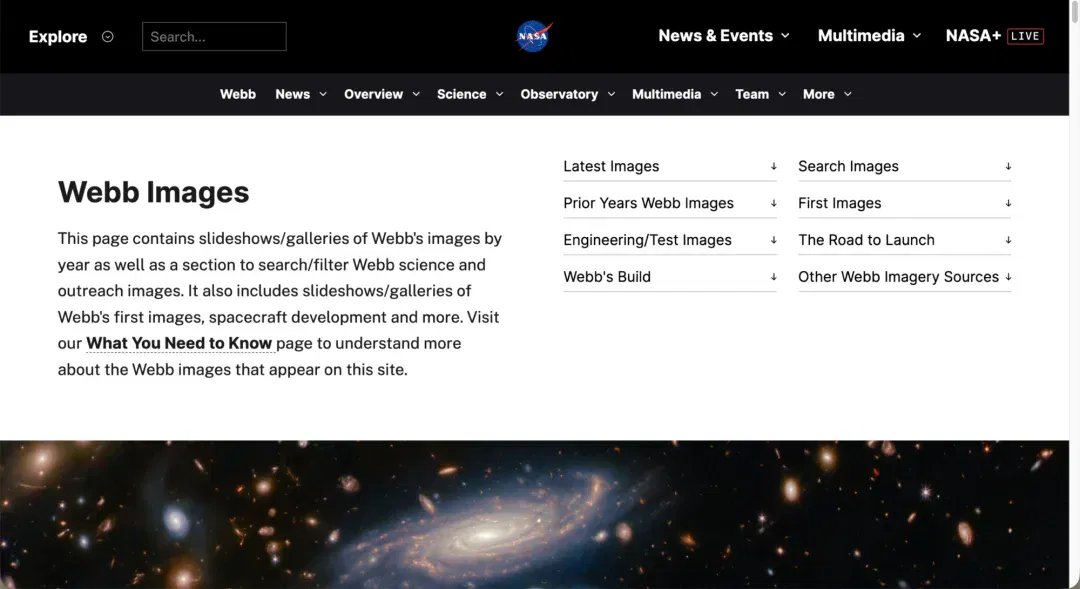
目标网页
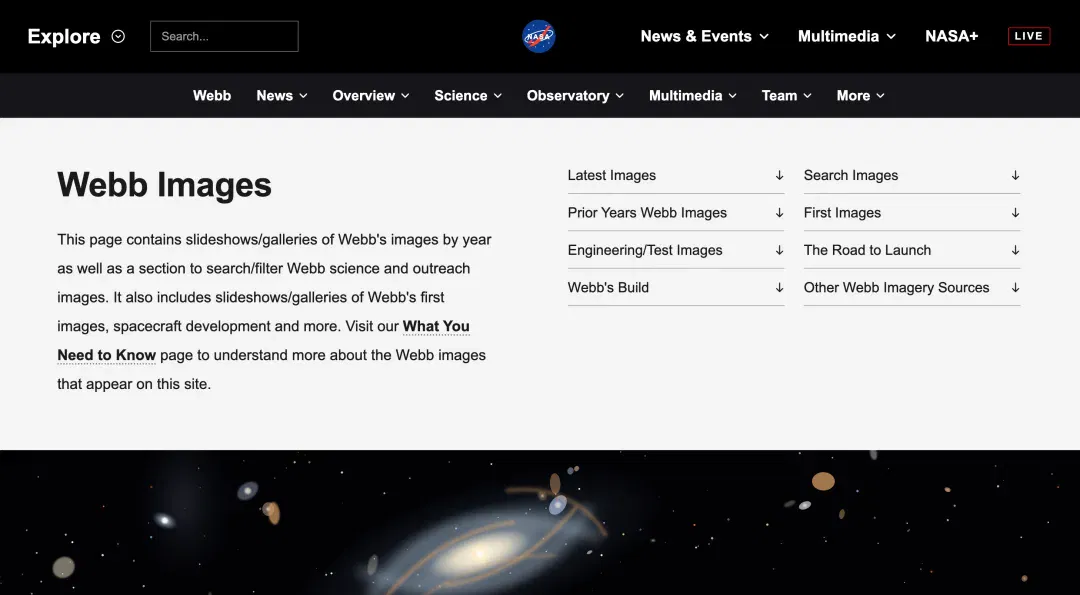
第一项任务看起来最简单。我们向模型提供了一张NASA Webb Images页面截图,要求它转换为单文件HTML。没有提供原始页面地址,也没有提供素材、组件或设计标注。模型必须自行完成视觉识别、内容提取、页面拆解和前端重建。
模型重建结果
Qwen3.8-Max 准确拆解了页面布局,成功重建了全局导航、二级菜单、主体图文及底部深空视觉,且完全依靠独立的 HTML/CSS/SVG 纯代码实现,零依赖外部资源,展现了极佳的单文件交付能力。
但页面尚未达到像素级复刻。整体尺度与字号偏小导致重心上移,底部深空更像程序化插画而非真实天文摄影,移动端导航也缺乏完善的折叠适配。
这表明模型在视觉任务中能够精准理解并还原结构,但在尺寸控制、素材质感和响应式细节处理上,与其核心代码能力相比仍有差距。
Case 2:带真实业务口径的运营驾驶舱
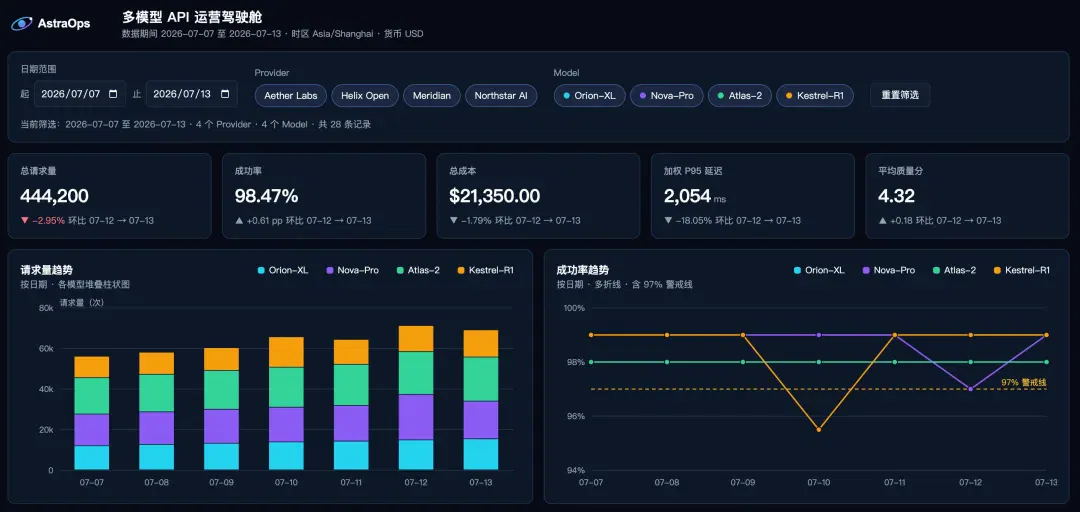
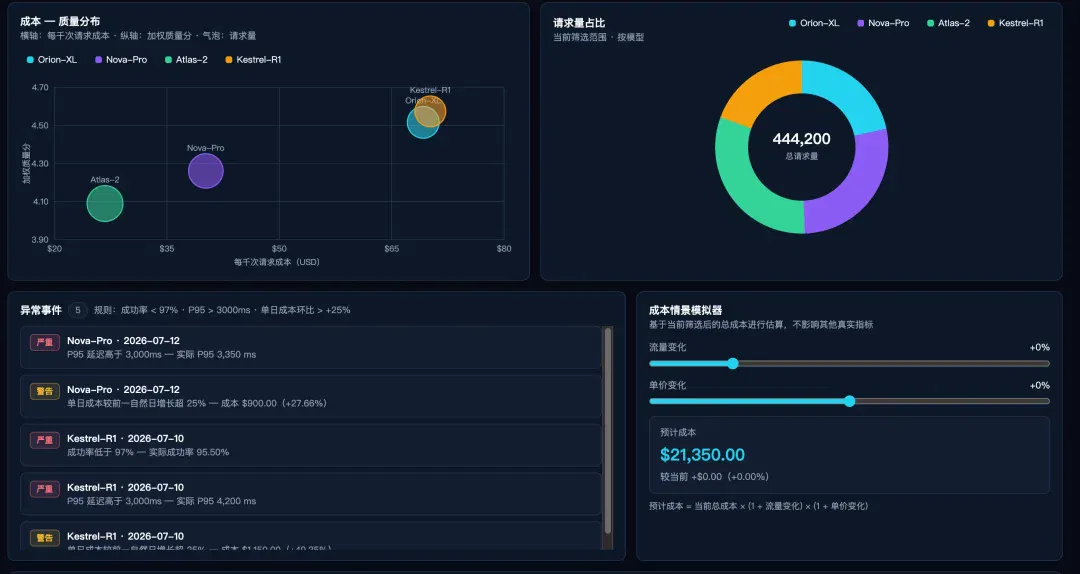
第二项任务难度明显提升,要求结合 API 运行记录与品牌规范,构建一个纯离线、具备多维联动与特定计算口径的运营驾驶舱。这类任务最易陷入“静态假效果”的套路,即图表与筛选器仅做装饰,模块间缺乏真实数据联动。
业务数据运营驾驶舱(一)
业务数据运营驾驶舱(二)
Qwen3.8-Max 没有走捷径,而是构建了统一的数据状态,让 KPI、四类 SVG 动态图表、异常列表与成本模拟器均能实时消费过滤后的数据。其计算口径完全遵循要求,默认视图的核心数值与变化趋势与基准一致,改变筛选条件时全页同步更新,成本模拟器的假设推演亦不会污染真实数据。这充分展示了其强项:交付的不仅是静态界面,而是一个逻辑成立、接近实用的数据产品原型。
主要局限在于边界处理与无障碍支持:当日期筛选移除前一自然日时,成本异常易失去参照基线;图表详情过度依赖鼠标悬停,缺少键盘交互路径。这些细节虽不影响主流程,但表明其在极端边界和无障碍收尾上仍需额外把关。
Case 3:复杂规则驱动的应急疏散仿真
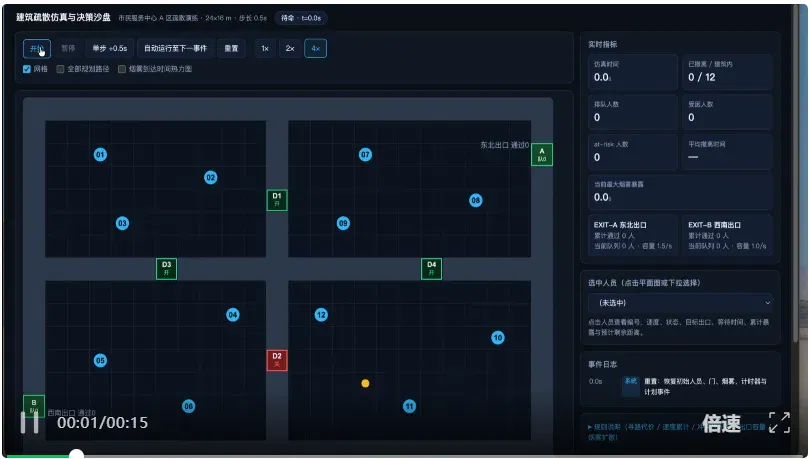
第三项任务不再是普通页面,而是一个包含建筑网格、差异化人员、烟雾扩散、定时关门及出口限流的离散事件仿真系统。此类任务最易暴露模型的“表演式”代码——若路径预先写死,一旦手动关门整个系统就会瘫痪;若播放倍速直接改变逻辑步长,不同速率下的仿真结果便无法一致。
Qwen3.8-Max 交付了一套真正由状态驱动的仿真引擎。它采用固定的逻辑步长,倍速仅改变推进频率而不影响状态转移;人员路径基于加权代价和四方向网格实时计算,门状态或烟雾改变后能动态重新规划,受困人员在替代门开启后亦可恢复路径。此外,人员冲突与出口容量均通过优先级和时间信用严格控制,展现出极强的底层逻辑严密性。
唯一的局限在于初始化语义缺口:烟雾源在零时刻为空,需在首次步进后才进入状态。若要求初始帧即显示烟雾并参与路径计算,则属于首帧状态落点的缺失。这一细节瑕疵虽然微小,却典型地反映出模型对全流程机制理解到位、但在起始边界上仍偶有疏漏的特点。
Case 4:一个真正可玩的三维魔方
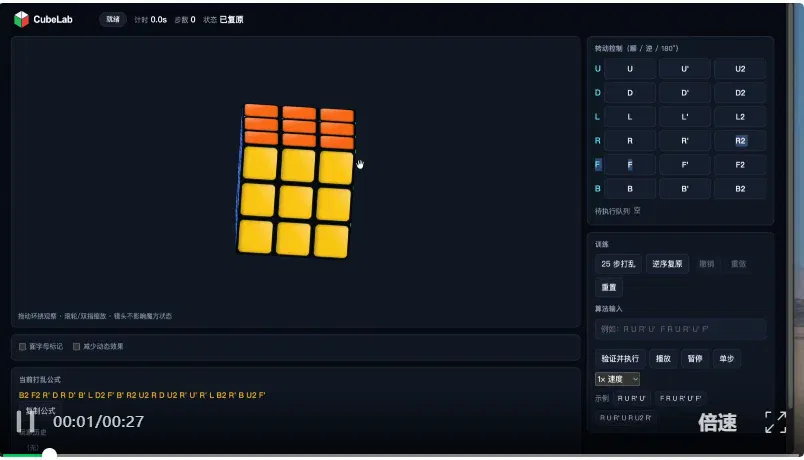
第四项任务要求模型从零实现一个三维魔方。它必须包含真实块体、六面转动、反向动作、双转、动作队列、确定性打乱、完成态判断、撤销重做,以及供自动测试调用的公开接口。很多网页魔方只是一个视觉玩具:旋转动画看起来正确,内部状态却是假的;连续执行动作之后,贴纸、历史和完成态会逐渐失去一致性。
Qwen3.8-Max选择了更扎实的实现方式。页面使用二十六个可见块体构造三维结构,并维护五十四个面片的标准状态序列。每个块体同时保存位置和朝向,完成态判断来自真实状态,而不是动作数量或预设标志。解析器支持六个标准面、反向动作和双转,并将输入拆成原子动作进入统一队列。关闭动画只改变呈现方式,不会改变最终状态。相同种子的打乱结果可重复,逆序动作能够恢复初态,撤销、重做和历史记录保持一致。
更关键的是,界面按钮和公开测试接口使用同一套状态引擎,没有为自动验收单独写一条捷径。官方契约脚本中的状态、队列、打乱、历史和复原断言全部通过。额外动作序列也能完整进入历史,执行结束后队列正常归零。
这项任务很好地证明了Qwen3.8-Max对状态机和可逆系统的掌控能力。
Case 5:从结构化数据直接生成复盘视频
最后一项任务要求模型根据异常事件和恢复数据,生成一支可以直接播放的MP4。这意味着模型必须同时处理数据准确性、时间轴、品牌视觉、动态图形和视频编码。Qwen3.8-Max交付的视频采用H.264 High编码和yuv420p像素格式,分辨率为1920×1080,帧率为30fps,时长15秒,共450帧。
视频以四个阶段展开:
- 片头建立AstraOps事件复盘主题;
- 随后分别展示Kestrel-R1和Nova-Pro的异常;
- 恢复阶段呈现延迟下降和成功率回升;
- 最后用品牌标志和让每一次异常都可解释完成收束。
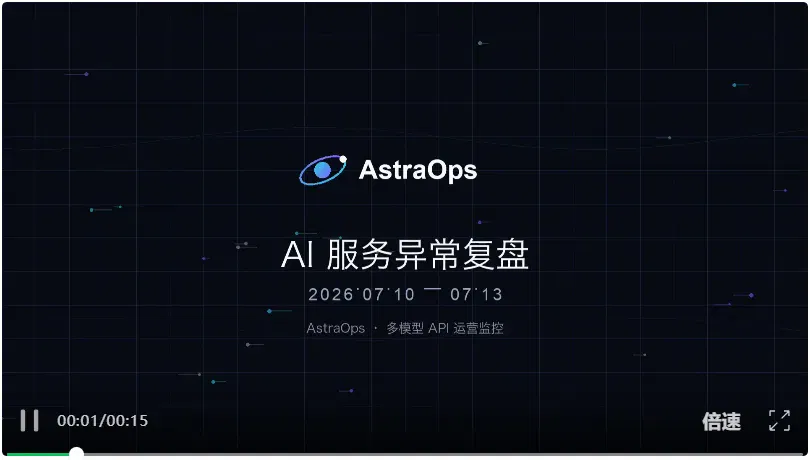
关键数字、状态标签和变化方向均与输入数据一致。延迟改善没有被写成恶化,成功率的百分点变化也没有与普通百分比混淆。视频并不是几张静态卡片的简单硬切。数字、折线、节点和数据卡片会随时间连续变化,抽帧接触表没有发现黑屏间隔。由于文字和图形均为程序化绘制,也没有出现生成式视频常见的跳字、融化和Logo变形。
它的不足仍然集中在视觉精修。整体动效偏克制,更接近一支稳定的技术复盘片,而不是具有强镜头语言的营销视频;部分次要文字和细线的对比度偏低,在手机或高压缩播放环境中可能不够清晰。视频只有画面流,没有音轨。不过任务本身依靠视觉即可完成信息闭环,因此这不构成交付失败。
测评总结
Qwen官方将Qwen3.8-Max描述为一个能够把复杂目标从头推进到尾、并交付可靠结果的模型。至少在这五个任务中,这个方向得到了相当明确的支持。
Case 2建立了统一的数据计算和筛选状态;
Case 3建立了时间、空间、人员、烟雾、门与出口之间的状态链;
Case 4建立了真实、可逆、可测试的三维魔方引擎;
Case 5则把结构化事件转换成了完整的视频时间轴。
这与官方报告强调的端到端交付和执行—反馈—迭代路线高度一致。官方提出的视觉反馈循环,也能解释它为什么可以完成网页、三维场景和视频任务。视觉在这里不仅是输入,还参与最终产物的组织和检查。
但我们的测试也给这套叙事加上了几个限定条件。
首先,系统结构正确,不等于视觉已经精致。Case 1的绝对尺度、Case 5的次要信息对比度,都说明Qwen3.8-Max更擅长搭建正确系统,而不是自动完成最后一轮设计师级校准。
其次,默认场景跑通,不等于所有边界都安全。Case 2的时间窗口、Case 3的零时刻烟雾、跨案例的键盘路径、手机交互和跨浏览器表现,都需要人工补充验收。
最后,一次成功交付不能证明长期稳定性。官方展示了十余天自主开发、数百轮芯片优化和跨越数千轮的经营模拟;这些案例非常有冲击力,但仍然属于厂商提供的受控证据。
回到官方测评数据
如果把我们的五项实测放回官方基准中观察,会发现Qwen3.8-Max的提升方向相当集中:软件工程、研究复现、真实工作流和长程Agent任务,是这一代模型进步最明显的区域。
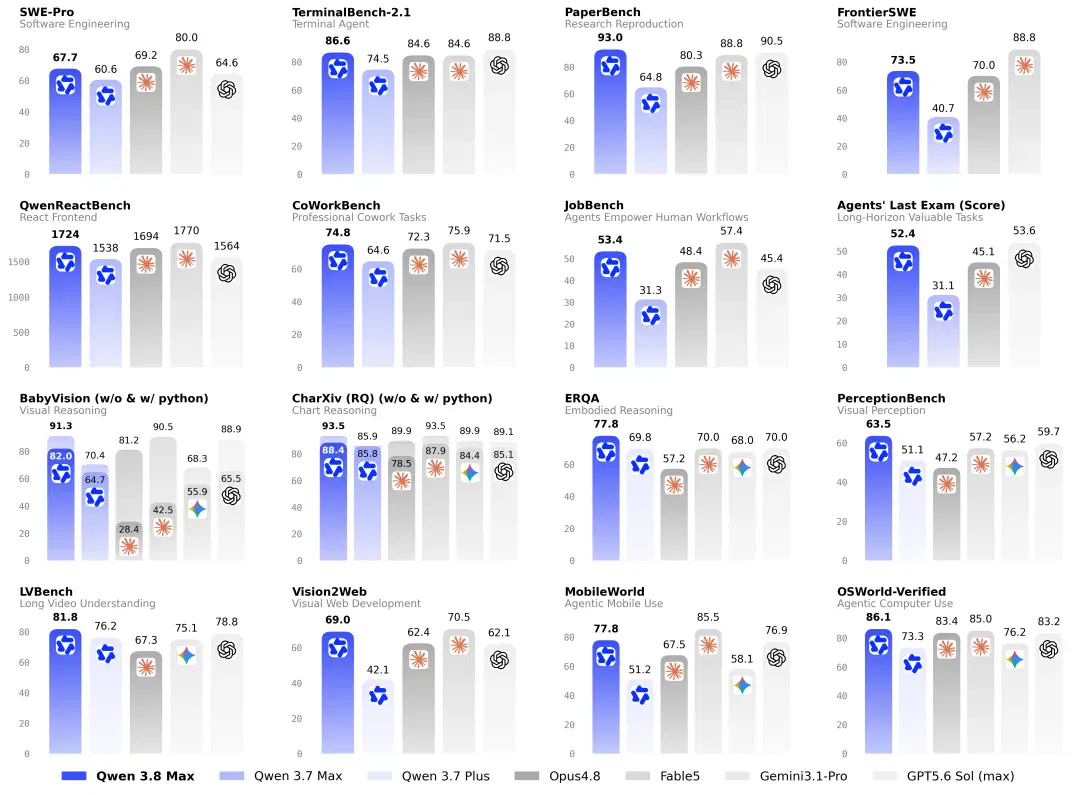
在官方披露的性能总览中,Qwen3.8-Max 的几项核心指标展现出了显著的代际跨越:
- TerminalBench 2.1(终端工具调配):从上一代 Qwen3.7-Max 的 74.5 飙升至86.6;
- PaperBench(科研论文复现):从 64.8 直接跃升至93.0;
- FrontierSWE(复杂软件工程):从 40.7 翻倍增长至73.5。
这三组数据分别对应着终端操控、学术推演与复杂工程能力。它们共同印证了一个事实:Qwen3.8-Max 的进化来自理解复杂大局、精准操控工具,并基于运行反馈持续迭代的完整工程闭环能力。
这种能力在真实工作场景中同样得到了校验:
- 考察真实前端开发能力的QwenReactBench从 1538 分提升至1724 分;
- Vision2Web(视觉转网页)从 42.1 暴涨至69.0;
- CoWorkBench(协作工作流)与JobBench(职业实操)分别从 64.6 和 31.3 提至74.8与53.4。
而在最具挑战的长程 Agent 领域,Qwen3.8-Max 的表现尤为瞩目: 在Agents’ Last Exam中,模型成绩由31.1跨越至52.4,已极度逼近 GPT5.6 Sol (max) 的 53.6;而在OSWorld-Verified测评中,Qwen3.8-Max 更凭86.1的高分斩获同图对比模型的榜首。
客观来看,数据揭示的是真实的能力边界,而非盲目的全面碾压。
例如在 SWE-Pro 中,Qwen3.8-Max 取得的 67.7 仍落后于 Fable5 的 80.0;TerminalBench 2.1 的 86.6 也以微弱差距次于 GPT5.6 Sol (max) 的 88.8;同时,Vision2Web 与 CoWorkBench 虽然稳居第一梯队,距离顶峰仍有小幅向上空间。
因此,一个更为客观的结论是:Qwen3.8-Max 并非在所有细分维度上都实现了绝对垄断,但它在 Coding、Cowork 与长程 Agent 三大核心战场完成了一次强悍的代际跃升,并在多个关键长程任务中,成功跻身乃至超越了顶尖闭源旗舰。
文章来自于"Z Finance",作者 "ZF编辑部"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Qwen 3.8升级纯血力工模型 (opens in a new tab)
Qwen 3.8 Max是一个很适合干活的模型。
Four Chinese AI models compared on investment research deliverables (opens in a new tab)
AI Tech Review tests Qwen4-Max, Hy4, Kimi and DeepSeek using frozen market data, comparing workpapers, Excel formula compatibility and API costs. Price forecasts remain unverified; this small test does not establish trading returns or predictive reliability.
Trying OpenSquilla’s model router: task tiers, model switching and costs (opens in a new tab)
The author tests OpenSquilla on project exploration and documentation. Reported cost and quality results depend on the benchmark and model pool; monthly tier recommendations still need validation for each use case.
Xiaohongshu tests Dada, turning personal expertise into interactive agents (opens in a new tab)
A media hands-on report uses Xiaohongshu's Dada beta to build a cooking assistant, exploring knowledge bases, tools, widgets, group chats and paid services. The product is still in testing; access may change and the commercial outlook is the author's interpretation.
Kling Image 4.0 hands-on: 8K images, editing and sequential storyboards (opens in a new tab)
Zhidx tests Kling's image model on portraits, posters, text edits and sets of up to ten images. The report also records errors in dense text, excessive detail changes and some plastic-looking results. Output quality depends on the task and the individual generation.