用K3和GPT的同款考题,测了Gemini 3.6 Flash的前端
谷歌的前端功底有多深,不需要任何人来认证。
谷歌的前端功底有多深,不需要任何人来认证。
Material Design定义了Android世界的设计语言,Chrome DevTools是每一个前端工程师每天打开的工具,Web Vitals直接改写了整个行业衡量网页体验的方式。从设计规范到开发工具到性能标准,谷歌在这条链路的每一个节点上,都是标准制定者。
所以当Gemini 3.6 Flash在2026年7月21日发布、开发者社区随即给它贴上「谷歌史上最差模型」的标签时,你很难不产生一种微妙的荒诞感。一家定义了「好前端」长什么样的公司,自家最主力模型的弱项,竟然是前端。
但口说无凭,我们设计了7道考题,从SaaS落地页到K3和GPT打过擂台的3D浮岛,把Gemini 3.6 Flash从头到尾测了一遍。
谷歌到底发了什么
7月21日,Google DeepMind一口气发了三个模型。C位是Gemini 3.6 Flash,被定位为「主力工作模型」。
官方列出的涨幅集中在后端和Agent场景:DeepSWE v1.1从37%涨到49%,MLE-Bench从49.7%跳到63.9%,OSWorld-Verified从78.4%提到83.0%,GDPval-AA v2从1349升到1421。Token消耗比前代少17%,DeepSWE上甚至砍掉65%。
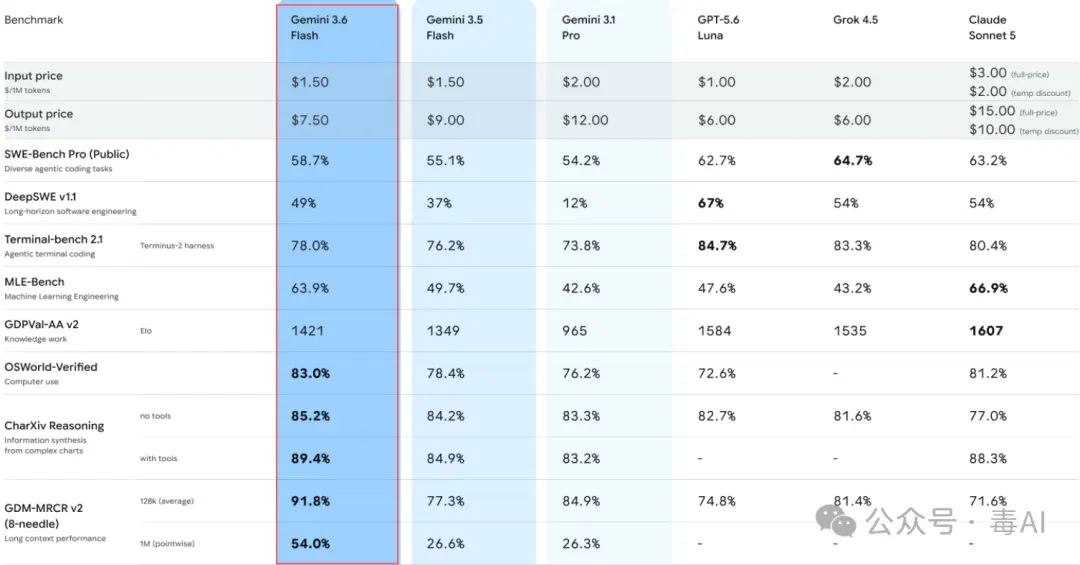
看出来了,快,省,后端强,没有任何一处提到前端设计生成。
同时,官方确认了两件事:被期待了大半年的Gemini 3.5 Pro还在测,「准备好了就发」;Gemini 4的预训练已经启动,这是他们「迄今最雄心勃勃的一次训练」。Pro跳票,4还在跑,3.6 Flash是来撑场子的。
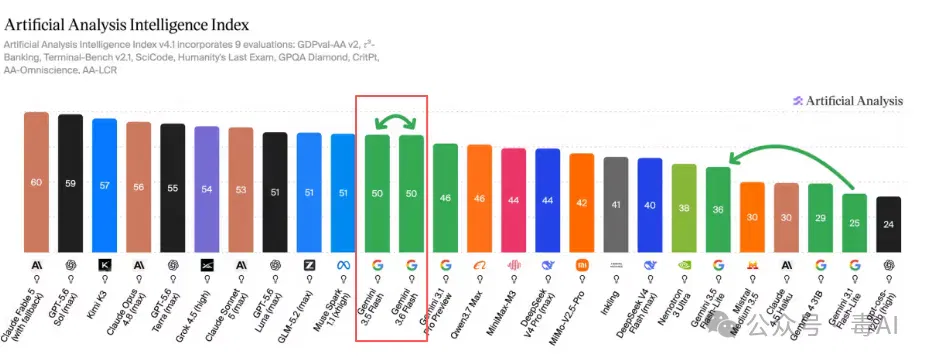
但独立评测不太给面子,Artificial Analysis的Intelligence Index上,3.6 Flash得分50,和3.5 Flash一模一样,零提升。
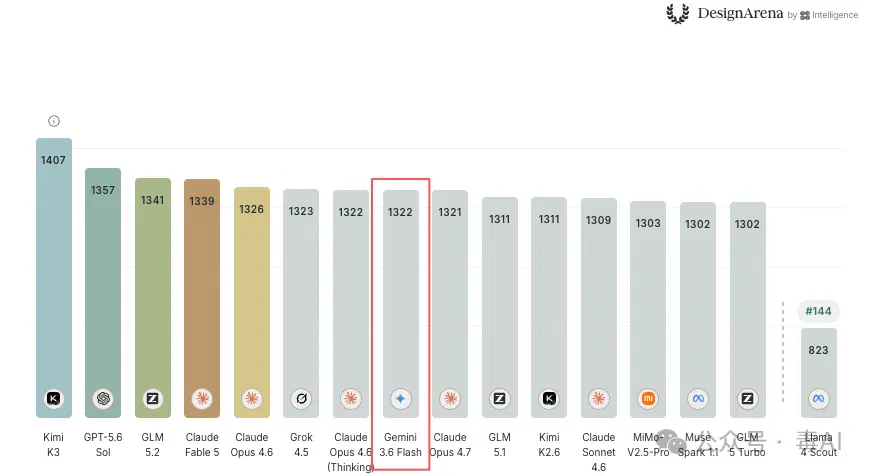
Design Arena非Agent Web开发榜上Elo1322,比Grok 4.5还低一分,落在Claude Fable 5(1339)、GLM 5.2(1341)、Kimi K3(1407)之后。
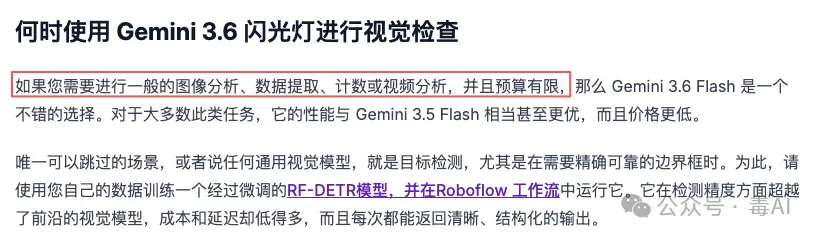
Roboflow的视觉评测更扎心:3.6 Flash虽是「测试过最好的视频理解模型」,但物体检测明显倒退,偷懒到只返回一个大框,JSON格式经常解析失败。
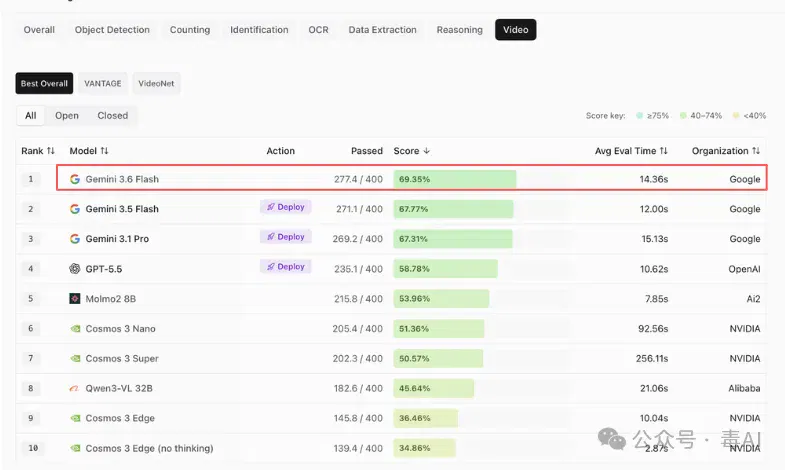
最后Roboflow也是给出了中肯的建议。
7道题怎么出的
出题之前,我们翻了业内两个主流前端评测体系。
Design Arena是全球第一个盲测+真人投票评价AI前端生成质量的平台,非Agent榜分6类:Website、UI组件、游戏开发、数据可视化、3D设计、图片转网站。
Frontend Code Arena加了品牌营销、数据看板、游戏等7个Agent分类,Kimi K3七月登顶时1679分,拿了6个第一。
从这两个体系挑了7个维度:L1-L6单文件HTML一次性输出,对标Design Arena非Agent模式;L7完整React + Three.js项目搭建,在Gemini CLI中执行。
L1 SaaS落地页,L2数据仪表盘:基线不低
L1生成一个完整SaaS Landing Page:Hero区+功能卡片+三档定价+sticky nav毛玻璃+ CSS Grid。
Gemini 3.6 Flash首次直接可运行,配色选了偏暖的橙色系,和市面上泛滥的蓝紫渐变拉开距离。SVG产品示意图自己画的,hover有上浮微交互,定价区层级清晰。生成速度不到一分钟,像模像样,确实有个AI工具官网的样子。
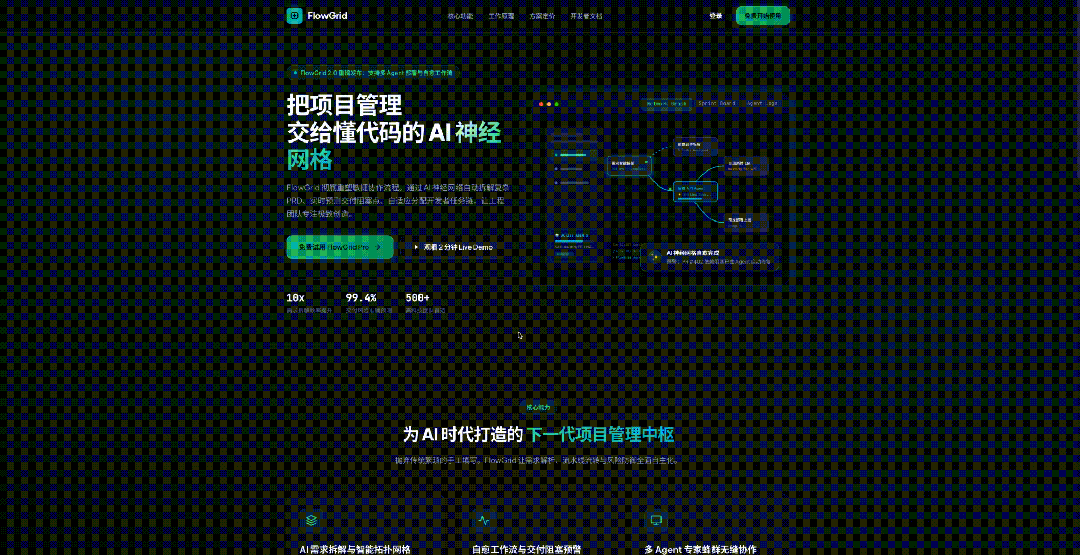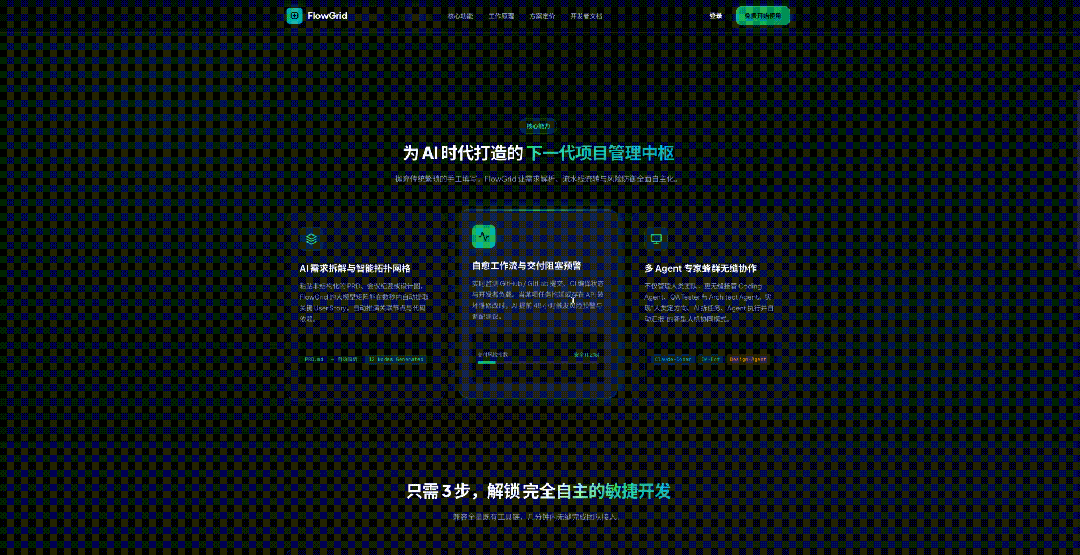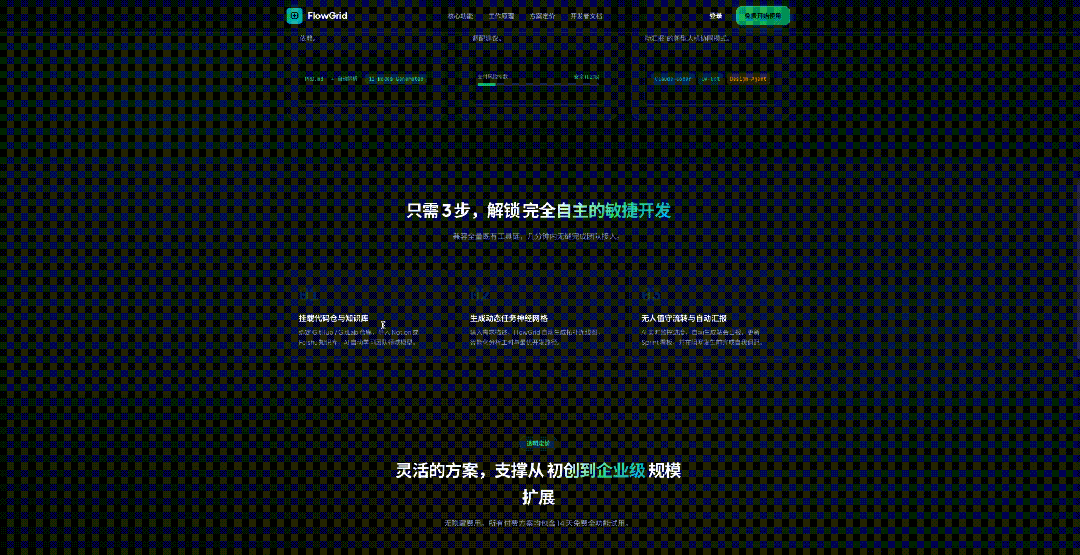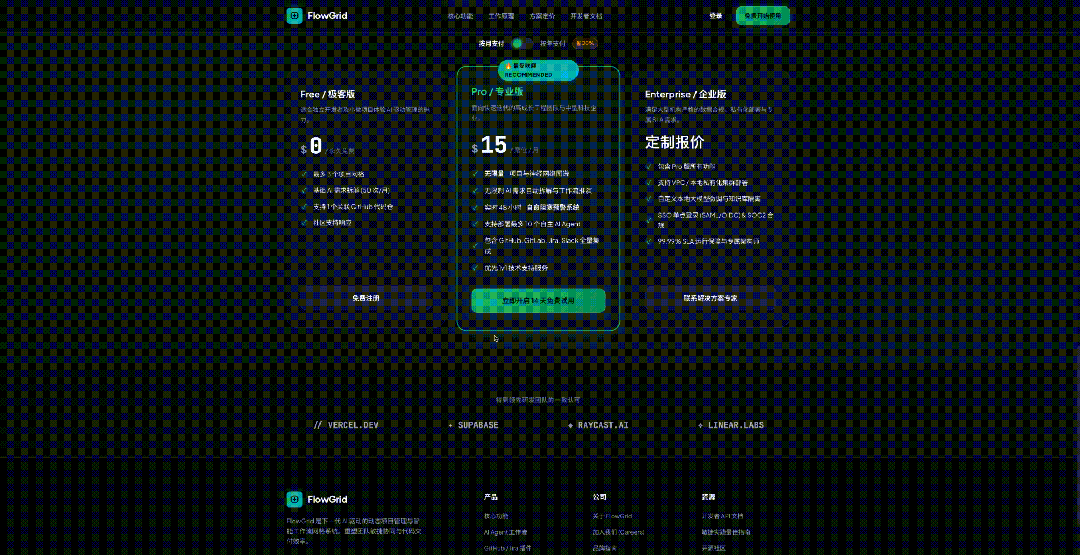
L2是深色主题「AI模型使用量监控仪表盘」:4个KPI卡+折线图+环形图+柱状图+数据表格,Chart.js CDN、Grid三断点响应式。
全部4个图表正常渲染,折线图的Token消耗有真实的工作日/周末波动,侧边栏移动端正确隐藏,三个断点准确触发。仪表和市面上常见的中转站布局很相似,放在真实环境也不违和,AI味不重。
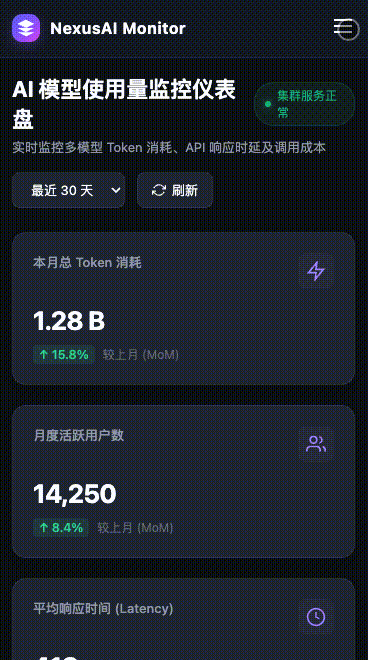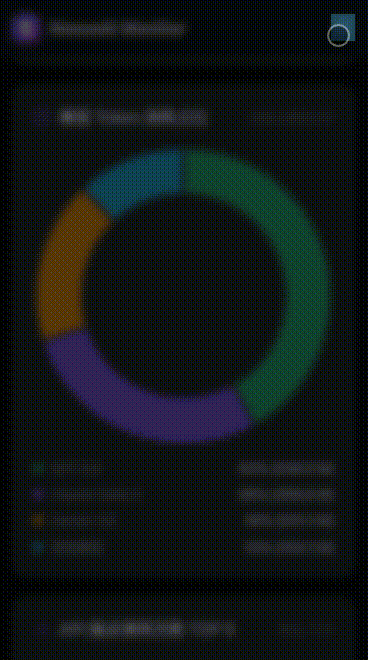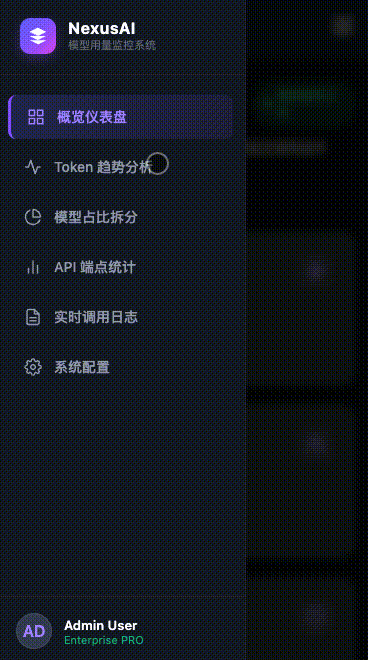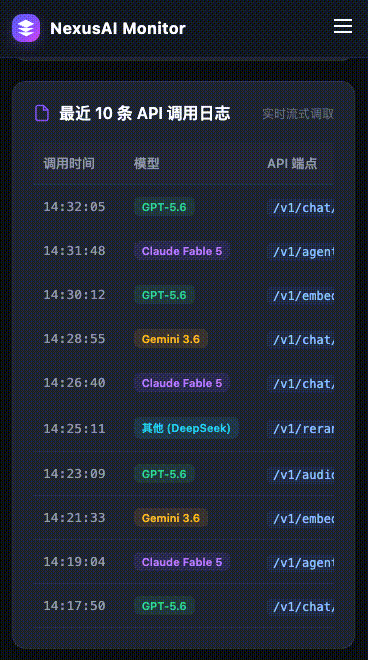
这两个开局说明:Gemini 3.6 Flash在单页面基础前端上有一个不低的基线,它不是「不会做前端」。
L3像素级还原:全对,但像新手做的
L3是一张精确到色号的个人作品集页面。
6个色号全对,3列网格正确,但页面看起来寡淡,毫无张力,像一个前端新手做的。
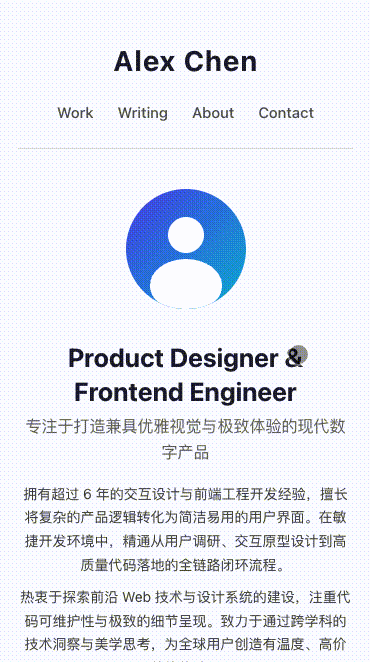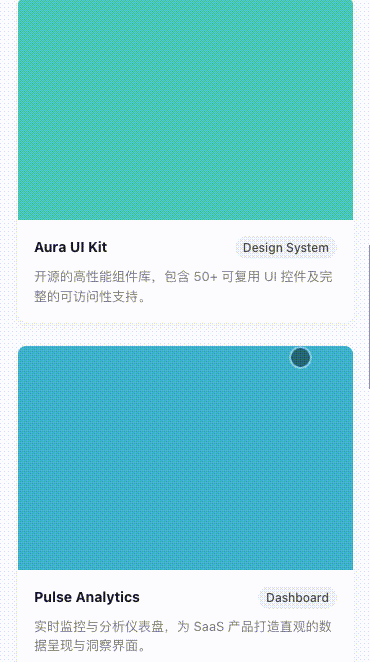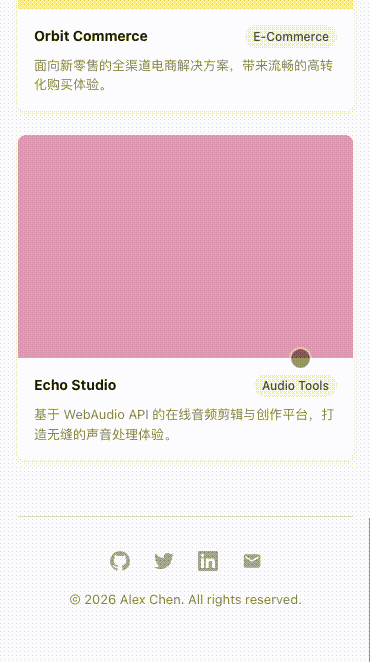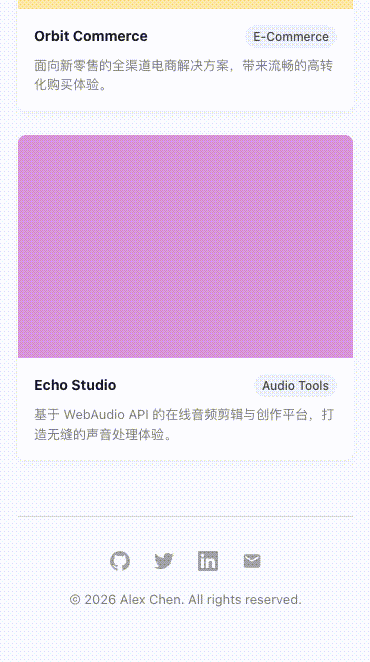
这就是核心矛盾:它能精准执行,但缺乏设计品味你告诉它Hex色号,它不用错。你让它自己发挥,它僵硬地照抄。对比GPT-5.6 Sol被Design Arena指出「明确学会了规避AI味设计反模式」,Gemini 3.6 Flash显然还没上过这堂品味课。
L4拖拽看板:又快又稳,全场最佳
L4是三列Kanban看板,HTML5原生Drag and Drop,添加/删除/拖拽,响应式降级。
这是7个测试里表现最好的一个:拖拽正常、计数更新正常、Modal表单添加+目标列正确插入全通、删除正常、手机端三列变纵向堆叠正确、拖拽时卡片半透明+目标列蓝色高亮两个视觉反馈都做了。
这个项目体现了Gemini前端能力的稳定性,这才应该是Gemini的真实水平。
拖拽是前端原生API里最难正确实现的之一,设计环节上环环相扣,漏一环就「看着能动但实际上不对」。Gemini 3.6 Flash在这个维度上几乎满分。对于一个被骂「史上最差」的模型,这是一次漂亮的反击。
L5电商页,L6创意动效:一个bug,一个惊喜
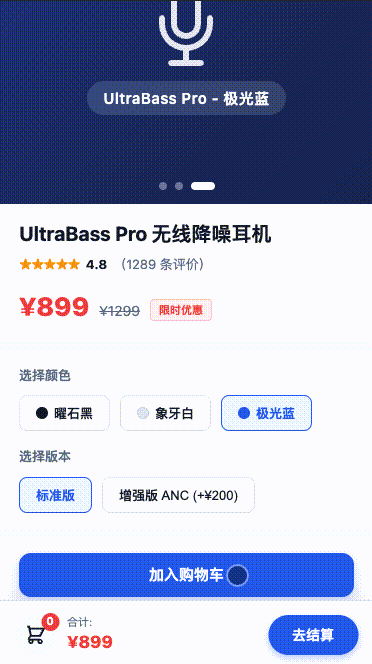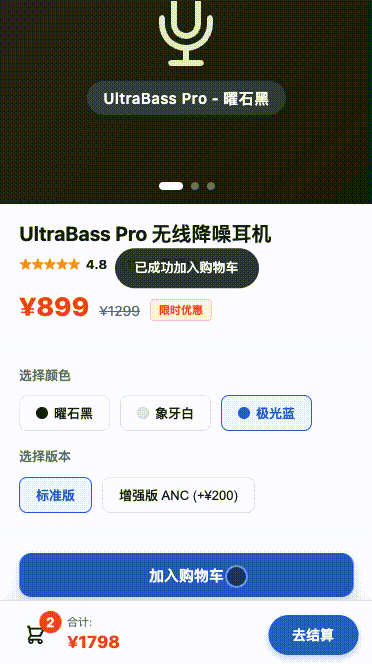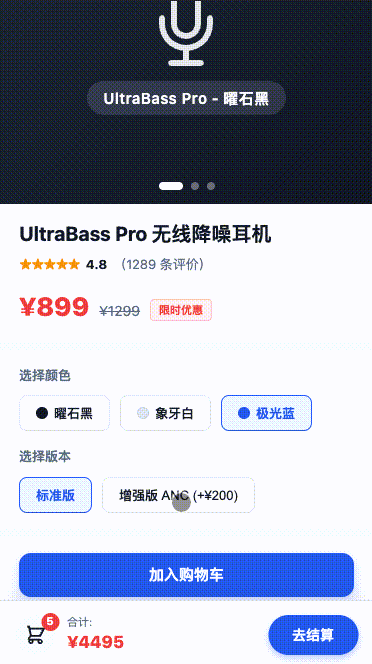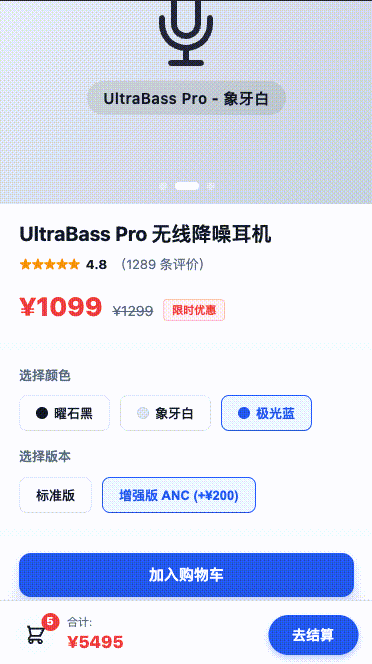
L5是移动端优先的电商详情页,所有功能维度都通过了:轮播、颜色规格高亮、版本切换联动价格、Tab切换、三个断点布局全部正常。
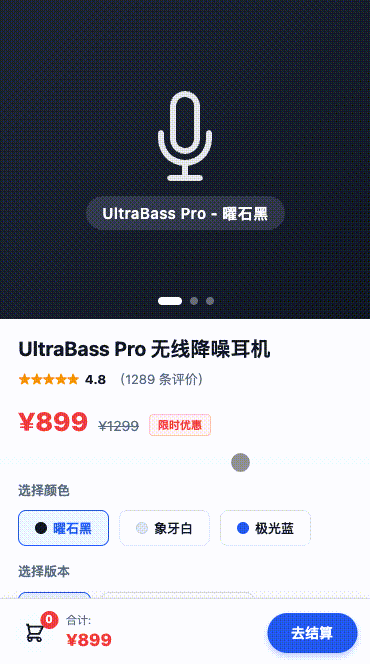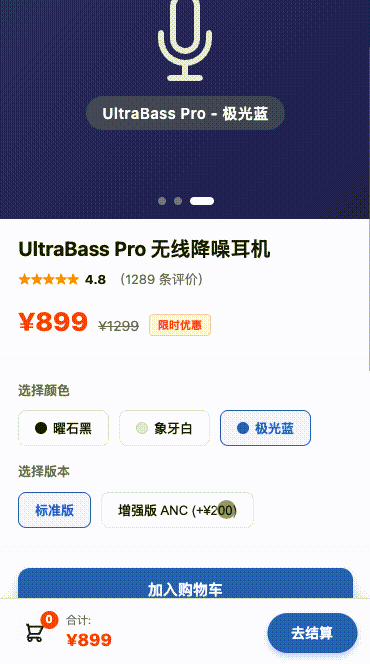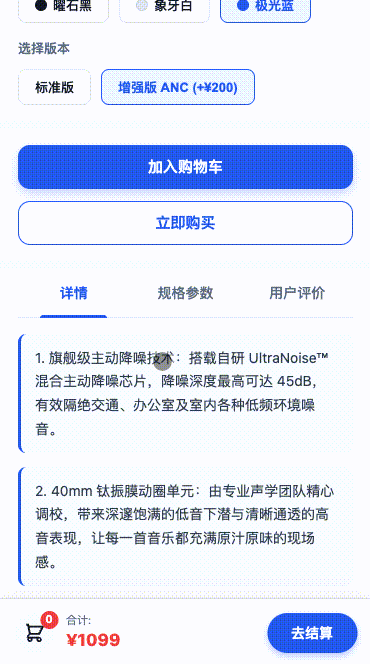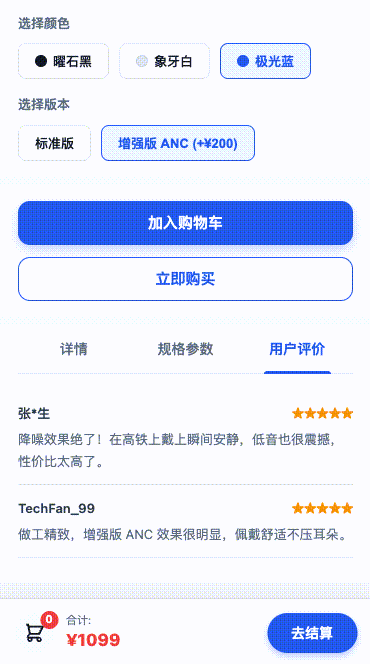
但有个逻辑bug:加入购物车后,在选购界面切换版本,已经加进购物车的商品版本也跟着变了。这是典型的「全局状态污染」,购物车里的对象和选购区指向了同一个引用,做了,但没想全。
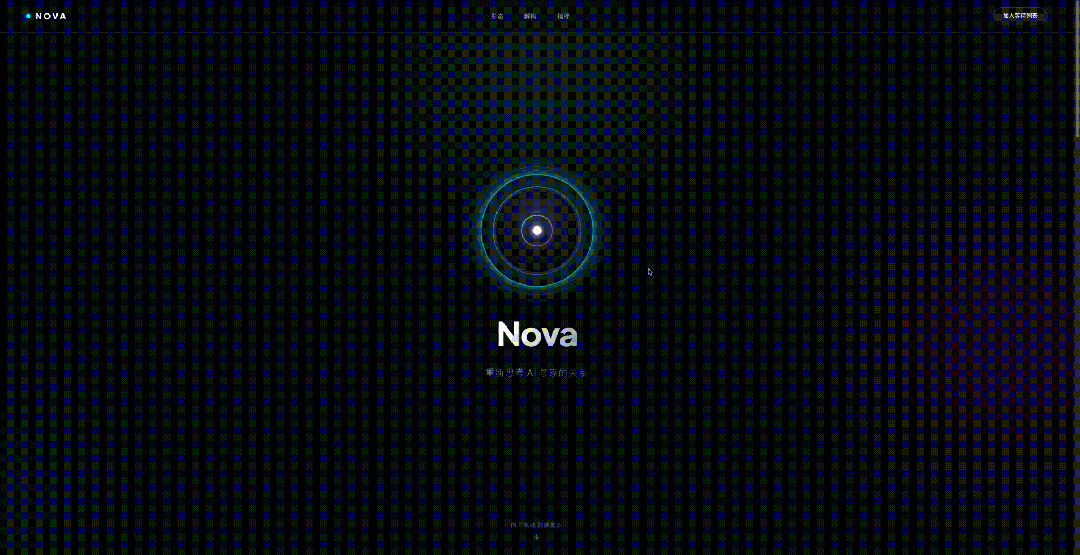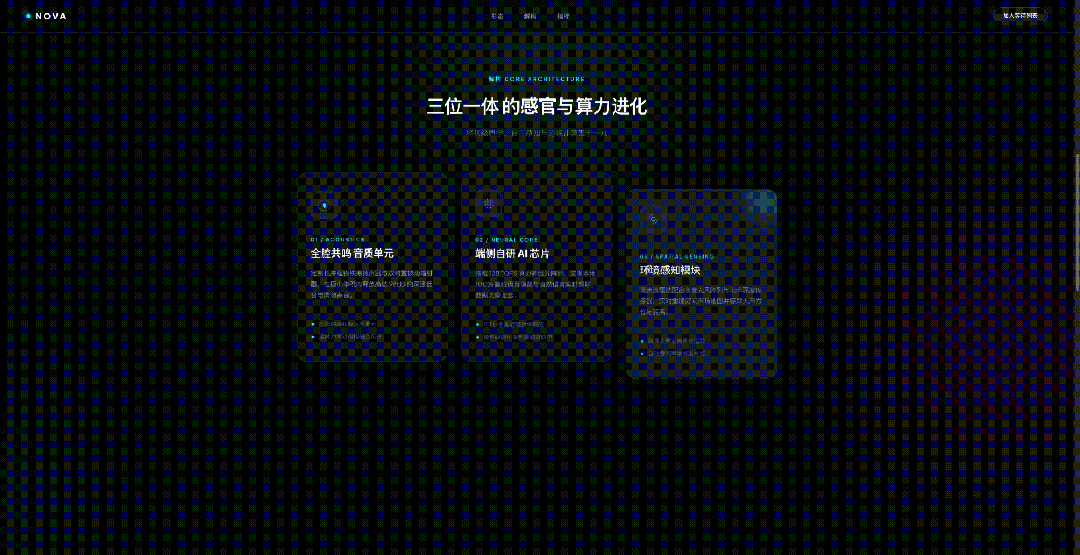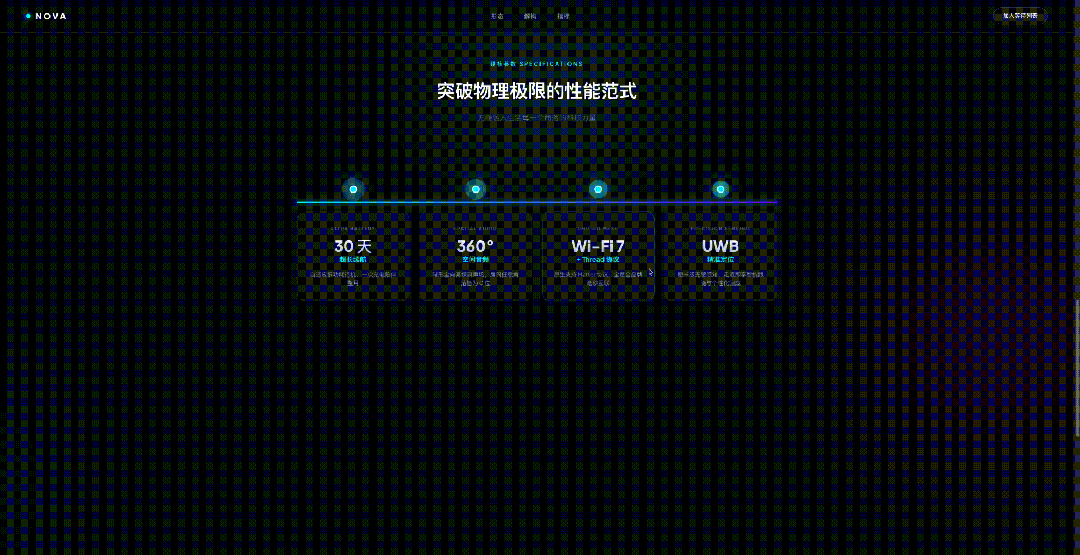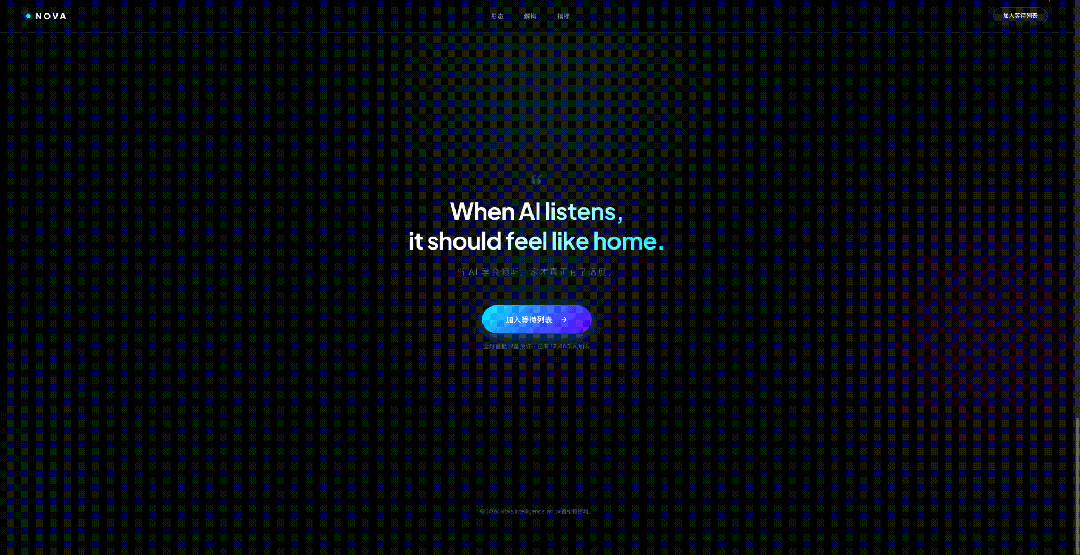
L6是为「Nova」圆形智能音箱做沉浸式产品展示页:全屏脉冲光环动画、Intersection Observer滚动滑入、时间线发光。
脉冲动画正常,Observer正常,3种缓动函数达标。
但真正让人意外的是叙事节奏:从第一屏光环到卡片滑入到时间线亮起到结尾CTA,页面不是单纯往下走,是一条完整的视觉乐章。它不是传统功能列表,而是一次产品发布会的keynote。
L5和L6放在一起,恰好暴露了Gemini 3.6 Flash的两种面孔:死规矩面前保守到寡淡,抽象目标面前反而有创造力。怕死规矩,不怕抽象。
L7 3D浮岛:走进K3和GPT的考场
这是分量最重的一节,我们直接复用了为Kimi K3和GPT-5.6家族设计的同款Prompt,用React + Three.js从零搭建3D浮岛作品集网站。
先看之前的四模型同期对比:
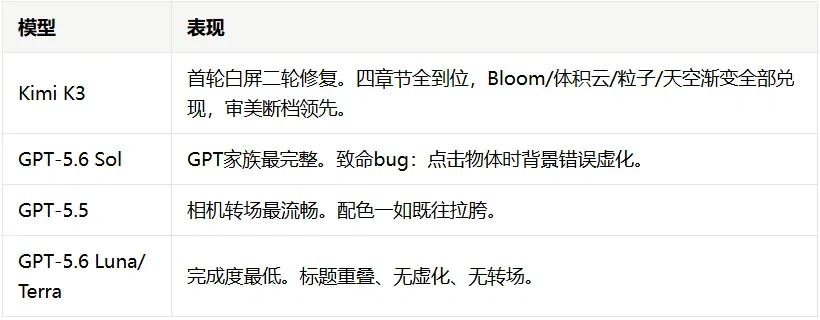
现在看Gemini 3.6 Flash。
完成度不低,浮岛主体、草地、小树、基础瀑布效果都出来了。四章节运镜逻辑在,场景静止时会缓慢自转(其他模型没加的细节),天空配色饱和度偏高,场景过渡流畅。
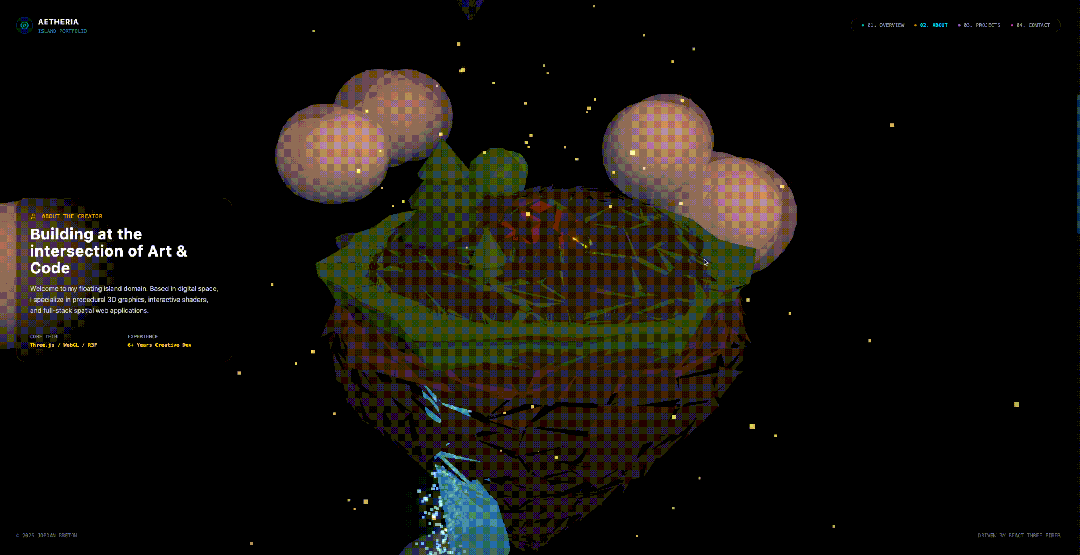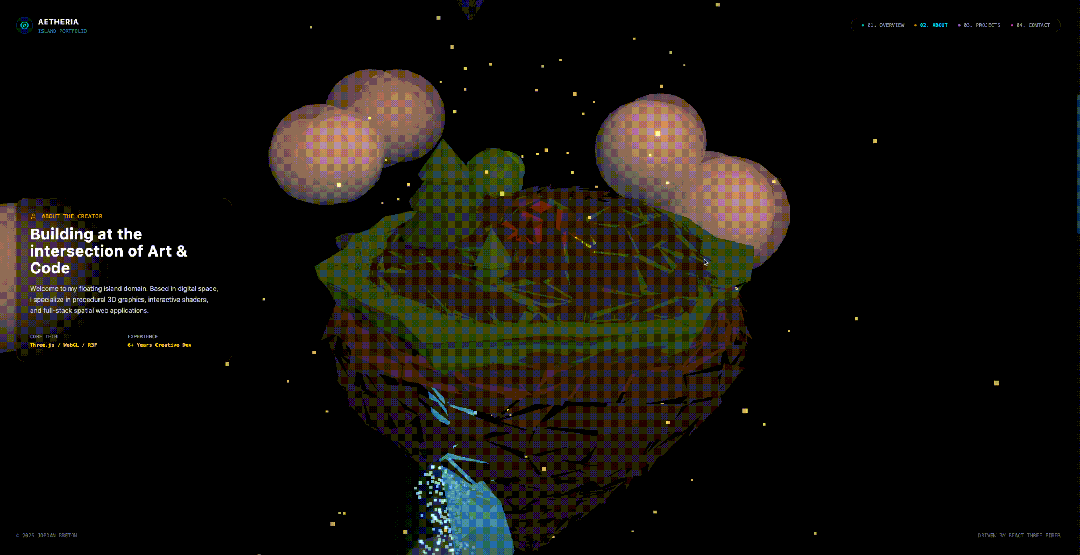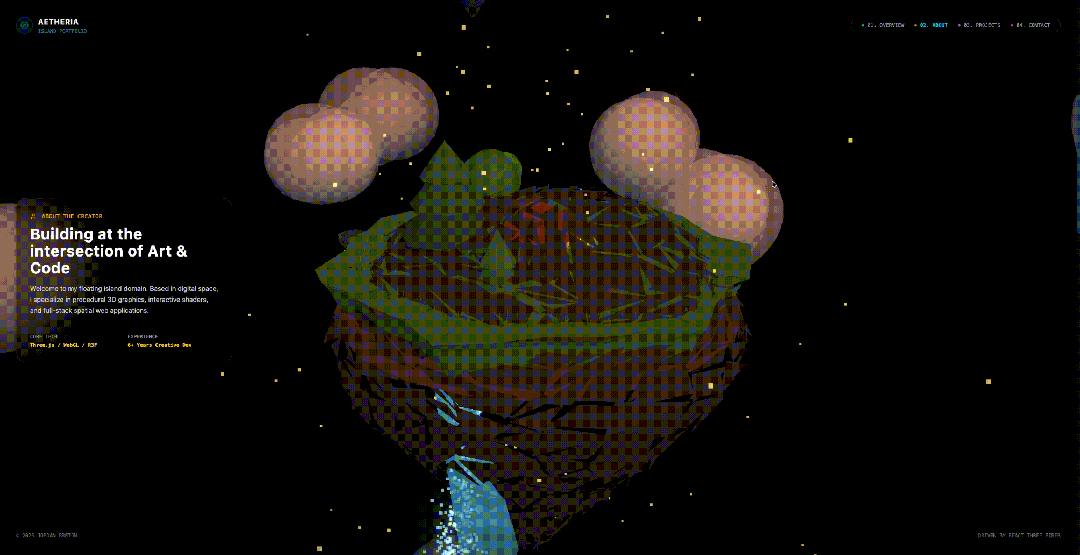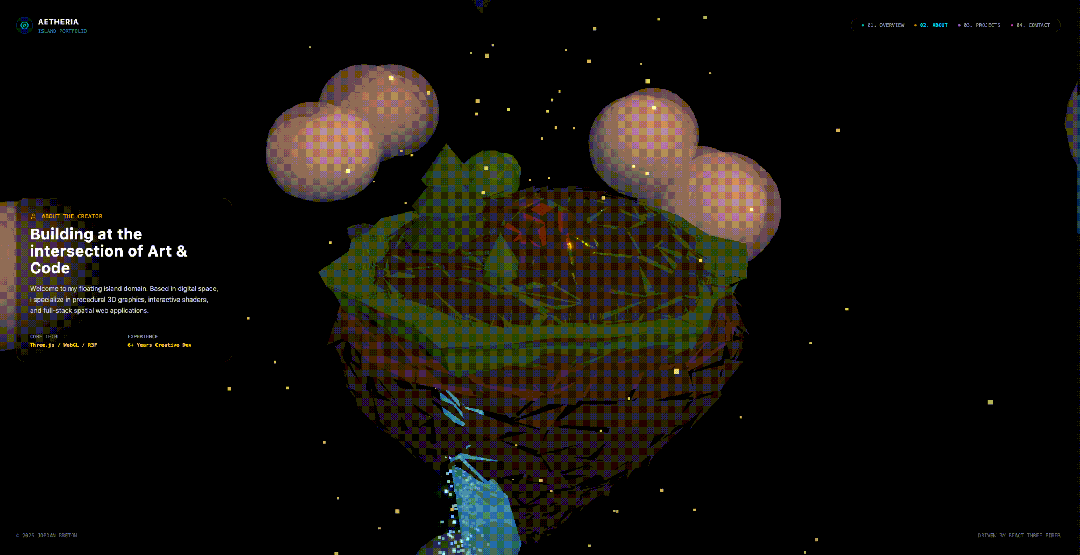
但它不完美,最大的问题是:浮岛草地上方覆盖了一层不明物体,4个本应高亮展示的交互物件消失了。不是渲染错误,是被半透明overlay遮挡了。hover发光放大和点击推进特写的功能在,但你看不见它们。这跟GPT-5.6 Sol「点击物件时背景被错误虚化」的bug属于同一种类:底层功能在,渲染逻辑有偏差,导致用户体验断裂。
还有一个数据:Gemini 3.6 Flash是这个项目里生成速度最快的,遥遥领先。但在3D场景里,「快」和「对」从来不是等价交换。
排进四位对手的擂台,Gemini 3.6 Flash的位置:比GPT-5.5好,比GPT-5.6 Sol略低,远不及K3。
八、还没到最终判决
Gemini 3.6 Flash不是「前端不行」的模型,L1、L2、L4、L6四道题足以证明它有不低的基线,但它有两块天花板。
第一块是设计品味。L3还原全对但寡淡,「精准执行+零审美判断」。GPT-5.6 Sol和K3都在往上修炼品味,Gemini还在「不犯错但不加分」的阶段。
第二块是复杂场景的稳健性。L7的交互物件遮挡、L5的全局状态污染,都是同一个根因:单一维度的能力够了,多维度协同时,一个小偏差就导致体验断裂。
回到开头:谷歌知道怎么做前端,但Gemini 3.6 Flash还记得多少?它记得大部分,但忘了最重要的那部分:不止把事做对,还要把事做好。
谷歌用「workhorse model」定义3.6 Flash,干活儿的马,不是上台表演的马。这个定位很精准,但也是一种自我设限。
当GLM 5.2以MIT开源做到Design Arena Elo 1341,当Kimi K3以开源身份在浮岛项目上击败所有闭源对手,当Grok 4.5用更快的速度和更低的成本持平了3.6 Flash的前端Elo,「Flash系列不是用来做前端的」这个解释,越来越站不住脚了。
毕竟,没有人在乎你是Flash还是Pro,人们只在乎AI做出来的页面看上去值不值得点进去。
文章来自于"毒AI",作者 "高晓阳"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
刚刚,Gemini 3.6 Flash 正式发布,但网友笑得更大声了 (opens in a new tab)
如果你从去年就开始用 Gemini,那感觉就像看着自家兄弟慢慢得了阿尔茨海默症。按理说,一家公司发新模型,通常是来打脸这种调侃的。可就在刚刚,Google 一口气发了三个新模型之后,网友非但没收回这句话,反而笑得更大声了。多少有种他们都不看好你,可偏偏你最不争气的即视感。
Four Chinese AI models compared on investment research deliverables (opens in a new tab)
AI Tech Review tests Qwen4-Max, Hy4, Kimi and DeepSeek using frozen market data, comparing workpapers, Excel formula compatibility and API costs. Price forecasts remain unverified; this small test does not establish trading returns or predictive reliability.
Trying OpenSquilla’s model router: task tiers, model switching and costs (opens in a new tab)
The author tests OpenSquilla on project exploration and documentation. Reported cost and quality results depend on the benchmark and model pool; monthly tier recommendations still need validation for each use case.
Xiaohongshu tests Dada, turning personal expertise into interactive agents (opens in a new tab)
A media hands-on report uses Xiaohongshu's Dada beta to build a cooking assistant, exploring knowledge bases, tools, widgets, group chats and paid services. The product is still in testing; access may change and the commercial outlook is the author's interpretation.
Kling Image 4.0 hands-on: 8K images, editing and sequential storyboards (opens in a new tab)
Zhidx tests Kling's image model on portraits, posters, text edits and sets of up to ten images. The report also records errors in dense text, excessive detail changes and some plastic-looking results. Output quality depends on the task and the individual generation.