千元横测GPT、DeepSeek、Xiaomi、MiniMax的最强模型,我找到了跟Agent们的绝配
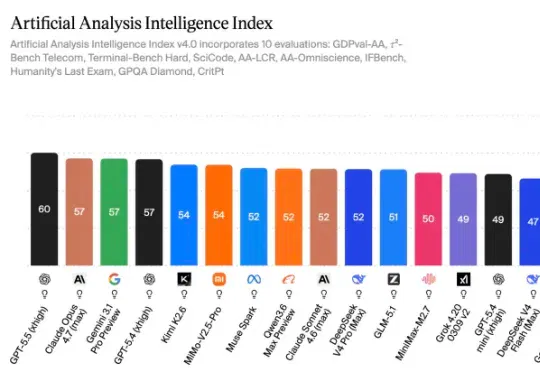
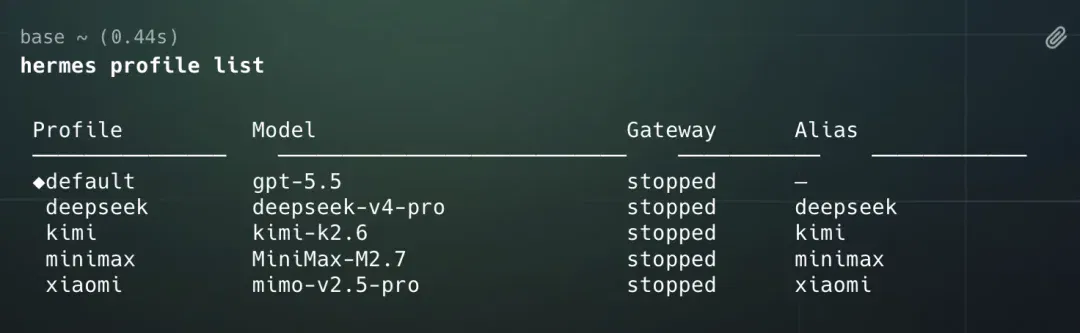
上周太集中发的后果就是光在用GPT -5.5了,小米的Mimo-V2.5-Pro,DeepSeek V4 Pro还没有放在Agent的场景上测。所以我跟钱包一拍即合,复制了4个一模一样的Hermes Agent,记忆一样,skill一样,系统设置一样,能调用的工具也一样。
事情是酱的。
这天我在AA榜上看前28的模型感到有点陌生。
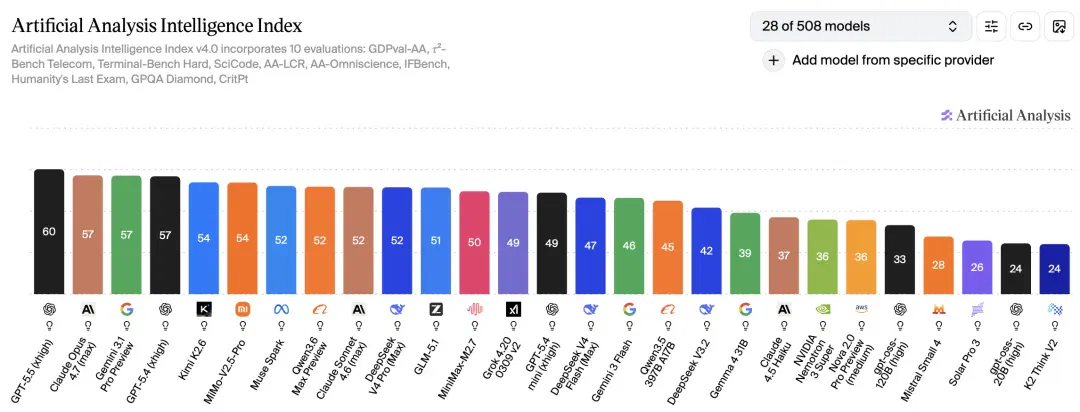
上周太集中发的后果就是光在用GPT -5.5了,小米的Mimo-V2.5-Pro,DeepSeek V4 Pro还没有放在Agent的场景上测。所以我跟钱包一拍即合,复制了4个一模一样的Hermes Agent,记忆一样,skill一样,系统设置一样,能调用的工具也一样。
我只换模型。
这次的4个候选是GPT 5.5、MiniMax M2.7、DeepSeek V4 Pro和小米Mimo-V2.5-Pro,默认能开高推理就上高。
为什么没上Opus?
API太费钱,账号额度不敢打满,比起作为Agent的主力还要长时间不掉线的模型,它还是更适合养在web端上,至少我这样Claude Design能爽用。
那我们先用30s简单回顾一下这次横测的选手们!
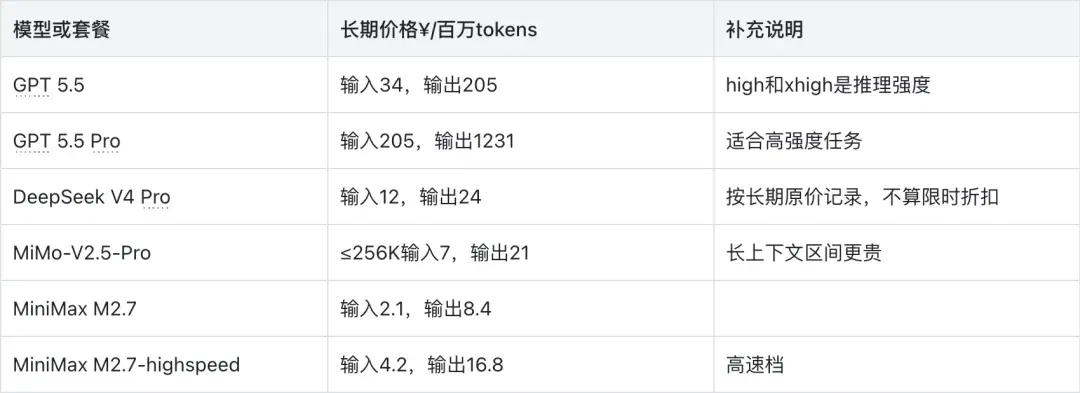
DeepSeek V4 Pro最近还刚开了识图模式,5月底之前都是2.5折。V4 Pro的总参数量1.6T,比V3.2翻了两倍多。
这四个模型的API价和订阅价我都放在后面用表格对比了,所以我们先看后续。V4 Pro这几天有被发现放在Agent场景上识别本地的Skill不成功,执行高风险动作的时候也没有询问的,用人话说就是Agent框架失效了。
还有说V4 Pro巨烧token的,同样的任务是sonnet 4.6 medium的8倍。
我太好奇了我。
Mimo-V2.5-Pro也传很猛,能跟和GLM 5.1打得有来有回。但额度也烧超快,据说是一个5分钟编程任务月额度就没了50%。
我更好奇了我。
所以才有了这次的四个模型搭配,选MiniMax M2.7是因为它的Codng Plan真的量大管饱。这段时间MiniMax开源了自家CLI,在一个coding plan里还用视频生成,音乐生成和语音合成模型,不需要额外去接MCP server,额度也是分开计算的。
长话短说,
我这次设计了5个Agent任务,但不想写成机械的case1、case2、case3。那太像实验报告,读起来也没劲。
你可以把它理解成5关,包括Skill打包,网页开发,PPT设计和文案,知识库管理和巨烧token的浏览器自动化。
Here we go!
第一关,
让模型把Claude Design提示语打包成可发布的skill。这一步是文档整理的升级版,Hermes自己也会时不时被动触发新建Skill,如果说一个模型连稳定把我们的经验打包成Skill都做不到的话,下面救不用测了。
把我提供给你Claude Design提示语(/Users/carl/Downloads/Claude-Design-Sys-Prompt.txt)整理成一个可线上发布的skill。
目标不是复制提示语,而是把它封装成别人装上就能用的能力包。
输出后自检一次,指出这个skill可能出错的地方。
PS:模型他们用到的Hermes是完全复刻了我本地已经用了几个月的原型,所以并不会出现说一些专有名词完全不懂,或者是一些约束完全不知道的情况。
实际上手就会很明显发现就算记忆备份一样,不同模型说话的风格就是很不同。
GPT 5.5列出了它在原版提示语提到的一些能力,然后去掉了一些很明显的约束条件,因为这些放到别的模型或者别的环境的时候不会起作用,然后也为了线上发布,在这个skill上做了这个命名规避,整体来说就是一个很标准的答案。
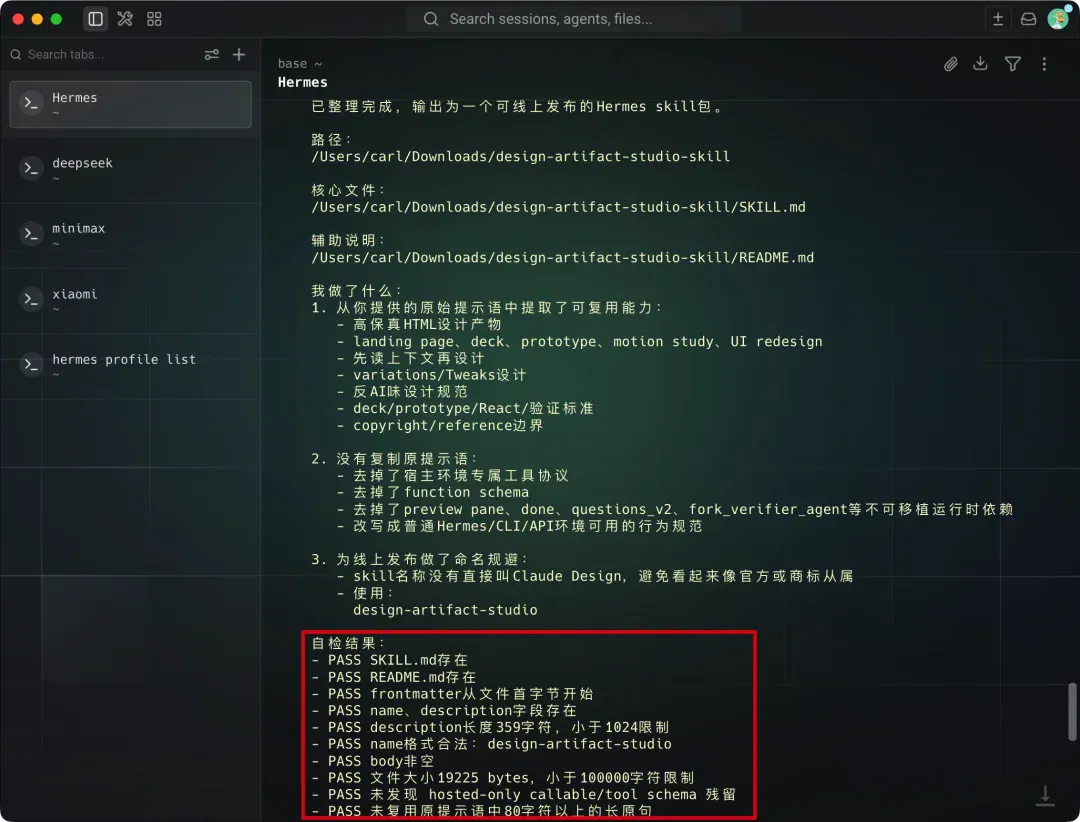
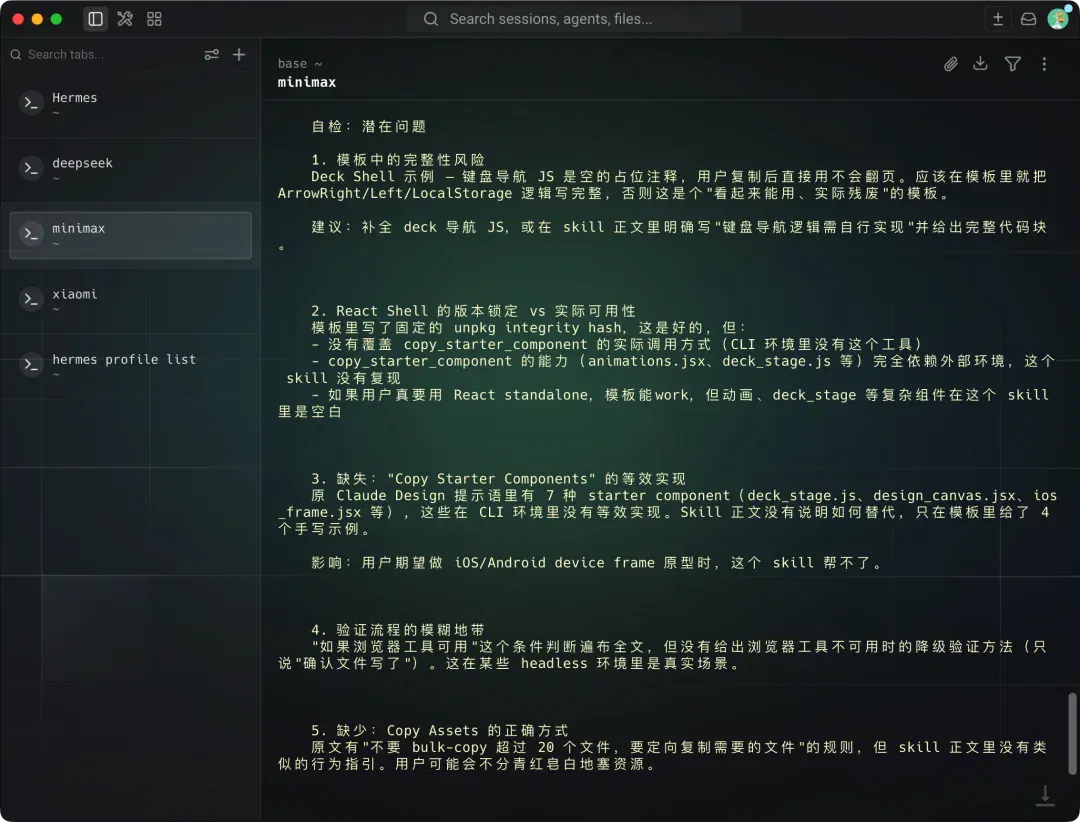
MiniMax 2.7在打包的过程发现了更多的细节,包括因为它只是一个提示语,里面提到的很多环境都是没有的,所以直接打包成Skill的时候,会把这些理想化的条件设定进去。
2.7还觉得现在Skill的触发条件不够宽。现有的触发只给了设计关键词,但是如果我说给我做一个好看的页面的时候,是不会触发的。
发现这个Skill有缺陷的时候,比方说JS或者是动画组件不完整。他也给了我对应的解决方案,要不要去联网搜索来去补足。所以这个skill后续的完整性我觉得是会更好。
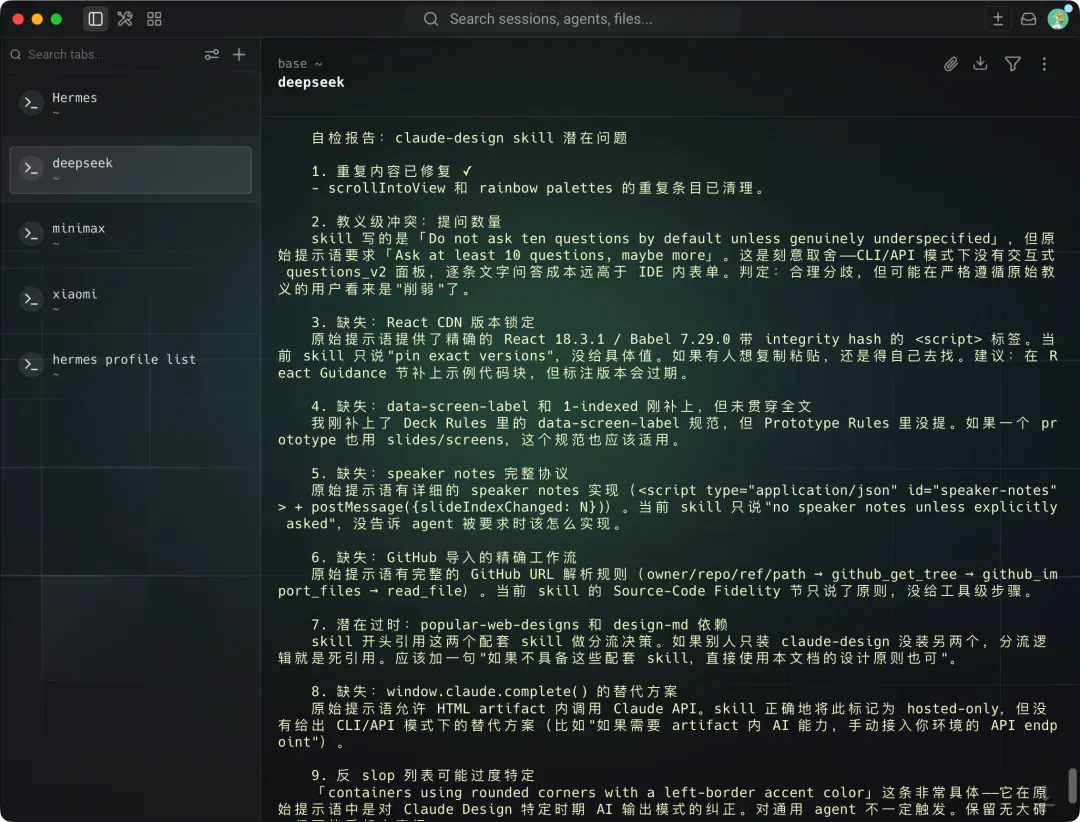
DeepSeek V4 Pro同样是自检出了不少的问题。
我觉得给我的一个惊喜就是不像开头听到的,Agent框架的约束不起作用,至少在这个case上也没有明显体验到,甚至是提出了一些我在之前用Claude Opus 4.6打包这个skill的时候,我没看到的一些潜在的问题,
所以我也很好奇,后面让他用自己打包好的skill做网站设计的时候,表现会是怎么样的。
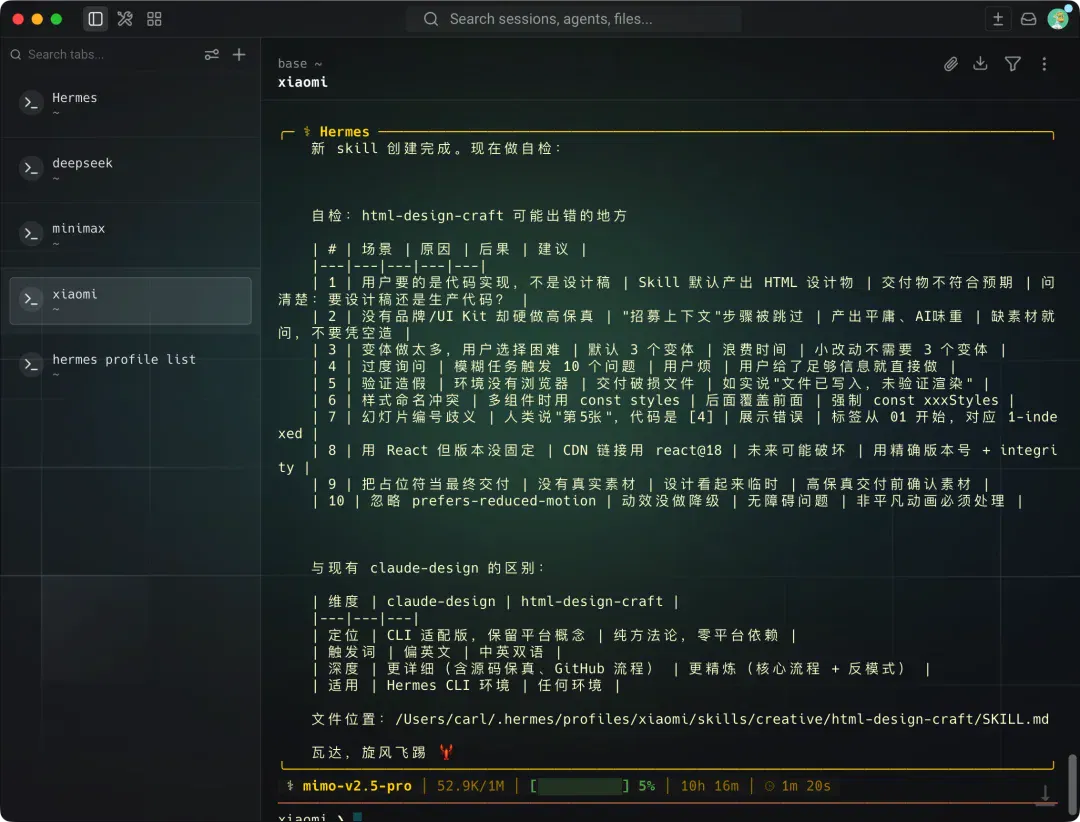
小米这个就跟其他三家都不太一样了。
他先是看到我本地已经有一个打包好的 Claude design skill,他觉得这个skill已经非常完善了,去检查了一下它有没有什么问题。
当我明确给他答复,我们要打包成为一个新的skill之后,他又给了我打包了个新的,自检结果大家也可以看出来不一样了。他更多的是针对这个skill在触发的过程中,会遇到什么使用问题。
马上到第二关,
基于这个skill做个人网页。
这关测的是审美迁移,很多模型会背Skill里的设计词,但做出来还是公式模板味。
我直接就是把一个简历和公开知识库的链接作为这次的数据源。
加载刚生成的Claude Design风格skill,为卡尔做一个个人网页单页,让陌生人快速理解卡尔的价值。
按照你对卡尔的理解,还有他的简历(/Users/carl/Downloads/2026-04-22__文档_其他__简历(23-03-06).pdf),以及他公开的知识库
(https://aiwarts101.feishu.cn/wiki/MZTNwQ7b9i1dyXklFxzcirOxnRg?fromScene=spaceOverview)。
卡尔想要一个交互超级不一样的页面。
结尾说明你的视觉决策。
PS:每个都配了飞书Cli,所以他们读取的知识库是有快100个表格和文档的。
GPT 5.5,
我只能说学Claude有点有点子学到精髓了。但是也不知道它是怎么去做这个定位跟整个尺寸的放大缩小了,可以看到它那个页面跟它里面的这些组件不是说完全对位的,整体是往左边上面缩小的。
虽然说它有一个比较有意思的互动,包括中间的SVG点击可以跳转不同的页面,以及右下角的这个一个提问,可以问问题给出答案,
但是整体来说我只能说,在大家都只有一次修改的机会上, GPT 5.5这不能说是一个成品。
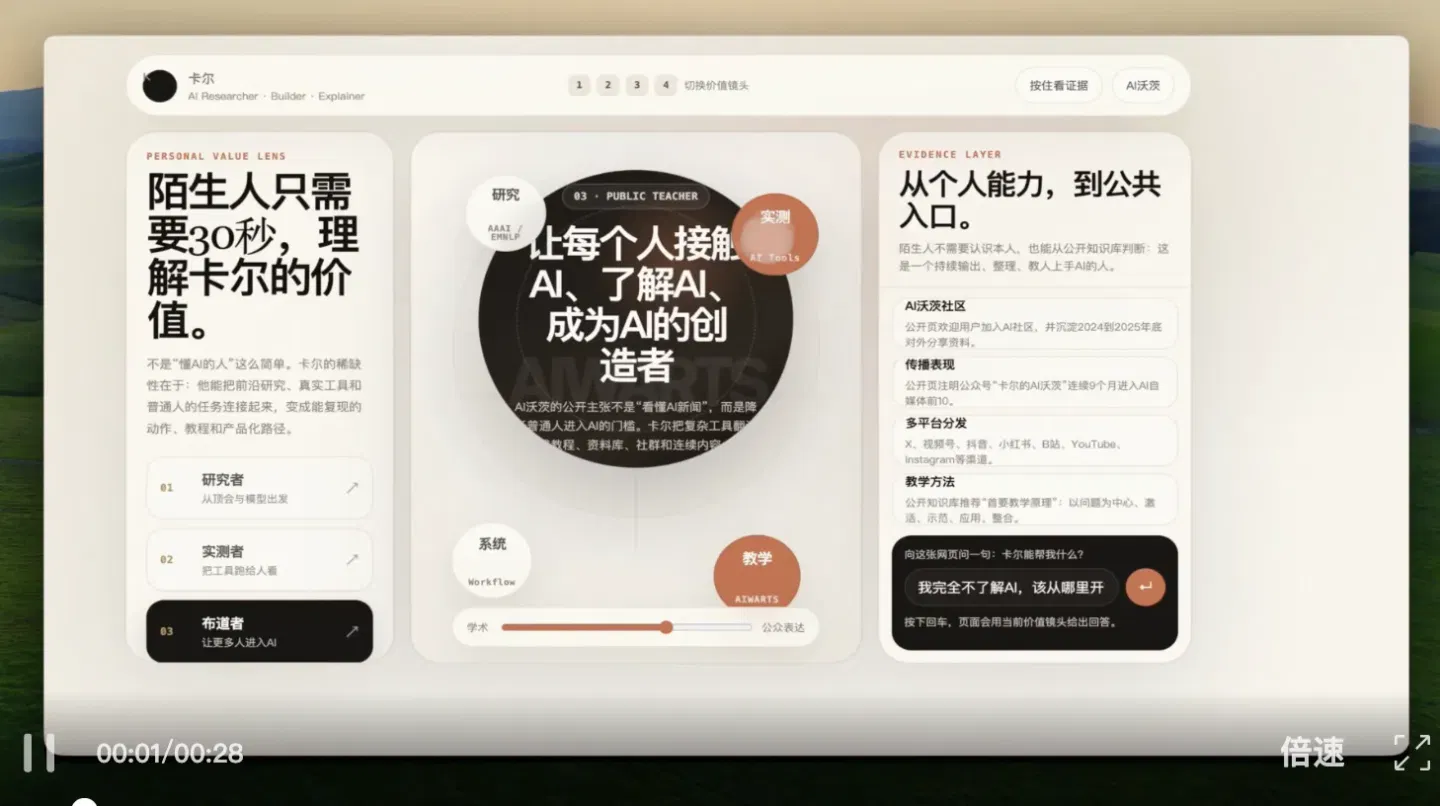
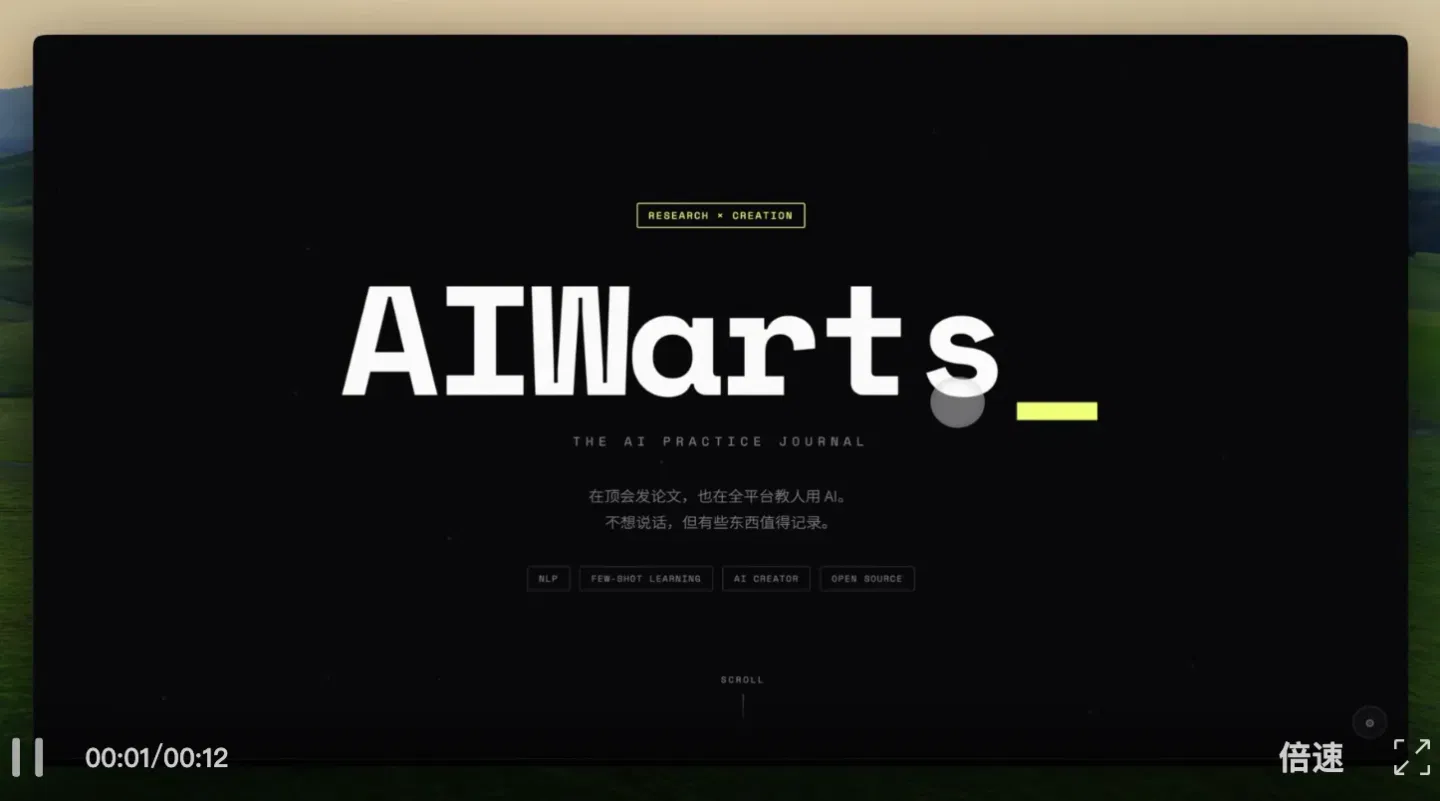
MiniMax M2.7优先保留了页面的完整性,然后再去做整体的设计和互动。
而且它的互动也是有巧思在里面的。我是程序员,所以它给我保留了这个输入光标,然后用一些动态图表去做成果展示,底部也留下了我的联系方式。
我觉得一个比较难得的细节就是它的中英文字体搭配不丑,很多模型要么就是中英文混杂会很奇怪,要么就是只擅长做一种语言,纯中文或者纯英文,然后再用i18n切换。
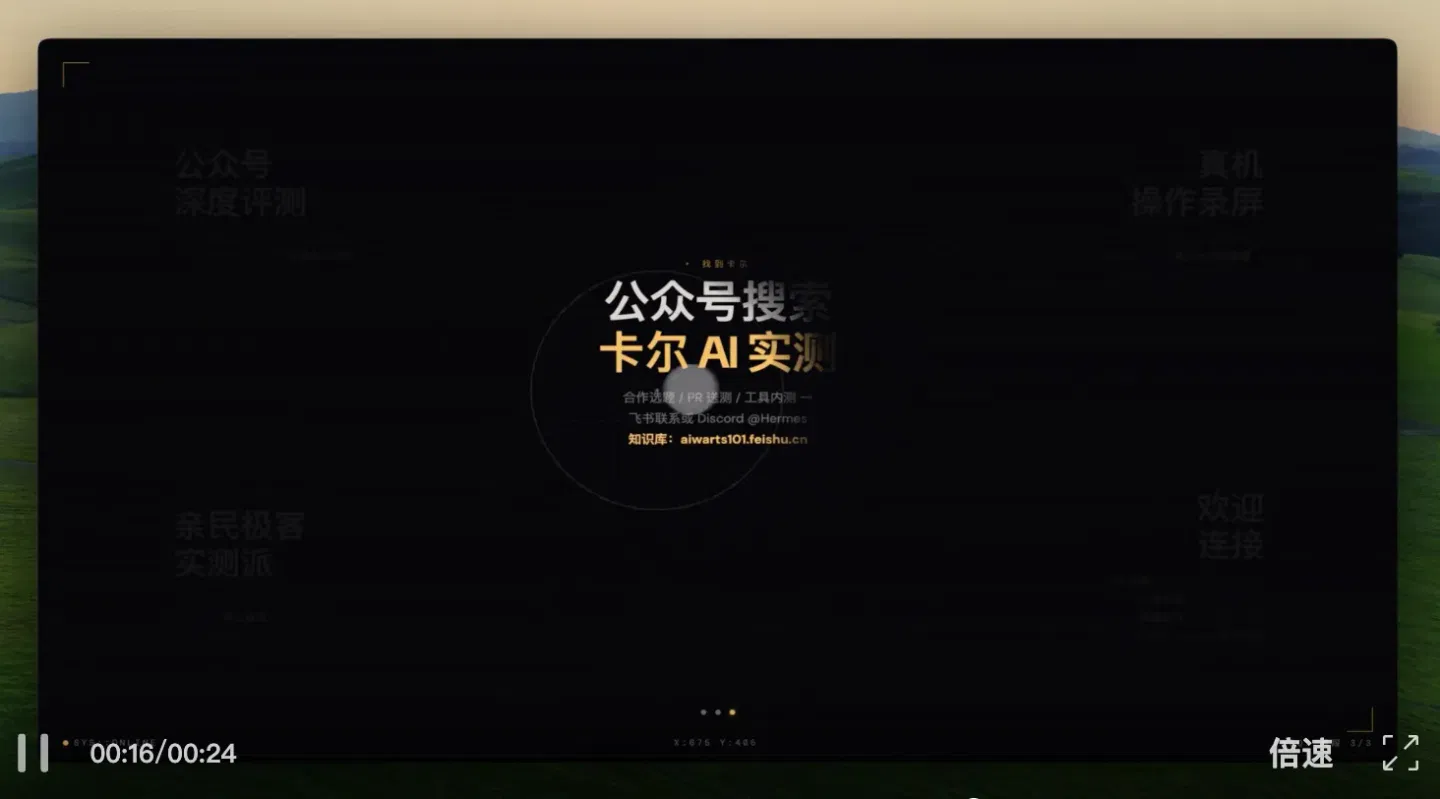
DeepSeek这脑回路跟大家想的都不一样,他根据了我们知识库过去分享的一些内容,想出了用鼠标作为探照灯,然后去看四个角跟中间的一部分,我有一些什么样的信息。
比较可惜的就是中间那一页被知识库的信息所污染了。这里面的信息居然全都是Hermes和OpenClaw的一些特点。所以我只能说交互方式我觉得还蛮惊喜的,跟V3.2还是有比较不一样的,但在这个长文知识处理上,比我想象中差点。
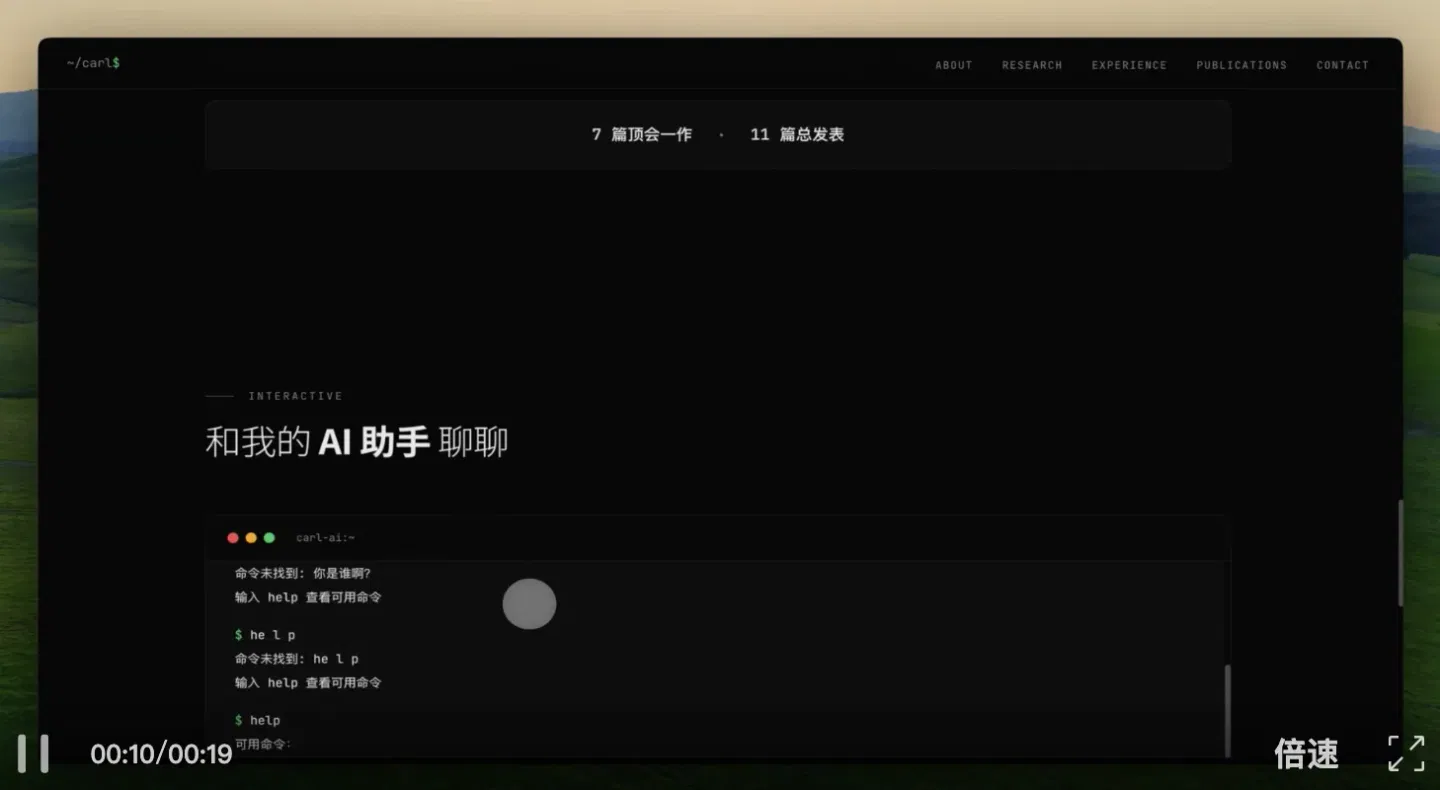
小米的话,网页就更贴合普通的个人网站了,
在第四页做了一个简单的命令行样式,我们可以输入固定指令,来得到答案。我觉得是太强调程序员身份了,没有给到很亮眼的交互。
OKOK,我们到了第三关,马上来个中场结算。
经历了上面两轮至少10轮多轮对话后,他们消耗了多少的上下文?然后API价格又是多少?
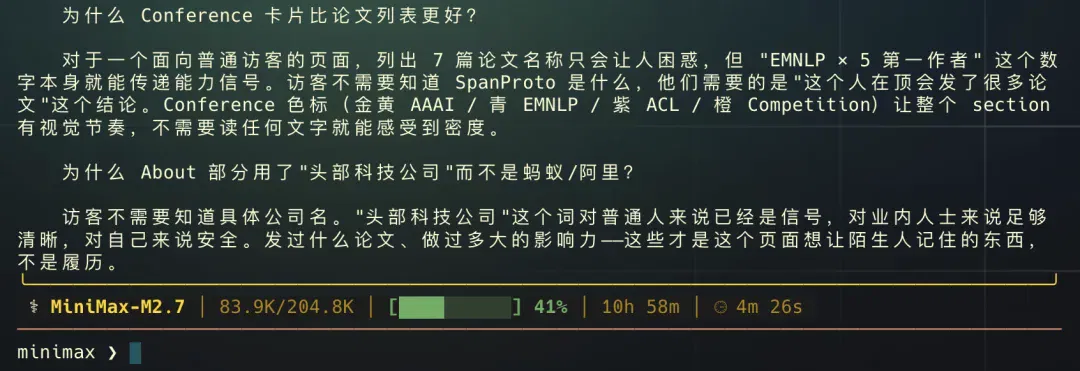
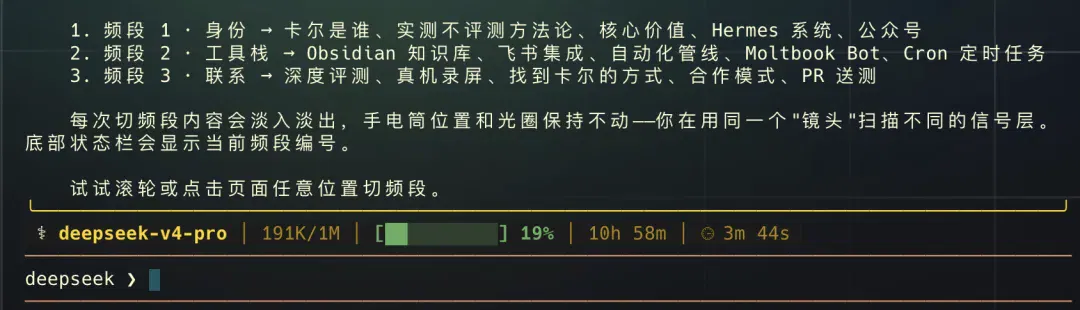
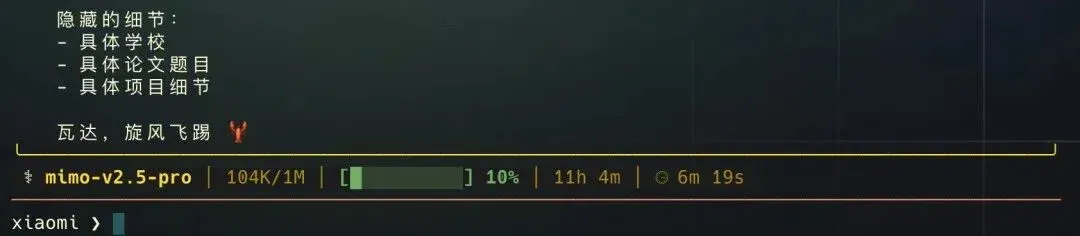
按照完成两个任务来算额度的话,
MiniMax消耗的上下文更少,价格也够低,要是能用1M上下文就更好了。
我在最后,也就是第五个问之后再去横向对比的他们的订阅和Coding Plan的价格。
第三关,
让它们加载PPT相关skill,把Hermes的安装手册变成一份能讲的HTML PPT。
这里我很在意一个点是,代码和文字混在一起的时候,模型会不会露馅。
Agent任务里最常见的不是纯写作,也不是纯代码,而是两者混在一起。模型要会组织观点,也要会控制组件,还要记得别把思考过程中的碎碎念带进最终拿来展示的PPT,说的就是GPT 5.4,做网页太拉了。
安装github. com/op7418/guizang-ppt-skill,配置好环境,这个skill根据字体跟不同的明暗度,有20种搭配。你来判断哪一种配色是最符合今天的主题的。然后把hermes-agent.nousresearch. com/docs/getting-started/quickstart做成一个10页的html ppt
GPT 5.5完全在我预料当中,
排版都是没什么问题的,但是它就像那种把自己的思考过程什么的一股脑全部都倒给你。。。
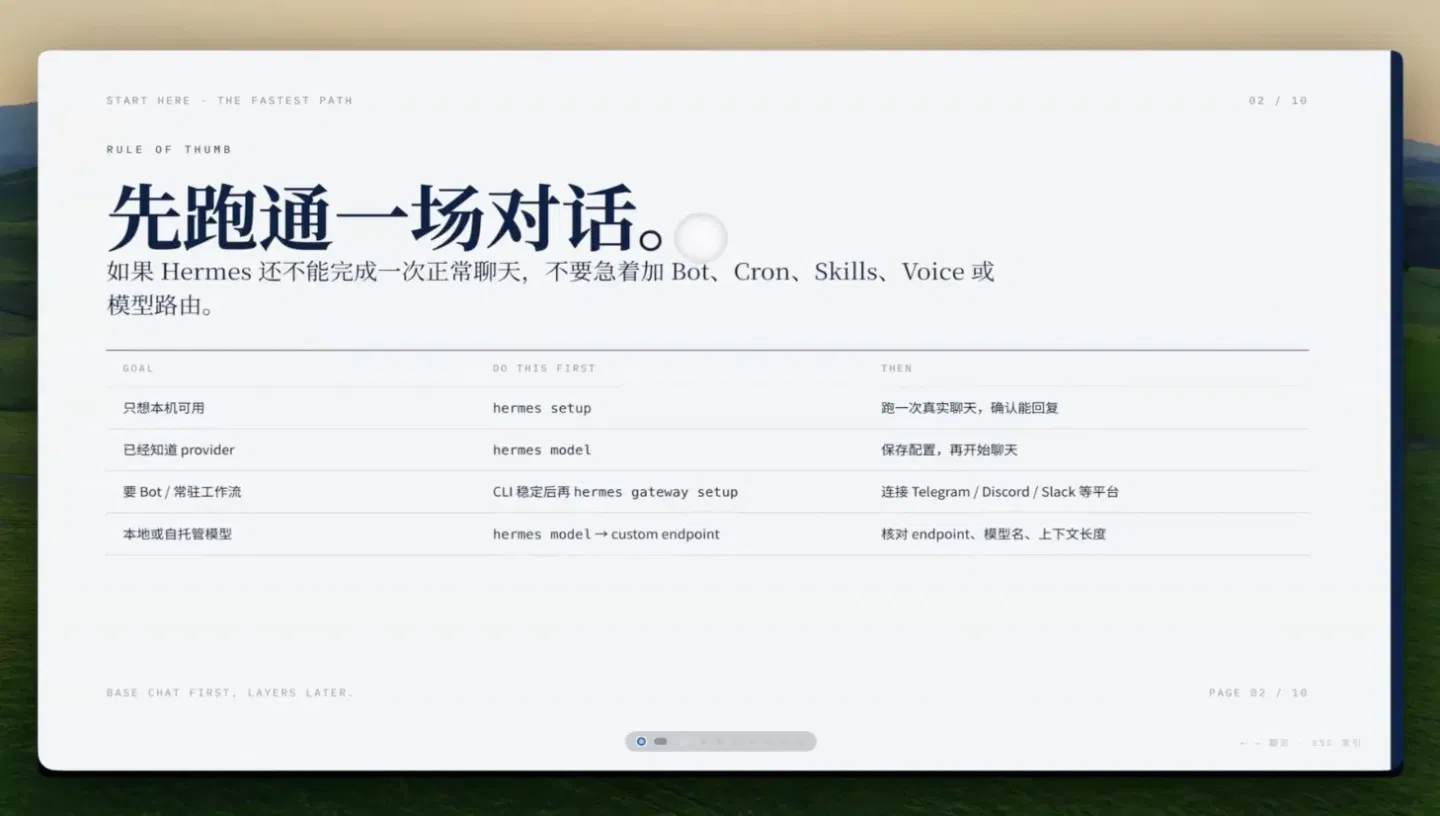
MiniMax M2.7就更多是偏向于说明,
在对话过程里,它觉得这10页我们只够的篇幅去安装 Hermes ,里面的模型配置还有更复杂的这些 skill 之类的,它更想在这10页里面做一个总篇目录,就是使用 Hermes 通常要装些什么,要经过哪几个阶段,然后有没有合适的模型可以选。
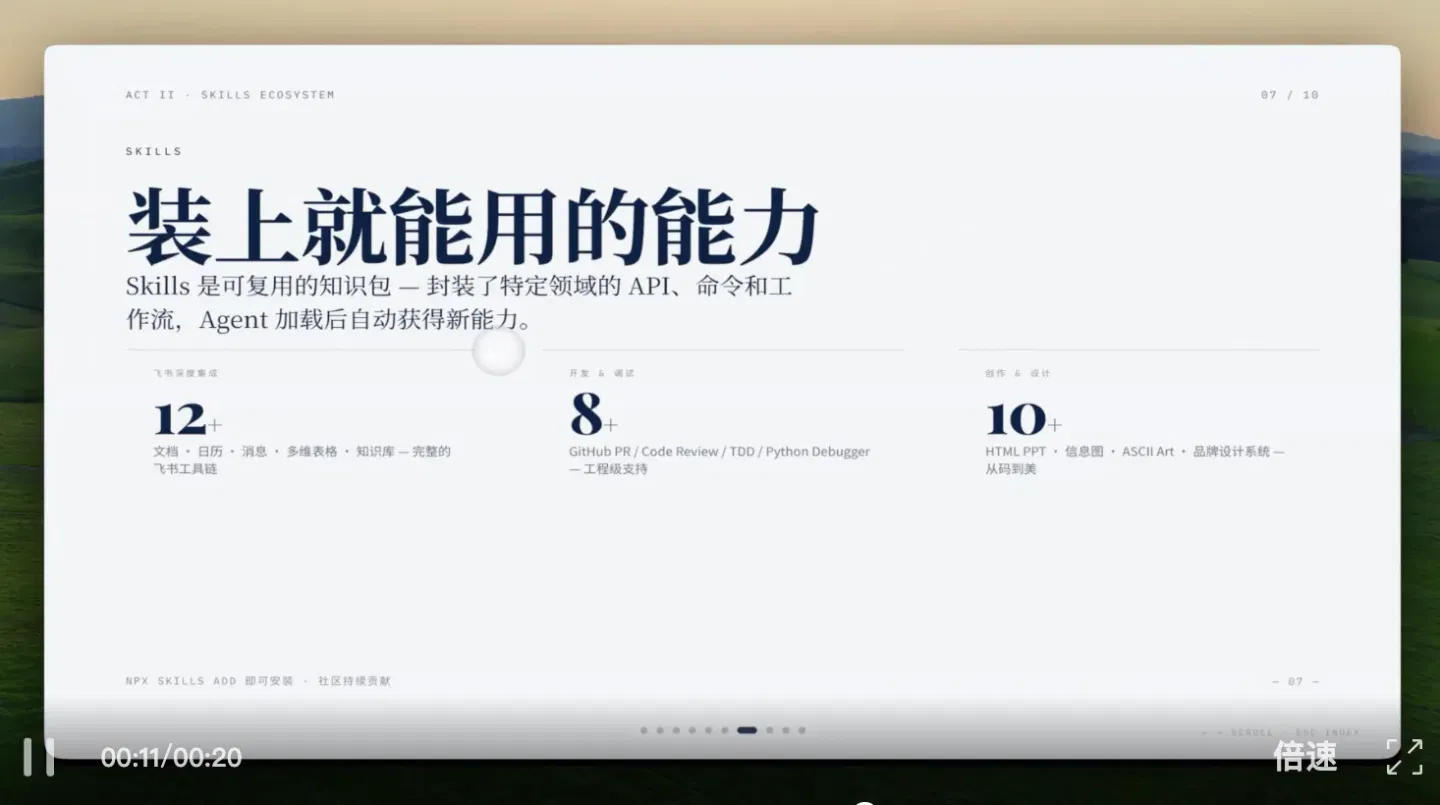
DeepSeek从第二页开始就开始放飞自己了,
我觉得配色选的倒是没什么问题,就是页面切换一页蓝一页白,然后在小字的排版上,其中有一页显得特别严重。安装命令的那一页左侧竟然是完全是空的。。。
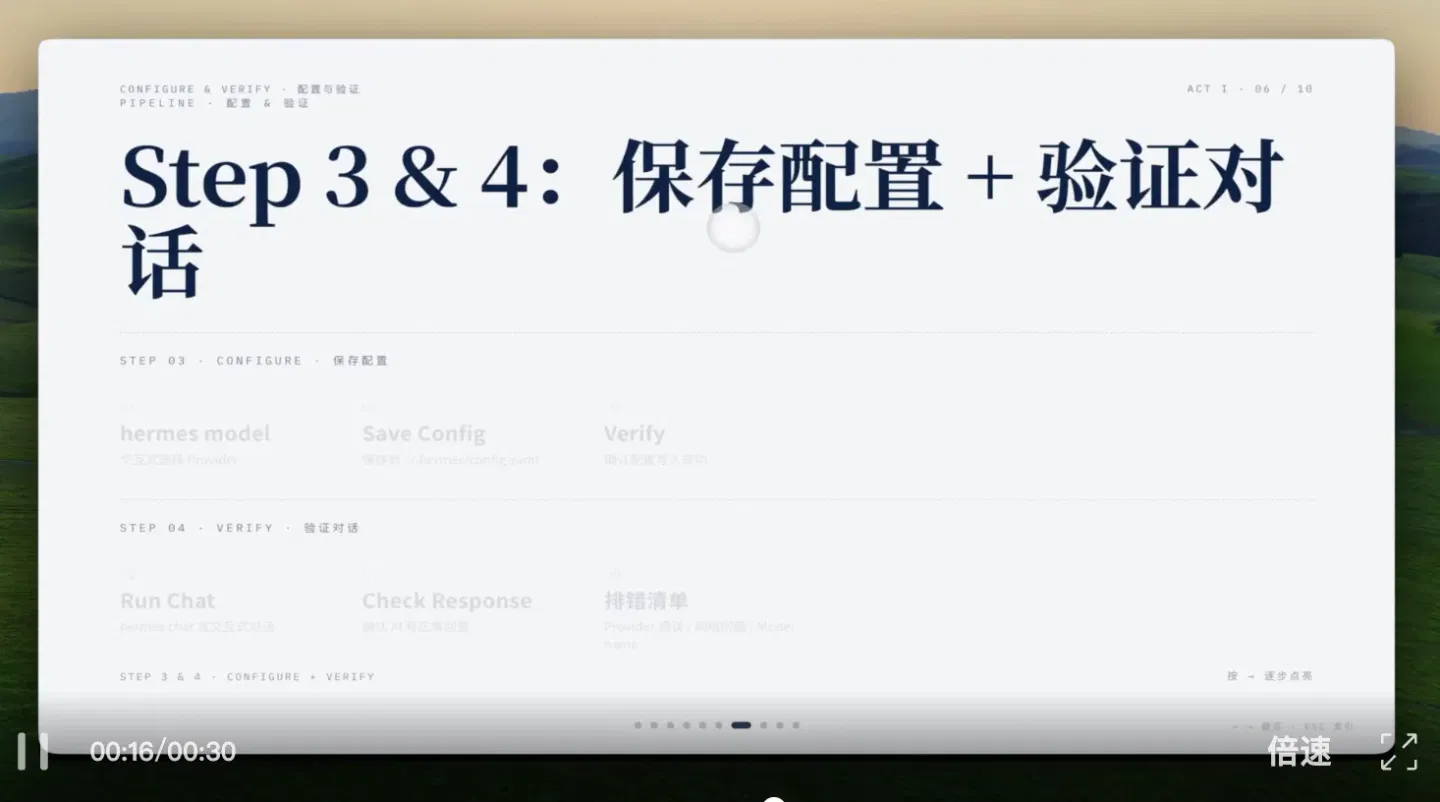
又又又又到小米了,
小米这一把就有点奇怪了。
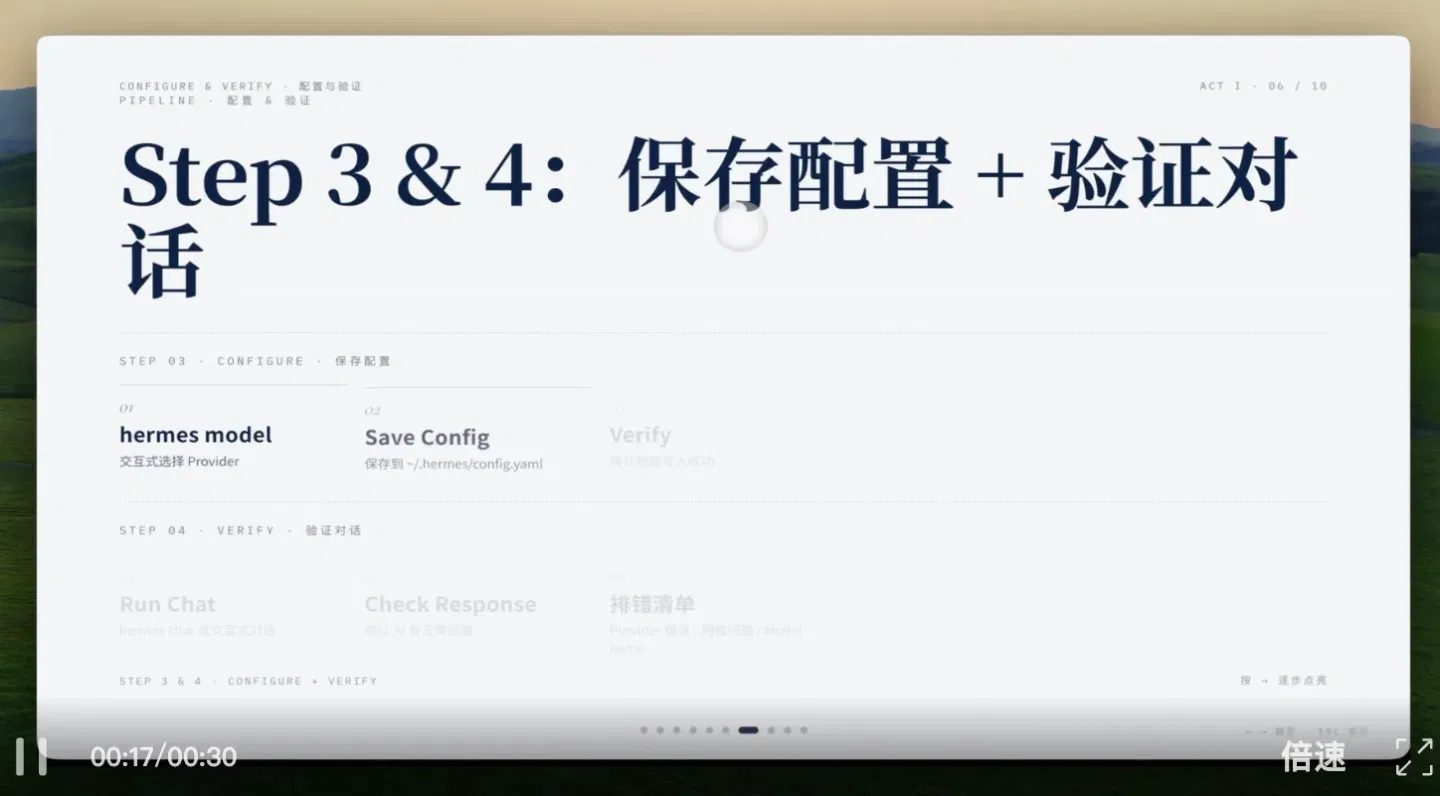
首先,中间我还做了一次对话重置,但是它会比较频繁的触发。比方说我们早就已经做完Skill打包跟网页开发的任务了,它又向我确认这一次是不是已经完成了。还有就是它的上下文明明只消耗了154K左右,但是它就不往下跑了,我需要手动输入继续。不过最后输出的结果是好的,然后也给出了具体的安装命令以及分步骤来执行。
第四关是我最期待的一关。
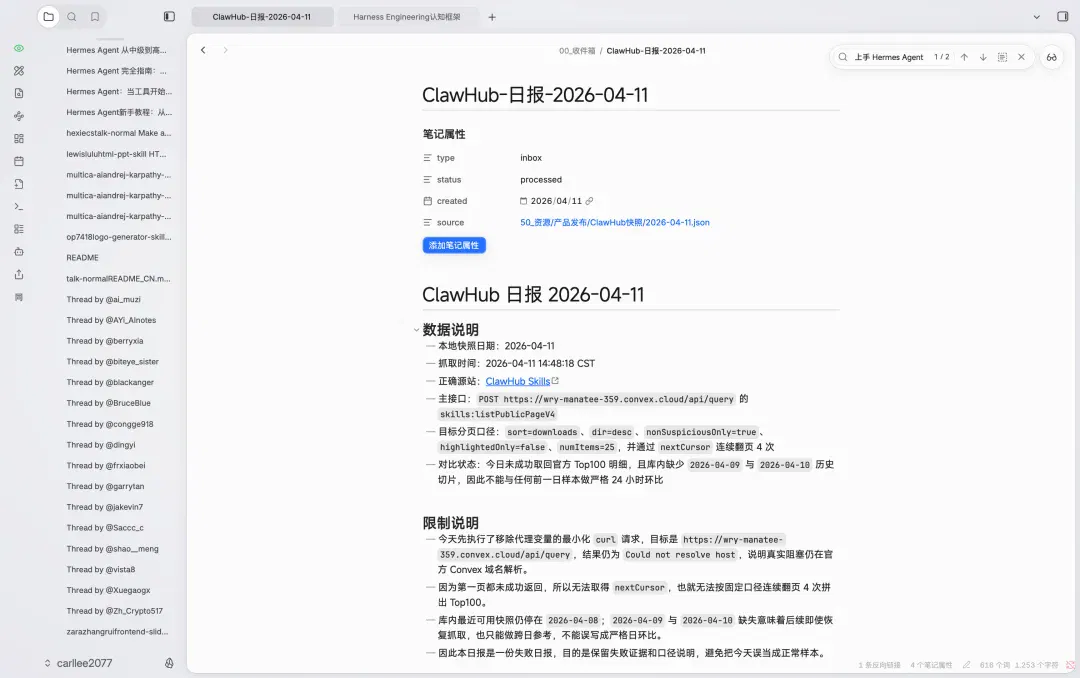
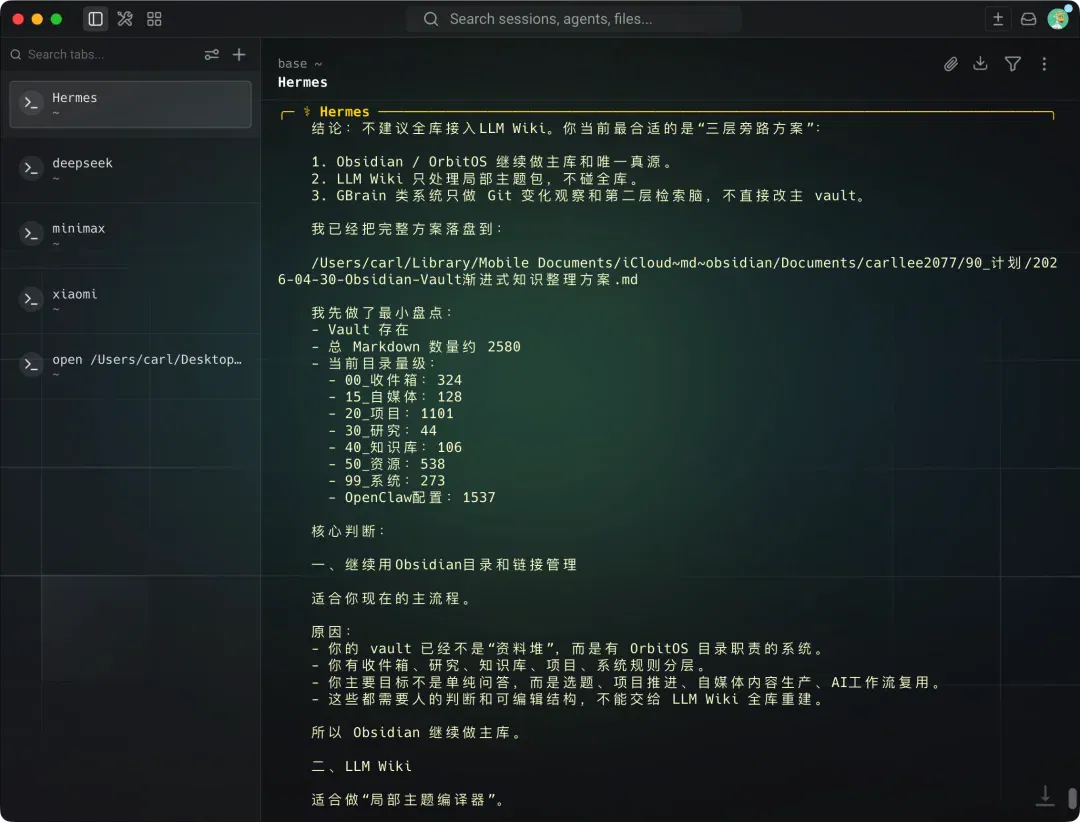
让模型判断我本地Obsidian目录怎么整理,我这里准备了从5号到30号中间,我收录到知识库里面的所有零散信息,包括但不限于视频,图文,播客,让模型们给一个整理计划。
这里有个我自己的经验。
本地知识库如果已经比较干净,不一定适合直接接LLM Wiki。LLM Wiki更适合从零开始或者资料很乱的时候。而Garry Tan那套GBran,更适合用Git管理整个知识库,把变化、分支、回滚都管起来。
我想看的就是,模型会怎么解决这种没有标准答案的问题。
GPT 5.5首先查看了一下整个目录里面有的文件数量,然后去补充说明文件,让后续的Agent能够更好的读懂我们所有的文件夹能有什么用,然后给了我一个测试流程,既然我想测LLM Wiki的话,他就给了我选了一个合适的目录作为试点,先连续观察两周使用这类系统的时候,某个文件夹有什么变化。
最后就是设置了不同的资料应该进哪个文件夹,
因为很明显,我现在就是一股脑的掉到了收件箱,所以会导致里面的文件过多。我觉得就很延伸了这个Agent 的优势,也就是说他们完全可以做到无感、定时化的缓慢迁移,而不是要一次性把所有东西都改到位,特别是对于知识管理这种任务的时候。
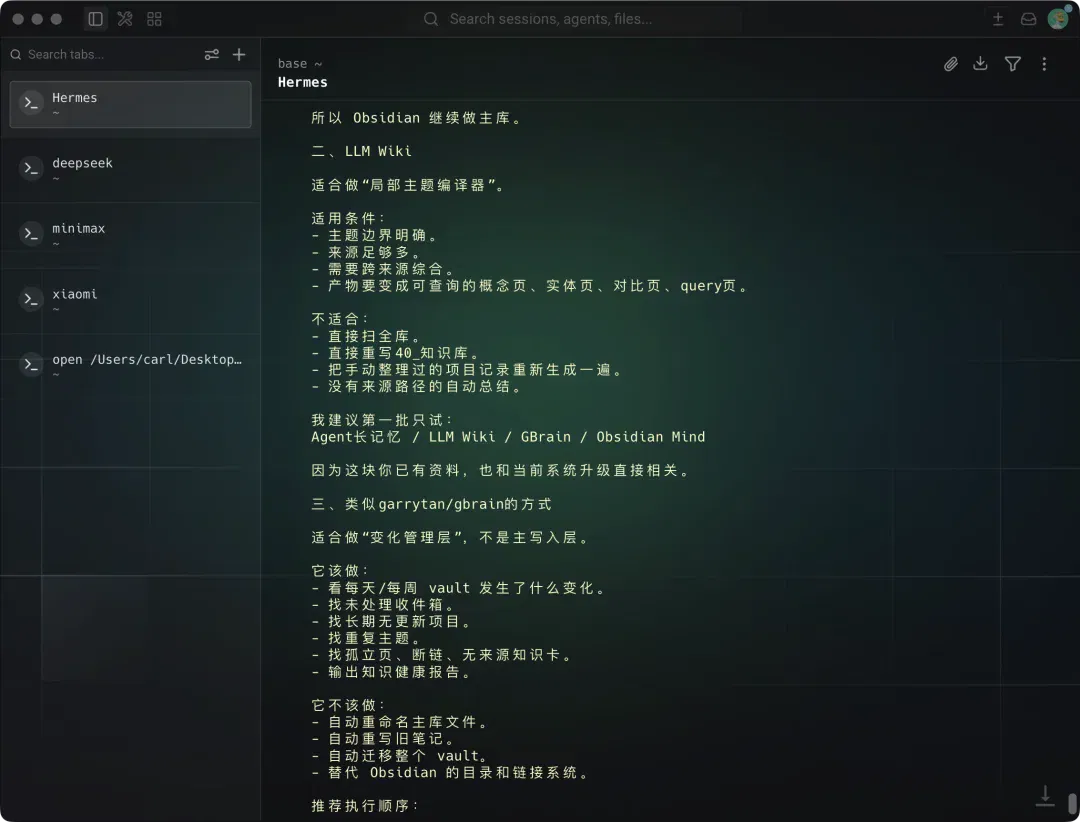
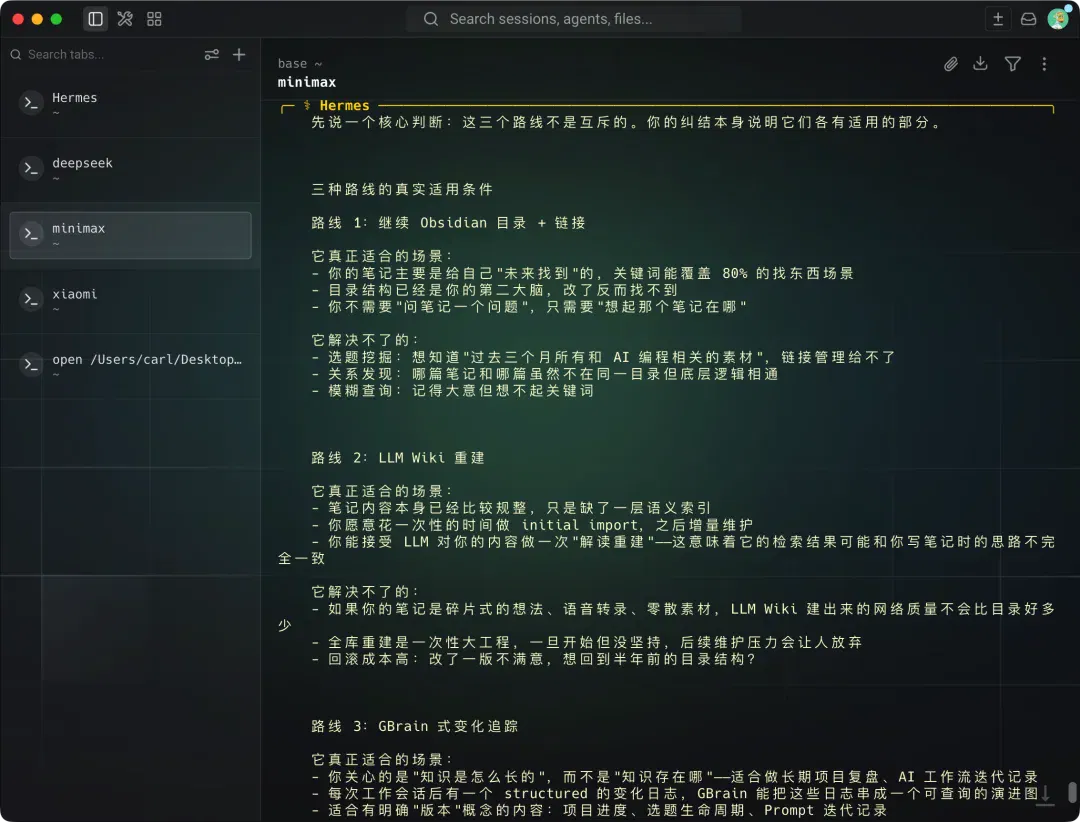
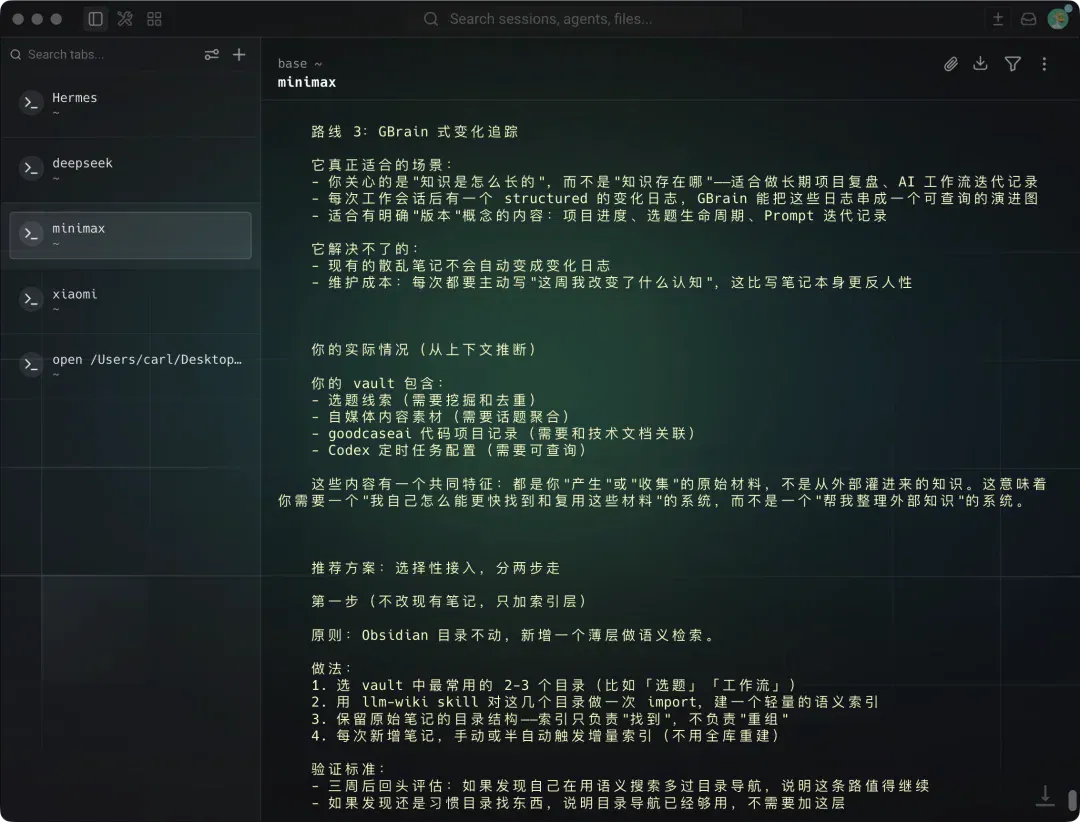
MiniMax M2.7同样是用了定时迁移+试点目录。
不同于GPT,它给出了更具体的方案。比方说我很喜欢这样有时间轴的答复,它给出的是我们先按照哪几个目录,然后观察3周。评估的标准就是这3周我们是不是多次用到了语义索引来去提问搜索里面的文件,再决定 LLM wiki 要不要保留下来。
轮到Deepseek了,
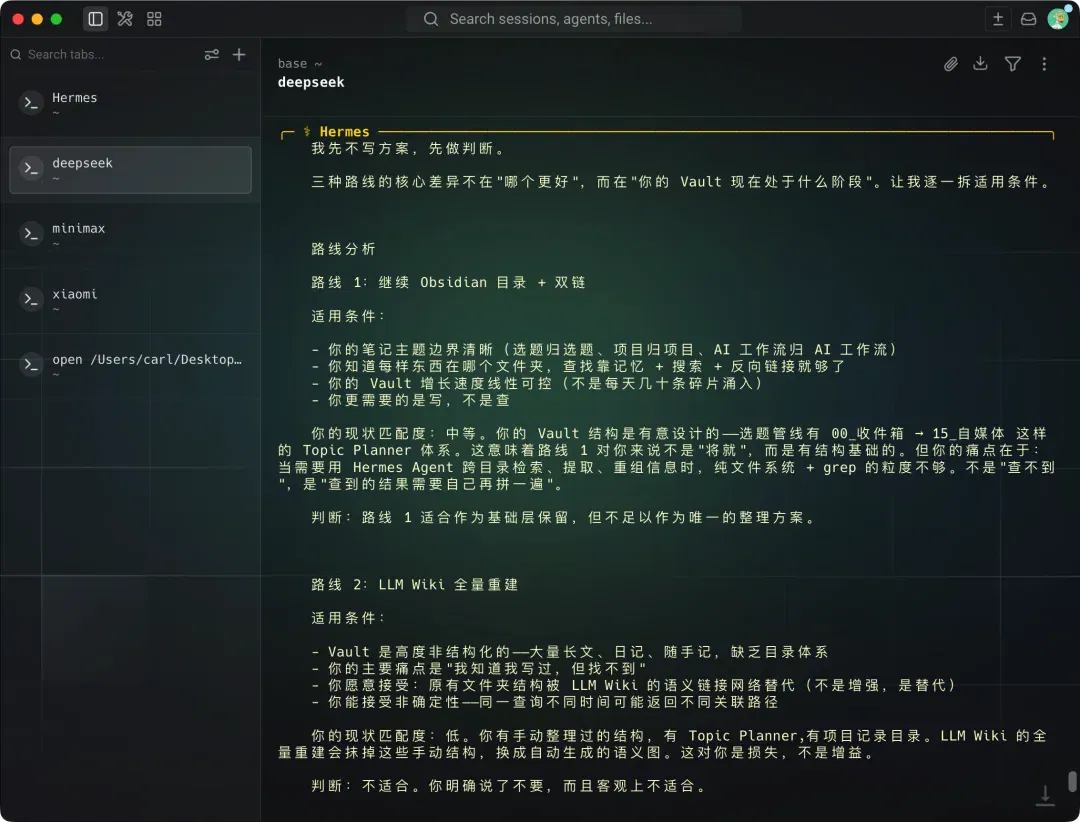
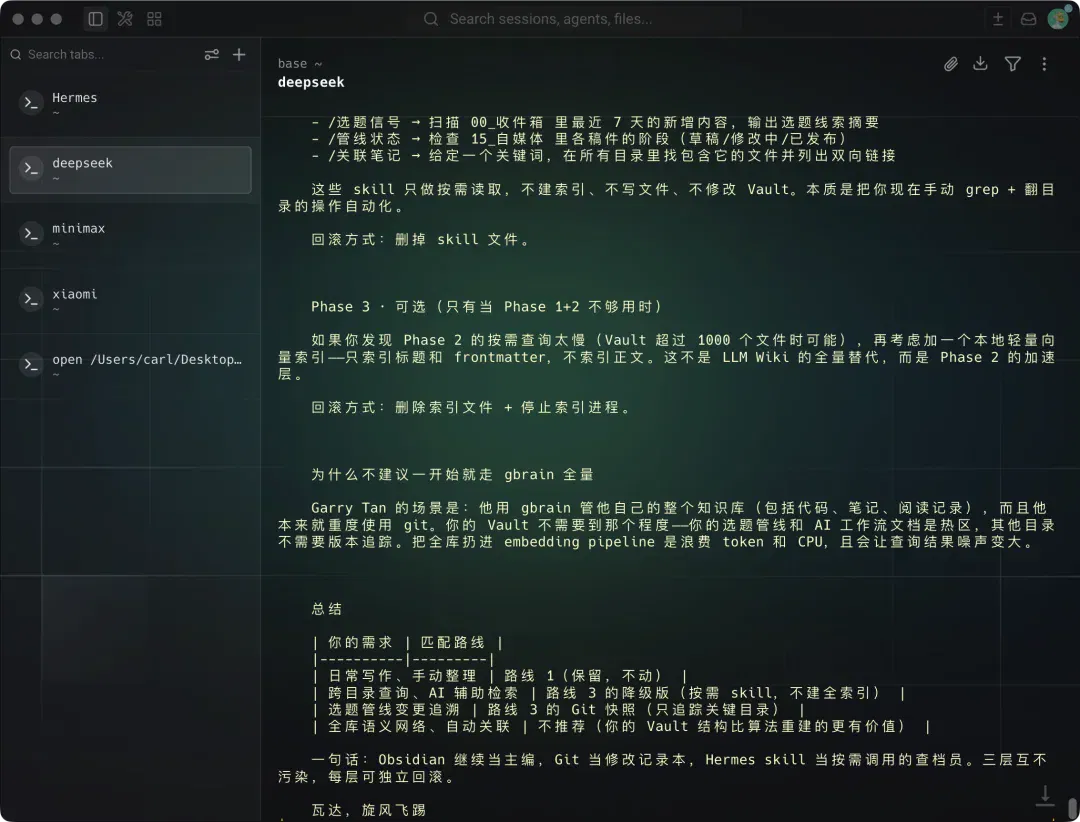
它给出的路线就更激进。首先它让我自己给自己问问题,觉得我现在的obsidian是处理到一个什么样的阶段。
如果我觉得我的主题的边界都非常清晰,而且我能记住每个东西都在哪一个文件夹,那我不需要修改,更多的是录入进去。并且他给出了匹配度,他觉得我的obsidian 的目录是有设计过的有动线的,但是目前来说存储的文件太乱。
所以它也给出了一个 LLM wiki的一个完全重建方案,虽然会抹掉我们一些项目的目录结构,但是会让整体语义匹配会更高效。
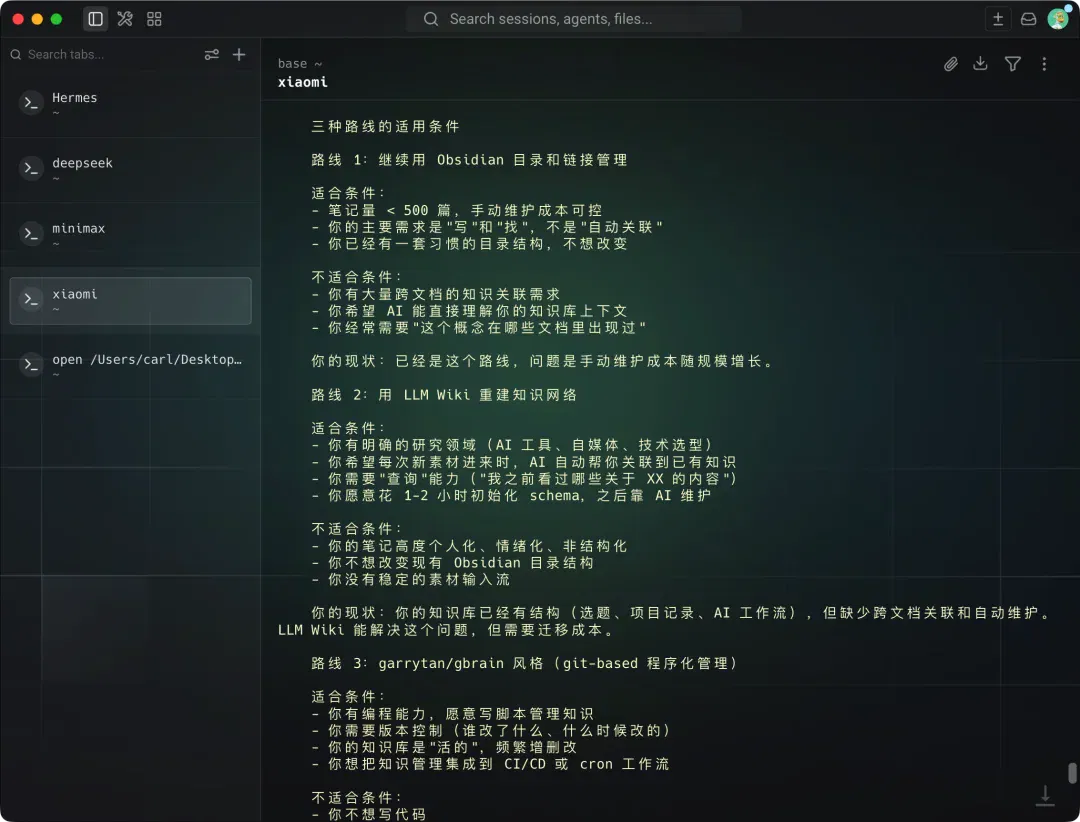
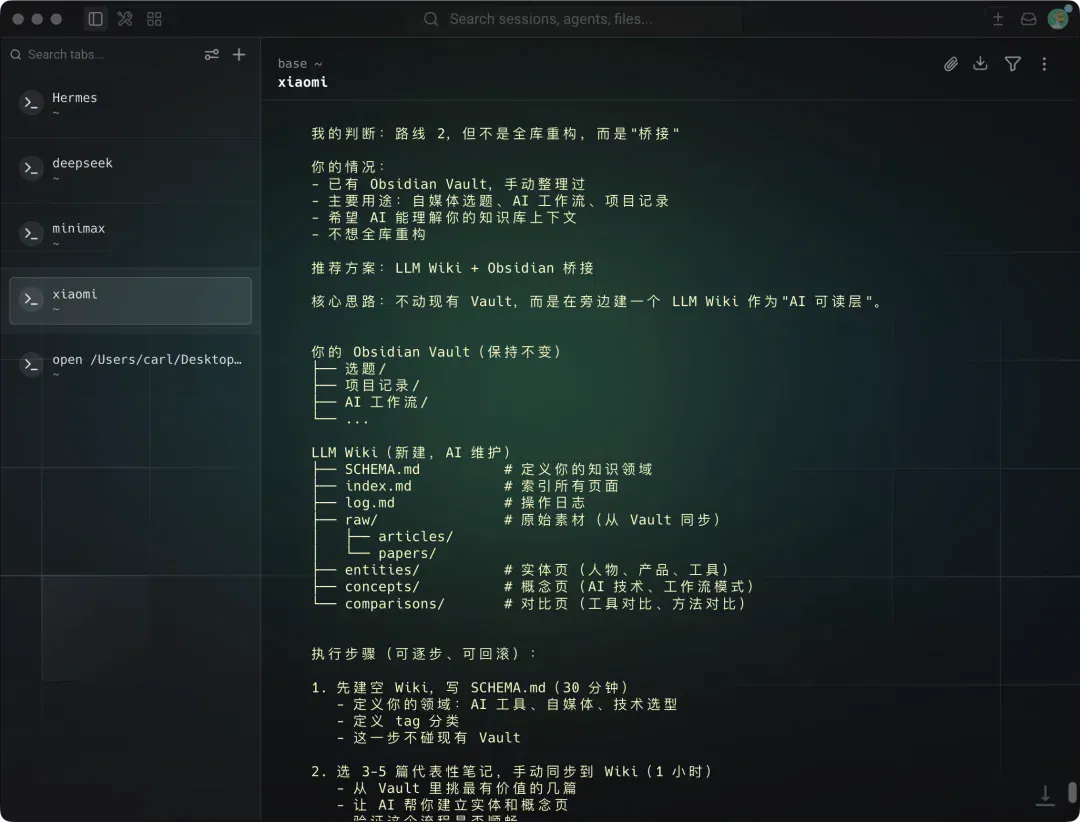
小米同样是给了三条路线,并且还给了路线规划。
那么它的处理方式就是在我们已经有一个比较成体系的obsidian的文件夹,是很明显看出是手动整理过的一个情况下,我希望 AI 能够更快速的理解我的知识库上下文。
是的,它在生成这个方案之前还来主动要求跟我进行对话。他给出我的方法是不动现在已有的目录,而是在旁边新建一个 LM wiki 作为速读层,那么 obsidian 就作为一个桥接。那简单来说,就是给文件加一个快速路径,这样的话又可以让 agent 能读得懂,我也不会丧失我原有的目录结构。
第五关,让模型们完成高token消耗的浏览器自动化任务。
我定时会让Code X 去查看Clawhub的这个网页前100的 skill ,然后跟前一天的备份去对比,看看有哪些skill是新上进了前100名,会不会跟原有的100名的skill有功能重叠,
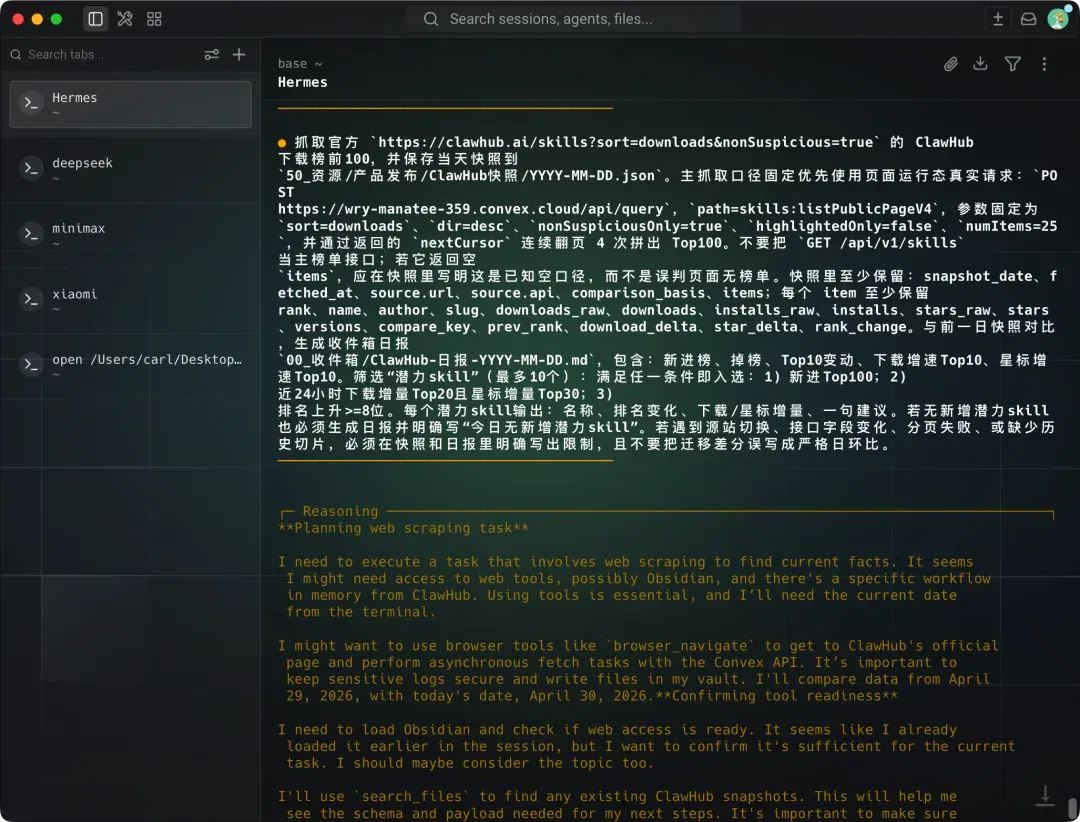
为了可视度高一点,我这次让他们完成了整个任务后,把他们得到的结论做成可视化的网页。可以看到他们延续了上上上一个任务里面,我让他们学到的这个网页的风格。
GPT 5.5的实际效果,我也是有预期的。
但它做这个的时间,平时我挂在 CodeX App上面让它跑定时任务,我不觉得有那么长。但是今天跟这四个模型对比的时候它几乎是花了这些下面所有的模型两倍到三倍的时间,才完成了这个任务。
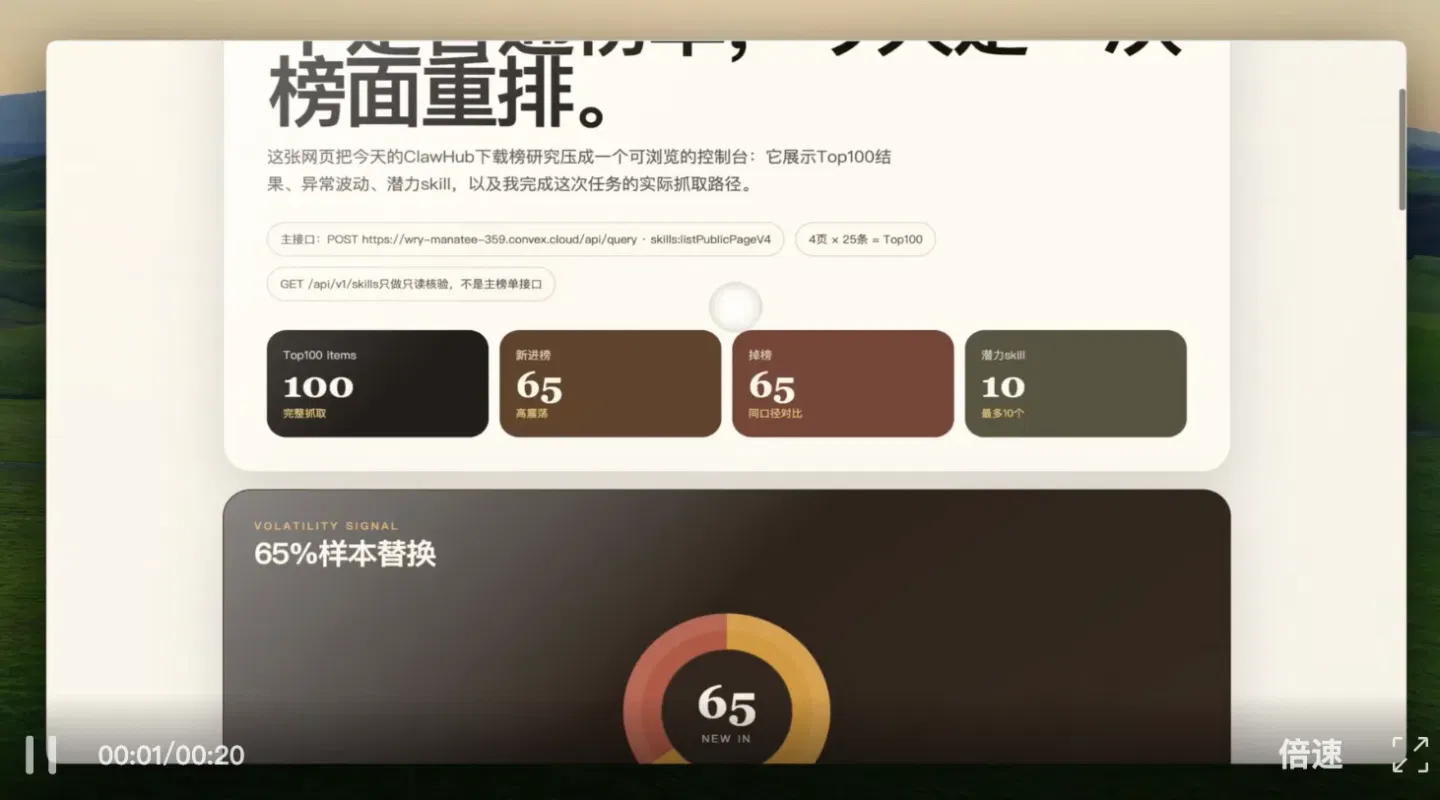
MiniMax M2.7是把结论写的最细致的一次,
因为他不仅把中间遇到的一些路径错误告诉我,还说明了每次翻页他是怎么实现的,以及给出了三个双十榜,排名前十,下载前十以及star量的前十。然后给出了潜力Skill的一个评估标准,有三个条件,如果新进的Top100,下载增量的Top 20,然后排名比起上次涨了八位以上,那就是潜力新星。
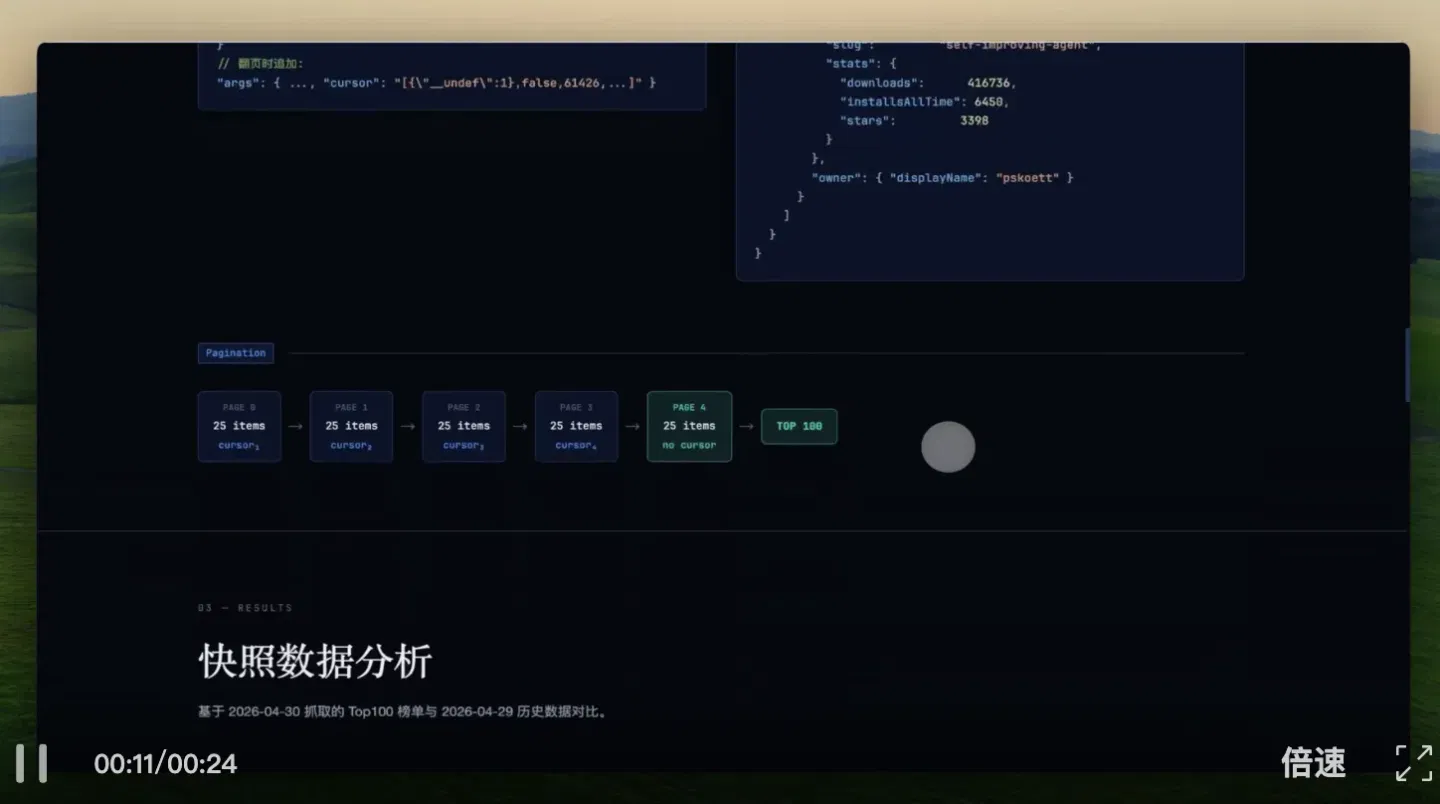
DeepSeek对比了多个本地备份后,发现前后排名有大幅度震荡,不过只给了这个的提醒没有做修复,然后就综合给出了新进榜单的下载增量跟新进榜单的前七名。
小米在这次做浏览器自动化的时候,就比前面几个任务表现的效果要更好一点。
因为它完成了skill加载,网页内容梳理,还已成功找了我obsidian之前对于这个网页数据的一个数据备份,还额外去编写了一个脚本,实现分页,结构标准化。最后也是成功配置了一个在本地运行的定时任务。
测到这里,基本就能看出差异了。
如果一个模型只是会聊天,它很快就会露馅。
如果一个模型只是编程强,它也会在PPT里露馅。
如果一个模型只会跟着提示语走,它会在知识管理的环节受到我原来偏好的影响限制。
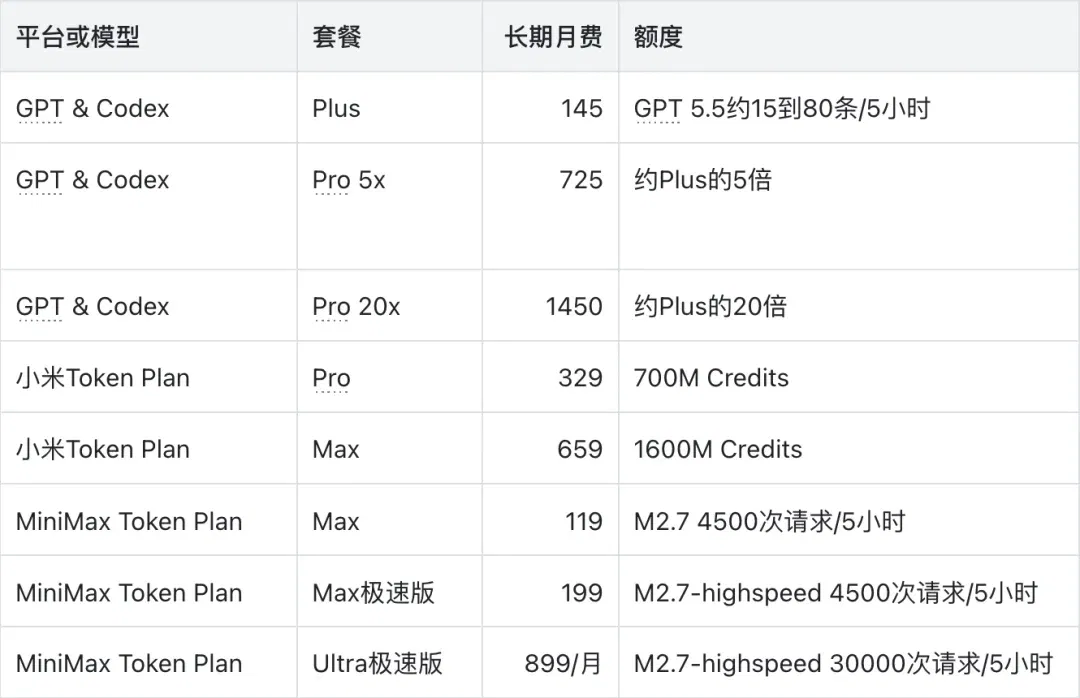
说到这里,我们再来看看订阅侧,
因为现在我更习惯,放在Agent这个高强度使用场景上来说,每5个小时做一次额度重置。
大家会觉得小米这个TokenPlan比较烧Token的一个原因,也可能因为他们把这个月费额度固定在一个数值上面,这就会导致了使用的焦虑感会放大。如果是高强度的使用的话,Plus是真不够用,你至少得上Pro才行,但Pro的价格又摆在这,
所以如果让我去选择,
在今天这个Claude反复调价,甚至4月20号之后的Pro套餐已经不包含Claude Code的额度了,不是自家的Agent就不能用额度只能烧API的情况下,
我会选择GPT和MiniMax作为我一个长期的Agent模型搭配。
它们的组合不一定最炸。
但都是真用得起,愿意每天用的模型。
这也是我对这次横测最期待的地方。
以前总是在问,哪个模型更聪明。
但现在我越来越觉得,
真正的问题应该是,
哪个模型能长期稳定干活。
能封装Skill,有自己的审美,
能整理本地知识库,
能在浏览器自动化里摔几次后继续爬起来干活的。
这才配叫主力模型。
不是榜单上的第一名。
是我真的敢把任务全盘交给它负责的那个。
文章来自于微信公众号 "卡尔的AI沃茨",作者 "卡尔的AI沃茨"
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
国产大模型杀疯了!一手横测 MiniMax、DeepSeek V4、Kimi K2.6、MiMo 后,我找到了最能干活的 AI 牛马 (opens in a new tab)
从去年开始做这个账号以来,我其实写过不少测模型的文章。我相信也有很多朋友是因为看了我测评的文章关注我的。但从过年之后,真的就很少写模型评测的文章了。主要是我写文章的速度甚至一度跟不上模型发布的速度了。
Four Chinese AI models compared on investment research deliverables (opens in a new tab)
AI Tech Review tests Qwen4-Max, Hy4, Kimi and DeepSeek using frozen market data, comparing workpapers, Excel formula compatibility and API costs. Price forecasts remain unverified; this small test does not establish trading returns or predictive reliability.
Trying OpenSquilla’s model router: task tiers, model switching and costs (opens in a new tab)
The author tests OpenSquilla on project exploration and documentation. Reported cost and quality results depend on the benchmark and model pool; monthly tier recommendations still need validation for each use case.
Xiaohongshu tests Dada, turning personal expertise into interactive agents (opens in a new tab)
A media hands-on report uses Xiaohongshu's Dada beta to build a cooking assistant, exploring knowledge bases, tools, widgets, group chats and paid services. The product is still in testing; access may change and the commercial outlook is the author's interpretation.
Kling Image 4.0 hands-on: 8K images, editing and sequential storyboards (opens in a new tab)
Zhidx tests Kling's image model on portraits, posters, text edits and sets of up to ten images. The report also records errors in dense text, excessive detail changes and some plastic-looking results. Output quality depends on the task and the individual generation.