TurboQuant团队学术不端?谷歌回应了,但争议更大了
一篇 AI 论文,能否同时引发学术争议与 900 亿美元市值震荡?
一篇 AI 论文,能否同时引发学术争议与 900 亿美元市值震荡?
上周末,我们报道了血洗内存股 900 亿刀的谷歌 AI 论文涉嫌学术不端(在新窗口打开)。指控的核心在于,TurboQuant 团队涉嫌隐瞒核心技术借鉴、错误贬低先行研究,并在实验中进行极度不公平的硬件对比。
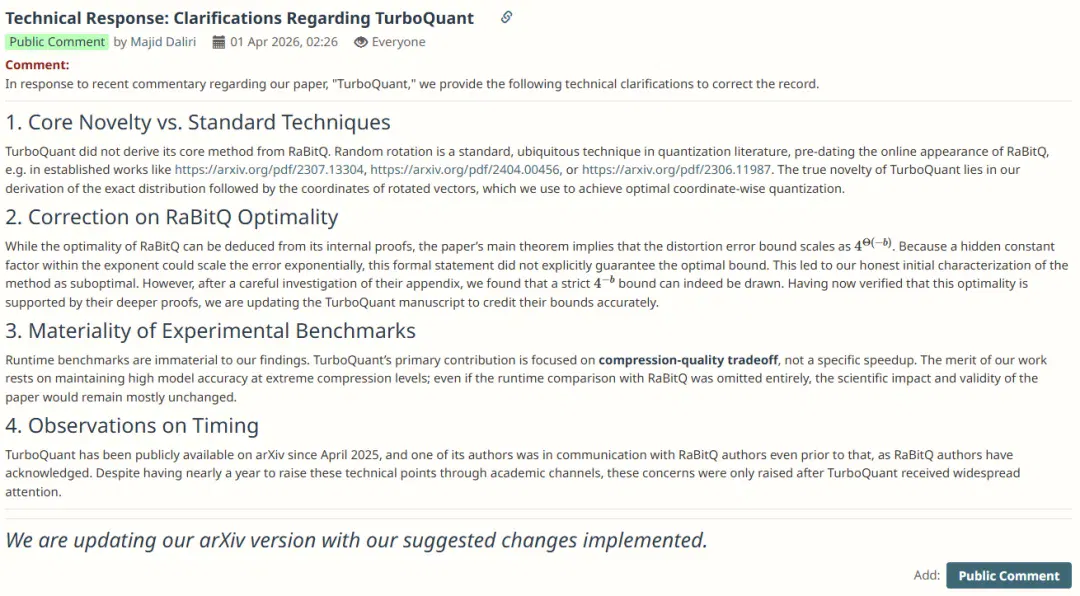
随着舆论发酵,TurboQuant 的作者团队在 OpenReview 平台上做出了公开回应,第二作者 Majid Daliri 发布了一份分为四点的「技术澄清」。
https://openreview.net/forum?id=tO3ASKZlok
具体回应内容如下:
1、核心创新 vs. 标准技术TurboQuant 并未将其核心方法建立在 RaBitQ 之上。Random rotation 是量化领域中一种标准且广泛使用的技术,其出现时间早于 RaBitQ 的公开发布,例如在一些已有工作中已经被采用,如https://arxiv.org/pdf/2307.13304、https://arxiv.org/pdf/2404.00456、https://arxiv.org/pdf/2306.11987。TurboQuant 的真正创新在于:我们推导出了旋转后向量各坐标所遵循的精确分布,并利用这一结果实现了最优的逐坐标量化。
2、关于 RaBitQ 最优性的修正尽管 RaBitQ 的最优性可以从其内部证明中推导出来,但论文的主定理表明其失真误差界按某种形式进行缩放。由于指数项中存在一个隐藏的常数因子,该因子可能导致误差呈指数级放大,因此该形式化表述并未显式保证最优界。这也是我们最初将该方法描述为次优的原因。
然而,在对其附录进行仔细分析后,我们发现实际上可以推出一个严格的误差界。既然这一最优性已经由其更深入的证明所支持,我们正在更新 TurboQuant 的论文手稿,以更准确地标注并致谢其理论界限。
3、实验基准的重要性运行时基准对于我们的研究结论而言并不关键。TurboQuant 的主要贡献集中在压缩率与模型质量之间的权衡,而非特定的加速效果。本工作的价值在于:在极高压缩率下仍能保持模型精度。即使完全移除与 RaBitQ 的运行时间对比,本论文的科学意义与有效性也基本不会受到影响。
4、关于时间节点的说明TurboQuant 自 2025 年 4 月起已在 arXiv 上公开发布,其作者之一在此之前就已与 RaBitQ 作者进行过沟通(这一点也已被 RaBitQ 作者承认)。尽管对方有将近一年的时间可以通过学术渠道提出这些技术问题,但相关质疑是在 TurboQuant 获得广泛关注之后才被提出。
然而,这份回应不仅没能平息争议,反而像是在火上浇油,引发了学术社区和开发者群体更强烈的反弹与吐槽。
- 把关键技术「降级」为行业常识
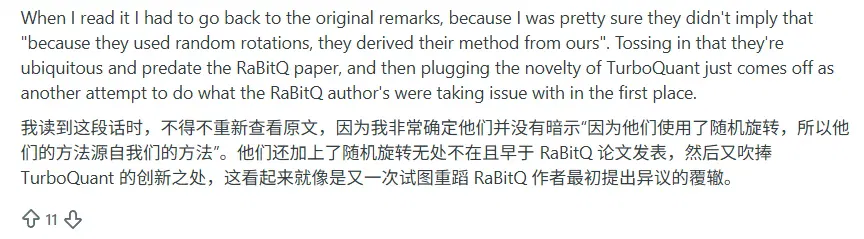
首先,针对「隐瞒核心技术相似性」的指控,即 TurboQuant 同样使用了 RaBitQ 论文中标志性的「随机旋转(Johnson-Lindenstrauss 变换)」作为第一阶段量化的核心,Daliri 的回应是:随机旋转在量化文献中是一项极其标准且无处不在的技术,早在 RaBitQ 出现之前就有了。他们强调,TurboQuant 的「真正创新」在于推导出了旋转向量坐标的具体分布(Beta 分布),并据此实现了最优的逐坐标量化。
这种说法在字面上没毛病,毕竟谁也不能给一个基础数学变换申请专利。但同行们吐槽的点在于,把别人在相同特定场景(向量量化)下率先组合使用的核心步骤轻描淡写地归结为「行业标配」,然后将顺理成章的分布推导包装成自己的「核心创新」,多少显得有些不够厚道。
- 核心理论评价,建立在「没看清附录」之上
其次,关于「错误贬低 RaBitQ 理论结果」的问题。TurboQuant 曾在正文中将 RaBitQ 的理论保证定性为「次优」和「分析粗糙」。面对原作者的对质,Daliri 倒是坦率地认了错。他解释说,因为 RaBitQ 论文主定理的指数中隐藏了一个常数因子,导致他们最初认为这会产生指数级误差,所以给出了「客观的次优评价」。但在仔细研究了对方的附录后,他们发现 RaBitQ 确实达到了严格的最优界限,并承诺会在最终版手稿中更正。
虽然态度诚恳,但这段回应依然让人感到一点荒谬。一篇被谷歌官方博客数千万次曝光的 ICLR 顶会论文,其对同行竞品的核心评价,竟然是因为「没仔细看附录」而得出的草率结论。更何况,RaBitQ 团队早在近一年前的邮件沟通中就已经指出了这个理论误读,而 TurboQuant 团队硬是拖到事情在社交媒体上闹大、影响了纳斯达克指数之后,才「恍然大悟」地表示要修改。
- 最具争议的,是「硬件对比」这一环
第三点回应则彻底点燃了社区的情绪。RaBitQ 团队指控 TurboQuant 在对比运行速度时,用自己的 NVIDIA A100 GPU 去碾压被限制在单核 CPU 且关闭多线程的 RaBitQ Python 翻译版代码(这段 Python 代码甚至还是 TurboQuant 作者自己写完找原作者帮忙 debug 的)。面对如此实锤的「田忌赛马」式跑分造假,Daliri 的回应令人叹为观止:他表示「运行时基准测试对我们的研究结果无关紧要」。
按照 TurboQuant 团队的逻辑,他们的主要贡献在于压缩质量的权衡,而不是具体的加速比,因此就算把和 RaBitQ 的速度对比全删了,也不影响论文的科学价值。评论区质疑如果不重要,当初又何必处心积虑地搞出一套不对等的硬件测试,并把「速度碾压对手」的结论堂而皇之地写进论文里呢?
最后,Daliri 还在回应中抱怨了原作者的「发难时机」,声称 TurboQuant 从 2025 年 4 月就在 arXiv 上公开了,RaBitQ 作者明明有一年的时间通过学术渠道沟通,却偏偏等到论文获得广泛关注后才出来指责。这不仅完全无视了 RaBitQ 团队提供的「2025 年 5 月私下沟通邮件记录」,还隐隐流露出一股「你就是想蹭我热度」的幽怨。
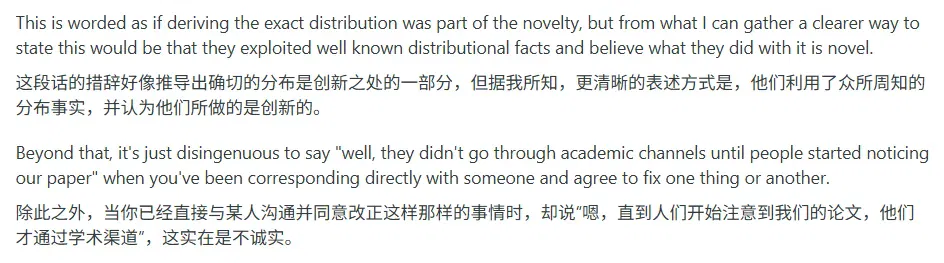
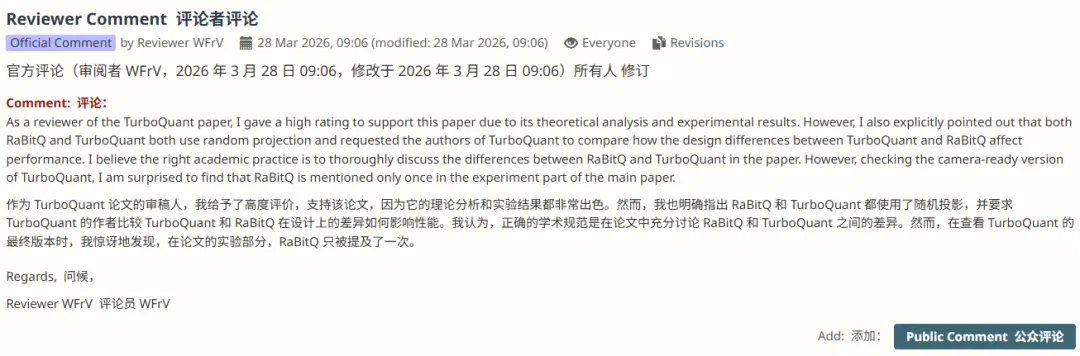
在 OpenReview 平台上,当初给 TurboQuant 打出高分的审稿人站出来表达了强烈的不满。这位审稿人明确指出,他在评审阶段就已经察觉到了两者的相似性,并「强烈建议」作者在正文中充分讨论 TurboQuant 与 RaBitQ 在设计选择上的差异。然而,作者们在最终的 Camera-ready 中不仅没有进行有意义的探讨,反而仅仅在实验部分提了一次 RaBitQ,甚至把原本正文中对 RaBitQ 已经很不完整的描述直接塞进了附录。
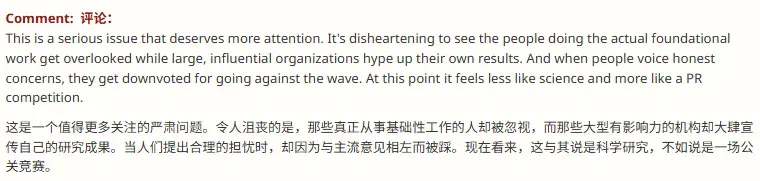
更让社区感到不适的是这背后折射出的大厂傲慢。一位研究者在公开评论中指出,这是一个令人沮丧的现状:做基础奠基性工作的独立研究者或学术团队往往无人问津,而手握巨大影响力的科技巨头(如谷歌)只需将这些底层逻辑稍微包装一下,配合强大的 PR 机器,就能瞬间打造出一个「革命性突破」的学术神话,甚至能以此撬动百亿美元的股票市场。
在这个过程中,如果不是原作者顶着压力、拿着详实的邮件记录和代码证据出来「刚正面」,那些被刻意淡化的技术传承、被错误定性的理论成果、以及单核 CPU 战顶级 GPU 的荒诞对比,就会在大厂千万级的曝光量下固化为新的「行业常识」。
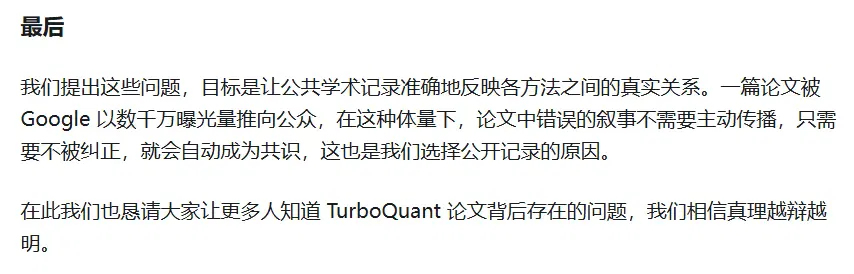
正如 RaBitQ 一作高健扬在声明文末所写:「一篇论文被 Google 以数千万曝光量推向公众,在这种体量下,论文中错误的叙事不需要主动传播,只需要不被纠正,就会自动成为共识。」
纵观整起事件,TurboQuant 在技术层面确实为 LLM 的内存优化提供了一个极具商业价值的工程解法,这也许是它能被 ICLR 接收并在工业界引发地震的原因。
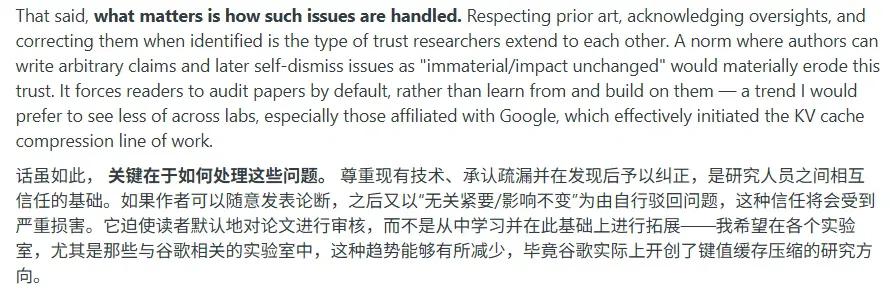
然而,科学研究从来都是建立在同行间诚实、透明的交流与接力之上。当「跑分造假」可以被轻描淡写地解释为「与核心结论无关」,当「忽视先行研究」可以用「行业惯例」来搪塞,这伤害的不仅仅是某一个学术团队的感情,更是整个 AI 研究社区赖以生存的信任基石。
这场风波目前仍在发酵,而它留给学术界和工业界的反思,恐怕比那 900 亿美元的股市震荡要深远得多。
参考链接:
https://www.reddit.com/r/MachineLearning/comments/1s8yni2/d_turboquant_author_replies_on_openreview/
文章来自于"机器之心",作者 "机器之心编辑部"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Neon identifiers surface in Gemini web code; model and subscription positioning remain unconfirmed (opens in a new tab)
A source report recounts developers finding Neon model and subscription identifiers in Gemini web code, alongside discussion of element naming. Code strings and online guesses do not establish a release, plan features or access date.
Karpo Decision goes open-source; 31B model ties first on a specified Decision Index version (opens in a new tab)
MachinePulse releases 0.8B–31B decision models that score options in one forward pass. The 31B model ties first at 73.9 in the November 12 Decision Index 0.4.1 snapshot. Latency and costs depend on test configuration; single decisions differ from full workflows.
Google expands TPU system sales as software adaptation and inference economics draw attention (opens in a new tab)
QbitAI discusses complete-system deliveries, TorchTPU and agent-inference tests using filings and sources. Revenue, unfulfilled contracts and model-specific token-per-dollar comparisons are distinct measures; optimization rounds can change results.
Google adds TPU 8tx and 8i Max for confidential computing and long-context tasks (opens in a new tab)
Google describes new eighth-generation TPU variants expected in 2027. The report covers customer needs, supply constraints and external sales; its 2028 revenue figures are institutional forecasts.
Google releases Gemini 4 Hydrogen and the multimodel Orchestrator (opens in a new tab)
The new model emphasizes fast execution for coding and multimodal tasks. Google also details availability across services, API pricing and model-orchestration tests.