让机器人看视频学操作技能,清华等全新发布的CLAP框架做到了
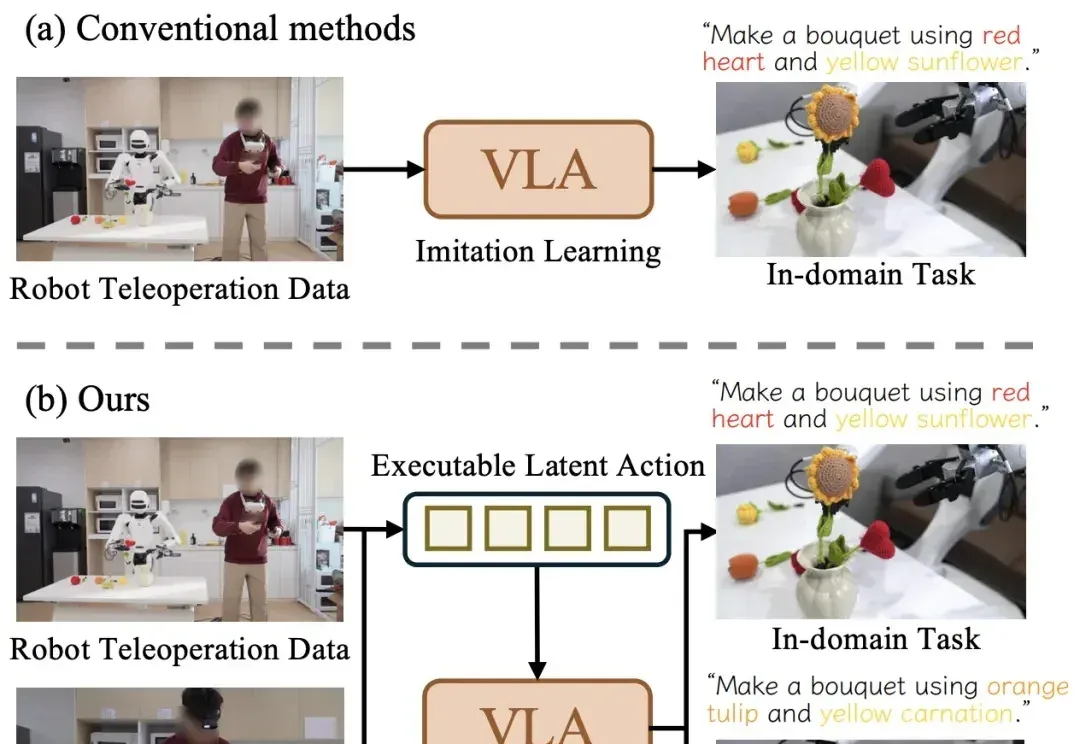
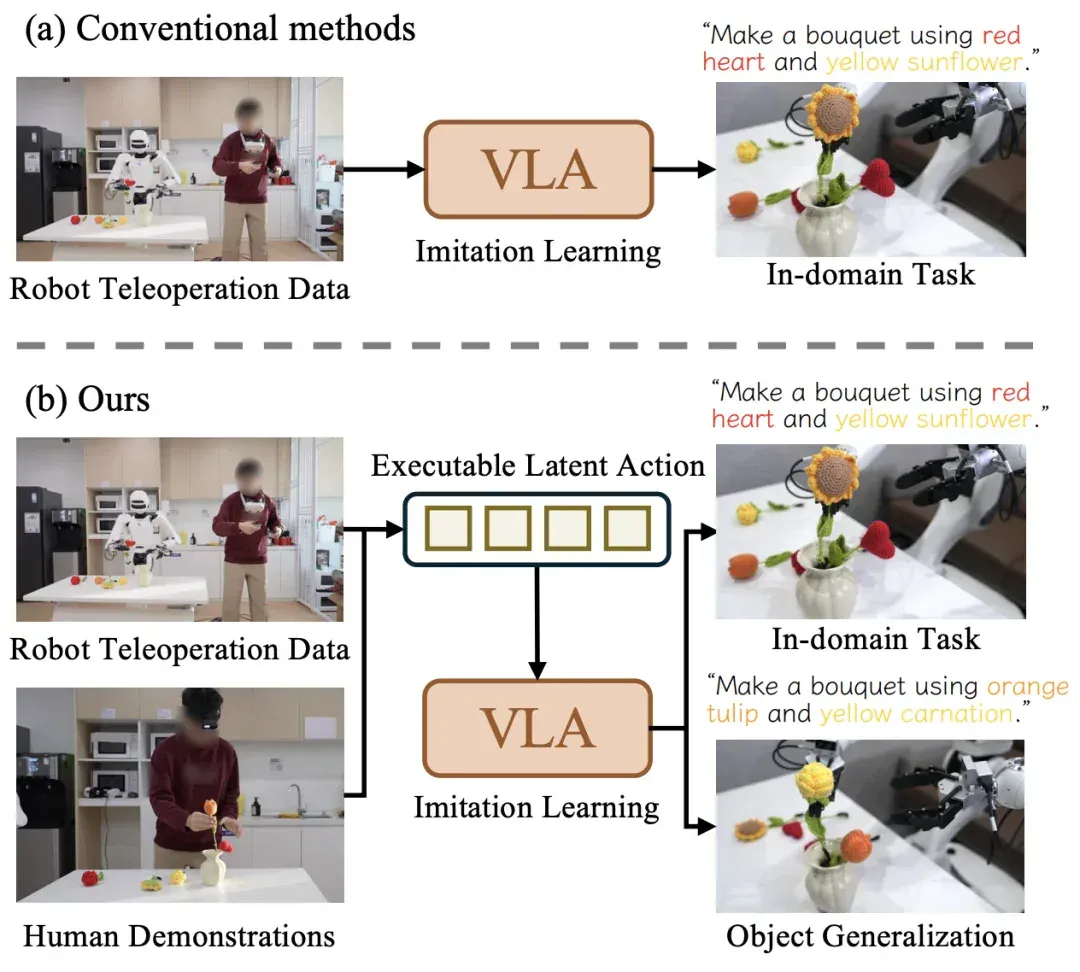
近日,清华大学与星尘智能、港大、MIT 联合提出基于对比学习的隐空间动作预训练(Contrastive Latent Action Pretraining, CLAP)框架。这个框架能够将视频中提纯的运动空间与机器人的动作空间进行对齐,也就是说,机器人能够直接从视频中学习技能!
近日,清华大学与星尘智能、港大、MIT联合提出基于对比学习的隐空间动作预训练(Contrastive Latent Action Pretraining, CLAP)框架。这个框架能够将视频中提纯的运动空间与机器人的动作空间进行对齐,也就是说,机器人能够直接从视频中学习技能!
- 论文标题:CLAP: Contrastive Latent Action Pretraining for Learning Vision-Language-Action Models from Human Videos
- 论文地址:https://arxiv.org/abs/2601.04061
- 项目地址:https://lin-shan.com/CLAP/
引言
长期以来,机器人学习面临着一个令人头疼的「数据饥荒」难题:互联网上有着数以亿计的人类行为视频,但专门用于训练机器人的数据却寥寥无几。
这种数据不对称现象的根源在于,收集机器人操作数据需要昂贵的硬件设备、专业的操作环境,以及大量的人工标注工作,成本高昂且效率低下。相比之下,人类行为视频数据虽然丰富,但由于视觉表征与机器人动作空间之间存在巨大的语义鸿沟,传统方法难以有效利用这些资源。
现有的潜在动作模型(Latent Action Models)试图利用视频数据,但往往会遭遇「视觉纠缠」(visual entanglement)问题 —— 模型学到的更多是与实际操控无关的视觉噪声,而非真实的操控技能。
CLAP 框架的核心创新正是解决了这一长期困扰业界的技术瓶颈。该框架能够将视频中提纯的运动空间与机器人的动作空间进行对齐,有效避免了以往潜在动作模型中普遍存在的「视觉纠缠」问题。通过对比学习,CLAP 将视频中的状态转移映射到一个量化的、物理上可执行的动作码本上。
研究团队基于两种 VLA 建模范式进行训练:其一是CLAP-NTP,一种自回归模型,在指令跟随与对象泛化方面表现突出;其二是CLAP-RF,一种基于Rectified Flow的策略,面向高频率、精细化的操控。
这一技术突破的实际意义体现在多个层面。首先,从数据利用效率来看,CLAP 框架使得机器人能够从 YouTube、抖音等平台上的海量视频中学习技能,极大扩展了可用训练数据的规模。其次,从成本效益角度分析,这种「看视频学技能」的方式显著降低了机器人技能获取的门槛。
此外,该框架还解决了机器人学习中的一个关键技术挑战 —— 知识迁移问题。通过知识匹配(Knowledge Matching, KM)正则化策略,CLAP 有效缓解了模型微调过程中的灾难性遗忘现象,确保机器人在学习新技能的同时不会丢失已掌握的能力。
从产业应用前景来看,CLAP 框架的长期价值不仅在于技术创新,更在于其对机器人产业化进程的推动作用。当机器人能够通过观看视频快速掌握新技能时,企业部署机器人的成本和周期将大幅降低,这有望加速机器人在服务业、制造业等领域的规模化应用。
详解 CLAP 框架
研究团队构建了一个统一的视觉 - 语言 - 动作(VLA)框架,使其能够同时利用机器数据的动作精确性与大规模无标注人类视频演示的语义多样性。框架分为两个相互衔接的阶段:
- 通过 CLAP 进行跨模态对齐:建立共享的潜在动作空间,弥合无标注人类视频与有标注机器人轨迹之间的监督缺口。该过程基于对比学习进行隐空间动作预训练(CLAP):它将人类视频中的视觉状态转移「锚定」到一个量化的、物理上可执行的动作空间中。
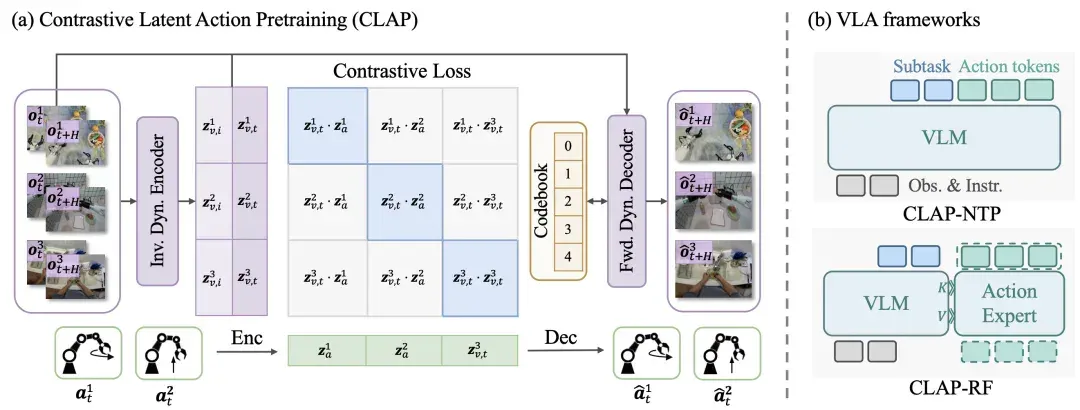
- 分层策略训练:研究团队通过连续训练两个 VLA 模型,将语义理解与控制动力学有效解耦:
- CLAP-NTP:采用「下一词元预测」(Next-Token-Prediction)训练的 VLA,擅长指令跟随与任务规划;
- CLAP-RF:包含一个 VLM 模型与一个采用 Rectified Flow 训练的动作专家,以实现高频、精确控制。
为高效适配新的本体形态并防止预训练先验在微调中发生灾难性遗忘,研究团队进一步提出知识匹配(Knowledge Matching, KM)微调策略:一种正则化方法,在微调过程中将策略更新锚定在可信区域内。
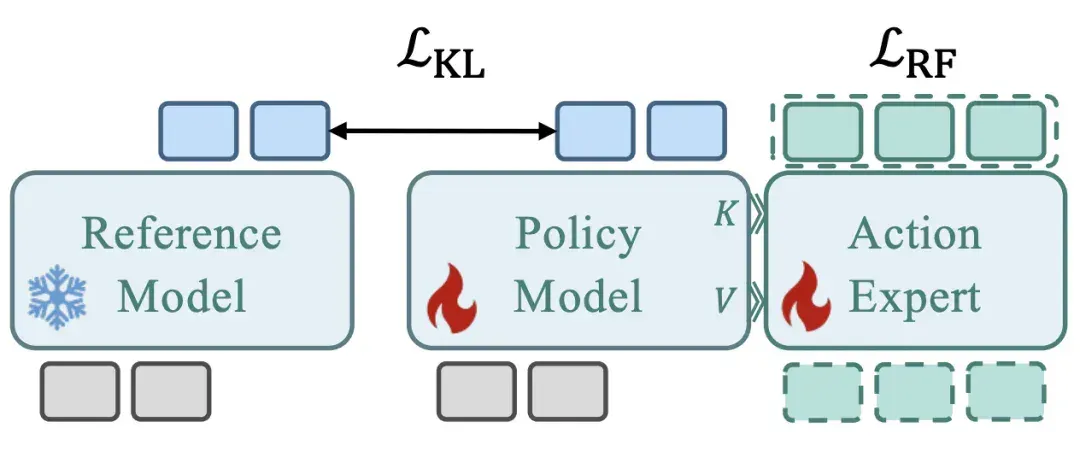
实验结果
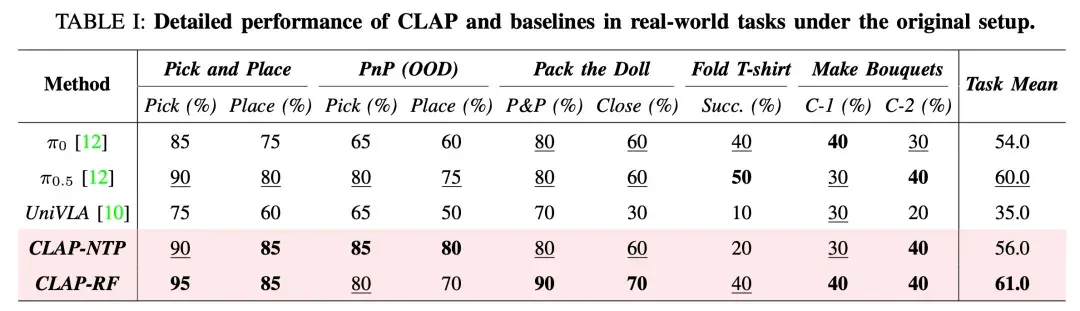
大量实验表明,CLAP 显著优于强基线方法,使得从人类视频中学习到的技能能够有效迁移到机器人执行中。
下表 1 为初始设置下,CLAP 与基线方法在真实世界任务中的性能比较。
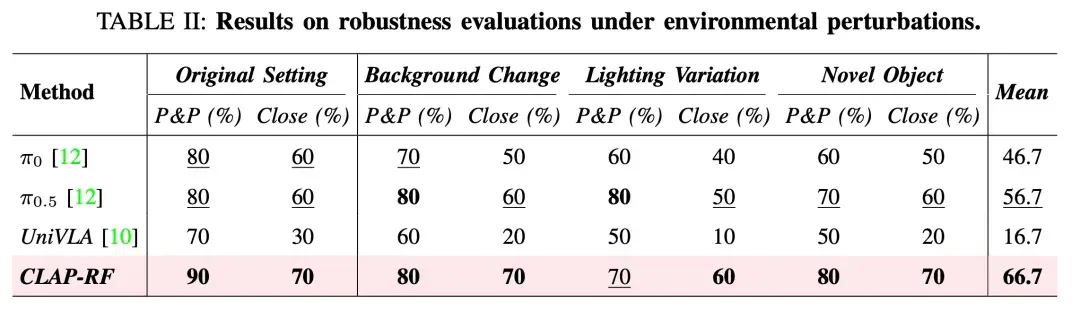
下表2 为 CLAP 与基线方法在环境扰动下的鲁棒性评估。
更多实验结果请参阅原论文。
文章来自于“机器之心”,作者 “机器之心”。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.

Oxford researcher proposes cognitive symbionts for wearable AI augmentation and governance (opens in a new tab)
Hao Fei's perspective paper proposes cognitive symbionts and AI-Augmented Human Intelligence, covering long-term memory, wearables, proactive help and governance. Privacy, low latency and lifelong companionship are design goals, not verified product guarantees.

ConvexLLM connects speech to language models through frozen text embeddings (opens in a new tab)
Researchers at CUHK-Shenzhen and Microsoft propose C-Gate, mapping audio into convex combinations of frozen text embeddings. The paper reports VoiceBench gains against its listed open-model baselines, while audio understanding and transcription still involve trade-offs.

CWM2.0 open-sources generative rendering with a 30-minute racing demo (opens in a new tab)
Teams from Ant, Westlake University and Zhejiang University use a structured Proxy to control scene state and Invoker-Render to generate visuals, releasing eight-GPU streaming inference. The long demo and 140 evaluations cover specified scenes, not arbitrary stable worlds.

Ankole outlines multi-user agent architecture: events, permissions and organizational memory (opens in a new tab)
The team describes its Business Harness design for fast and slow paths, shared state, Actor orchestration and dynamic permissions. Formal verification covers the modeled core permission state machine; it does not replace security checks of the full deployment, external interfaces or implementation.

openJiuwen presents a Harnessless approach for reusing AgentOS execution tools (opens in a new tab)
openJiuwen uses app-development and swarm demos to show how built-in harness capabilities support sessions, tools and app management. Applications still define business rules and permissions; remote deployment and some capabilities remain planned or exploratory.