
Know AI. See What’s Next.




Slide 1 of 5: 姜宇辉的AI分身:知识助手与“另一个自己”之间
Latest news
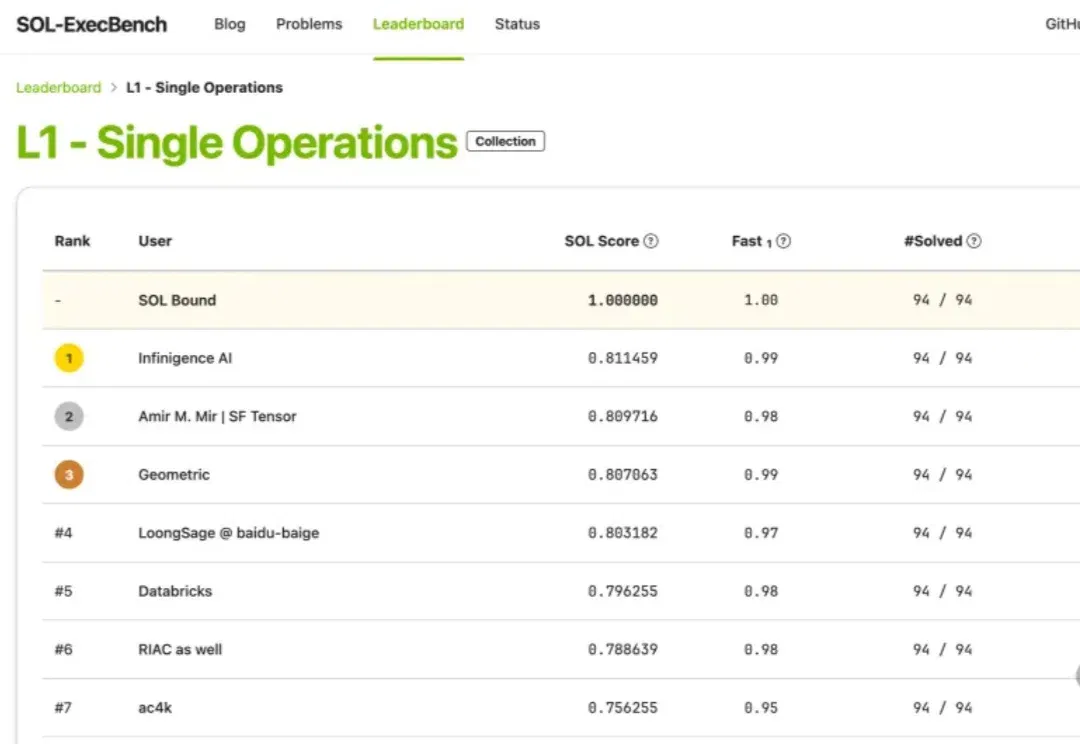
无问芯穹披露 SOL-ExecBench 成绩,介绍 GPU 算子优化 Agent (opens in a new tab)
据团队披露,截至 10 月 26 日,无问芯穹在 SOL-ExecBench 的 235 道题中取得 88 项单题第一,并在两个赛道总分领先。文章进一步介绍容器隔离评测、共享记忆与分层优化策略,展示如何把代码生成和真实硬件反馈连接起来;动态榜单成绩不等同于所有 GPU 工作负载的性能优势。
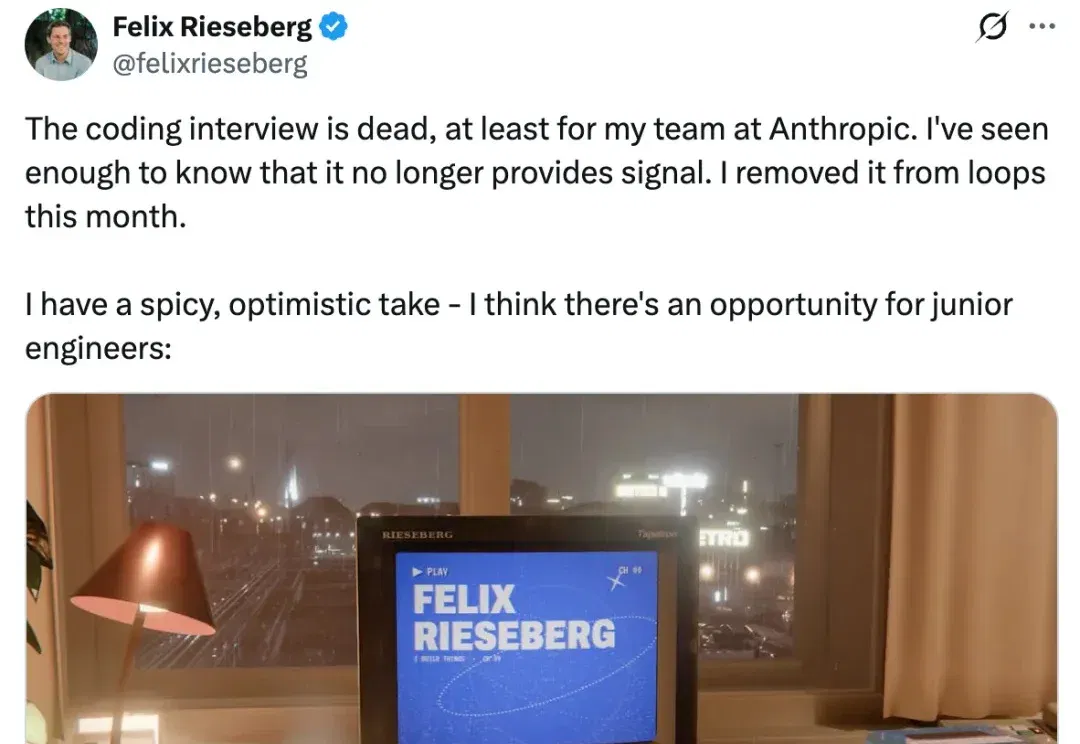
Anthropic 工程负责人取消团队编程面试,更看重原型与行动力 (opens in a new tab)
Felix Rieseberg 表示已从自己团队的招聘流程中移除传统编程面试,并讨论 AI 时代如何识别工程师的实际贡献。他建议初级工程师围绕业务目标做出聚焦、可运行的原型,同时坦言替代面试方法仍在探索;这并非 Anthropic 全公司的统一招聘政策。
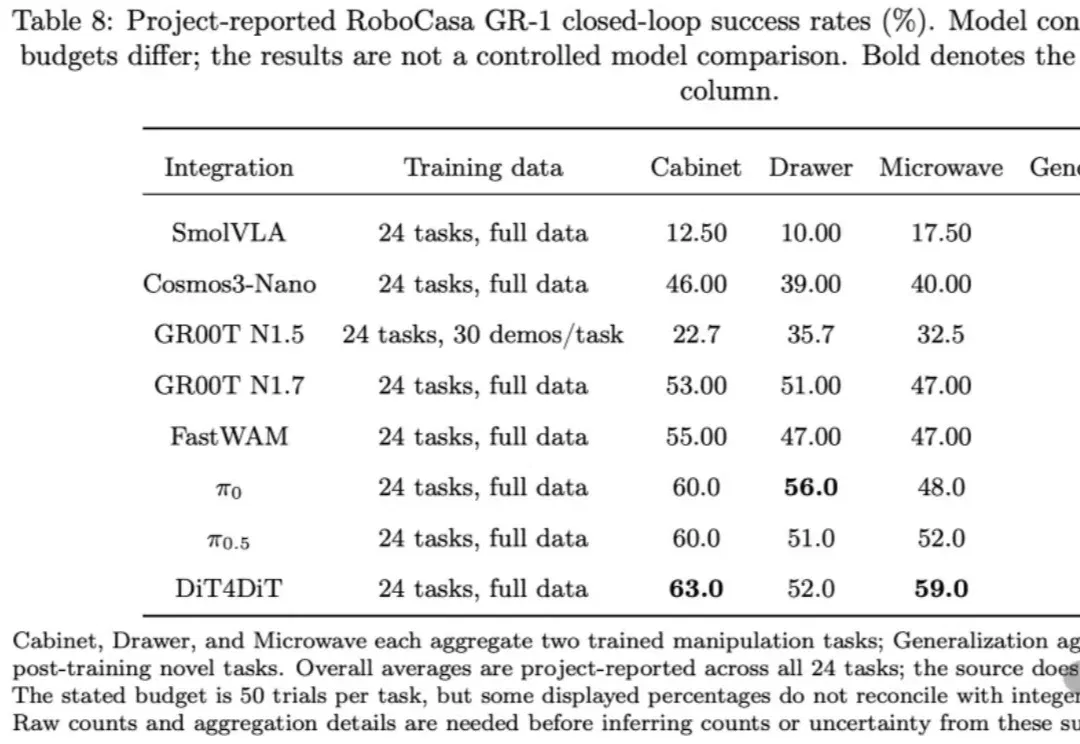
FluxVLA Engine V2:连接模型训练、在线强化学习与真机部署 (opens in a new tab)
逐际动力更新 FluxVLA Engine 技术报告,补充在线强化学习、仿真评测和多种机器人平台的部署链路。统一配置、数据接口、推理加速与动作衔接旨在减少重复工程;报告中的性能增益来自特定模型和设备组合,仿真高分与真机任务完成率仍需分别看待。
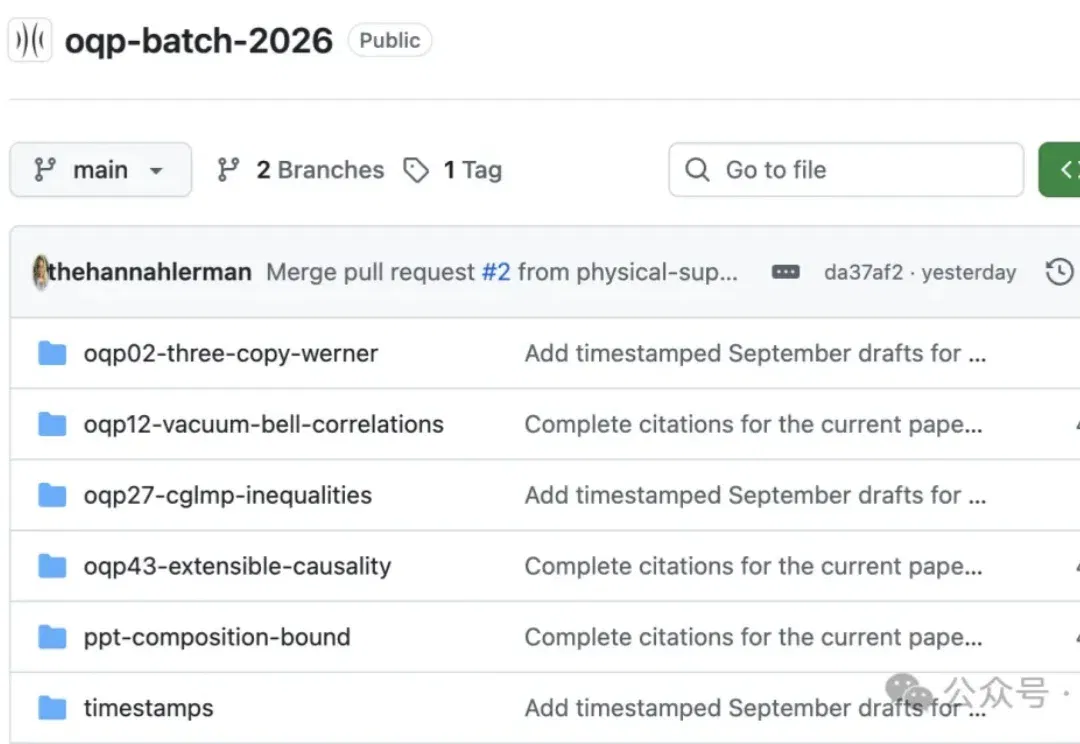
PSI 公布五项量子信息研究结果与 Lean 形式化材料 (opens in a new tab)
Physical Superintelligence 公布与开放量子问题目录相关的五项研究结果,并提供论文和 Lean 形式化材料供审查。结果涉及纠缠、贝尔不等式和量子因果过程等方向;各项结论有具体适用条件,需要区分对原问题的局部推进与完整解决。
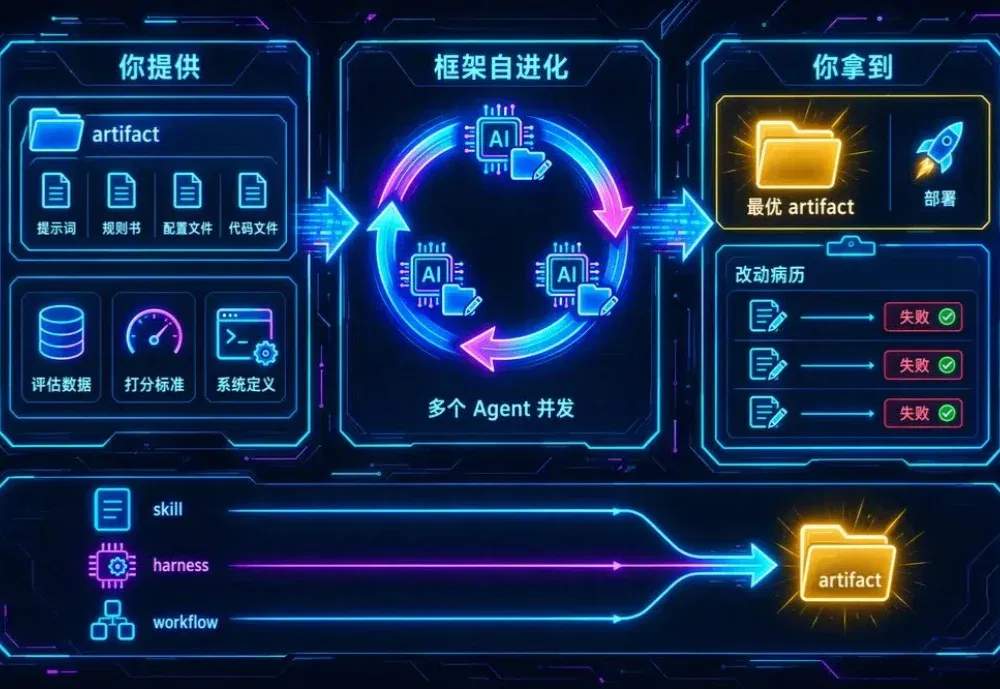
蚂蚁开源 AntOmniEvo,让 AI 迭代提示词、规则和配置 (opens in a new tab)
AntOmniEvo 将 AI 系统中可修改的部分组织成文件目录,通过修改、评估和筛选反复优化。Mara Chain 在有限预算内保留失败尝试的诊断记录,减少重复试错;团队展示了技能、执行框架与检索管线的实验结果,也指出 Text2SQL 测试尚未观察到提升。
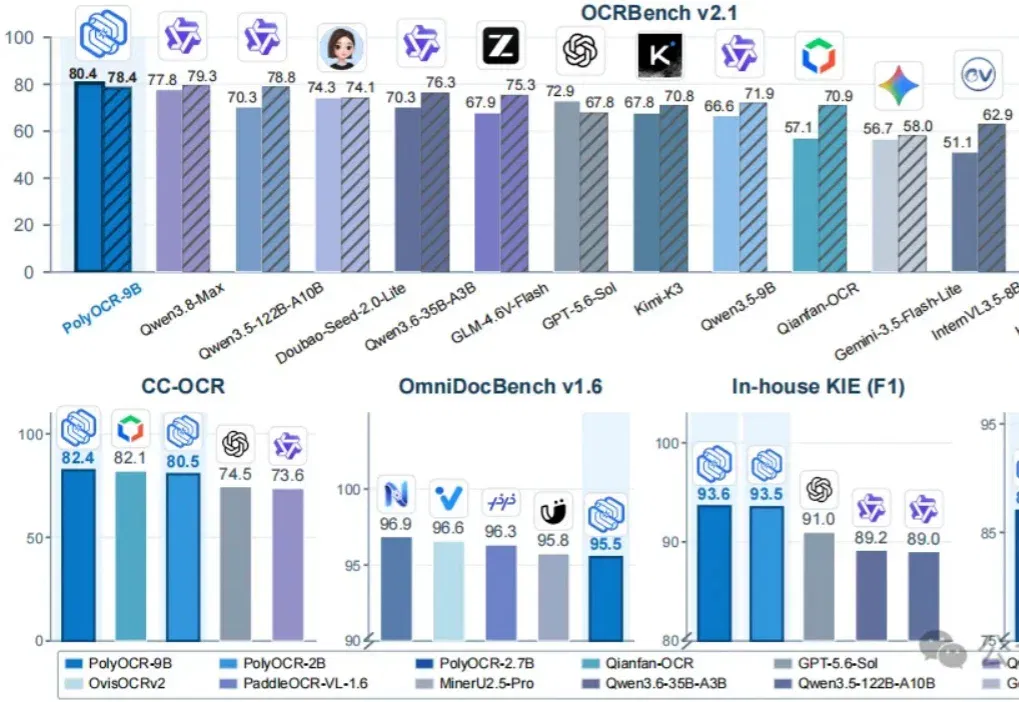
PolyOCR 用统一模型处理文字、版式与字段抽取,2B 和 9B 如何取舍 (opens in a new tab)
蚂蚁 AI 安全实验室介绍 PolyOCR,以多任务数据与能力引导策略优化连接文字识别、文档结构和字段理解。2B 与 9B 在部分卡证测试上接近,复杂文档表现则存在差距;高分版式解析方案还借助外部布局模块,部署选择需要结合真实材料与硬件验证。
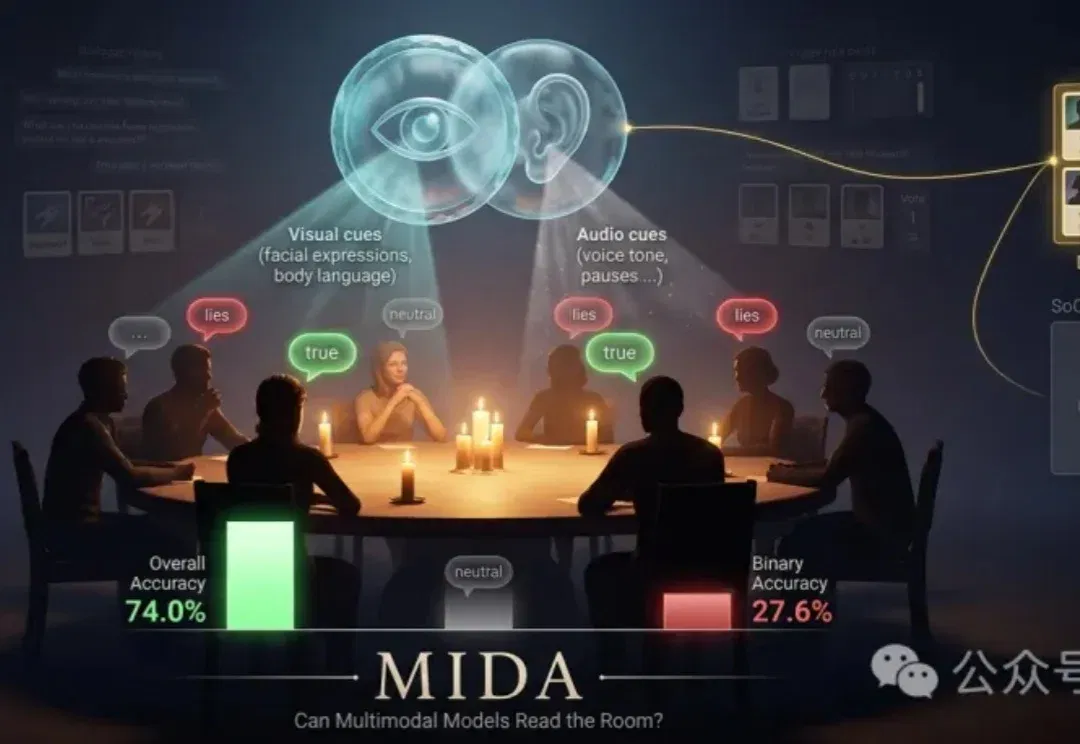
MIDA 狼人杀基准:多模态模型为何仍难判断发言真假 (opens in a new tab)
MIDA 以狼人杀对话测试模型能否结合玩家掌握的信息,区分真话、假话与无法判断的发言。研究发现,总体准确率可能掩盖大量“中立”预测;持续跟踪对话历史和角色信念,比简单增加视频帧更关键。这类受控游戏测试仍不能等同于现实测谎。
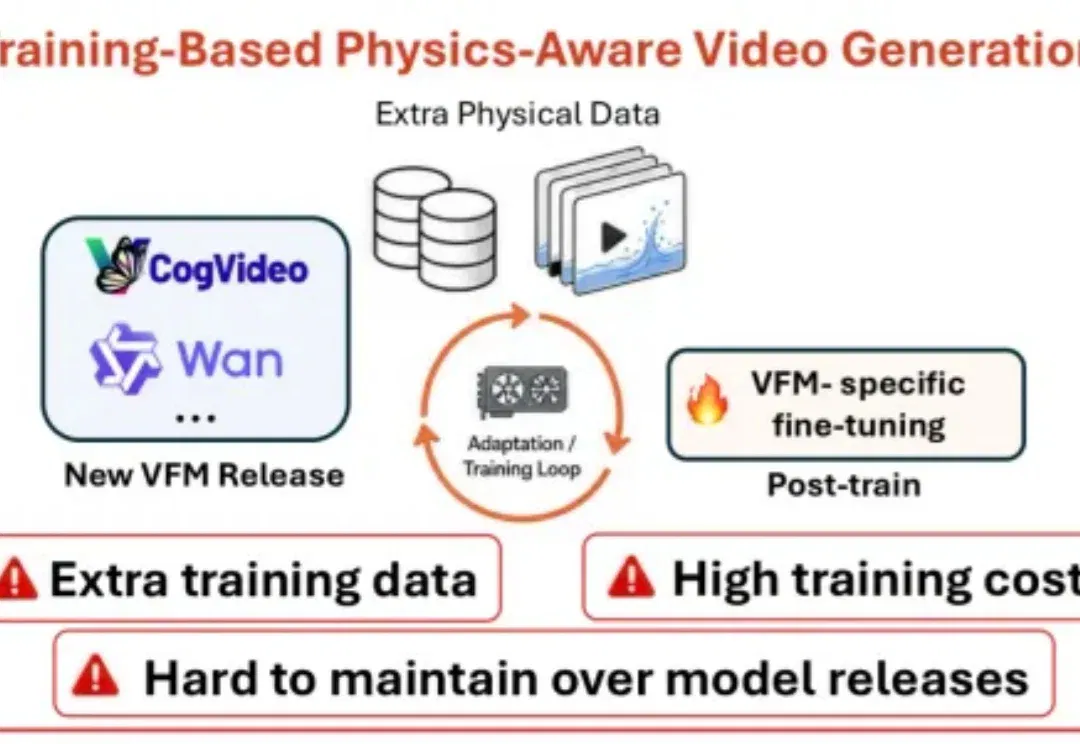
Fluid-Gen-Zero:不改模型权重,用物理仿真引导流体视频生成 (opens in a new tab)
Fluid-Gen-Zero 把运动轨迹交给物理模拟器,把外观生成交给预训练视频模型,并通过事件规划与区域引导连接两者。研究在流体交互场景中测试了这条无需更新模型权重的路线,但效果仍依赖场景重建、仿真质量和具体生成设置。
NV-CoT 用连续坐标选择图像区域,改进视觉思维链定位 (opens in a new tab)
视觉模型即使理解了问题,也可能因图像裁切位置不准而错过细节。NV-CoT 用连续坐标替代离散位置选择,结合监督微调与强化学习改善区域定位;多项高分辨率测试展示了收益,但更精确的坐标仍无法替代正确的语义理解。
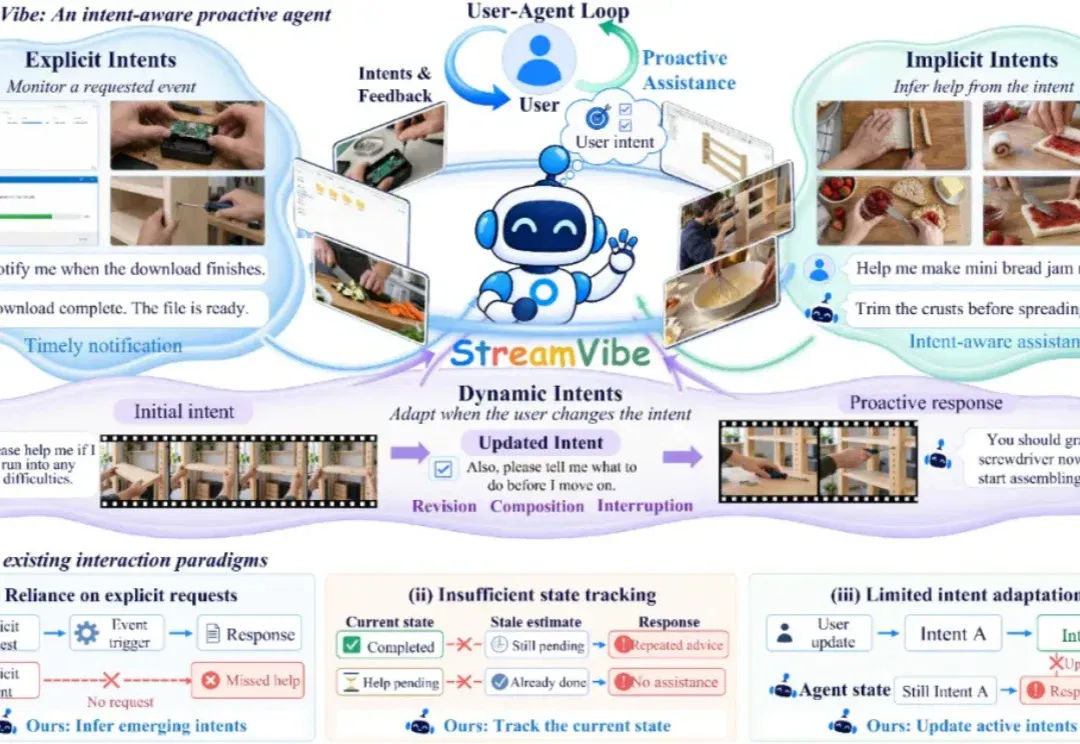
StreamVibe:让视频 Agent 跟踪用户不断变化的意图 (opens in a new tab)
StreamVibe 将显式请求、隐式帮助需求和动态意图放入持续视频交互,结合策略学习与状态记忆管理决定何时回应。报道区分逐点评测与完整轨迹,并讨论重复提醒、误触发和长时间交互中的错误累积。
Pieter Levels 退订 SaaS:个人软件省下什么,又要自己维护什么? (opens in a new tab)
独立开发者 Pieter Levels 用 AI 和开源工具替代多项工作软件,同时继续为邮箱、托管、备份及模型服务付费。文章结合其个人实践与开源办公软件案例,讨论定制软件的自由度、兼容性和长期维护成本,而非宣告所有软件订阅都已失去价值。
两份 ETH 相关研究比较:次指数计数算法与独立审查 (opens in a new tab)
量子位比较 OpenAI 与 Anthropic 披露的 ETH 相关算法与形式化范围,并解释这类复杂性结果为何影响条件性下界。报道明确参与审查不等于认可结论,相关材料仍需谨慎、独立地复核。
RobotAgentBench:从任务发现到失败恢复,评估机器人开放场景能力 (opens in a new tab)
RobotAgentBench 通过家庭仿真与真实环境子集,考察机器人操作、任务发现、情境推理、失败恢复和鲁棒性。研究比较规划、执行与验证的不同组合,并说明自我改进收益及仿真到真实环境仍存在的差距。
迅策推出 TokenRouters,面向企业数据与专用模型资源匹配 (opens in a new tab)
迅策介绍 TokenRouters 的数据集、模型、应用和场景资源匹配思路,并结合 PCB 质检等案例讨论数据治理与企业小模型部署。文中的专用 Token 交换、审计和商业模式属于公司方案,具体效果需结合场景验证。
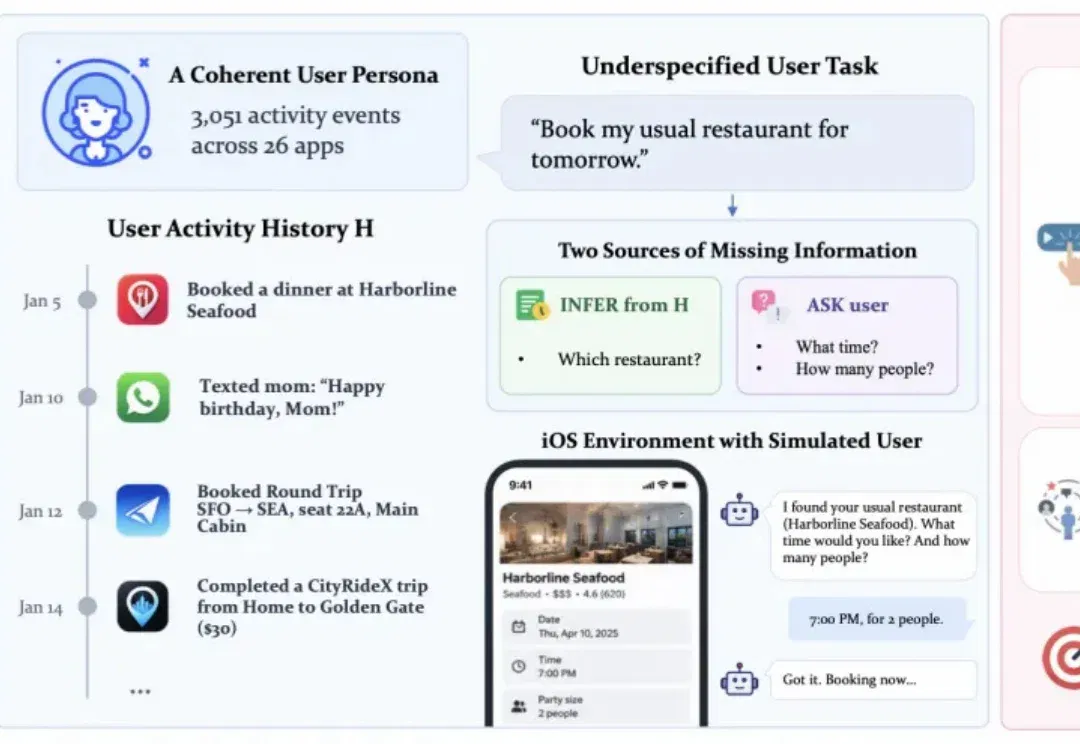
苹果Personal Agent新研究:能帮你干活儿,不等于真了解你 (opens in a new tab)
苹果团队提出 iPrefBench,在可执行的 iOS 环境中评估 Agent 何时应从历史推断偏好、何时需要询问用户。实验显示,完成操作与符合个人意图并不相同;增加澄清可减少漏问,也可能带来多余打扰。
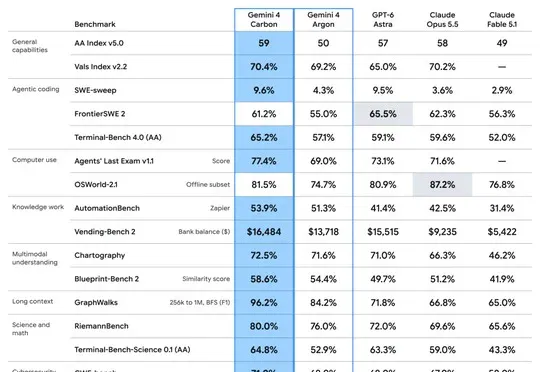
Google 发布 Gemini 4 Carbon,先向可信网络防御伙伴开放 (opens in a new tab)
Google 介绍 Gemini 4 Carbon 的长程工程、代码与网络安全能力,并从部分网络防御伙伴开始逐步开放。报道汇总官方与第三方评测;更大范围的开发者、企业和消费者使用仍取决于后续推出安排。
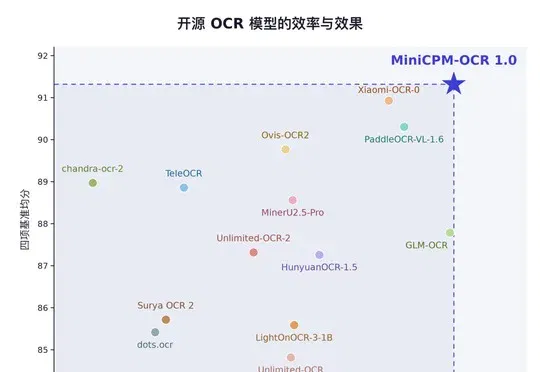
MiniCPM-OCR 1.0 与 Jev 开源,把文档解析和置信度评估分开 (opens in a new tab)
面壁智能介绍 MiniCPM-OCR 1.0 和独立评分模型 Jev:前者解析复杂文档,后者评估候选结果,供程序决定重读或交给人工复核。文章结合作者案例讨论识别效率与可信度,评分并不代表所有业务场景都能免除核查。
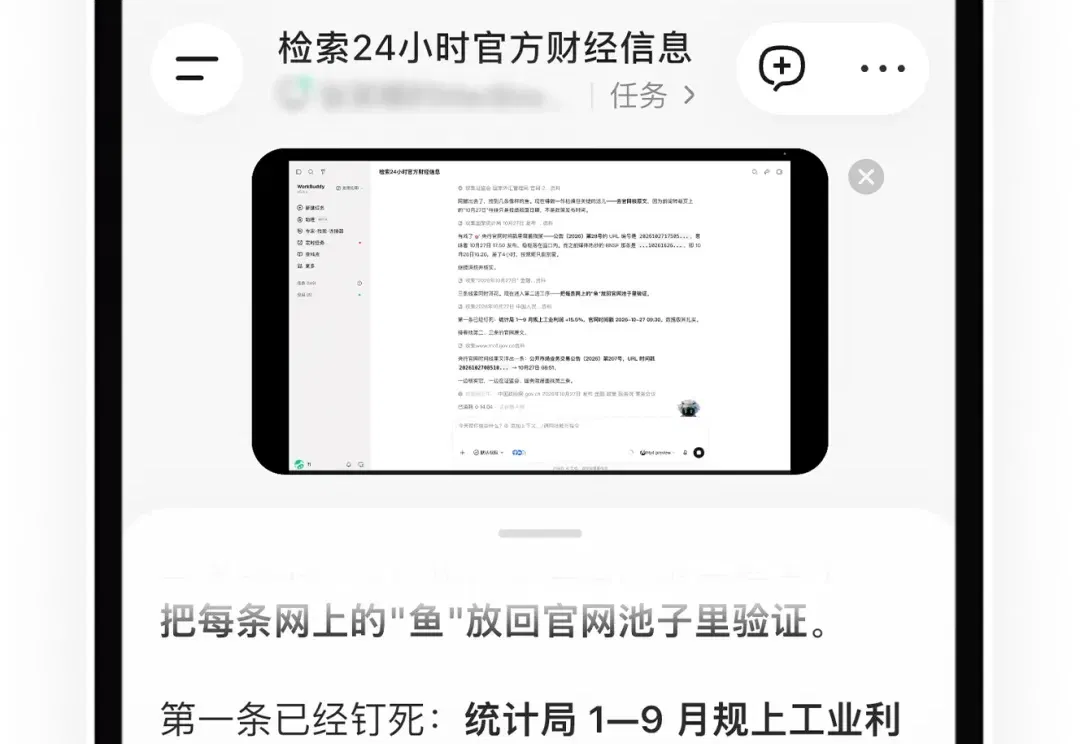
把电脑屏幕装进手机里:WorkBuddy「远程控制」上线 (opens in a new tab)
腾讯 WorkBuddy 介绍手机查看与接管电脑桌面的远程控制功能,可辅助处理任务中的登录、授权和手动操作。文章说明同账号设备连接、桌面端权限及电脑开机在线等前提,并介绍键盘、鼠标和画质控制方式。
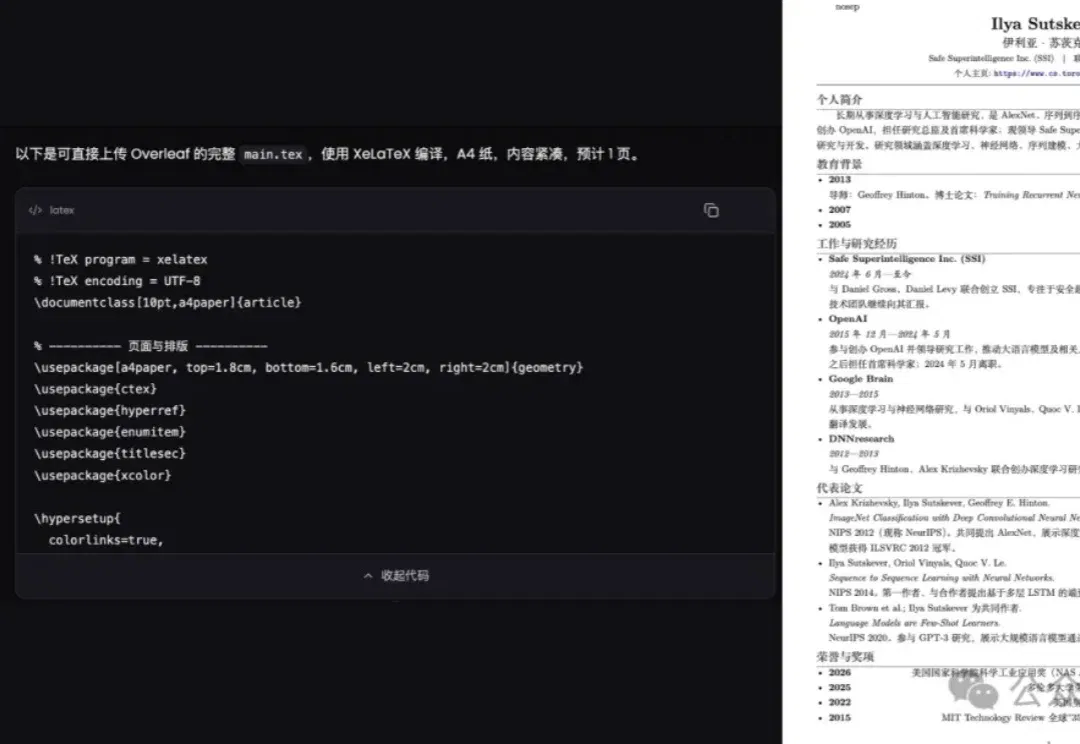
Clover 上手与架构解析:扩散语言模型怎样执行 Agent 任务 (opens in a new tab)
量子位结合交互网页、代码生成和工具调用的上手记录,解释 Clover 的块扩散、历史记忆与连续任务执行方式。文章区分作者体验、团队评测和后续多模态及端侧计划,不将特定任务耗时推广为普遍速度。
Anthropic 披露收购 Mithril Medicine,探索 AI 协调药物研发 (opens in a new tab)
报道介绍 Mithril Medicine 由全职创始人、科学顾问、外部实验室与 Claude 协作推进研发的案例,以及 Anthropic 公布的药企合作进展。相关候选药与实验成果主要处于临床前阶段,不能等同于疗法已经验证或上市。