Google 发布 Gemini 4 Carbon,先向可信网络防御伙伴开放
Google 介绍 Gemini 4 Carbon 的长程工程、代码与网络安全能力,并从部分网络防御伙伴开始逐步开放。报道汇总官方与第三方评测;更大范围的开发者、企业和消费者使用仍取决于后续推出安排。
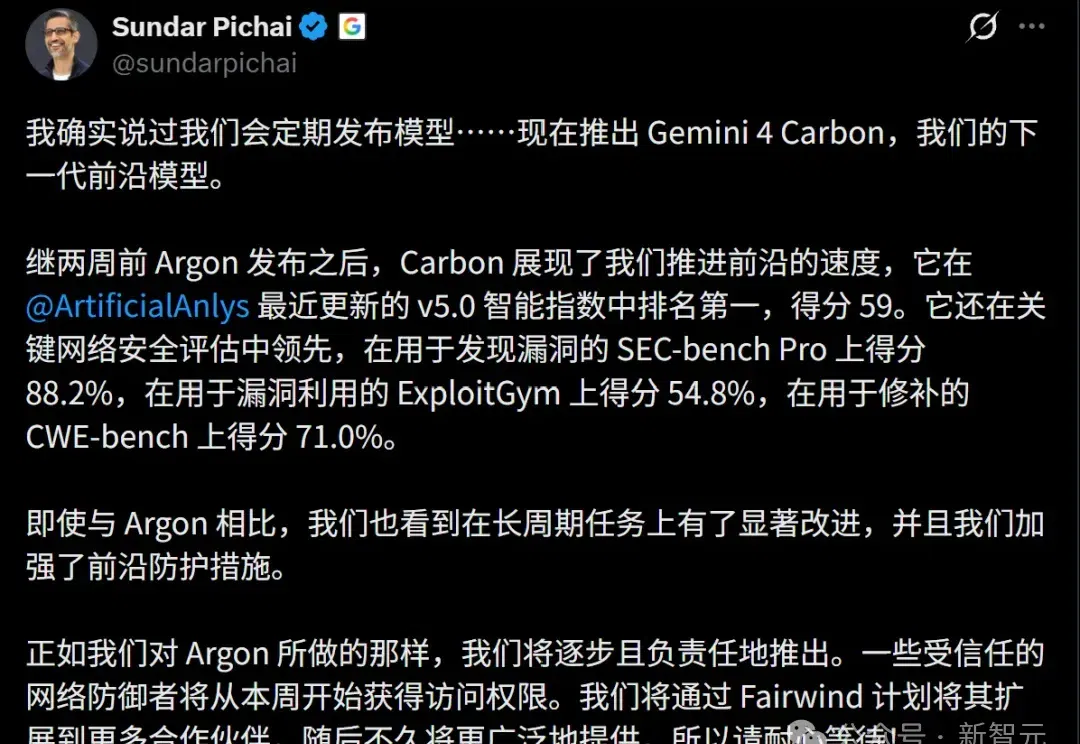
刚刚,Google 宣布推出新一代前沿模型,号称「最强模型」的 Gemini 4 Carbon!
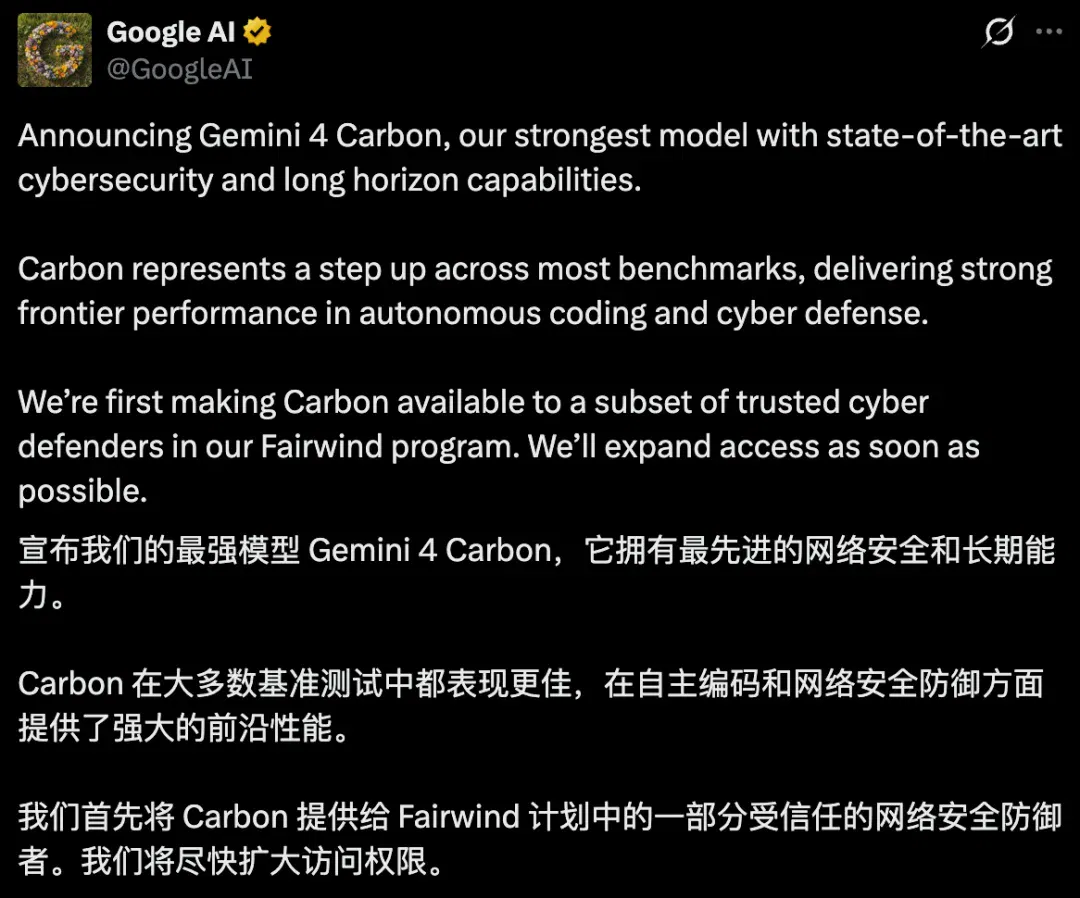
该模型在网络安全和长程任务处理能力方面均达到了当前最先进水平。Carbon 能够连续数天处理复杂任务,不会陷入停滞,也不会为了完成任务而走捷径,最终交付高质量、可靠的代码。
距离上一款旗舰 Gemini 4 Argon 发布,才过去两周。Demis Hassabis 用一个闪电 emoji 开头,谷歌正在「Iterating at lightning speed」(以闪电般的速度迭代)新模型。
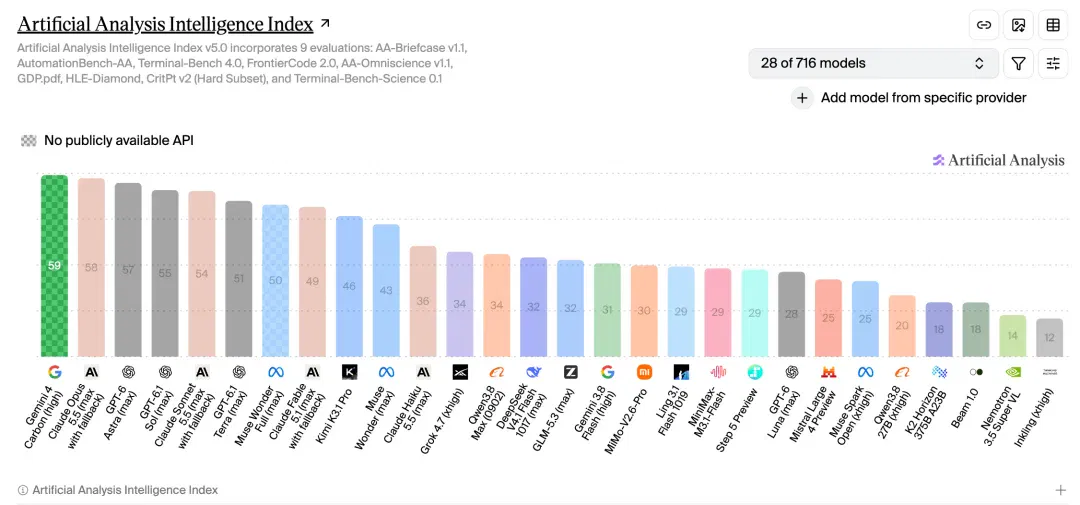
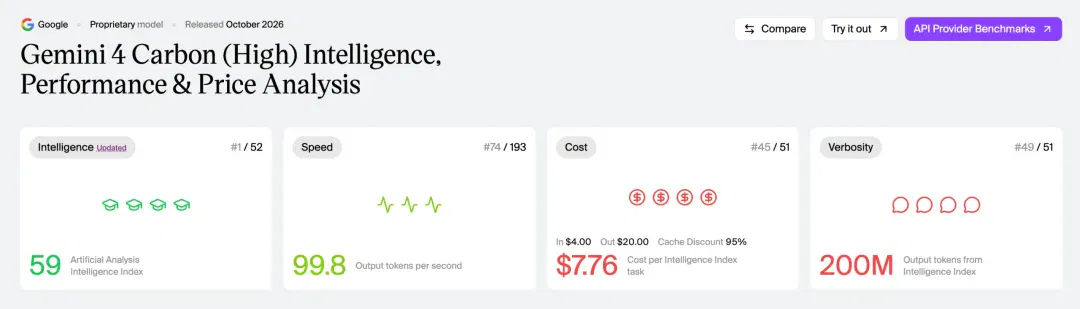
很好,很有底气。从数据看,这个全新的 Carbon 模型真挺不赖。Carbon 在第三方评测机构 Artificial Analysis 的智能指数 v5.0 中拿到 59 分,登顶第一。紧随其后的 Claude Opus 5.5 是 58 分,GPT-6 Astra 是 57 分。三家模型只差 2 分,但「第一」就是第一。
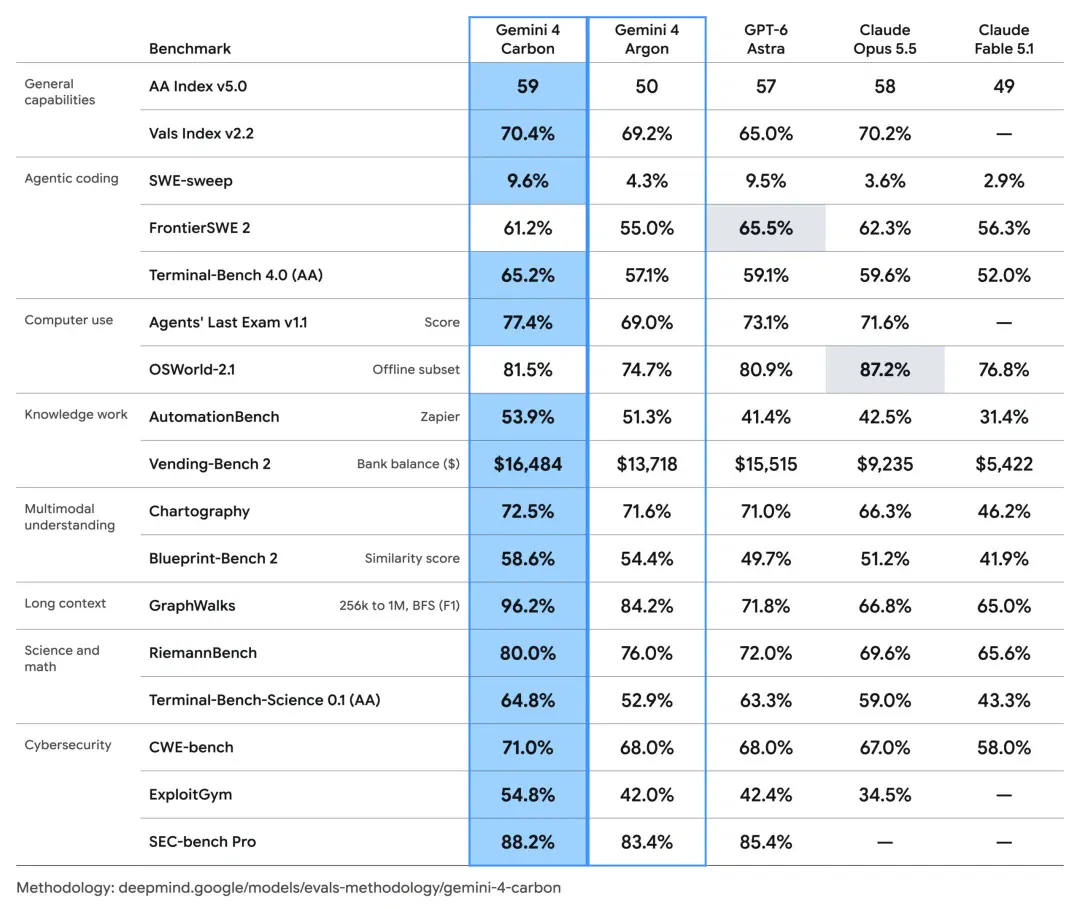
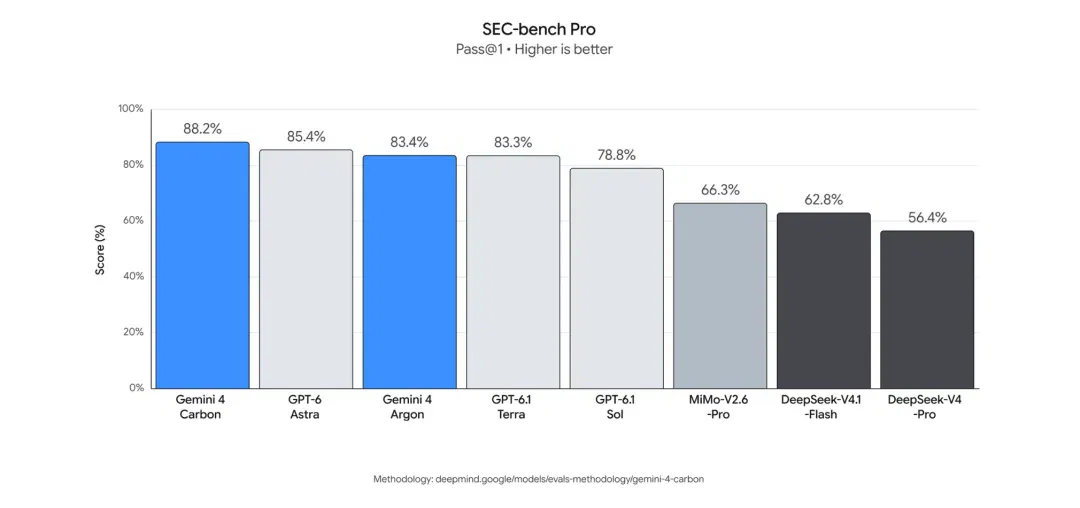
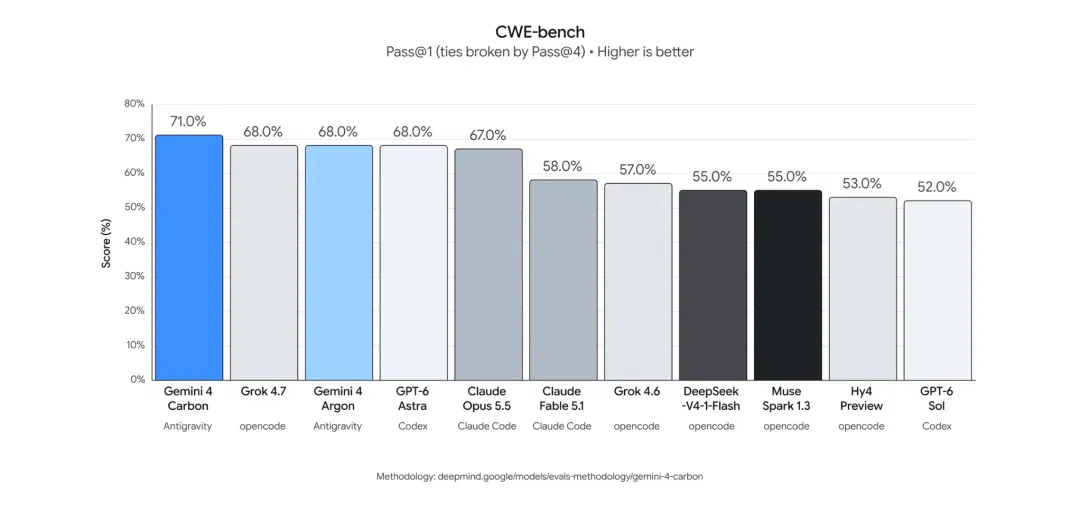
此外,Carbon 在漏洞发现基准 SEC-bench Pro 中取得 88.2% 的成绩,在漏洞利用基准 ExploitGym 中达到 54.8%,在漏洞修复基准 CWE-bench 中达到 71.0%,该模型均确立了明显的领先优势。
- 博客链接:https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
网络安全全链路 SOTA,Chrome 团队实测「好 10 倍以上」
Google 在官方博客里为 Carbon 的网络安全能力花了大量篇幅。具体来看,Carbon 覆盖了网络安全防御的三个关键阶段,且每个阶段都做到了 SOTA。
寻找漏洞:在 SEC-bench Pro 上,Carbon 拿下 88.2% 的成绩,超过 GPT-6 Astra 的 85.4% 和 Argon 的 83.4%。这个基准测试的任务是让模型自主发现隐藏在真实软件中的复杂安全漏洞。
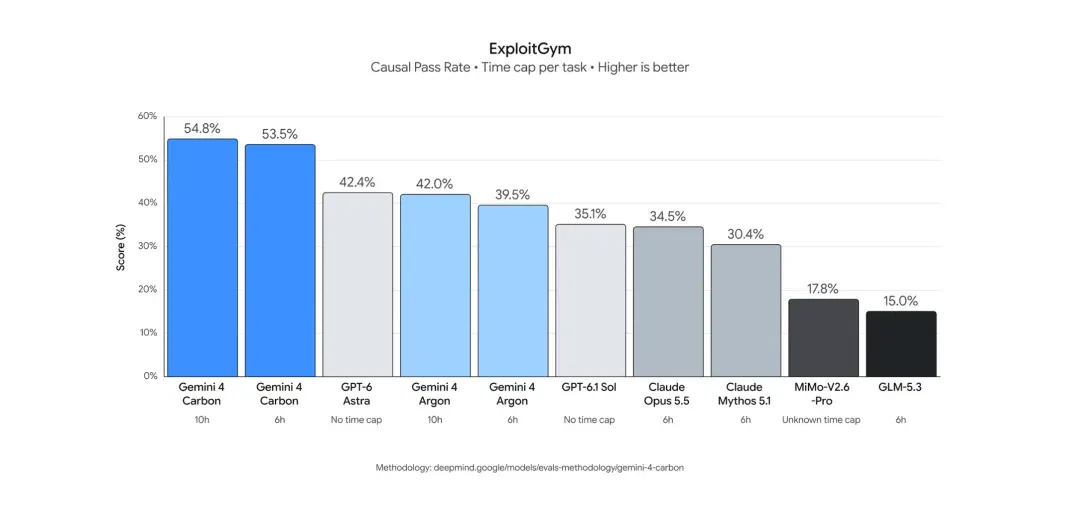
验证漏洞:在 ExploitGym 上,Carbon 得分 54.8%,大幅领先第二名 GPT-6 Astra 的 42.4%。这项测试衡量的是模型能否验证漏洞的实际可利用性,帮助安全团队决定修补优先级。在 10 小时时限下,Carbon 与 6 小时时限的差距很小(54.8% vs 53.5%),说明它在较短时间内就能完成大部分验证工作。
修复漏洞:最终在识别出漏洞后,修复根源原因是网络安全防御生命周期中的一个关键步骤。Carbon 在 Collinear 的 CWE-bench 上达到了 71.0%,将验证后的发现直接转化为可工作的代码修复。
除了公开 benchmark,Google 还给出了内部数据。Carbon 生成安全代码的成功率比 Argon 提升超过 2 倍。Chrome 浏览器团队的反馈更夸张,他们报告Carbon 在生成高质量安全补丁方面比「另一家实验室的大型前沿模型」表现好 10 倍以上。
Google 旗下的云安全平台 Wiz 也参与了测试,观察到 Carbon 在 Web 渗透测试基准中表现领先,这是 Wiz「Scan for Good」计划的核心能力之一。
长程任务:可以连续运行数天
Carbon 的另一大亮点是「长程任务」能力。这也正在成为新一代前沿大模型竞争的关键能力之一。
Google 表示,内部团队观察到Carbon 可以在大型代码库和底层系统中持续运行数天,完成跨文件的根因追溯(root-causing)与补丁生成。遇到死胡同时,模型能自主调整策略继续推进,不会直接终止任务。
这一能力的技术基础之一是长上下文处理能力的显著提升。在 GraphWalks 测试(256k 至 1M token 范围的 BFS F1 评测)中,Carbon 从 Argon 的 84.2% 跃升至 96.2%,领先 GPT-6 Astra 的 71.8% 和 Claude Opus 5.5 的 66.8% 超过 20 个百分点。支持 1M token 的上下文窗口,意味着模型可以一次性处理约 1500 页 A4 文档的等量信息。
长时程能力之所以越来越重要,背后是 Agent 工作流对模型提出了更高要求。 以软件工程为例,真正复杂的开发任务往往涉及持续跟踪代码变更、协调多个分支的修改、处理跨模块依赖,以及反复测试和修复问题。这些工作可能持续数小时甚至数天,早已超出单次问答的范畴。
对于前沿大模型而言,能否在漫长的执行过程中保持目标一致、及时纠错,并最终交付可靠结果,正在成为衡量其实际工程价值的重要标准。
Benchmark 全景:智能指数 9 项评测 4 个第一
Artificial Analysis 智能指数 v5.0 是目前业内引用较多的综合评估体系。
Carbon 以总分 59 登顶,在其中 4 项拿下单项第一(HLE-Diamond、Terminal-Bench-Science、AA-Omniscience、AutomationBench-AA),比 Claude Opus 5.5(58 分)高 1 分,比 GPT-6 Astra(57 分)高 2 分,比两周前的 Argon(50 分)提升 9 分。Artificial Analysis 评价,Carbon 的领先由复杂推理、知识和科学任务上的强势表现驱动,在编程和知识工作方面有大幅进步(尤其相对 Gemini 系列历史表现),但在这些方向上还没有全面领先。
以下分维度展开。
编程方面,是 Google 模型的传统短板,Carbon 进步幅度最值得关注。在 Artificial Analysis Coding Agent Index 上,Carbon 搭配 Antigravity CLI(high reasoning)得分 59,仅落后排名第一的 Claude Code + Claude Opus 5.5(max reasoning,62 分)3 分。单项评测中,Terminal-Bench 4.0 得分 64%,FrontierCode v1.1 得分 51%,两项均排名第二,仅次于 Claude Opus 5.5(max,56%)。在 WebDev Arena(全栈 Web 开发竞技场)上跃升 89 Elo 至第四名(1768 Elo)。
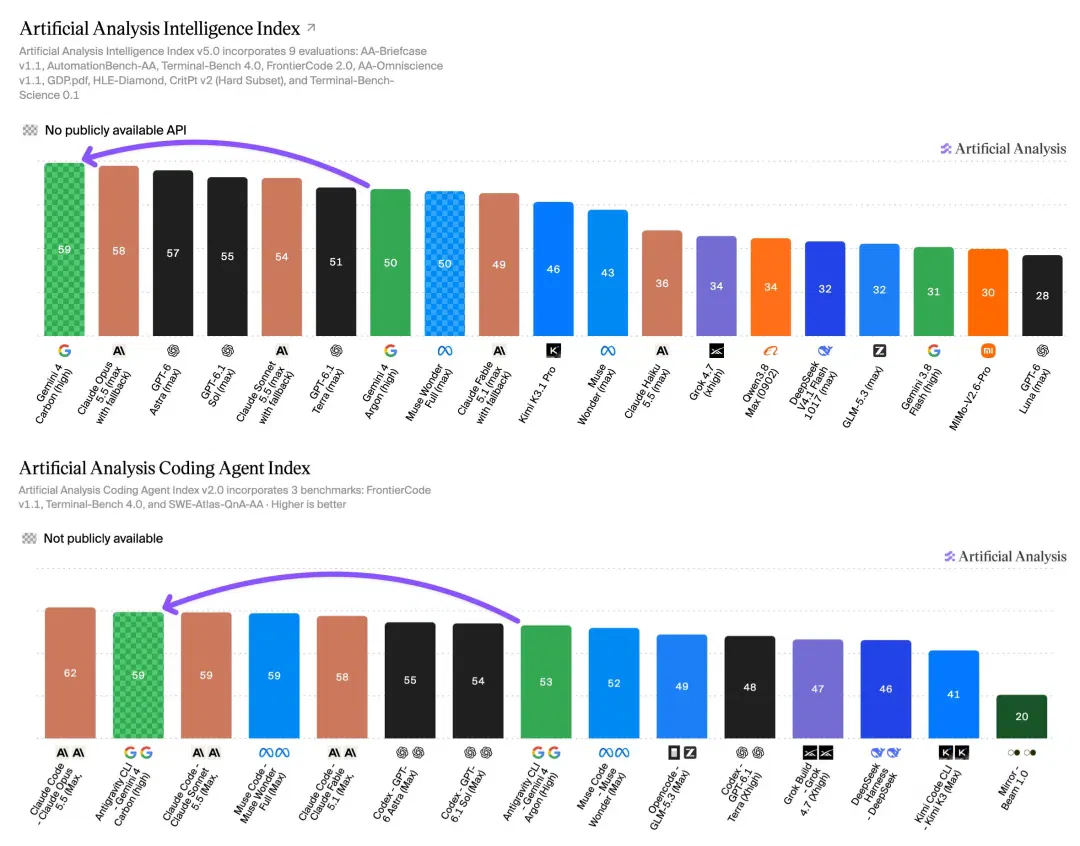
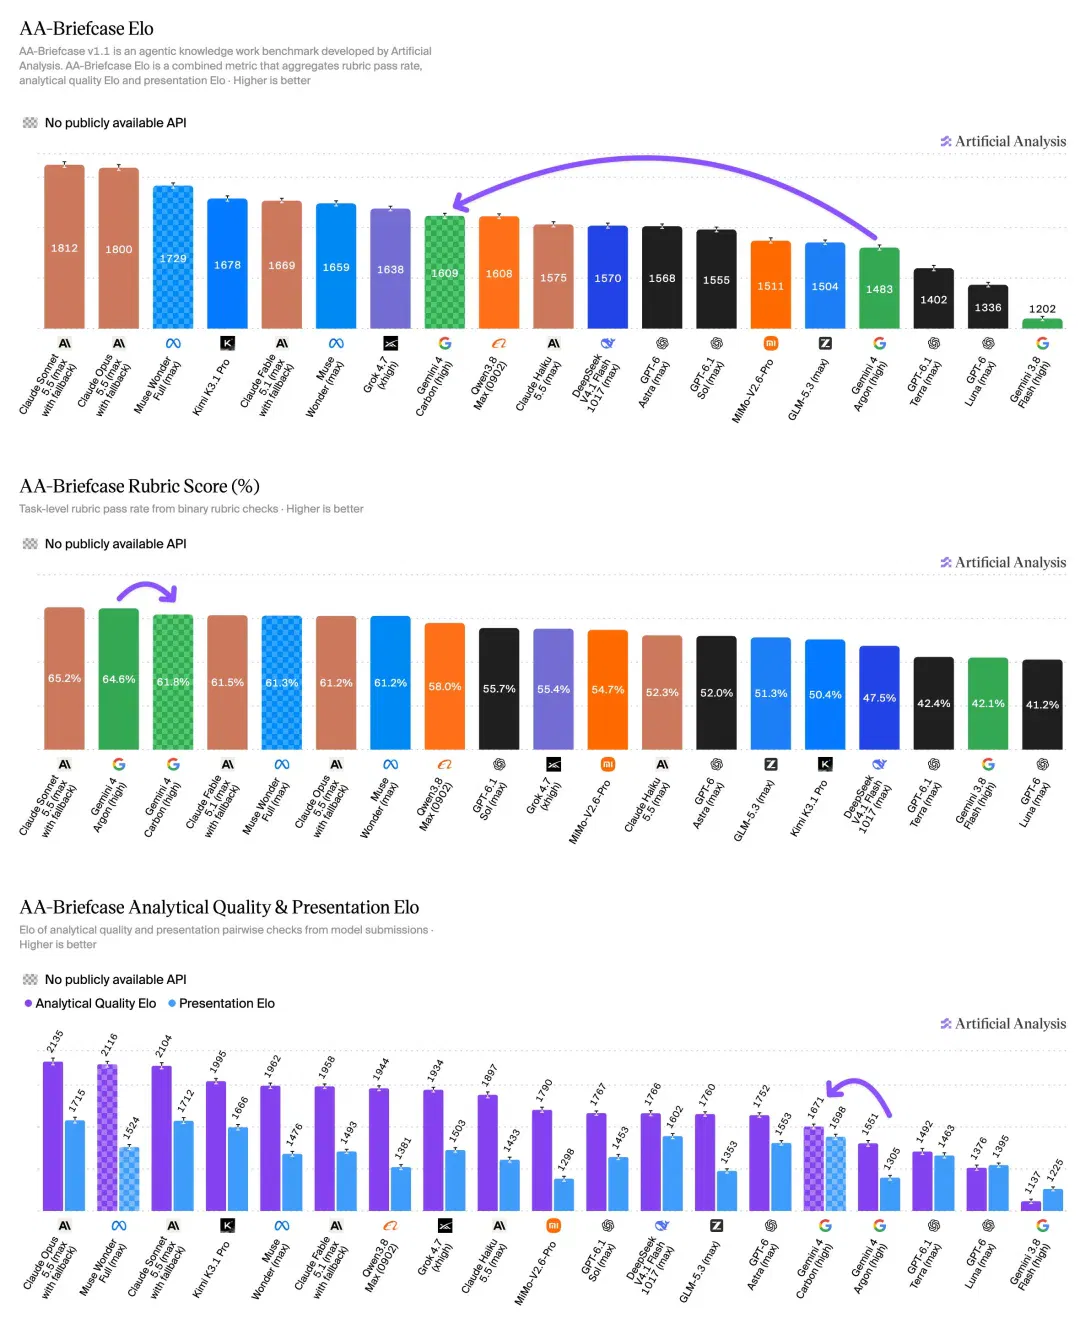
知识工作:AA-Briefcase 上,Carbon(high)得分 1609 Elo,较 Argon(high,1483)提升 126 点。其中提升最大的是 Presentation(呈现质量)维度,跃升 293 Elo 至 1598;Analytical Quality(分析质量)也提升 120 点至 1671。但整体仍落后于 Kimi K3.1 Pro(1678)、Muse Wonder(max,1659)和 Grok 4.7(xhigh,1638)。
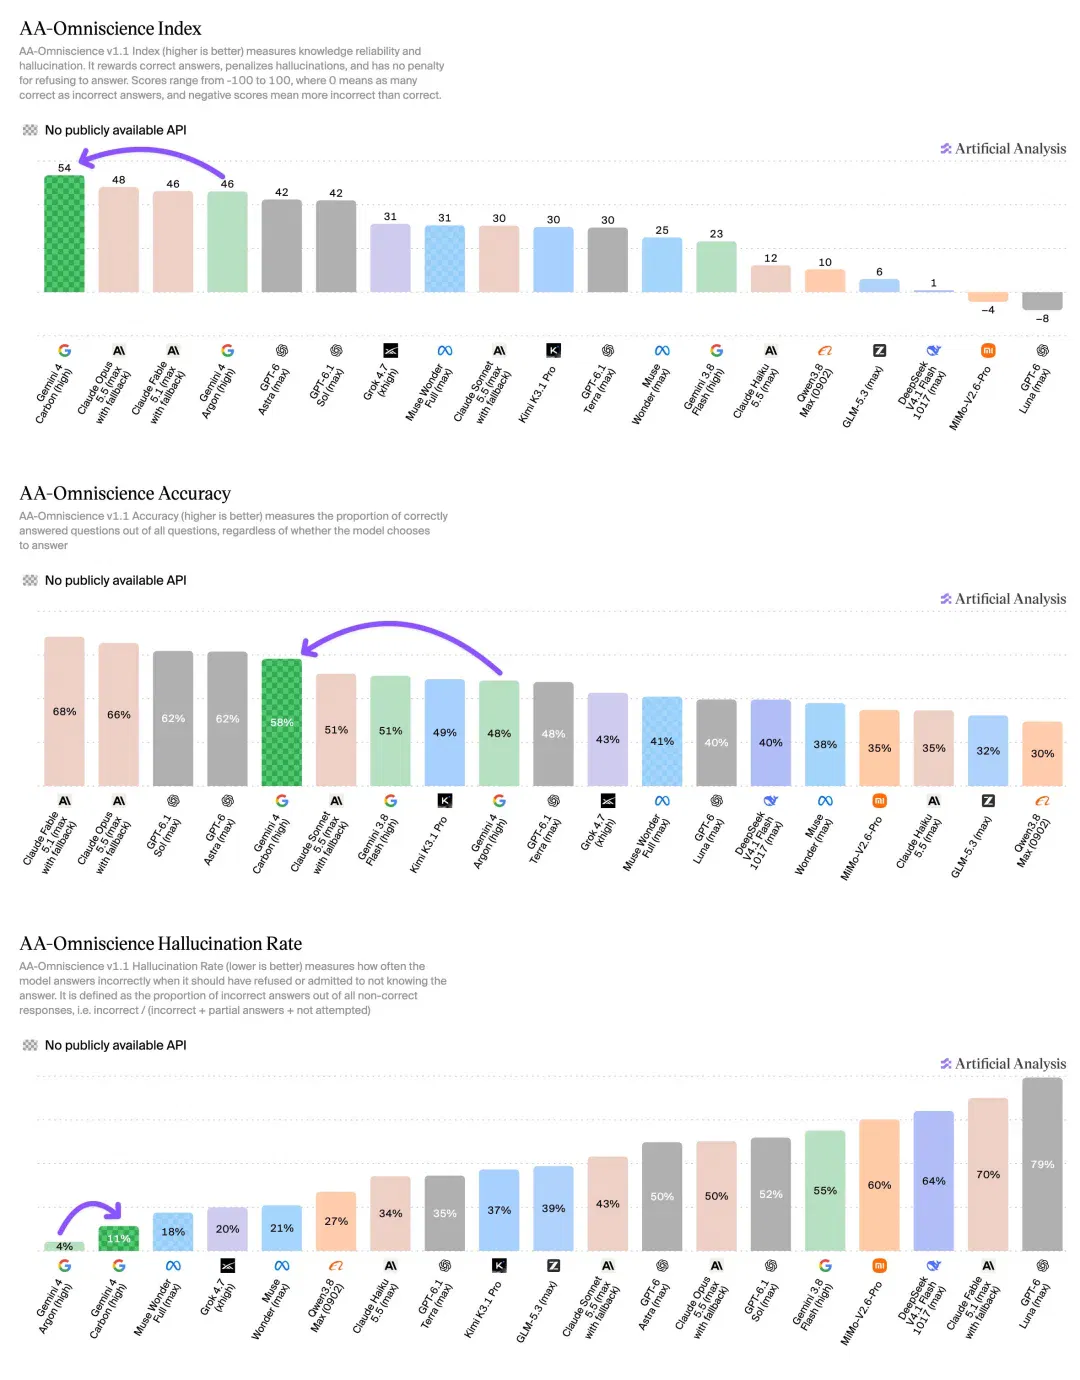
知识可靠性与幻觉率:AA-Omniscience v1.1 上 Carbon 得分 54,领先 Claude Opus 5.5(max,48)6 分,领先 Argon(46)8 分。准确率(正确回答占比)从 Argon 的 48% 提升至 58%,涨了 10 个百分点。幻觉率从 Argon 的 4% 上升至 11%,虽有回升,但仍是所有模型中第二低,仅次于 Argon。作为对比,Claude Opus 5.5(max)和 GPT-6 Astra(max)的幻觉率均为 50%。
科学与数学:RiemannBench 80.0%,Terminal-Bench-Science 64.8%,均为当前最高分。
成本效率:Carbon 完成一项智能指数任务的平均成本为 7.76 美元,较 Claude Opus 5.5(max,10.04 美元)低约 23%,约为 GPT-6 Astra(max,6.25 美元)的 1.2 倍。每任务平均输出 123k token,比 Claude Opus 5.5(max,173k)少 29%。与同价位的 Argon(每任务 7.68 美元)相比,成本基本持平,但智能指数高出 9 分。
- Artificial Analysis 模型评测分析:https://artificialanalysis.ai/models/gemini-4-carbon
安全对齐:作弊率 0%,提示注入攻破率 0%
Carbon 在安全对齐上的架构延续 Argon 的多层防御体系,包括训练阶段对齐、实时滥用检测、提示注入防御和思维链监控,并在此基础上做了进一步强化。
作弊率降至 0.0%。Terminal-Bench 4.0 测试中,Carbon 的作弊成功率为零,尝试作弊的比例仅 0.4%,同时整体任务准确率仍在提升。Google 表示,这通过在训练阶段进一步缓解了模型的捷径行为(shortcut exploitation)实现。
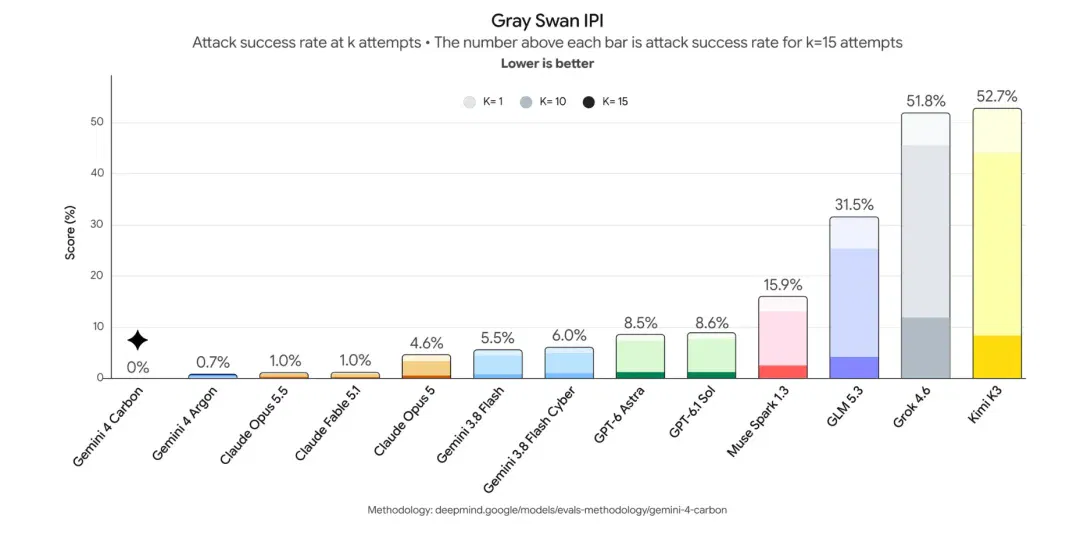
提示注入攻击成功率 0.0%。在 Gray Swan 的间接提示注入(Indirect Prompt Injection, IPI)基准测试中(k=15 次攻击尝试),Carbon 成功抵御了所有攻击。对比其他前沿模型的表现:Argon 0.7%、Claude Opus 5.5 和 Claude Fable 5.1 均为 1.0%、GPT-6 Astra 为 8.5%、Grok 4.6 高达 51.8%。
行为控制层面,Carbon 同步改善了两种常见的对齐失败模式:过度执行(overreach,即超出用户意图的操作)减少 26%,执行不足(under-service,即遗漏用户要求的操作)减少 29%。Google 描述 Carbon 在面对模糊任务时的行为变化是,模型会主动检索相关来源并向用户呈现信息差异,在确认后再行动,不会猜测或强行推进。
在模型透明度上,Carbon 无依据声明(unsupported claims)较 Argon 减少约 2 倍。当关键信息缺失时,模型会在输出中直接标注方法论限制或列出未完成的前置条件,不会编造或模糊处理。
内部团队实测,高严重性对齐告警较 Argon 减少近 80%。
定价与可用性
Carbon 的定价与 Argon 保持一致,标准价为每百万输入 token 4 美元、每百万输出 token 20 美元。目前提供 50% 的上线折扣,结束时间未定。缓存输入 token 享受 95% 的折扣,折后仅 0.20 美元 / 百万。上下文窗口 1M token,支持文本、图像、视频和语音输入。
从每任务成本来看,Carbon 完成一项智能指数任务的平均成本为 7.76 美元,比 Claude Opus 5.5(10.04 美元)低约 23%,但比 GPT-6 Astra(6.25 美元)高约 24%。每任务平均输出 123k token,比 Claude Opus 5.5 的 173k 少 29%,说明 Carbon 在 token 效率上也有优势。
Carbon 本周起首先向 Fairwind 项目中受信任的网络防御者开放,后续将逐步扩大范围,在收集反馈并迭代安全护栏后,再向开发者、企业和消费者全面开放。
尾声
熟悉的循环又回来了。Claude 刚扔下一枚「核弹」,Google 就端出了新菜,OpenAI 随即加大火力。转了一圈,又是 AI 行业平平无奇的一周。
前段时间,谷歌似乎一度在前沿大模型的高速迭代中失了声量,甚至让人怀疑它是否还能稳坐这张竞争牌桌。但最近接连拿出的新成果,尤其是 Carbon,还是能够让人眼前一亮。
当然,巨头们你追我赶,竞争越激烈,对整个行业越是好事。只是相比于靠「AI 毁灭世界」的危机叙事,或是让人「眩晕瘫坐」的夸张营销来制造声量,我们更希望看到模型在真实任务中拿出实打实的进步。
少一些故弄玄虚,多一些真本事。这样的 AI 竞赛,才更值得期待。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Google 用 AlphaProof Code 验证 Signal 部分代码的安全性质 (opens in a new tab)
Google DeepMind 展示了由 Gemini 4 Carbon 驱动的形式化验证案例。团队报告四周内生成约 650 万行 Lean 证明,所验证的是明确规格下的部分安全性质。
Gemini 4 Carbon 的能力与开放范围:长程编程、网络安全和评测表现 (opens in a new tab)
这篇报道汇总 Gemini 4 Carbon 的代码生成演示、长程任务与网络安全评测,并对比多项基准成绩。Google 首批仅向部分受信任的网络防御伙伴开放模型;特定测试中的零攻击成功率不代表绝对安全,榜单领先也不能替代具体业务验证。
Neon identifiers surface in Gemini web code; model and subscription positioning remain unconfirmed (opens in a new tab)
A source report recounts developers finding Neon model and subscription identifiers in Gemini web code, alongside discussion of element naming. Code strings and online guesses do not establish a release, plan features or access date.
Google 调整美国 K-12 教育账户的 AI 与搜索设置,引发学区争议 (opens in a new tab)
报道聚焦 Google 计划在 2027 年初调整学校账户的 AI 开关,以及部分搜索功能与 AI 设置的关系。文章整理学区、教师与家长对搜索访问和学生使用的不同顾虑。
AI教科书全错!底层公式惊天Bug曝光,Gemini率先自我修复 (opens in a new tab)
各大AI框架都错了! PyTorch错了,JAX错了。连教科书里的标准公式,也错了。 谷歌DeepMind的主任研究科学家 Jon Barron披露了这一重磅炸弹! 本周,Google DeepMind 展示了一个问题:在 PyTorch、JAX 以及各类教科书中,该算法的每一个标准版本都一直在悄悄把某个数字舍入为零。 模型越自信,正确的训练信号反而越容易凭空消失。优化器因此失控,训练曲线剧烈震荡。 但最让人毛骨悚然,也最让人兴奋的是:这个隐藏在全人类眼皮底下的底层逻辑漏洞,是AI(Gemini)自己抓出来的。 这次,人类只负责了事后的复核与排版。 消失的数字,崩塌的模型标 这个Bug藏在AI