
Know AI. See What’s Next.




Slide 1 of 5: 姜宇辉的AI分身:知识助手与“另一个自己”之间
Latest news
零一万物获杭州国资数亿元投资,总部将落地临平 (opens in a new tab)
零一万物宣布与杭州市及临平区达成合作,由市、区两级国资合计投资数亿元,并将总部落地临平、打造产业AI转型基地。
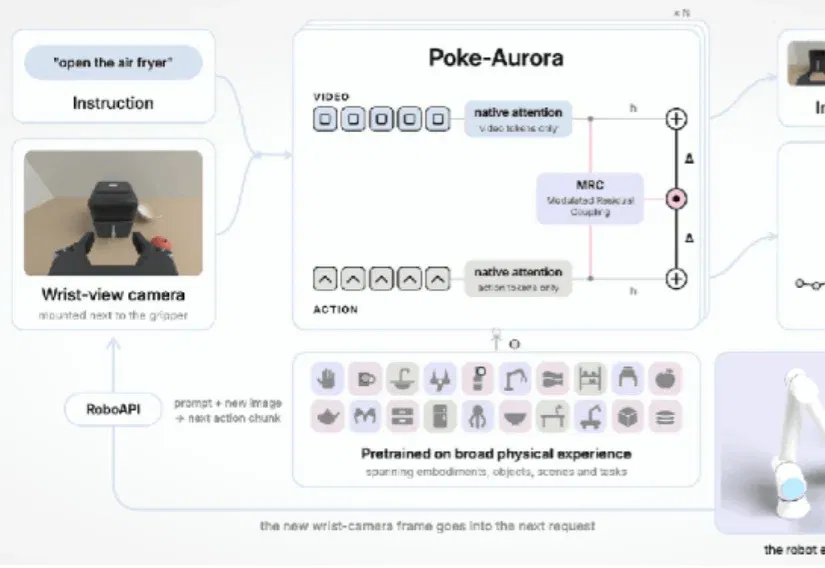
破壳机器人发布 RoboAPI,开放适配机械臂上的模型调用 (opens in a new tab)
RoboAPI 将机器人的观测、状态与语言指令连接到动作预测,支撑模型为 Poke-Aurora。破壳展示了自建评测和实验室试用,并邀请外部开发者检验泛化表现;使用仍有机械臂构型与接入条件,目前定位非商业化应用,而非任意硬件即插即用。
TRAE 宝内测体验:跨项目上下文、任务调度与远程跟进 (opens in a new tab)
十字路口团队以像素视频特效素材库为例,体验 TRAE 宝如何连接调研、开发和成果整理,并通过微信或飞书跟进任务。文章重点是跨项目上下文与统一管理入口;准确检索历史、协调多个任务和保持本地电脑开机,仍是实际使用中的前提与限制。
百灵开源 Ling-3.1-flash-1019 与 Base,面向长上下文和智能体任务 (opens in a new tab)
蚂蚁百灵同步开放进一步后训练的 1019 版与基础权重 Base,前者聚焦复杂推理和多步骤工作流,后者供开发者继续训练。报道分别梳理两类模型的评测、混合线性 MoE 架构及部署方式,也指出更高任务成绩伴随着更多 Token 消耗。
Buddy One 上线:腾讯尝试连接 WorkBuddy 与文档、会议等产品 (opens in a new tab)
作者介绍 Buddy One ID 与付费 VIP 的不同定位:前者连接腾讯产品账号与积分,后者提供组合会员权益。其体验显示,首次关联后的资料访问与可执行写入仍有区别,进一步操作需要连接器;关于统一任务入口的判断属于作者对产品走向的分析。
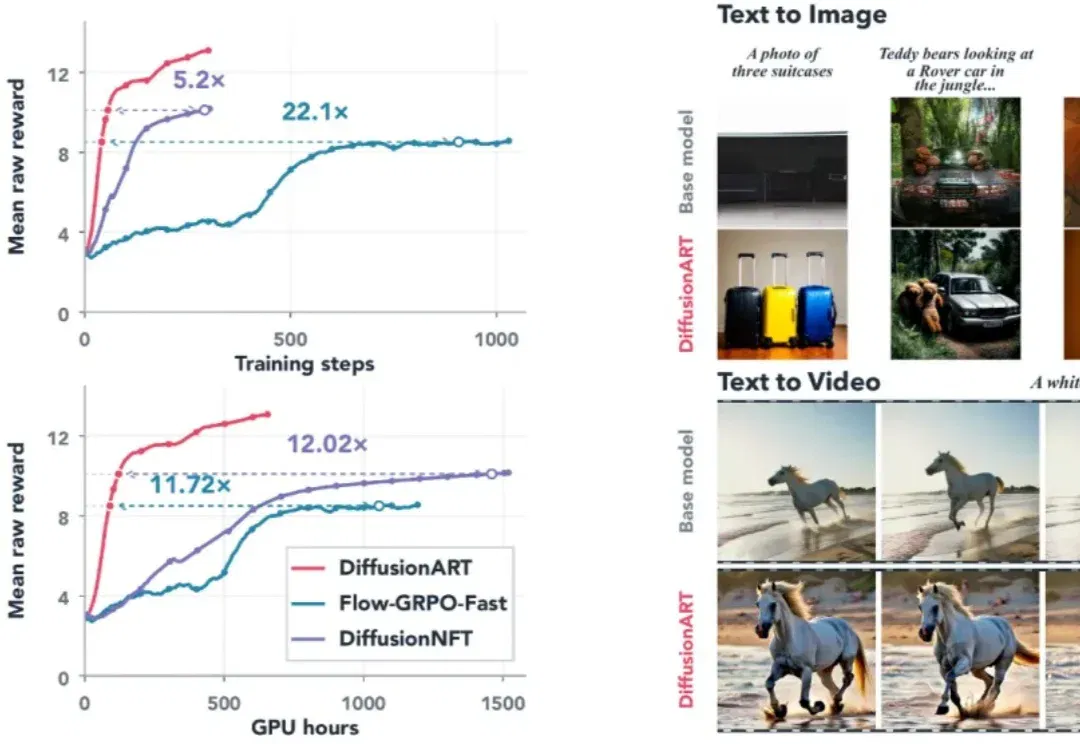
DiffusionART 从梯度机制入手,改善图像与视频扩散模型后训练效率 (opens in a new tab)
DiffusionART 先聚合奖励方向,再用两次更新和信赖域限制处理策略漂移,支持确定性采样与不可微奖励。团队在多种图像、视频模型上报告效率与稳定性收益;十倍以上加速指特定视频实验达到指定奖励水平的对照,并非所有训练任务都等幅提速。
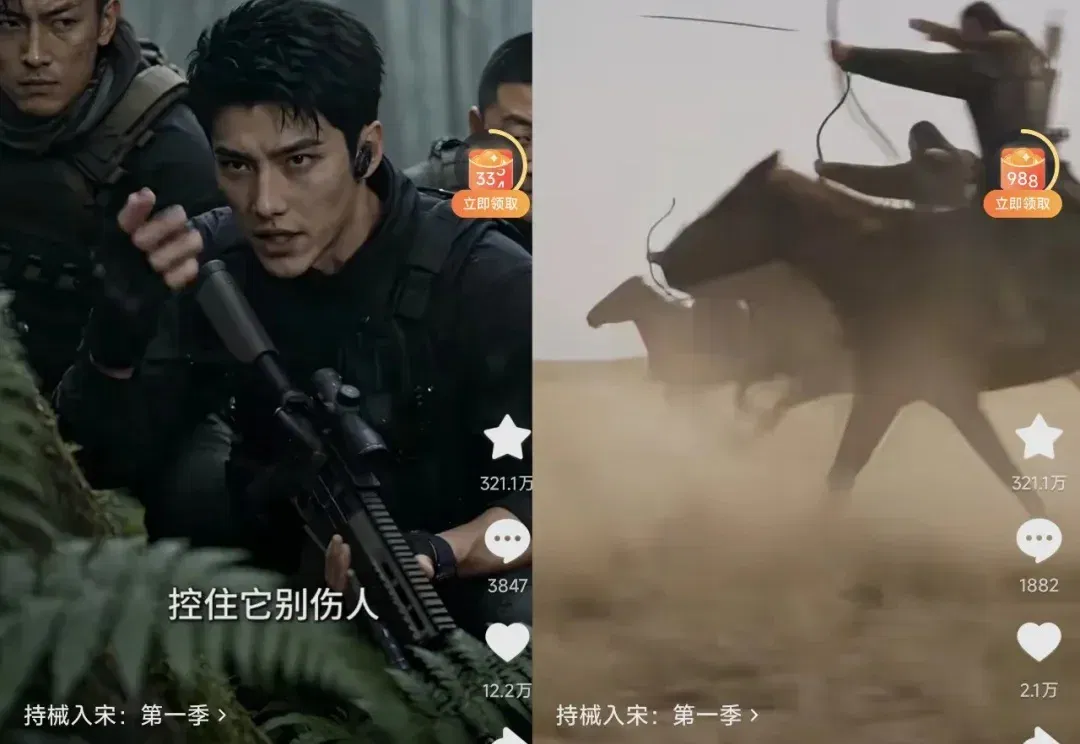
从《持械入宋》走红,看 AI 历史短剧如何走向细分题材 (opens in a new tab)
新榜以《持械入宋》等作品为例,分析 AI 历史短剧如何结合网文供给、场景生成与角色塑造吸引观众,也讨论爽感、历史逻辑和改编审核的矛盾。播放与收藏数据来自报道所引平台或发布账号,题材走红并不意味着所有创作者都能获得相同收益。
矩侨工业获亿元 A 轮融资,继续拓展织物触觉传感与数据采集 (opens in a new tab)
据 Z Potentials 报道,矩侨工业完成蚂蚁集团领投的亿元 A 轮融资,资金将用于织物电子皮肤量产、触觉技术研发和场景拓展。公司从柔性纤维出发,将压力感知延伸至手套、机器人皮肤和家居康养产品;交付与性能数据采用原报道及企业口径。
冥想、扩散与大模型的另一条路丨对谈西湖心辰创始人蓝振忠 (opens in a new tab)
西湖心辰创始人蓝振忠解释为何押注扩散语言模型:利用并行生成和多条思维链,在响应速度与交互质量之间寻找新取舍。访谈也谈到数据利用、分块扩散、强化学习和全模态 Agent 路线,相关效果来自团队实验与业务场景,规模化能力仍需逐项验证。
空间智能,究竟需要什么样的数据?访谈映界科技、港城副教授马辰 (opens in a new tab)
映界科技数据方向研究者、香港城市大学副教授马辰讨论空间智能的数据难题:连续观测如何关联对象、保留状态与不确定性,评测又如何反哺采集和训练。访谈强调数据价值取决于任务、模型和预算,单一总分或更多视频并不自动带来可靠的空间理解。
启元机器人的快慢脑路线:通用模型做规划,VLA 与数据支撑执行 (opens in a new tab)
启元团队介绍其分层认知与动作执行路线,以及针对模型薄弱环节采集示范的 Hil-UMI 方法。报道把已量产的 Q1、T1 与仍在迭代的家务机器人区分开,并讨论数据规模、训练效率、制造良率和家庭体验门槛;相关商业目标仍是团队规划。
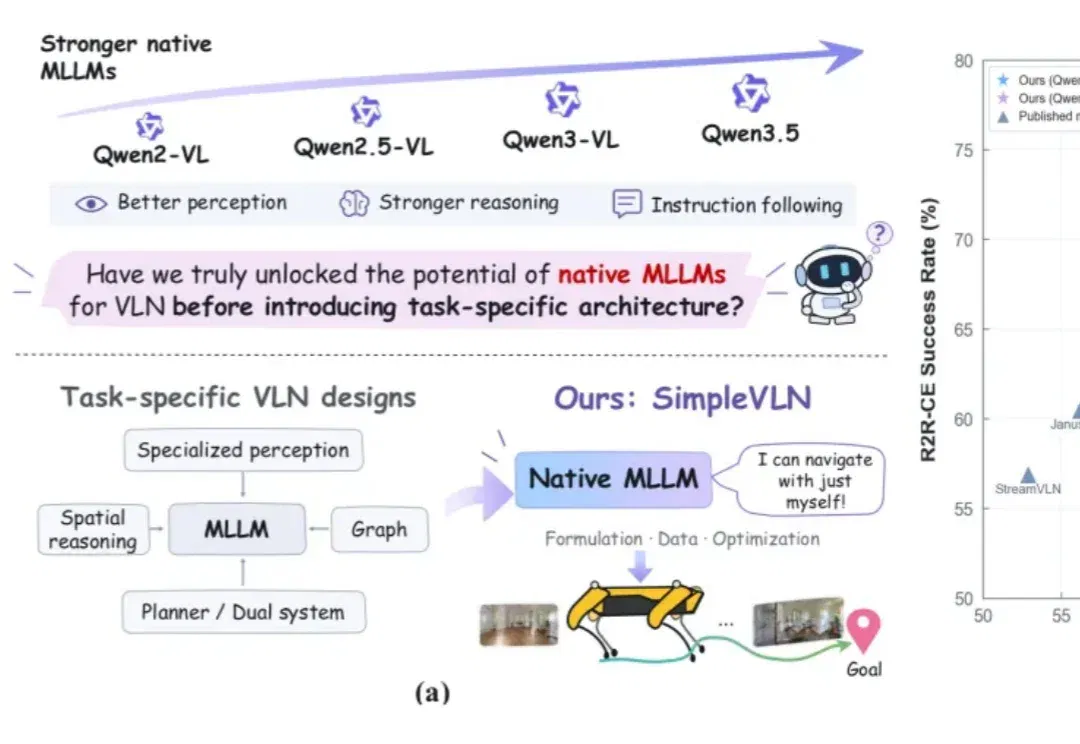
SimpleVLN 不改模型主干,以观测筛选和三阶段训练改善导航 (opens in a new tab)
SimpleVLN 通过历史画面筛选、动作块输出,以及专家示范、DAgger 和强化学习组成的训练流程,挖掘原生多模态模型的导航能力。团队在连续导航基准上报告提升,并展示四足机器人演示;仿真成功率与真实环境的稳定泛化仍应分别验证。
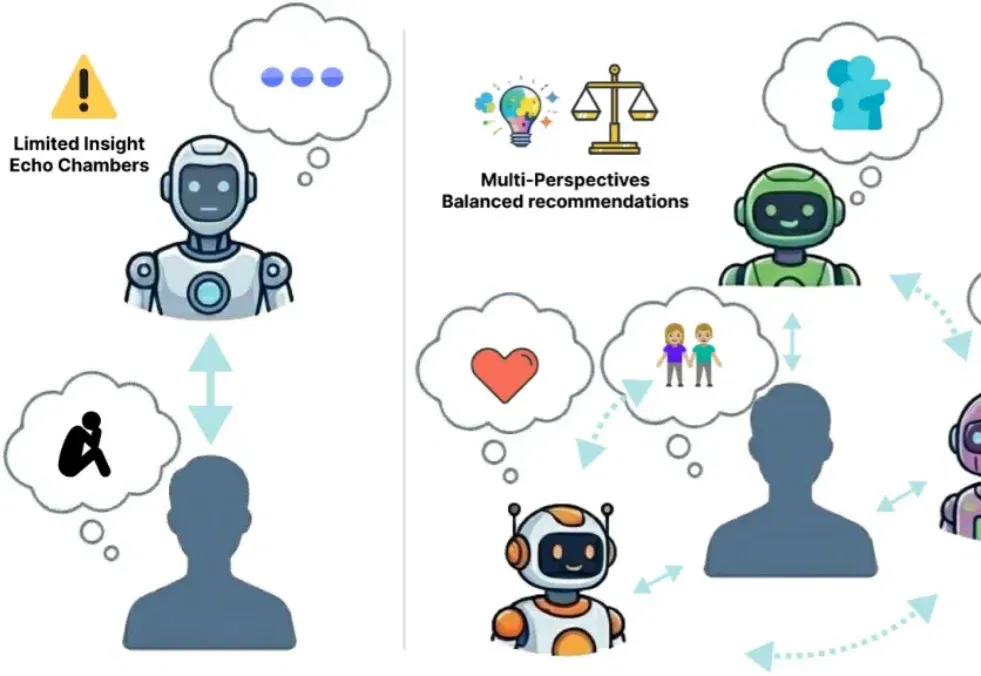
EMNLP 2026 Main | AI 群聊怎样多元化?佐治亚理工和麻省理工提出 MASCOT (opens in a new tab)
MASCOT 将多智能体群聊拆成角色行为对齐与主持人协调两个训练阶段,减少多个角色反复附和、缺少新贡献的问题。研究在情感支持与会议讨论数据上结合模型评分和人工盲评验证效果,现有证据主要来自英语和受控情境,长期互动仍待检验。
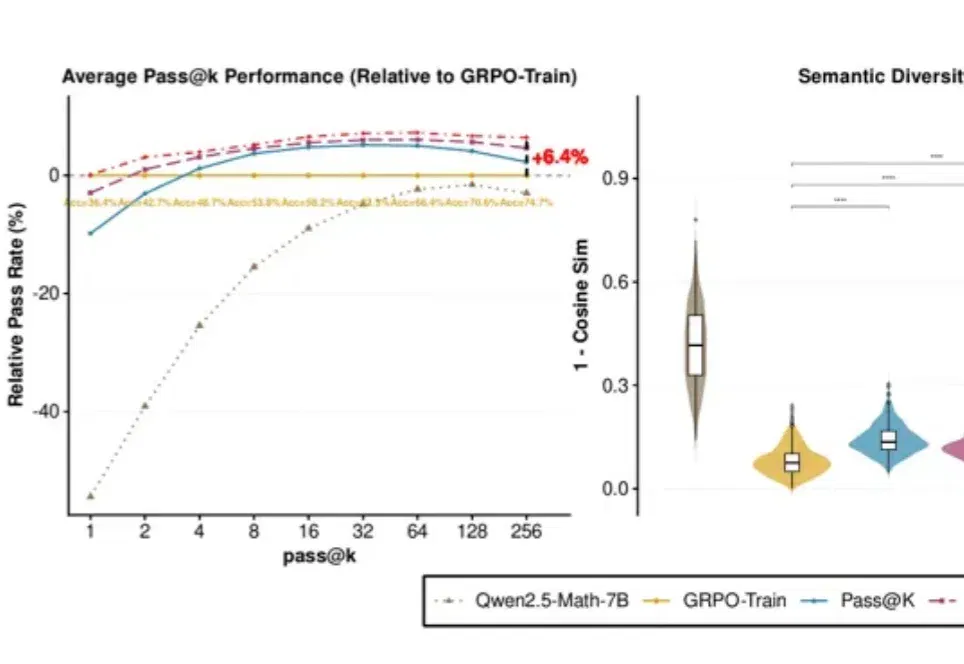
PSN-RLVR 用参数扰动探索解题路线,改善多次采样表现 (opens in a new tab)
PSN-RLVR 在生成前对部分模型参数施加小幅扰动,并让同一扰动贯穿整段推理,再通过重要性采样与自适应调度衔接正常训练。实验中多次尝试的成功率提升较明显,单次作答收益则需另看;有限采样发现新路线,并不能证明原模型永远不会产生同类解法。
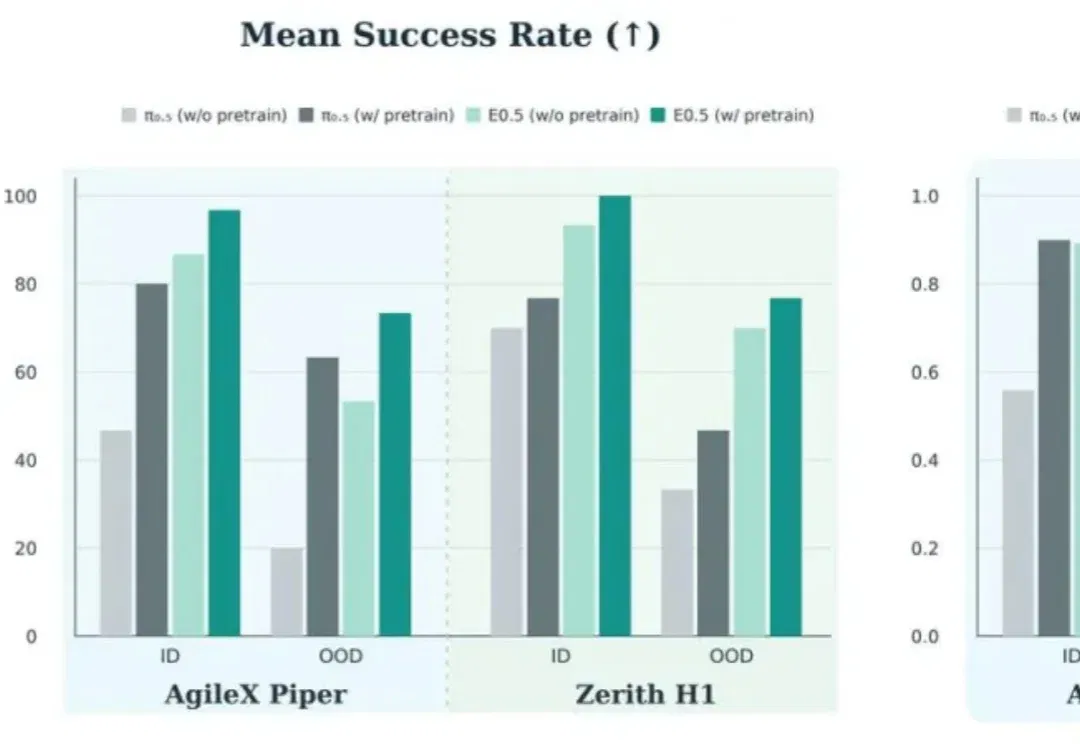
拓元智慧开源 E0.5,用未来三维几何预测连接机器人动作学习 (opens in a new tab)
E0.5 以三维基础模型为骨干,将未来几何状态与动作序列联合训练,并在双臂与人形机器人任务上测试操作表现。团队分别报告了有无大规模机器人预训练、分布内与分布外的结果;这些对照支持特定任务收益,不能直接代表任意真实场景的成功率。
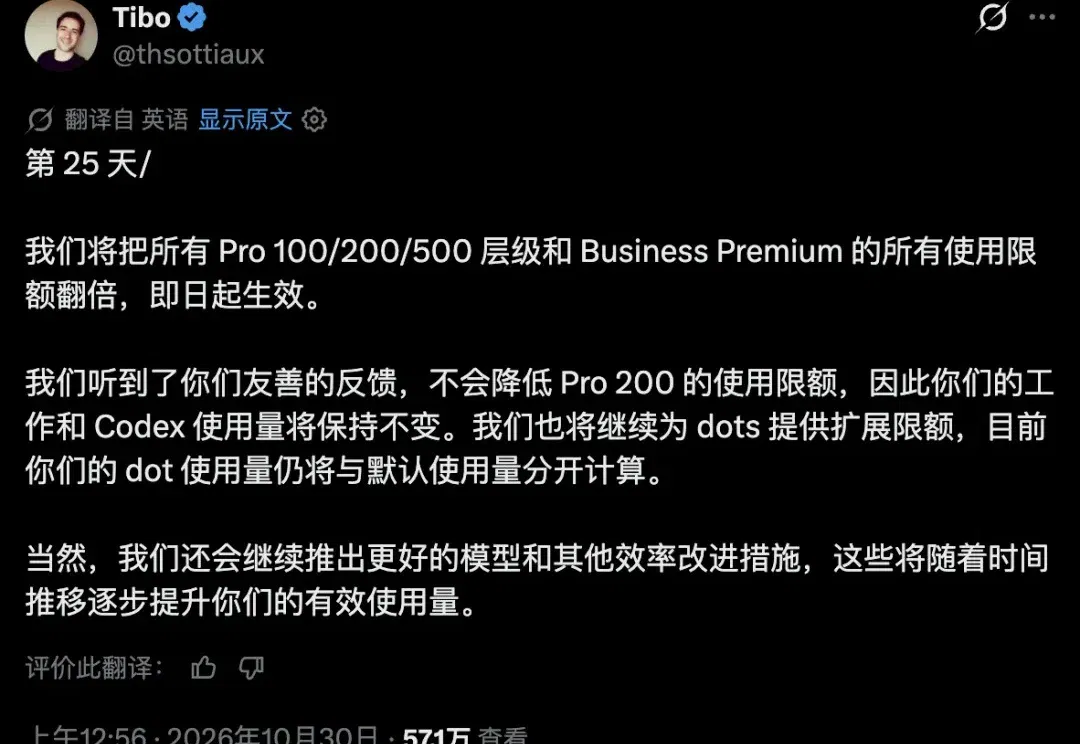
ChatGPT Pro 调整 Work 与 Codex 额度:哪些用户翻倍,哪些保持不变 (opens in a new tab)
OpenAI 提高 Pro 的 Work 与 Codex 额度:Pro 100、500 翻倍,Pro 200 原本较低的额度翻倍并对齐高额度,已享高额度的用户保持不变。文章据此讨论用量限制与开发者工作流,额度增加并不等于不限量,也不保证完成任务数同比增加。
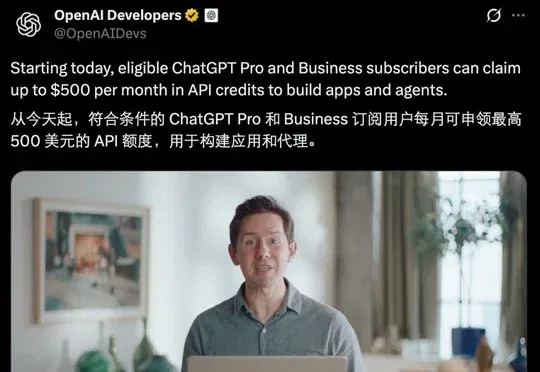
ChatGPT Pro 与 Business 新增 API 额度福利:谁能领、有哪些限制 (opens in a new tab)
符合条件的 ChatGPT Pro 和 Business 订阅可激活 API 额度福利,每计费周期最高 500 美元,首次金额按剩余时长折算。额度到期不结转,也不会提高 ChatGPT 或登录式 Codex 的使用上限;实际资格与发放以账单页面和当期政策为准。
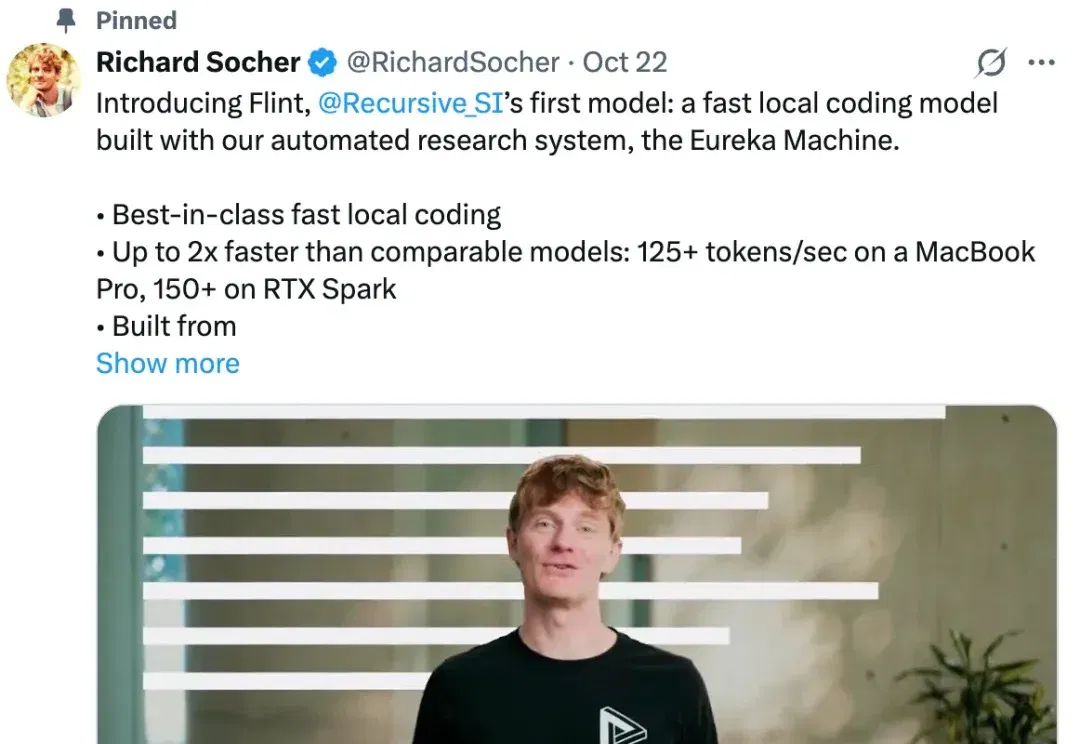
超衍智能发布 Apex-35B-V1.0,探索 AI 参与模型研发 (opens in a new tab)
Apex-35B-V1.0 基于 Qwen3.6-35B-A3B 进行中训练和后训练,面向编程、智能体及研究任务。超衍智能介绍其自动化研究系统如何参与数据构造、训练方案和算力优化,并公布多项评测与仿真案例;这些团队报告的结果仍需要结合评测设置和独立复现判断。
Musee 探索 AI 互动娱乐:从角色故事、互动短剧到用户创作 (opens in a new tab)
游戏公司豹亮科技围绕 Musee 布局 AI 互动内容:InPlay 结合角色对话、分支剧情和作品创作,InStory 更贴近竖屏短剧,另有桌面角色扮演与素材制作工具。报道关注游戏团队如何把节奏、反馈和参与感带入生成式内容,历史游戏业务规模不代表这些新产品已有同等收入。
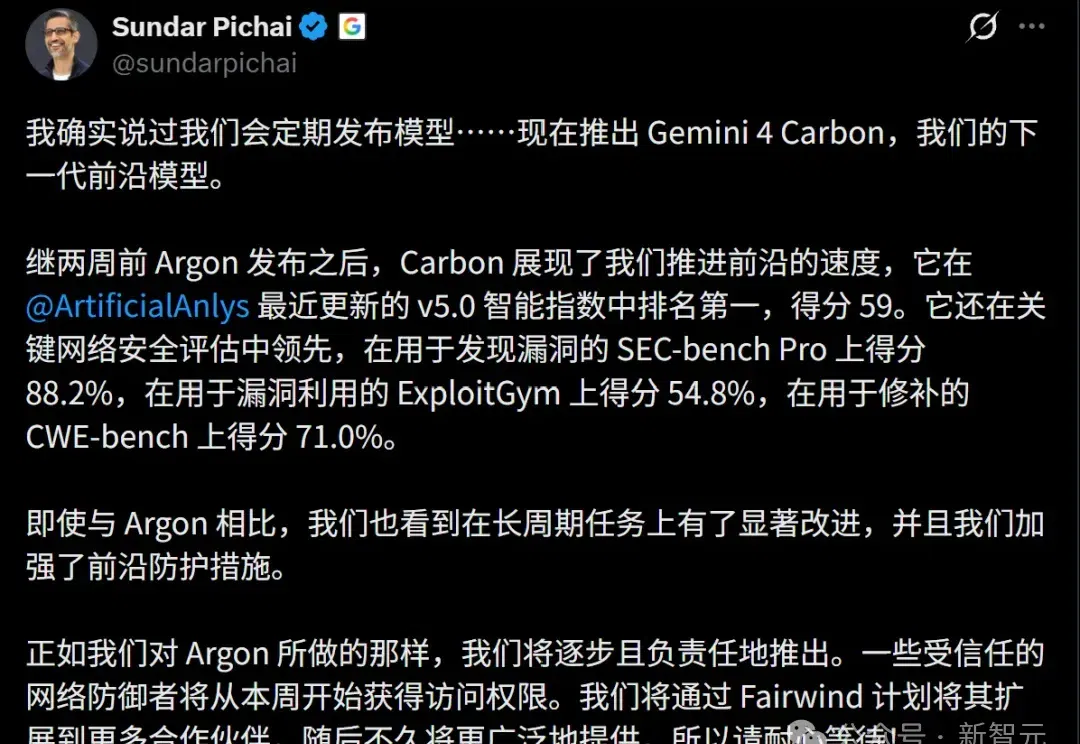
Gemini 4 Carbon 的能力与开放范围:长程编程、网络安全和评测表现 (opens in a new tab)
这篇报道汇总 Gemini 4 Carbon 的代码生成演示、长程任务与网络安全评测,并对比多项基准成绩。Google 首批仅向部分受信任的网络防御伙伴开放模型;特定测试中的零攻击成功率不代表绝对安全,榜单领先也不能替代具体业务验证。