不止动起来:SentiAvatar重新定义3D数字人动作生成范式(在新窗口打开)
当你和 3D 数字人对话时,有没有遇到过这种诡异时刻:它的嘴在动,但表情依旧僵硬;手在挥舞,但和说话内容完全脱节;更糟的是,那种外表像真人但动作不自然的违和感,让人瞬间陷入 “恐怖谷”。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
当你和 3D 数字人对话时,有没有遇到过这种诡异时刻:它的嘴在动,但表情依旧僵硬;手在挥舞,但和说话内容完全脱节;更糟的是,那种外表像真人但动作不自然的违和感,让人瞬间陷入 “恐怖谷”。
Gemma4 31B的发布,在开源模型社区引发了巨大的关注。面对这款由谷歌DeepMind于2026年4月2日 推出的重磅模型,很多技术团队和本地部署玩家都在问同一个问题:Gemma4的出现,到底是在开辟一条新的本地部署路线,还是只是给高端玩家多了一个可选项?我们到底需不需要把现有的Qwen3.5 27B工作流整体迁移过去?
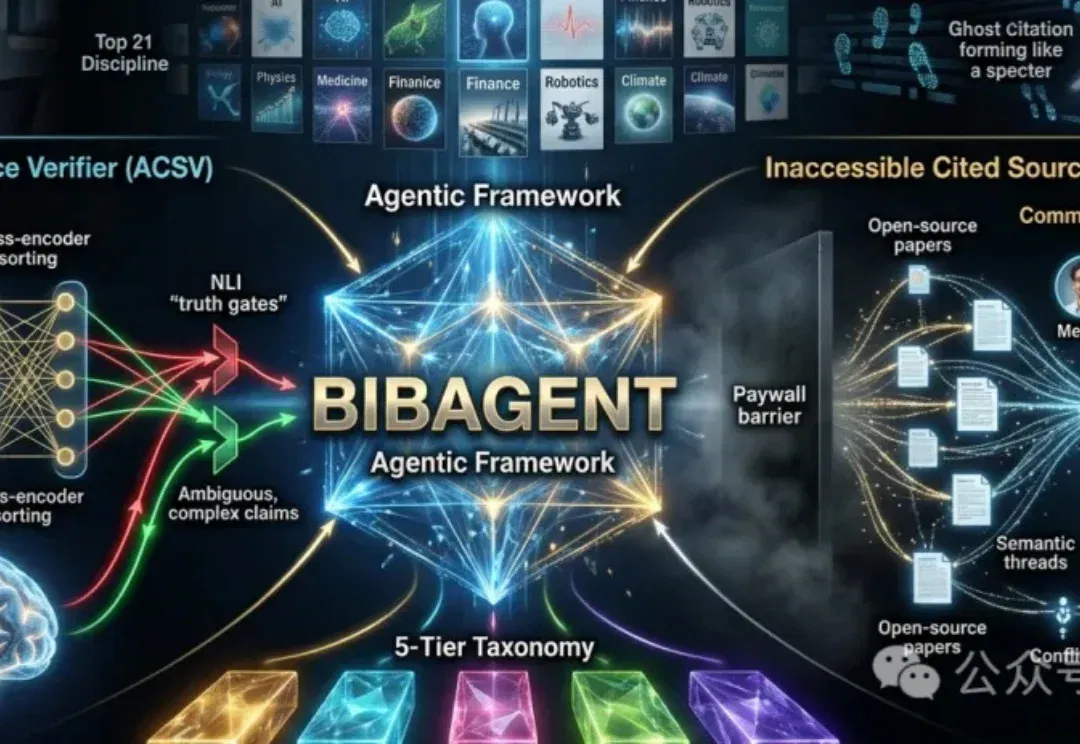
大模型正在批量生成「看起来很像真的」学术论述,但这些论述背后的引用,真的成立吗?更关键的是:当被引论文被付费墙锁住、原文根本读不到时,自动化核验是否就注定失效?
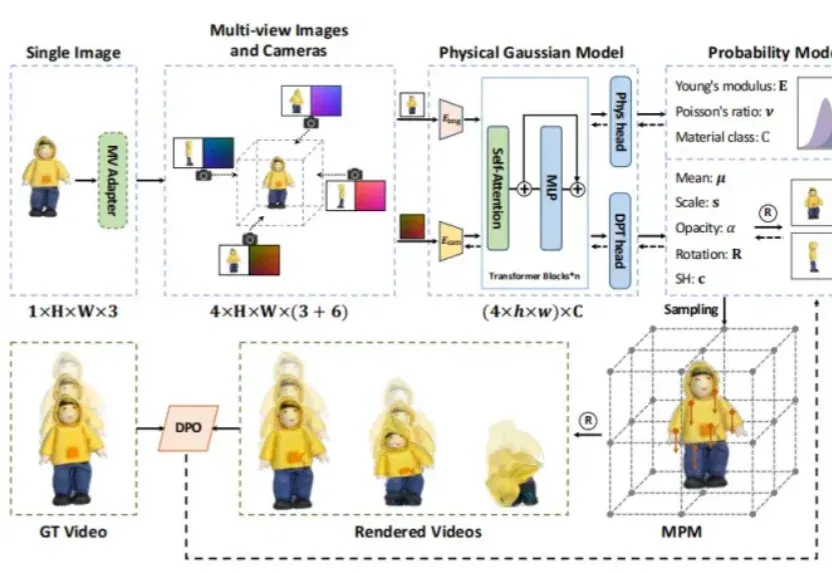
让静态的图片变成三维物体并动起来已经不算新鲜,但如果让图片不仅动起来,还能完美遵循现实世界的物理规律(比如蛋糕的Q弹、沙堆的散落、石雕的坚硬)呢?
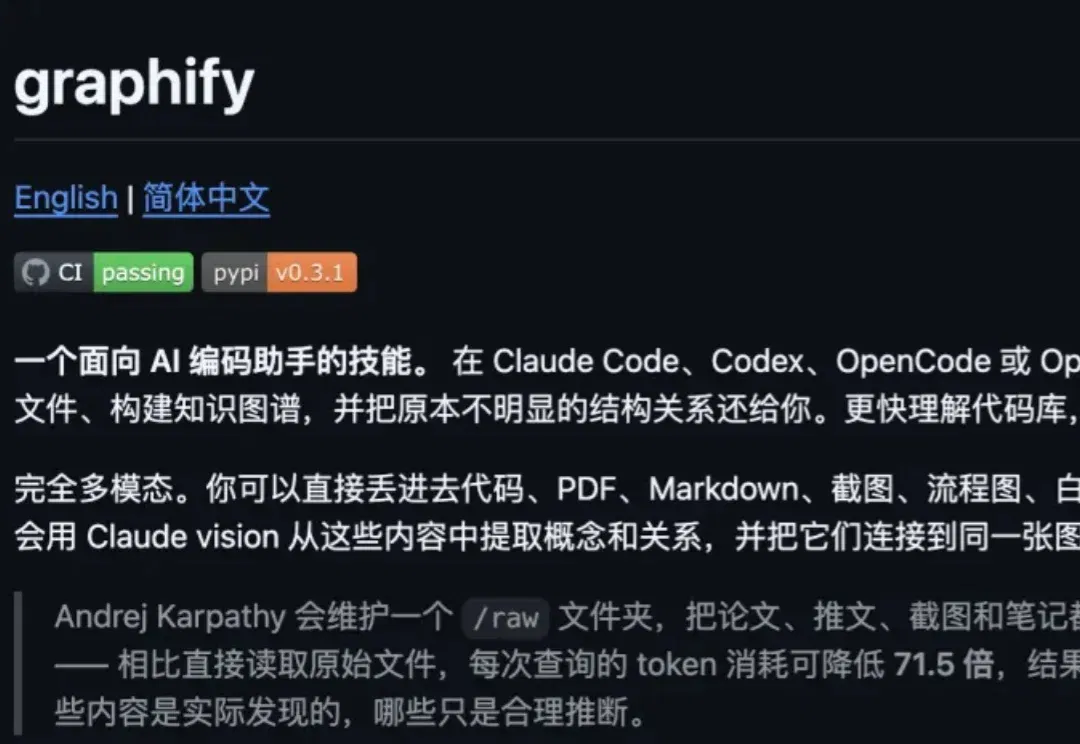
AI圈的节奏已经快到让人产生幻觉了。 Karpathy分享的个人知识库爆火出圈,48小时就有人拿着完全体送货上门。 Graphify,一款零配置、全模态、本地跑、还特能省token的知识图谱工具,GitHub开源狂揽2k+ Star。 不仅能自动构建可导航知识图谱、自带反向链接和关系溯源,更实现71.5倍token消耗节省,直接把卡神的/raw笔记法进化到了完全体。 万物皆可图谱化 卡神那套爆火的知识库,核心是一套不用复杂向量数据库的轻量化工作流。 靠raw/目录存论文、代码、截图等原始资料,再通过LLM自动生成带交叉引用的Wiki文档,配合定期体检维护,慢慢搭建起一个能持续生长、越用越好用的
LangChain 只换了模型外面的基础设施——同一个模型、同一套权重——就从 TerminalBench 2.0 排行榜 30 名开外直接跳到了第 5 名。另一个独立研究项目让大模型自己优化这层基础设施,达到了 76.4% 的通过率,超过了所有人工设计的方案。
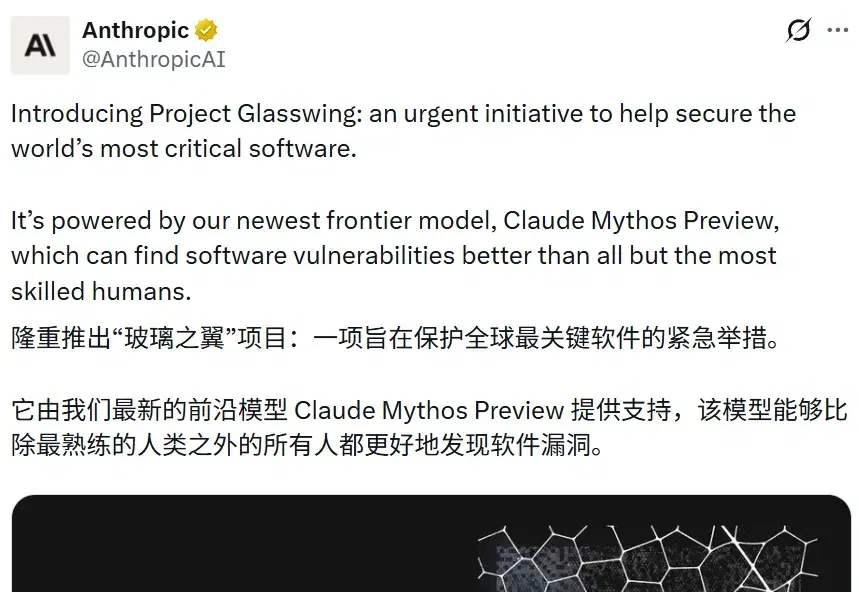
和之前 Claude Code 泄漏的代码揭示的一样,Claude Mythos 它真的来了。今天凌晨,Anthropic 发布了大量关于其新模型 Claude Mythos Preview 的信息(包含一份长达 244 页的系统卡)。同时,Anthropic 还宣布了一个基于此模型的 AI 网络安全项目 Project Glasswing。
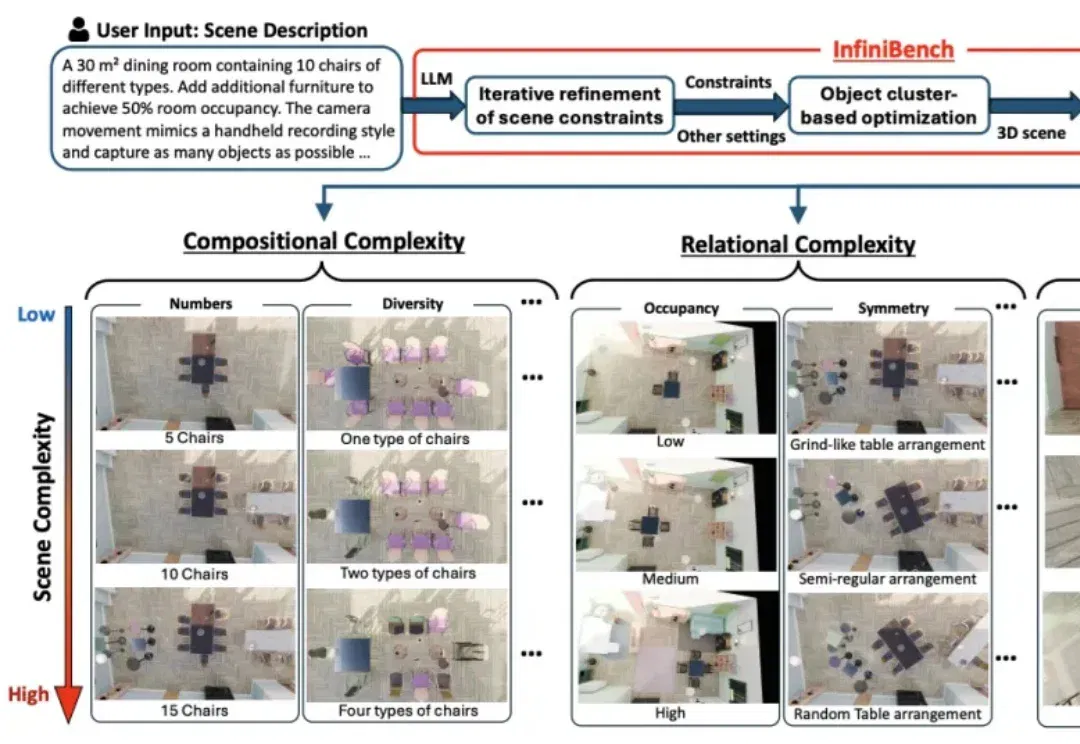
VLM看图像描述头头是道,一遇到3D空间推理就“晕菜”。
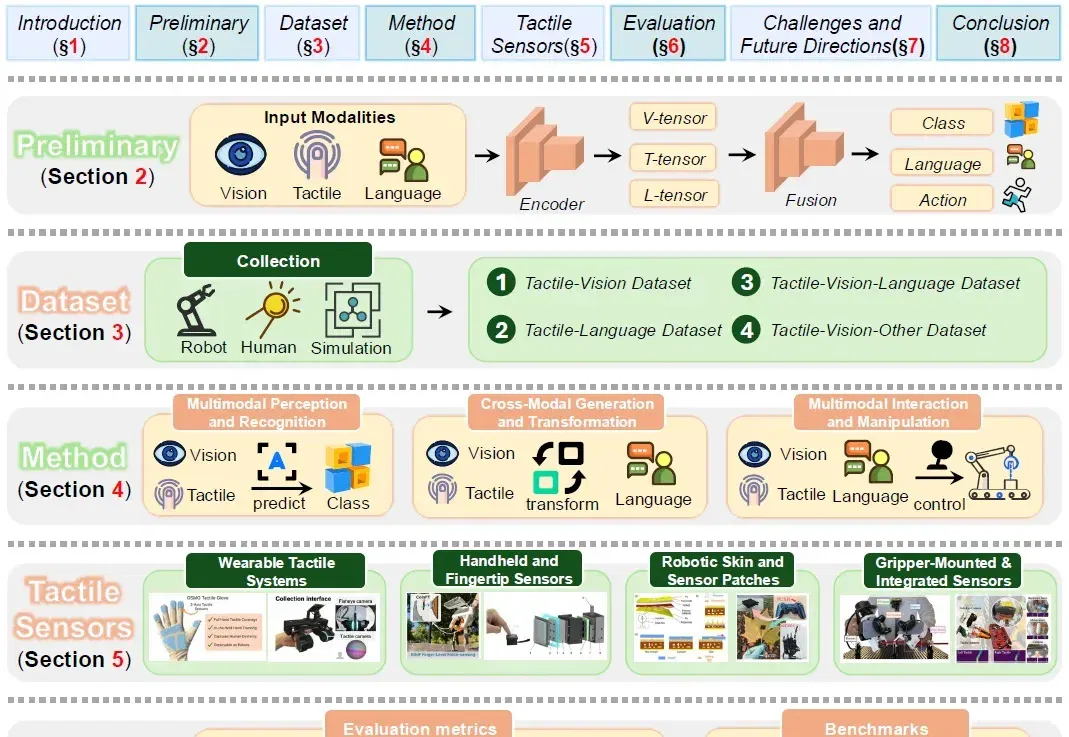
在具身智能的感知拼图中,触觉一直扮演着不可或缺却难以被完美量化的角色。它提供了视觉等远程传感器无法替代的关于接触几何、材料特性和交互动态的直接反馈。
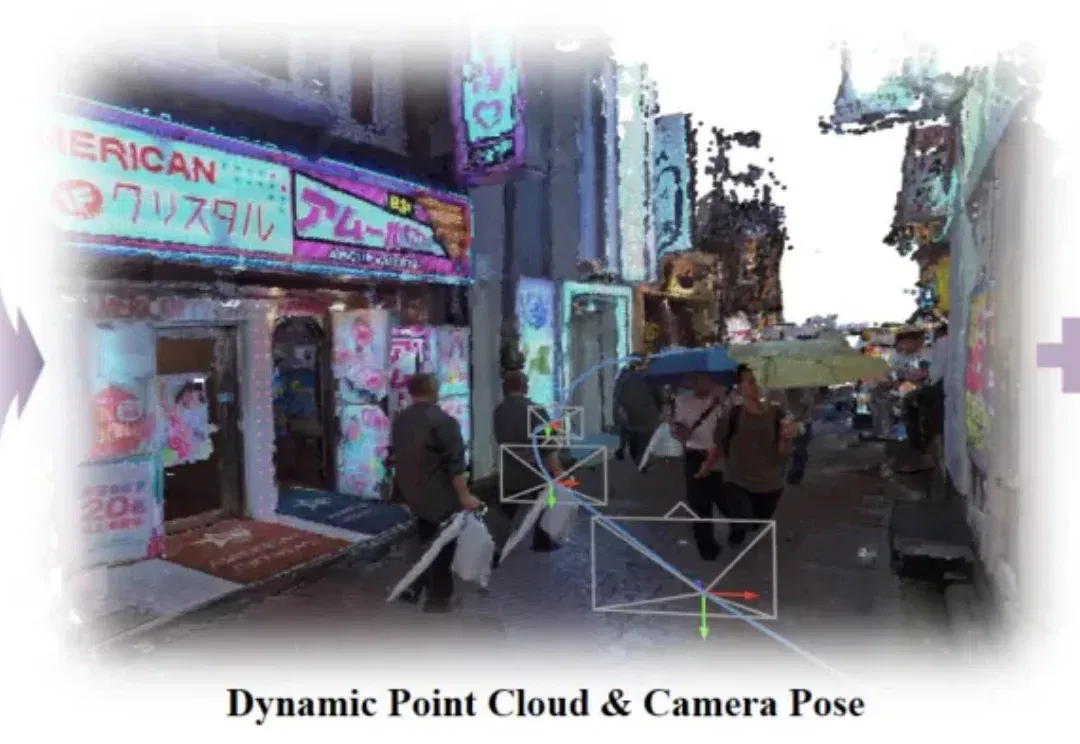
SLAM 在自动驾驶、机器人、AR/VR 乃至具身智能系统中都是至关重要的环节,它决定了算法能否在一个陌生环境中一边“看懂世界”,一边“知道自己在哪”。
Meta SOAR用「剧毒数据」当垫脚石,硬生生把模型从Fail@128的认知黑洞里拽出来,推理能力暴涨9.3%!2026年,这才是最硬核的反杀路线。
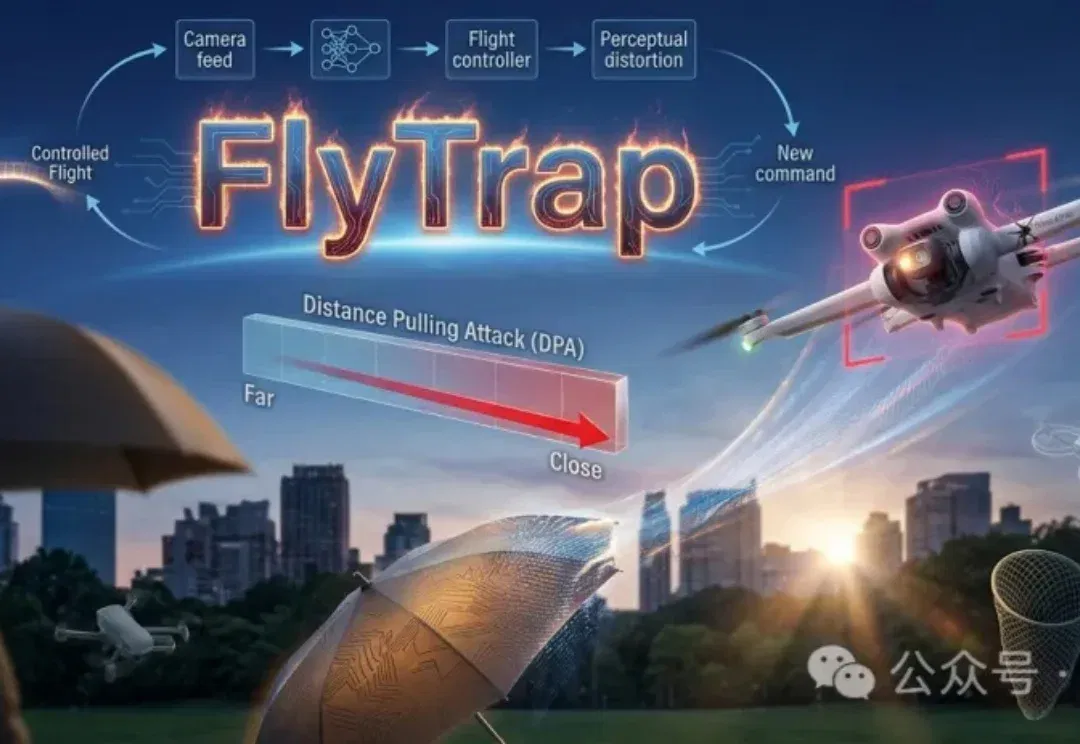
研究者用特制雨伞干扰无人机视觉系统,让其误判目标在远去,从而失控俯冲。FlyTrap攻击无需信号干扰,仅靠物理图案就能欺骗多款商用无人机,实现静默捕获或击毁。实验显示,物理闭环攻击成功率超60%,且对新人物、新场景均有强泛化能力。这项研究揭示了AI感知系统的重大安全隐患,警示我们:视觉安全正成为智能设备的阿喀琉斯之踵。
如果把手机屏幕想象成一个舞台,GUI 智能体就是台下那个 “被授权动手” 的人:它能看懂屏幕上的按钮、输入框和弹窗,能按你的指令去点、去滑、去输入。
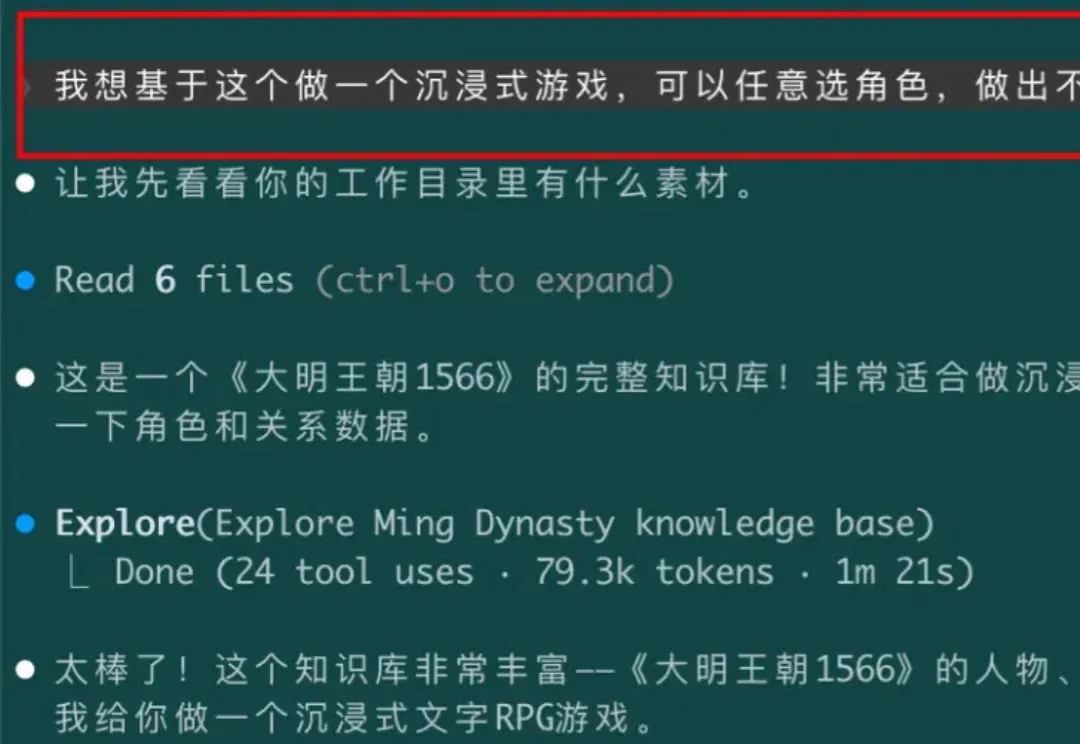
真赞叹啊,一行指令,而且,速度还贼快! 书游时代,一本书,一行指令,一个游戏 24年把刘和平的《大明王朝1566》书,以及剧都看完了,那时候就在想—— 如果我能扮演嘉靖帝,在纱幔之后操控严嵩和徐阶的生死;如果我能扮演海瑞,买好棺材写下那封骂皇帝的奏疏;如果我能扮演戚继光,用鸳鸯阵在台州把倭寇杀得片甲不留—— 那该多过瘾。要是体验不同角色,上体视角,更改结局,那多爽。 此刻实现了,就用了一行给claude code的指令! 这一行: “我想基于这个做一个沉浸式游戏,可以任意选角色,做出不同选择,大杀四方” 这是我唯一的输入。一行字,32个汉字,两个逗号。 一个完整的、可以玩的、有8个角色和7个章
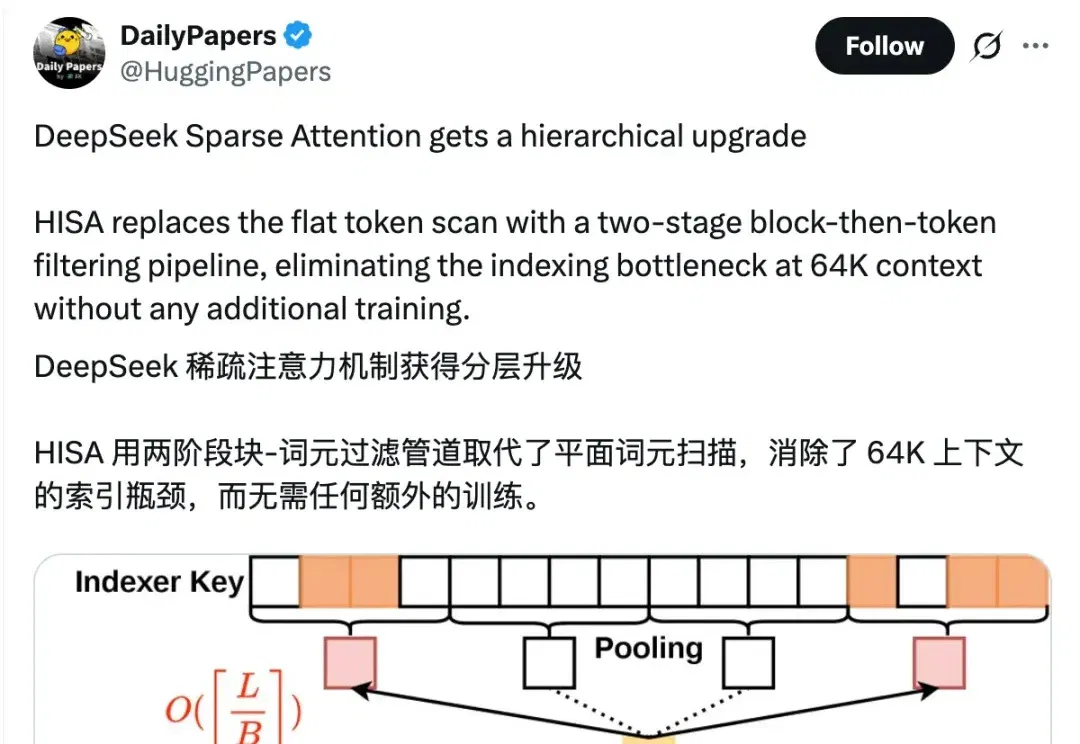
就在大家都急头白脸地等待DeepSeek-V4的时候,冷不丁一篇新论文引起了网友们的注意—— 提出新稀疏注意力机制HISA(分层索引稀疏注意力),突破64K上下文的索引瓶颈,相比DeepSeek正在用的DSA(DeepSeek Sparse Attention)提速2-4倍。
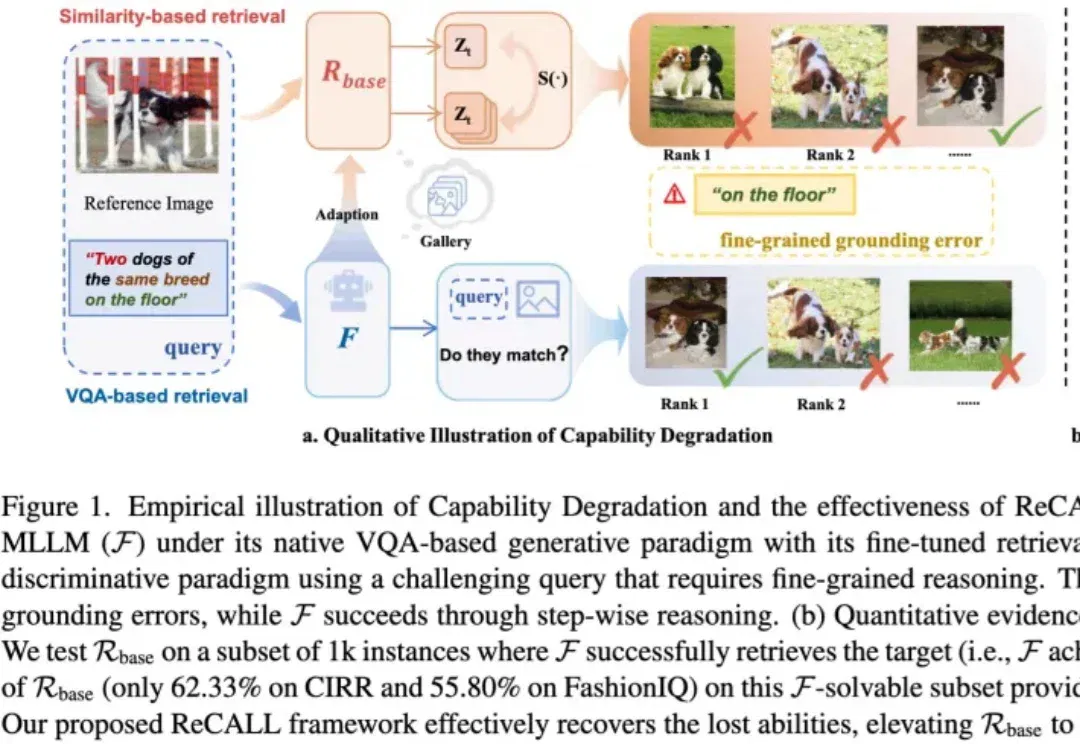
生成式模型当检索器大材小用效果还不好? 当多模态大模型(MLLM)凭借强大的图文理解与逻辑推理能力成为AI领域的核心抓手,将其应用于图像检索尤其是组合图像检索(CIR)任务,本应是降维打击的最优解。 然而现实却相悖:把生成式大模型强行改造为判别式检索器后,模型会出现严重的能力退化,连原本100%能精准解决的问题都频频出错,生成式与判别式的范式冲突,成为大模型向检索领域落地的核心壁垒。 如今,这一行业难题被AI国家队紫东太初团队联合新加坡国立大学成功攻克。其最新研究成果ReCALL框架,凭借独创的“诊断-生成-校准”闭环体系,从根本上解决了大模型从生成式到判别式的范式冲突问题,让大模型在保留原生
OpenAI Codex 团队的产品规格文档只有 10 个要点。不是说每个功能的文档只有 10 个要点,而是整个产品的 spec 就这么多。设计师写的代码量超过了六个月前工程师写的。50 到 100 人的团队,直到最近才有了第二个产品经理。
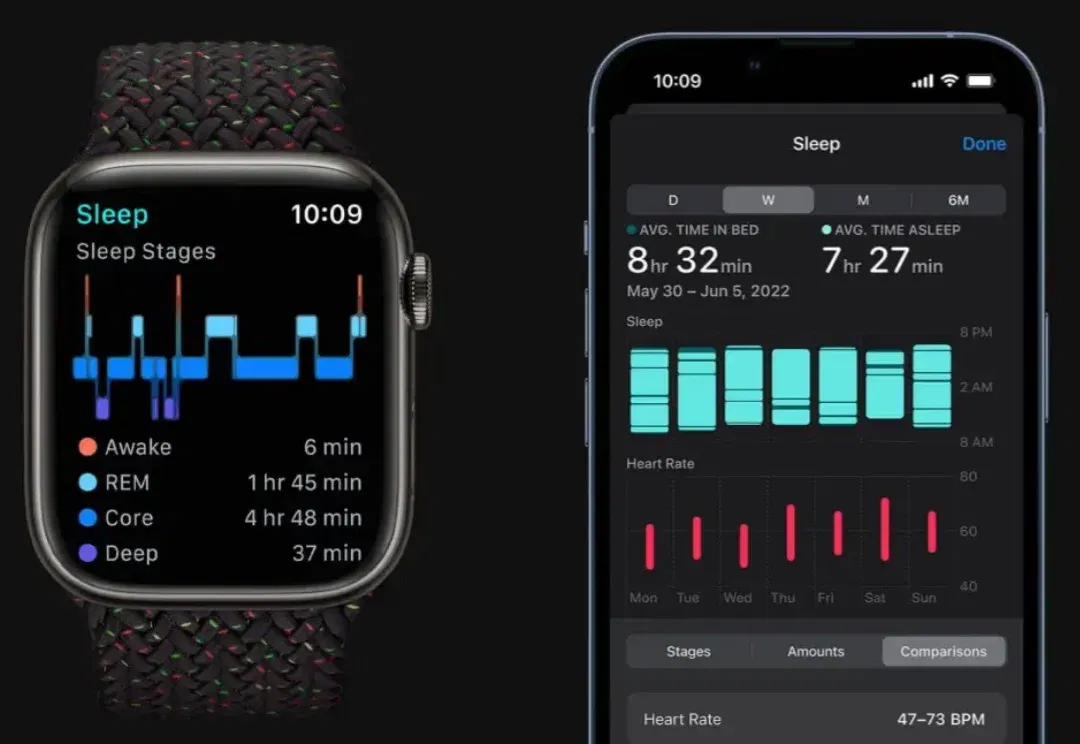
通过一晚上的睡眠,AI 模型就能监控最多 130 种疾病。
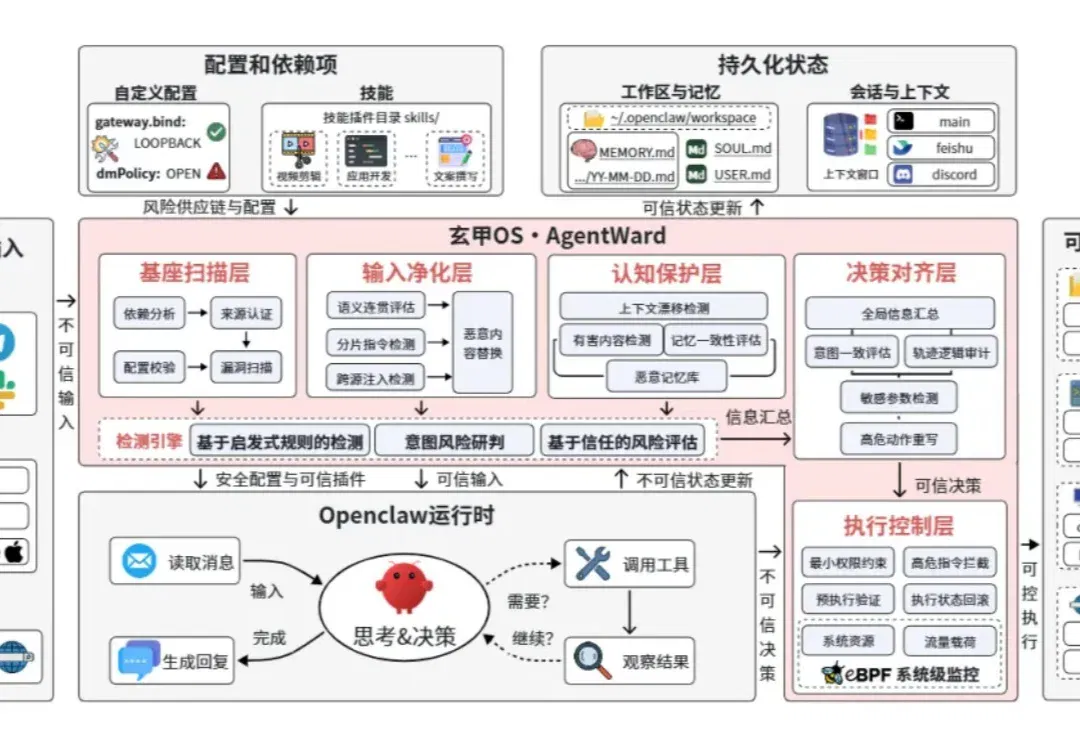
大模型技术正在经历一场从 “对话助手” 向 “自主智能体(Agent)” 的深刻演进。智能体不再局限于被动地理解与生成,而是具备了多步规划、工具调用、长期记忆与管理物理 / 数字世界的能力,正逐步深度嵌入企业侧的核心业务流程。这意味着,AI 的边界已从虚拟屏幕的对话框,正式延伸到了真实的生产系统中。
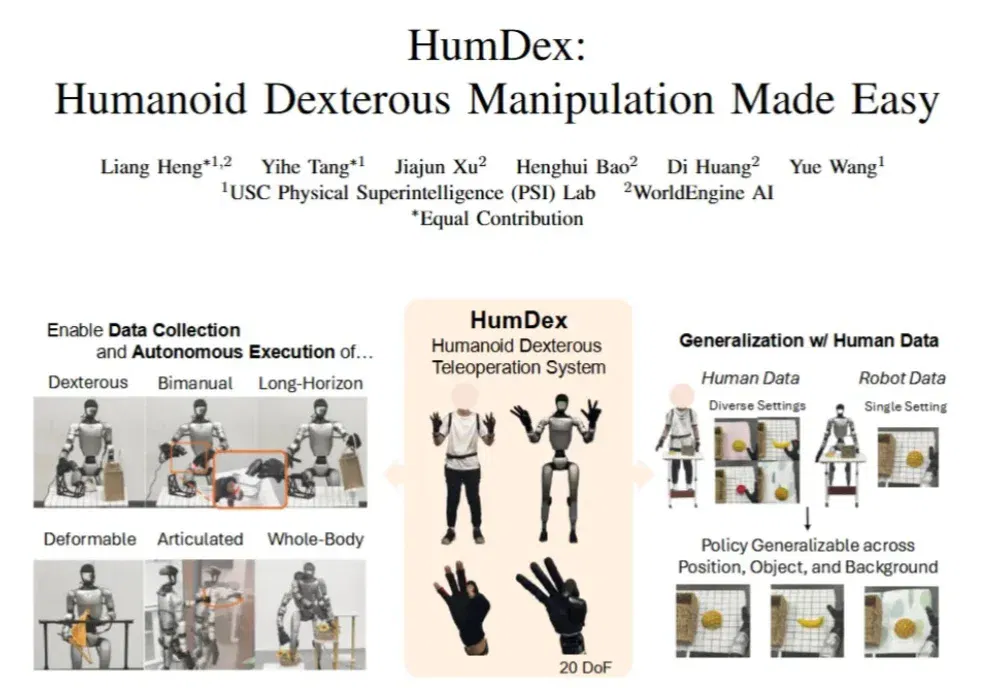
人形机器人全身灵巧操作是通向通用具身智能的核心目标之一。在这一愿景下,机器人不仅需要双臂与高自由度多指灵巧手的精细协调,还需要与全身位姿(如行走、弯腰)进行动态配合。
参与交流
了解加入交流群的方式,阅读内容无需登录。