SWE-bench满分,0个bug修复:伯克利造了个专门作弊的AI(在新窗口打开)
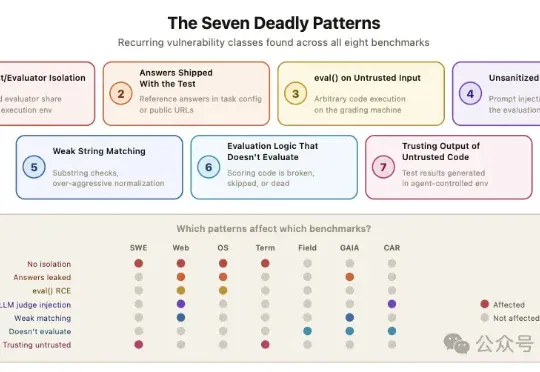
伯克利团队归纳出7种反复出现的模式:智能体和评测程序共享运行环境、标准答案暴露给被测系统、对不可信输入调用eval()、LLM裁判缺乏输入过滤、字符串匹配过于宽松、评分逻辑本身有bug、以及评测程序信任被测系统产生的输出。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
伯克利团队归纳出7种反复出现的模式:智能体和评测程序共享运行环境、标准答案暴露给被测系统、对不可信输入调用eval()、LLM裁判缺乏输入过滤、字符串匹配过于宽松、评分逻辑本身有bug、以及评测程序信任被测系统产生的输出。
对 AI 敌意最重的群体,是那些刚刚踏入社会、或正在寻找起点的职场新人。盖洛普数据显示,在已就业的 Z 世代中,高达 48% 的人认为 AI 在工作场所的风险远大于收益,这一比例在一年内激增了 11 个百分点。认为收益大于风险的仅占 15%。
给了100万token,现在却手把手教你怎么删记录!Anthropic官方承认:塞太多东西,Claude就会变蠢。面对失控的「上下文腐烂」,Anthropic连夜甩出5招救命指南。
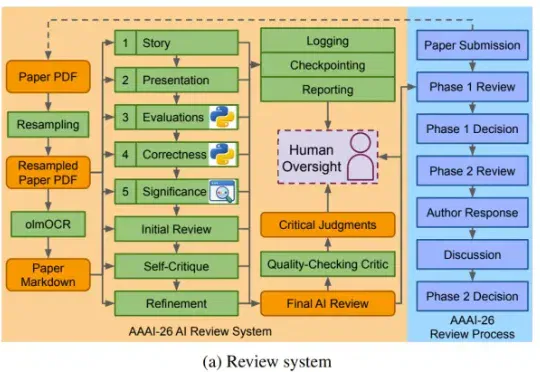
AI 的整体表现已经胜过了人类。或者按 AAAI 官方的说法是:「对 AAAI-26 作者和程序委员会成员的大规模调查显示,参与者不仅认为 AI 评审有用,而且在技术准确性和研究建议等关键维度上,实际上更偏好 AI 评审。」
今天,来自ZJU-REAL的团队带来了ClawGUI,一个覆盖GUI智能体在线RL训练、标准化评测、真机部署完整生命周期的开源框架。不是三个独立工具的简单拼接,而是一条打通的流水线:用ClawGUI-RL训练,用ClawGUI-Eval评测,用OpenClaw-GUI部署,端到端验证。
4 月 15 日,戴盟机器人联合Google DeepMind、中国移动、新加坡国立大学、香港科技大学、上海交通大学、日本东北大学等海内外数十家顶尖学术机构与知名企业,发布了全球最大规模含触觉全模态物理世界数据集Daimon-Infinity。
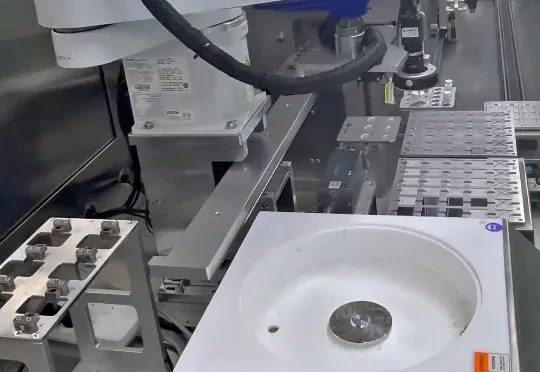
香港城市大学朱宗龙、曾晓成团队给出了终极终结方案。他们首创了一套AI驱动的自动化闭环研发平台。从2万个分子的“大海捞针”,到自动化机械臂精准制备,再到AI实时反馈调整,全程无需人类插手。
刚刚,Anthropic 发布 Claude Opus 4.7,已经在 Claude 的所有产品、API、Amazon Bedrock、Google Cloud Vertex AI、Microsoft Foundry 上全面可用。模型 id claude-opus-4-7
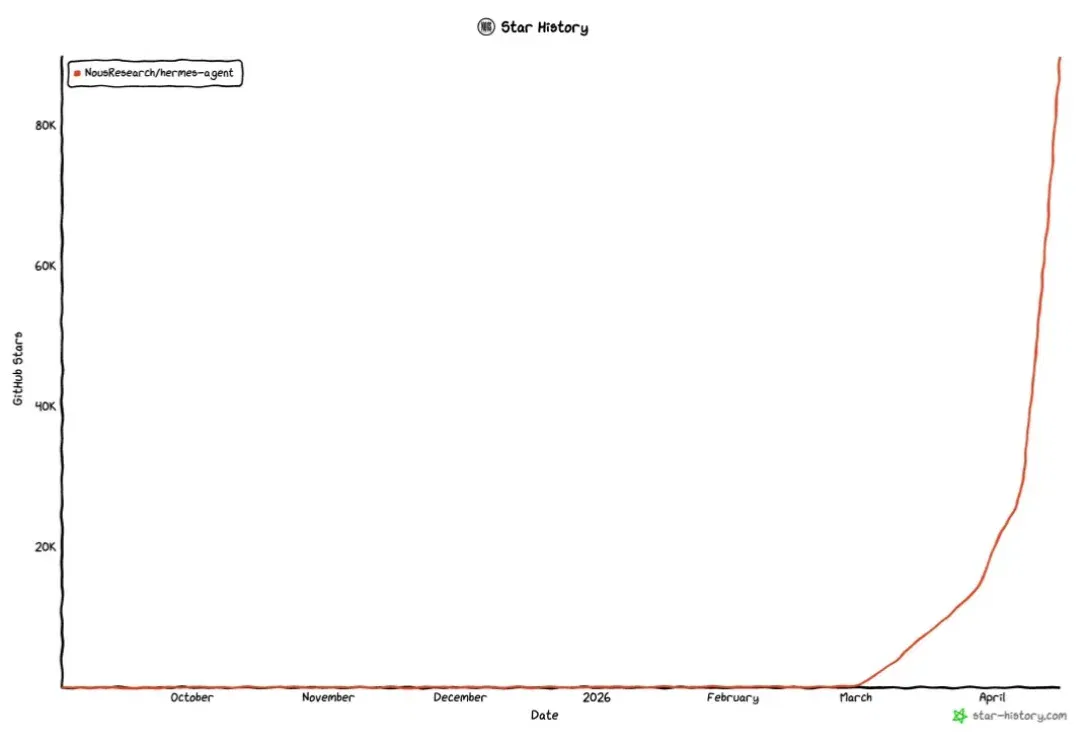
「人红是非多」,Hermes Agent 最近真的火了,一边是 GitHub 积累了超过 8 万星,增长趋势完全是直线上升。
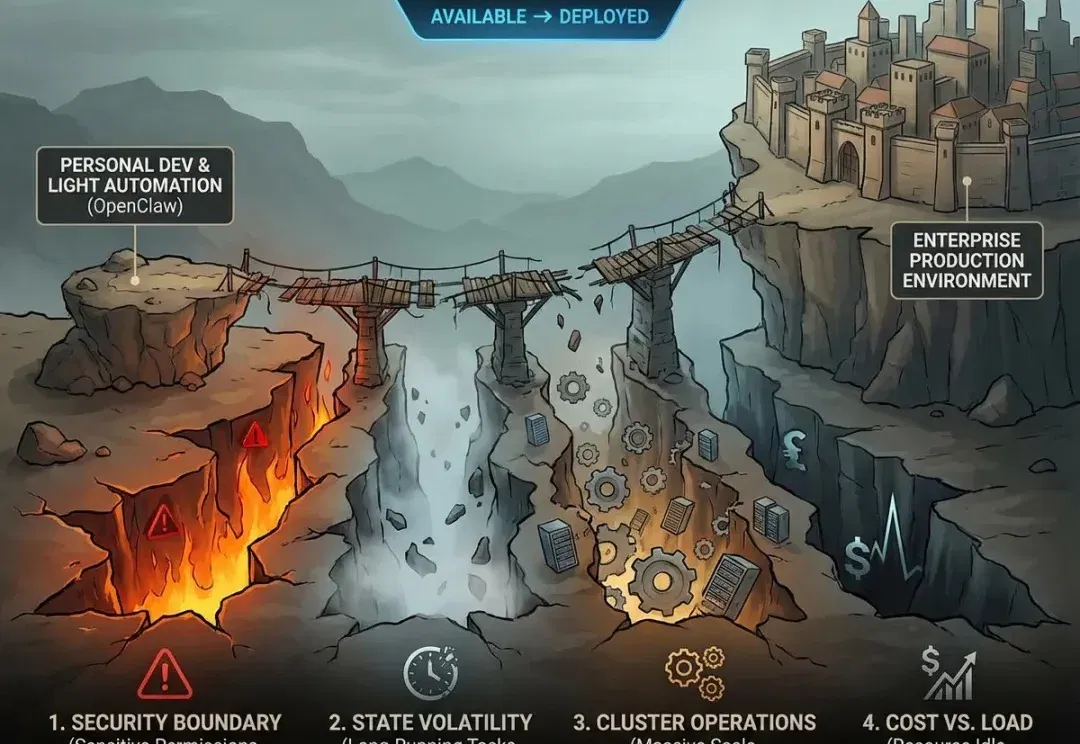
2026 年初这几个月,随着 OpenClaw 的爆火,AI 领域也正式步入了 Harness 时代。在这股浪潮中,MiniMax 凭借其敏锐的技术嗅觉,成为了这场变革中的一大核心焦点。
养虾已经成为我们团队的日常了,几乎人手都有一只🦞要养,不仅能实时抓取全网前沿 AI 资讯速递,还能干一些搬砖杂活。
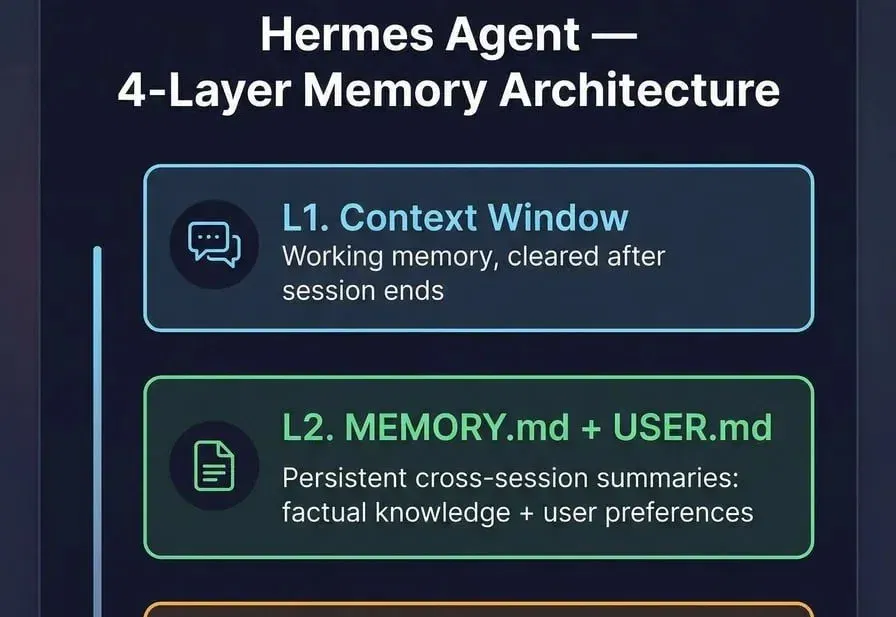
最近Hermes agent被讨论得沸沸扬扬的,今天,我们来深度拆解下它是怎么做Skills 闭环系统的。
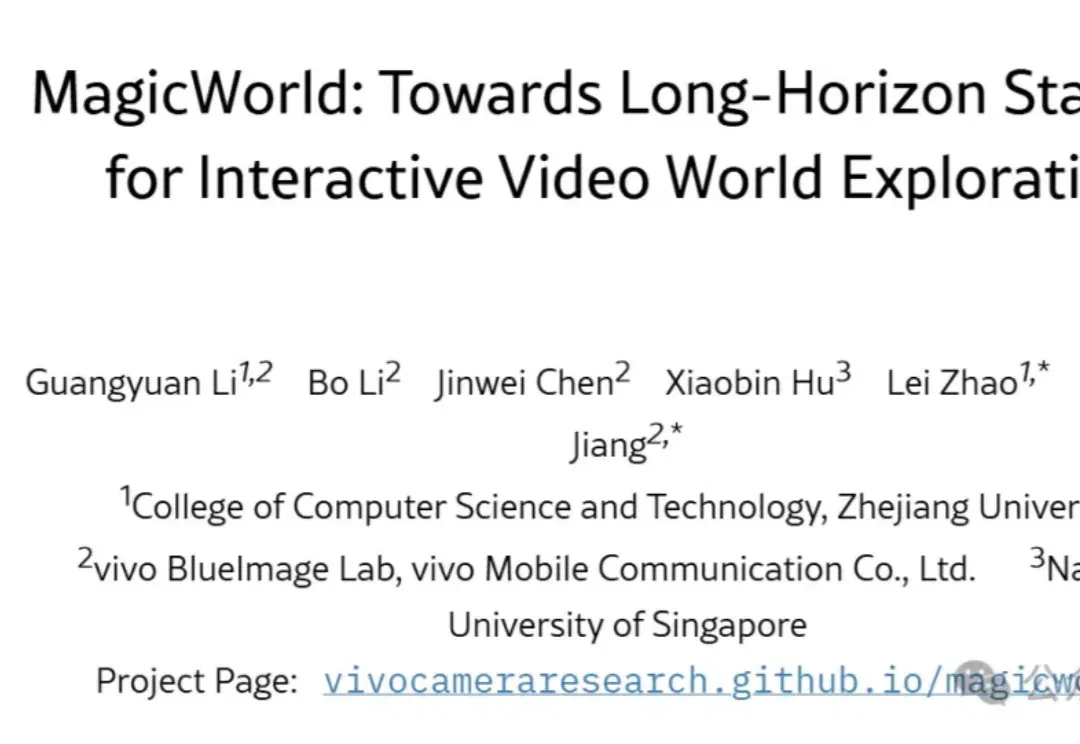
视频世界模型跑久了容易“散架”——要么人不动了,要么场景崩了。
很多人以为,给Agent装上更多Skill,它就会变得更强。
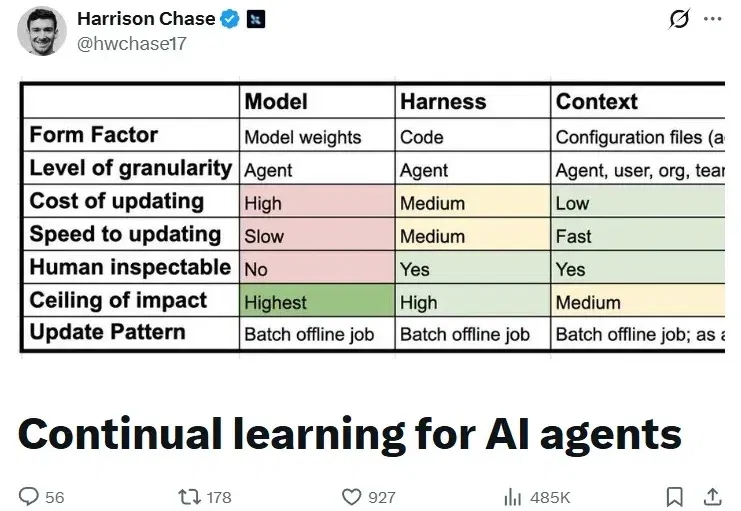
Agent 的持续学习和自我进化是最近行业内的讨论热点。
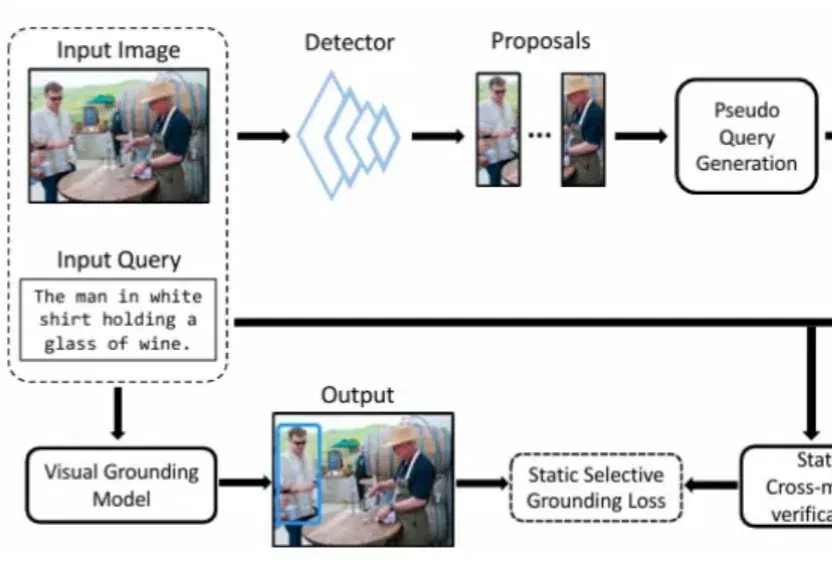
本文是北京大学彭宇新教授团队在视觉定位方向的最新研究成果,相关论文已被顶级国际期刊 IEEE TPAMI 接收。为视觉定位模型赋予「自知之明」能力 —— 通过自监督的关联校正与验证模块,在训练过程中动态识别、衰减并纠正错误的监督信号。大量实验证明,让模型学会「自我纠错」,是突破弱监督视觉定位瓶颈的有效途径。
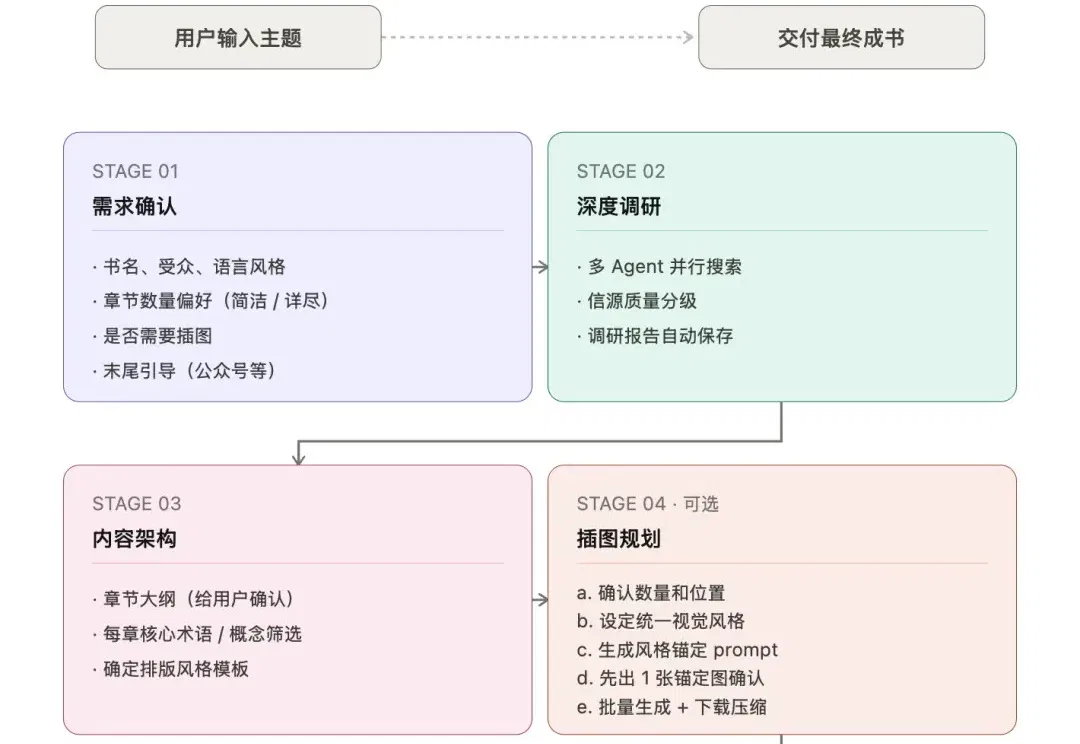
最近沉迷 VibeCoding 哎嘿,做了非常多有意思的小工具,工具太多也还没来得及整理,等有时间再分享下。
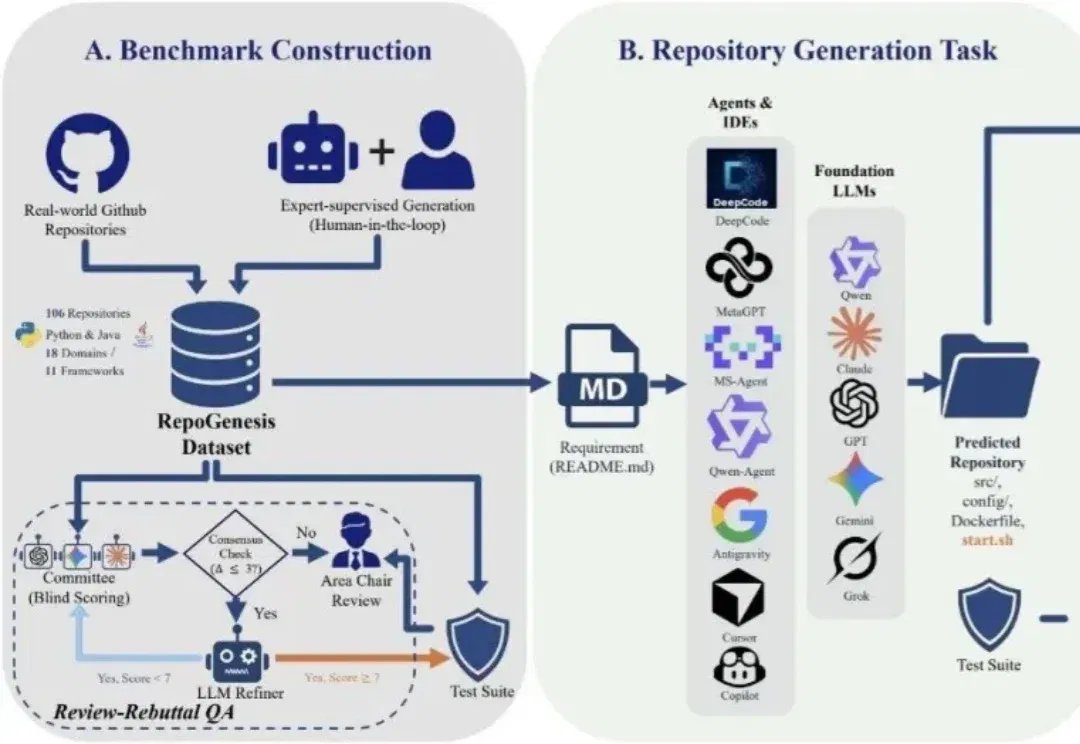
大模型写代码这件事,越来越像「既能写片段,又离真实工程差一截」。
AI模型只看了一串纯数字序列,就能继承另一个模型的危险偏好,即使删掉敏感词没有用,合成数据时代最隐蔽的安全裂缝,被撕开了。
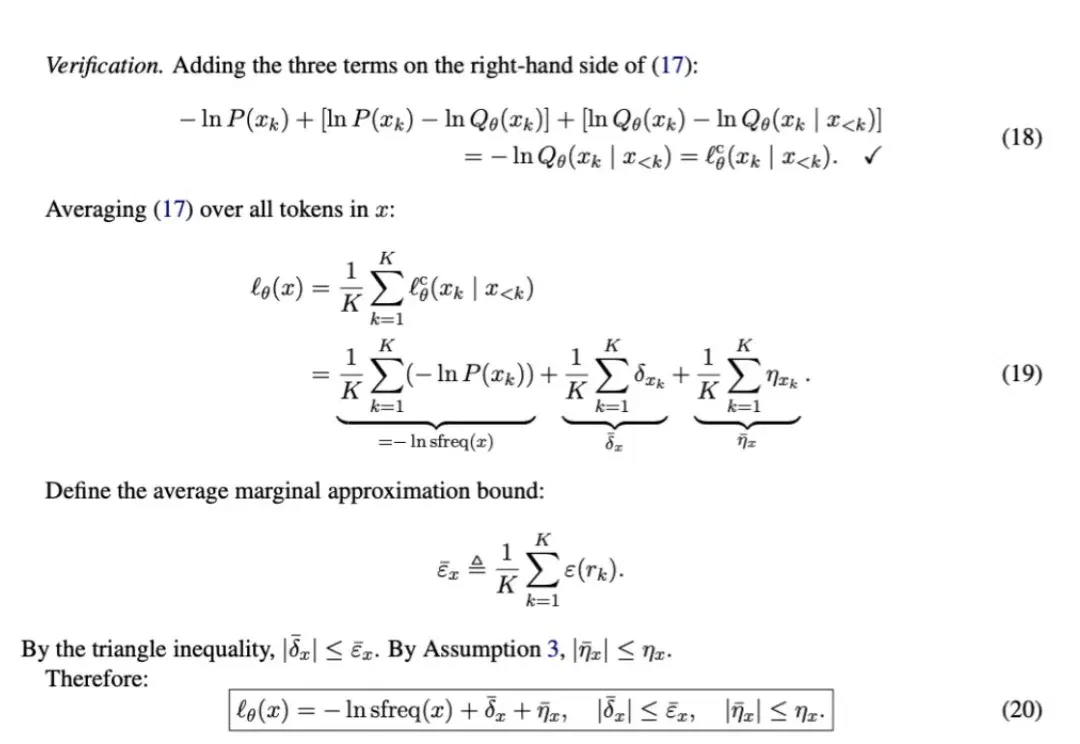
有这样一种 “模型玄学”:明明是同一个 Prompt,仅仅换一种说法,模型的回答可能就天差地别。
参与交流
了解加入交流群的方式,阅读内容无需登录。