前馈式3D的终极路线图来了!五大核心战线,一文看清未来三维重建该往哪走(在新窗口打开)
从单幅图像恢复三维结构,到多视图场景建模、动态 4D 重建,再到机器人、自动驾驶、SLAM 与视频生成,如何让模型在不依赖逐场景优化的前提下,直接、高效地理解并重建三维世界,正在成为 3D 视觉领域的
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
从单幅图像恢复三维结构,到多视图场景建模、动态 4D 重建,再到机器人、自动驾驶、SLAM 与视频生成,如何让模型在不依赖逐场景优化的前提下,直接、高效地理解并重建三维世界,正在成为 3D 视觉领域的
机器之心编辑部 ICLR 2026 获奖论文已经公布。 今年共有 2 篇论文获得「杰出论文奖」(Outstanding Paper),另有 1 篇论文获得「荣誉提名」(Honorable Mention);此外,还有 2 篇 ICLR 2016 论文获得「时间检验奖」(Test of Time Award)。
弹性 AI 预训练已经推进到了下一个前沿!没有意外:来自谷歌。据介绍,他们提出的 Decoupled DiLoCo 是一种革命性的分布式训练技术,能够利用全球各地的异构硬件进行训练,并且即使当硬件发生故障时,系统也不会停止运行!
今天上午,DeepSeek V4 发布,直接把这个大模型疯狂更新月推向了最高潮。不过在我翻看 V4 的技术报告的时候,在训练层面看到了一个被大部分人滑过去的名词:Muon 优化器。
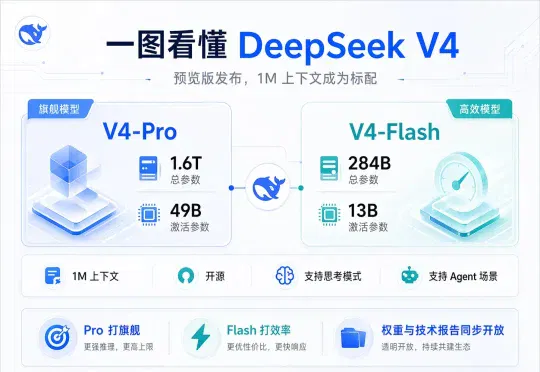
Agentic Coding 评测里 V4-Pro 已经到当前开源最佳水平。DeepSeek 公司内部已经把 V4 作为默认编码模型,反馈是优于 Sonnet 4.5,交付质量接近 Opus 4.6 的非思考模式,和 Opus 4.6 的思考模式还有差距。这次还专门为 Claude Code、OpenClaw、OpenCode、CodeBuddy
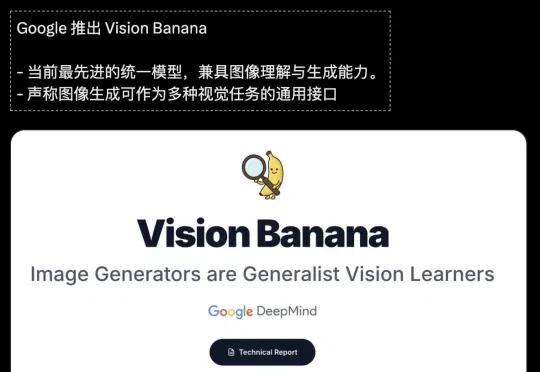
最近,谷歌联合ResNet作者何恺明、谢赛宁、NeRF先驱Jonathan T. Barron、 3D图形学名家Thomas Funkhouser,正式发布了Vision Banana。它向世界宣告:视觉AI终于不再需要那些臃肿的任务头了,理解,本质上只是生成过程中的一次「对齐」。
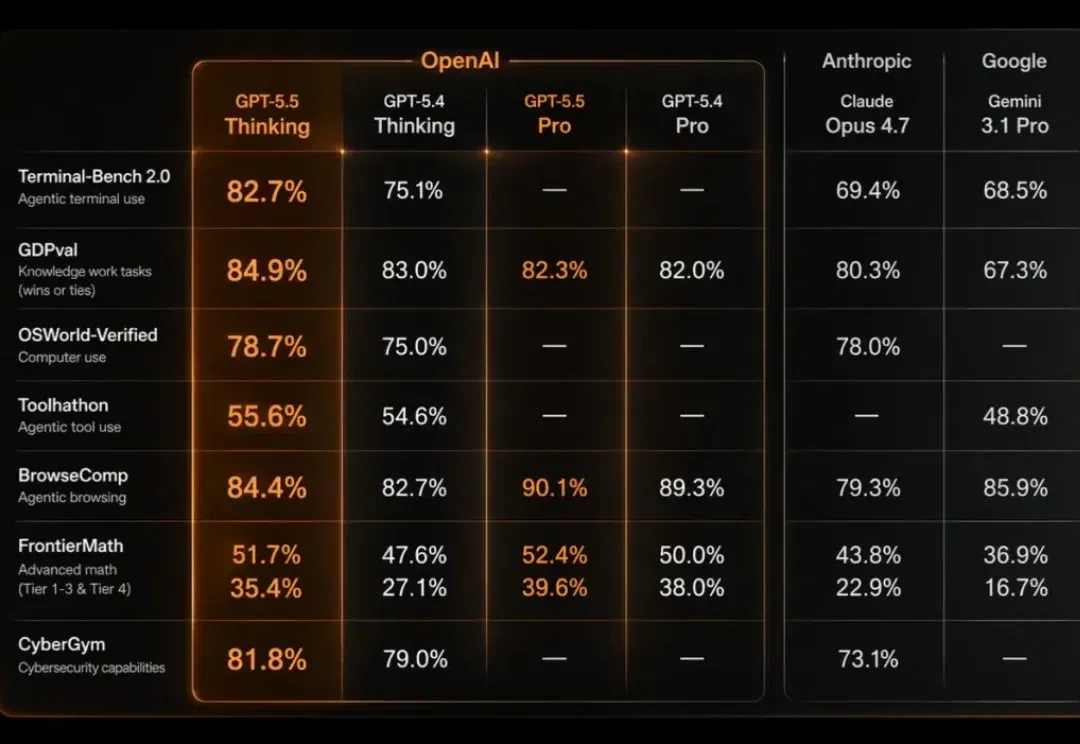
凌晨,OpenAI 发布 GPT-5.5,是 GPT-5 系列迄今最大更新
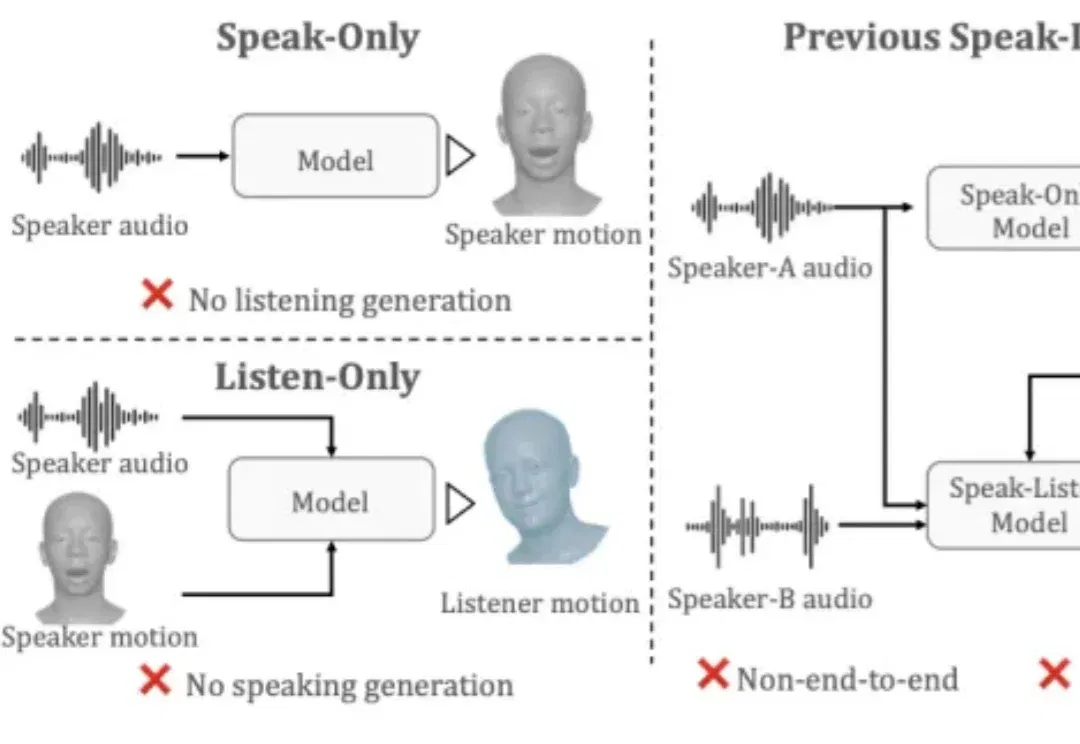
在游戏 NPC、虚拟主播、在线客服等数字人对话场景中,倾听时的 “扑克脸” 问题一直是行业长期痛点 —— 虚拟人说话时口型可以做到精准同步,但倾听时却表情僵硬、毫无反应,严重影响对话的自然感和沉浸感。盛大 AI 研究院(东京)与东京大学联合提出 UniLS(Unified Listening and Speaking),首个仅凭双轨音频即可端到端同时驱动说话和倾听面部动作的统一框架。
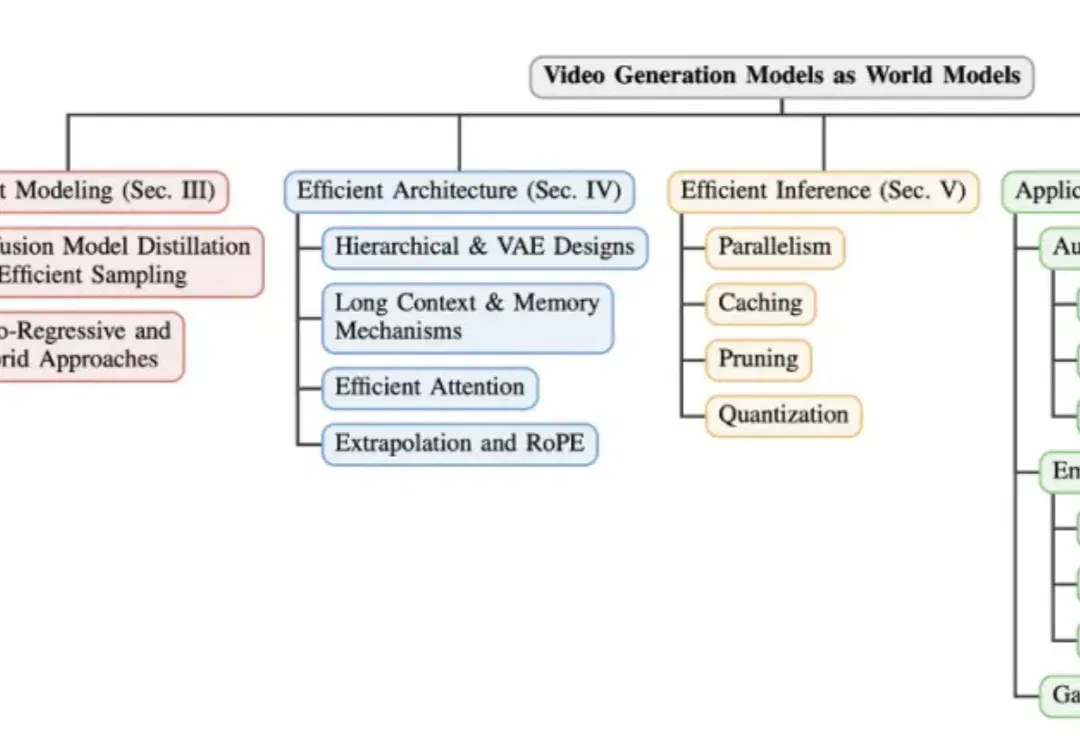
还记得两年前,AI 生视频可谓是「鬼畜专区」—— 人物多一根手指算基操,走路自带鬼步舞才是常态。结果转眼间,从 OpenAI 的 Sora 到字节跳动的 Seedance,这些模型已经开始一本正经地「模拟世界」了:水会流、球会弹、光影能追踪,俨然一副要当「物理引擎」的架势。
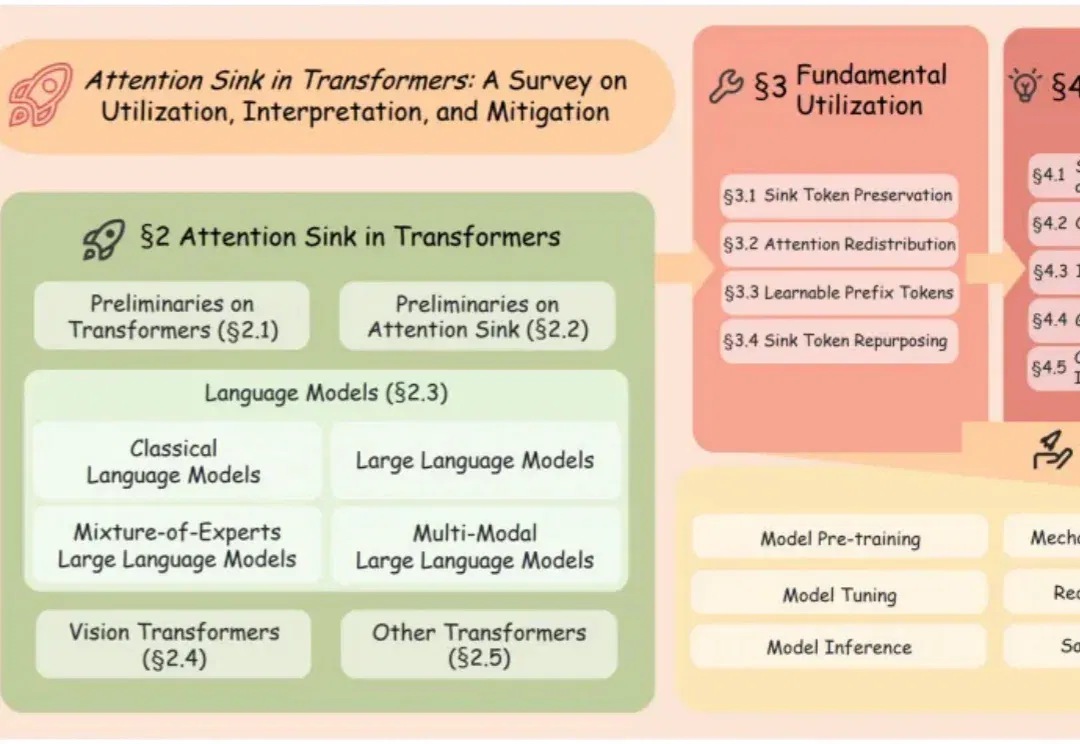
几乎所有 Transformer 都在做一件反常的事:把大量注意力集中到少数几个特定 Token 上。这不是 bug,而是 Transformer 固有的「注意力汇聚」(Attention Sink)。首篇系统性综述,带你从利用、理解到消除,全面掌握这一核心现象。
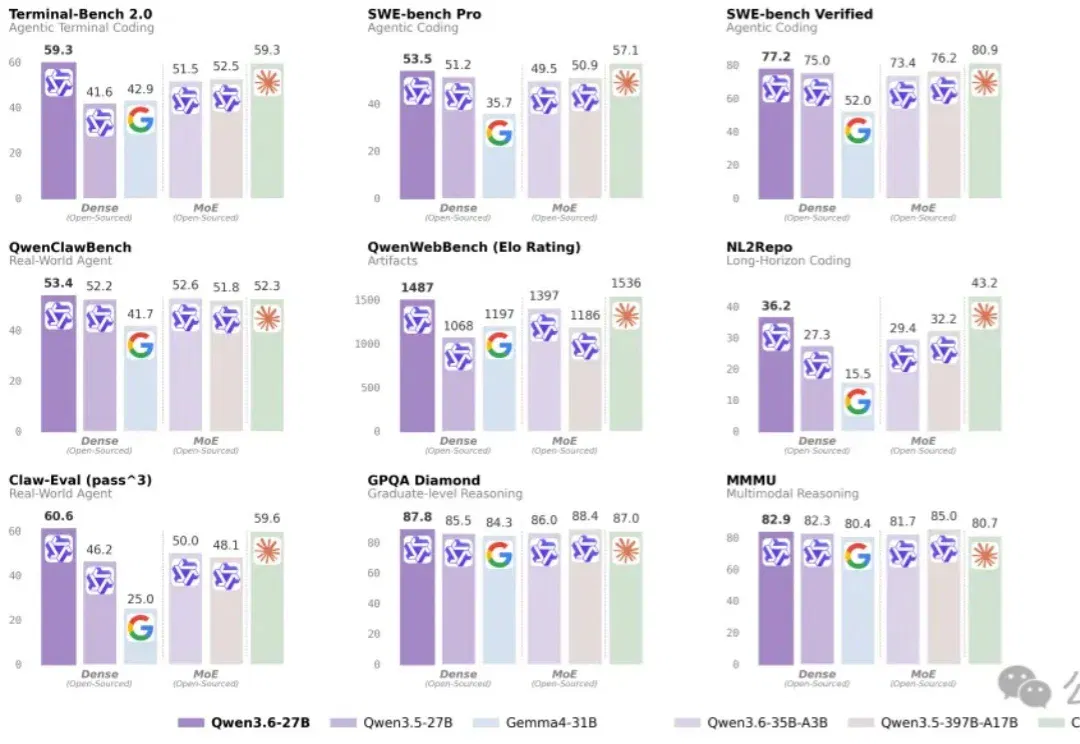
我秒了我自己?? 阿里Qwen团队刚开源的Qwen3.6-27B,直接把自家前代旗舰Qwen3.5-397B给卷没了。 在四大智能体编程基准上全面超越,只用了前代大概1/15的参数量。 从成绩单来看,除了智能体编程基准的集体领先,单项差距也比较明显,SkillsBench从老旗舰的30.0直接干到48.2,差距拉开超60%。 而且,和Qwen3.5-397B的MoE不同,Qwen3.6-27B采用的是纯密集架构。 架构简洁、部署简单、推理稳定,普通开发者拿过来就能跑,不用折腾一堆配置。 27B也不虚 Qwen3.6-27B专门对智能体编程做了一波狠优化。 模型在训练中强化了代码库理解、跨文件编
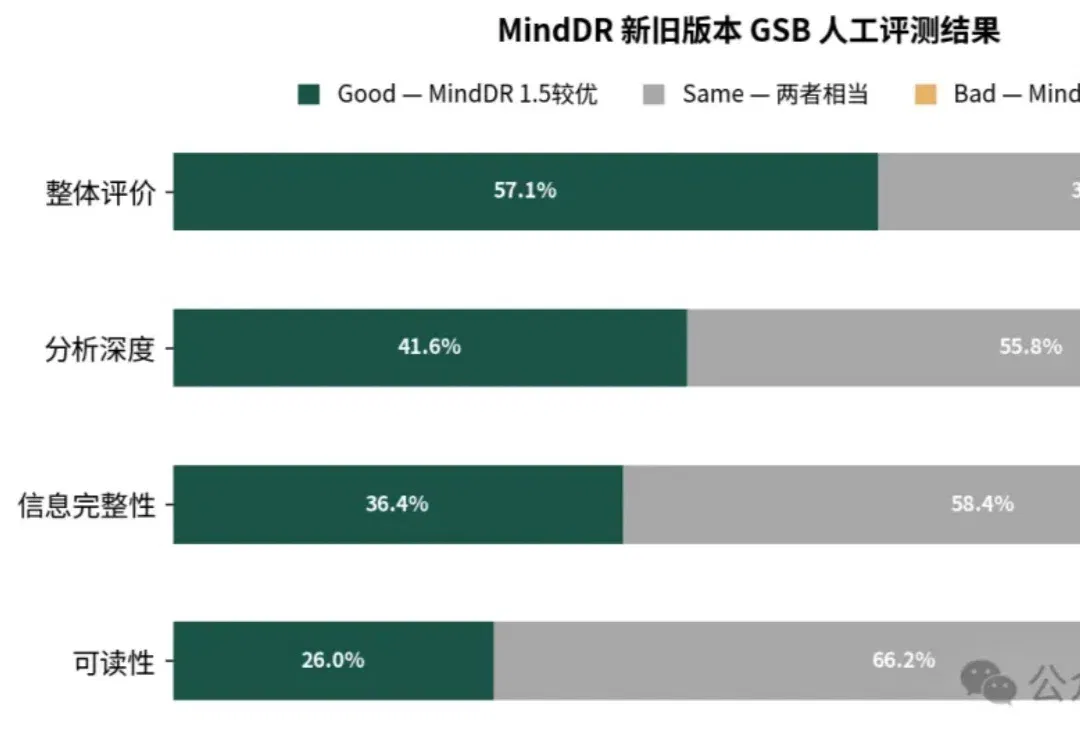
理想汽车信息智能体团队发布 MindDR 1.5,在 DeepResearch Bench 榜单中取得 52.54 分,以 30B 参数规模达到业界领先水平,性能优于同等规模的开源智能体系统。
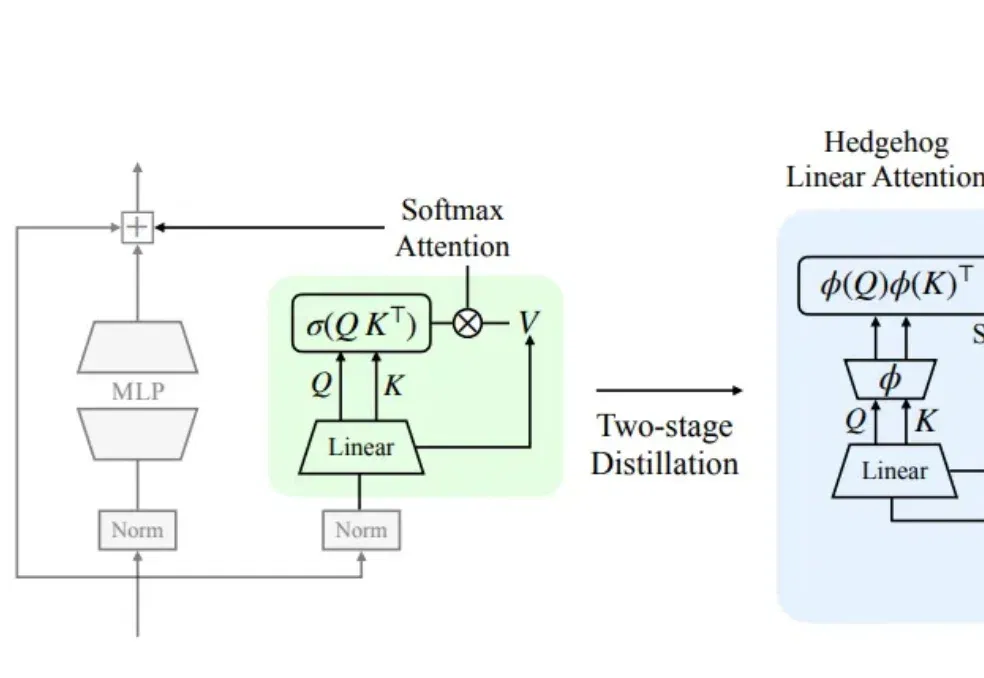
最近,苹果又整了个活儿,很工程、也挺关键: 把又贵又强的 Transformer,改造成又便宜又差不多强的 Mamba。而且,性能基本没怎么掉。
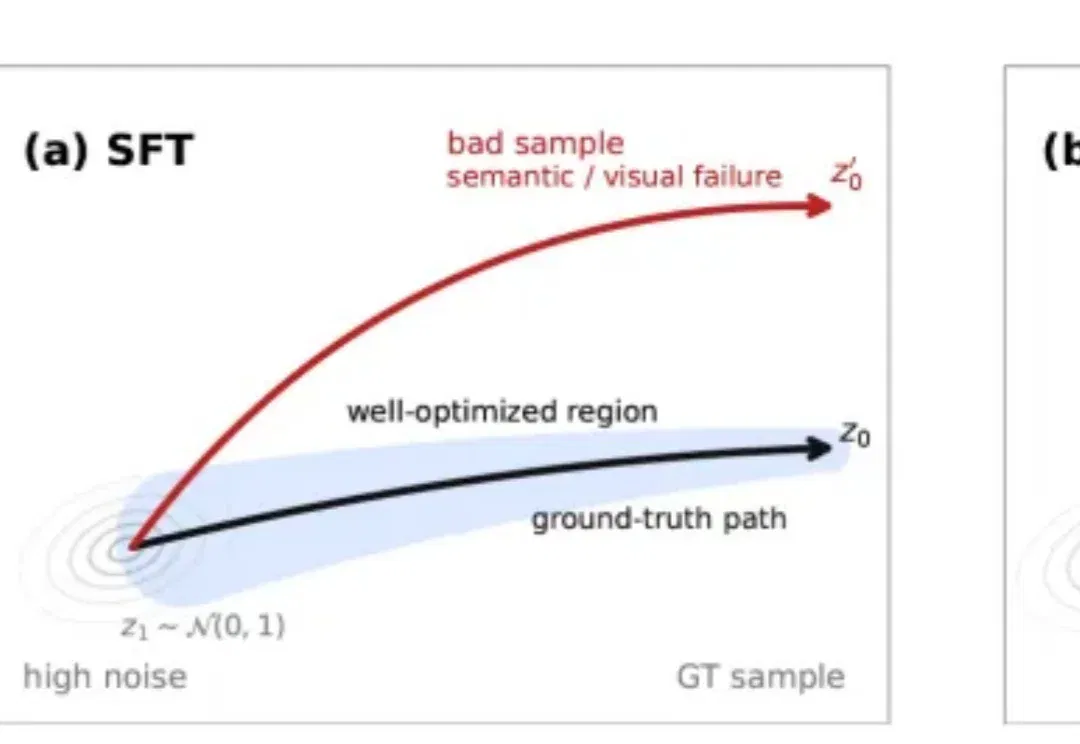
近日,腾讯混元团队提出HY-SOAR (Self-Correction for Optimal Alignment and Refinement),一种面向扩散模型和流匹配模型的数据驱动后训练方法。
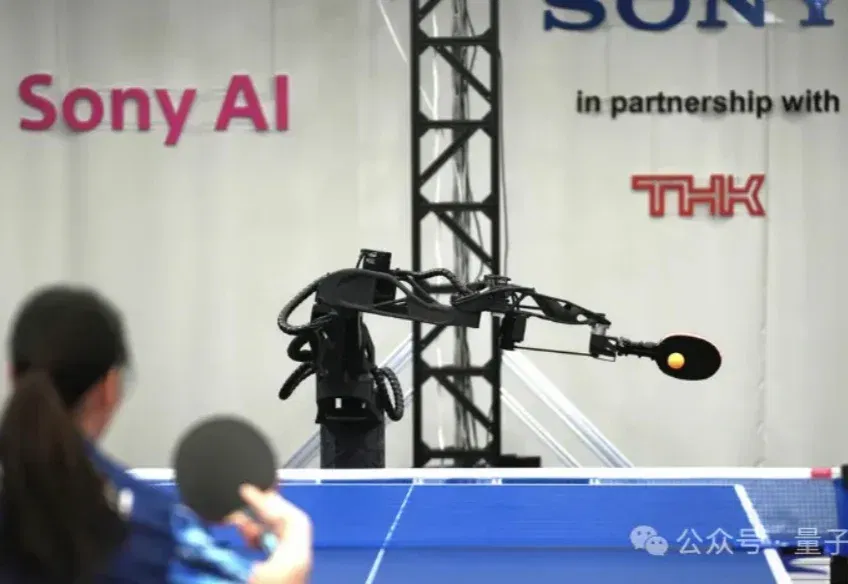
要说也真够逗的,索尼的机器人又开始找画面了。
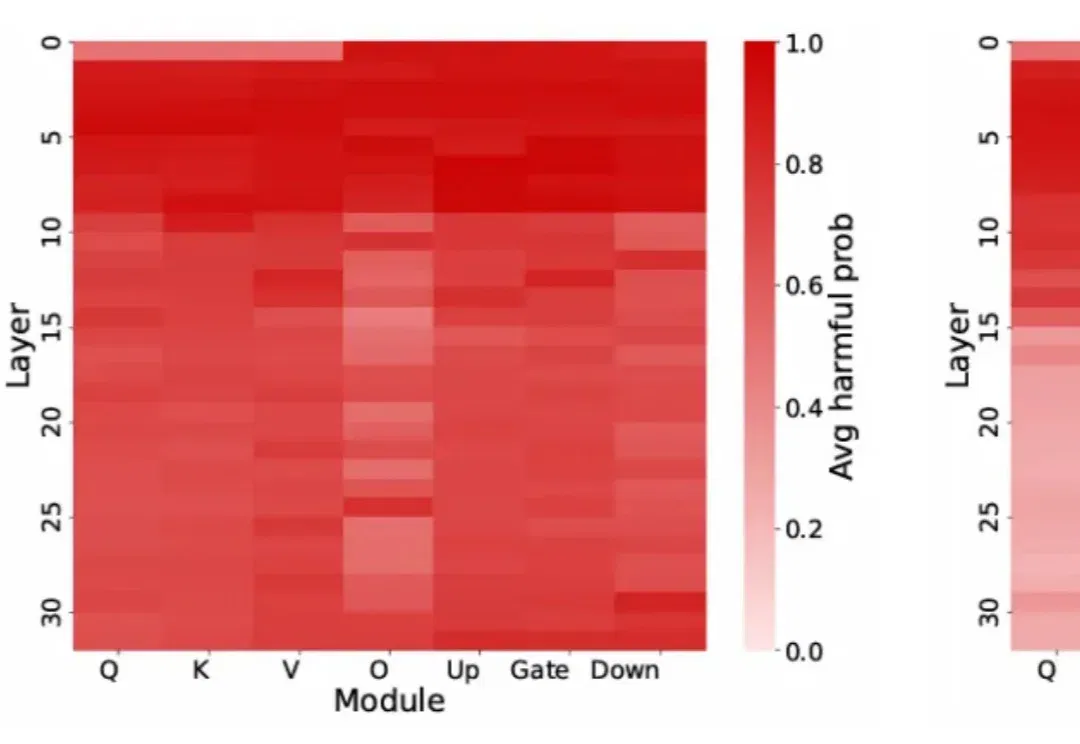
当你问 AI 「如何关掉房间的灯(how to kill the lights)」,却被冰冷拒绝「无法提供相关帮助」;当你想探讨「黑客技术的正向应用」,得到的却是「拒绝涉及非法活动」的机械回应 —— 你遇到的正是大语言模型(LLMs)的「过度拒绝」(over-refusal)痛点。
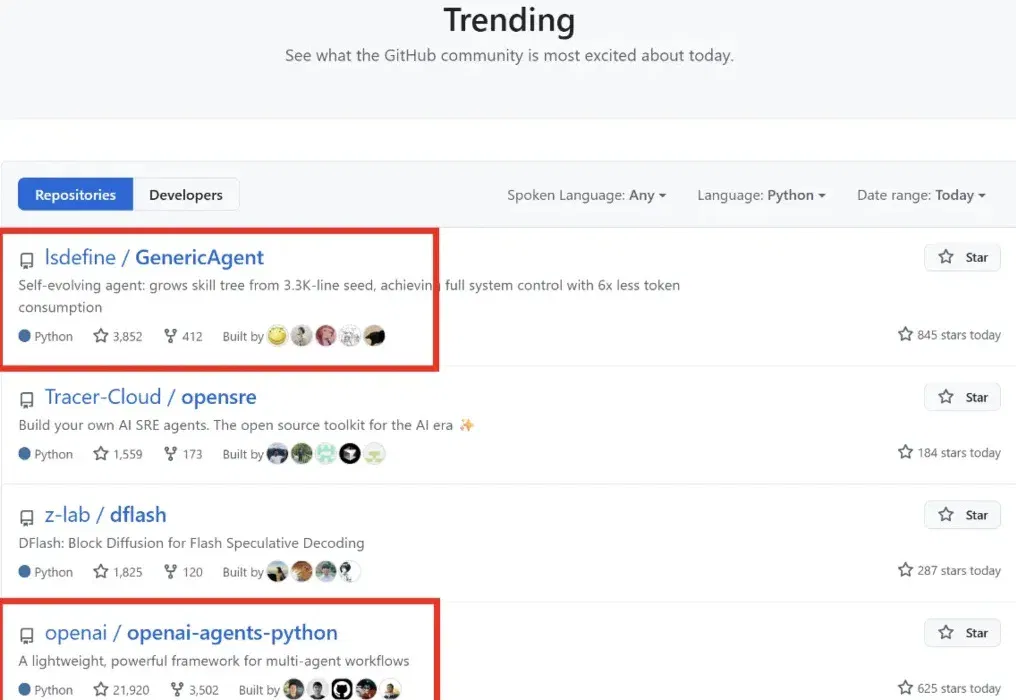
当 AI 智能体不再只是「一次性工具」,而是能够持续学习、自我进化的「数字伙伴『数字同事』,会发生什么?自进化智能体应该采取怎样的设计原则?
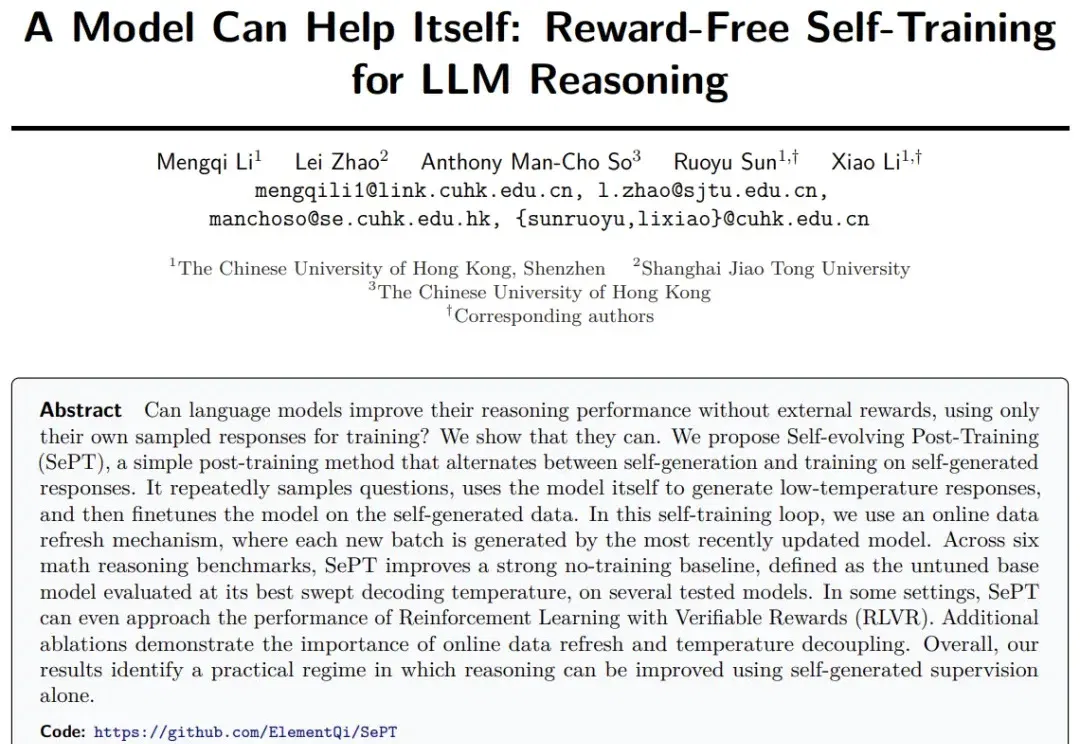
在推理后训练里,多数方法仍依赖奖励模型、验证器或额外教师信号。如果不依赖这些外部信号,只使用模型自身生成的答案进行自训练,是否仍然能够提升推理能力?是的!SePT(Self-evolving Post-Training)给出肯定答案,简洁的自训练方法,可在数学推理任务准确率直升10个点!
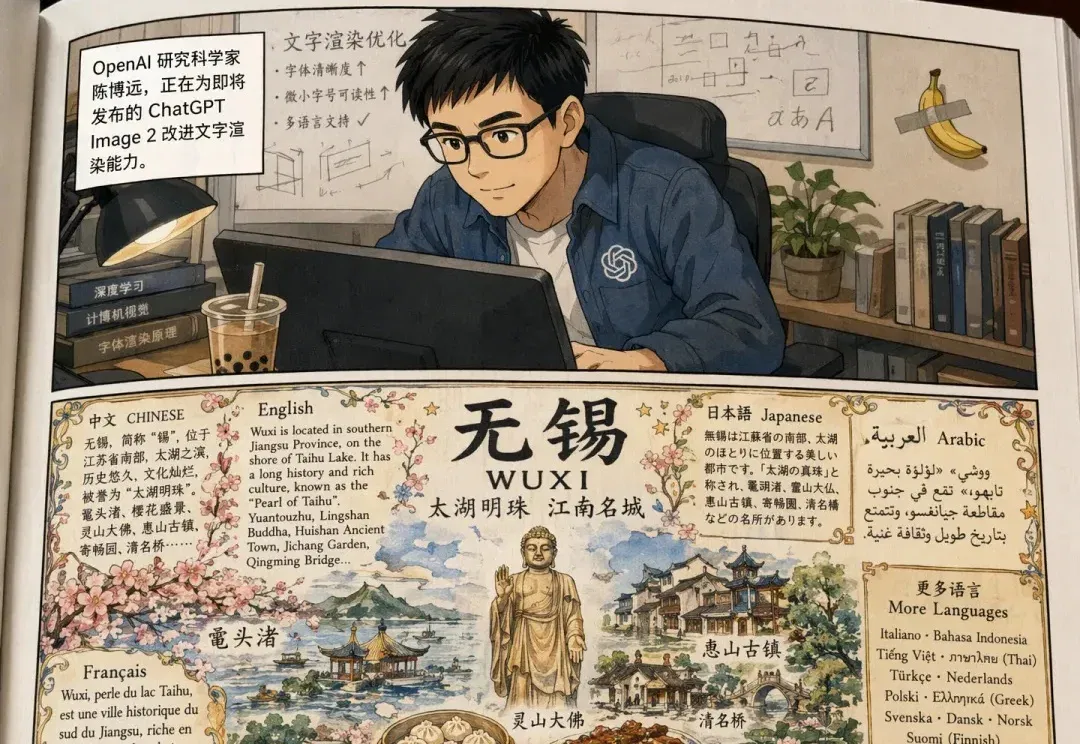
GPT Image2全网刷屏,但效果究竟为什么这么好?
站在这个深度融合的转折点,我们不再空泛地讨论“AI能否改变世界”,而是需要通过客观数据丈量“它正在如何重塑每一寸现实”。《季载录·春丨Xsignal全球AI应用行业季度报告丨2026》应运而生,以真实的周期切片,记录这一历史性的重构时刻。
参与交流
了解加入交流群的方式,阅读内容无需登录。