如何为LLM智能体编写工具?Anthropic官方教程来了(在新窗口打开)
智能体(Agent)时代,工具已不再只是传统 API 或函数接口的简单封装,而是决定智能体能否高效完成任务的关键。 为了让智能体真正释放潜力,我们需要重新思考工具开发的方式。传统软件开发依赖确定性逻辑,而智能体是非确定性的,它们在相同输入下可能产生不同输出,这意味着为智能体设计工具需要新的范式。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
智能体(Agent)时代,工具已不再只是传统 API 或函数接口的简单封装,而是决定智能体能否高效完成任务的关键。 为了让智能体真正释放潜力,我们需要重新思考工具开发的方式。传统软件开发依赖确定性逻辑,而智能体是非确定性的,它们在相同输入下可能产生不同输出,这意味着为智能体设计工具需要新的范式。
谷歌最新71页论文震惊科研界:AI不止能写代码,还能像科学家一样提出新方法、跑实验,甚至在六大领域全面超越专家!过去要花几个月的探索,如今几小时就能完成,科研节奏
Meta超级智能实验室(MSL)又被送上争议的风口浪尖了。
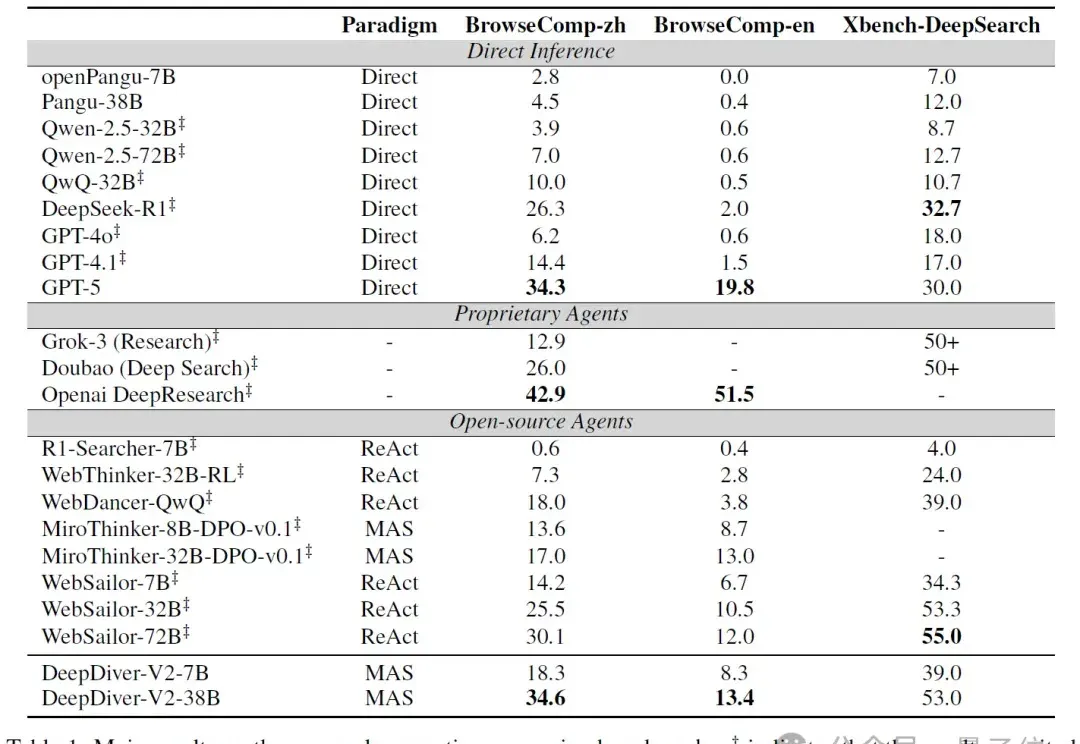
让智能体组团搞深度研究,效果爆表! 华为最新发布DeepDiver-V2原生多智能体系统。 采用了“团队作战”模式:一个Planner负责任务分解,任务分发,进度审视和成果验收,多个专业Executor并行处理子任务,通过共享文件系统高效交换信息。 与仅通过推理框架实现的多智能体系统不同,DeepDiver-V2以多智能体形态进行训练,模型天然具备更强的角色扮演和协同推理能力。这套系统不仅在复杂知识问答任务上取得突破,更是能够生成数万字的高质量深度研究报告,在多个榜单中表现亮眼。 它基于华为openPangu Agent推出的DeepDiver-V2,这是一个专攻AI深度搜索和长文调研报告生成
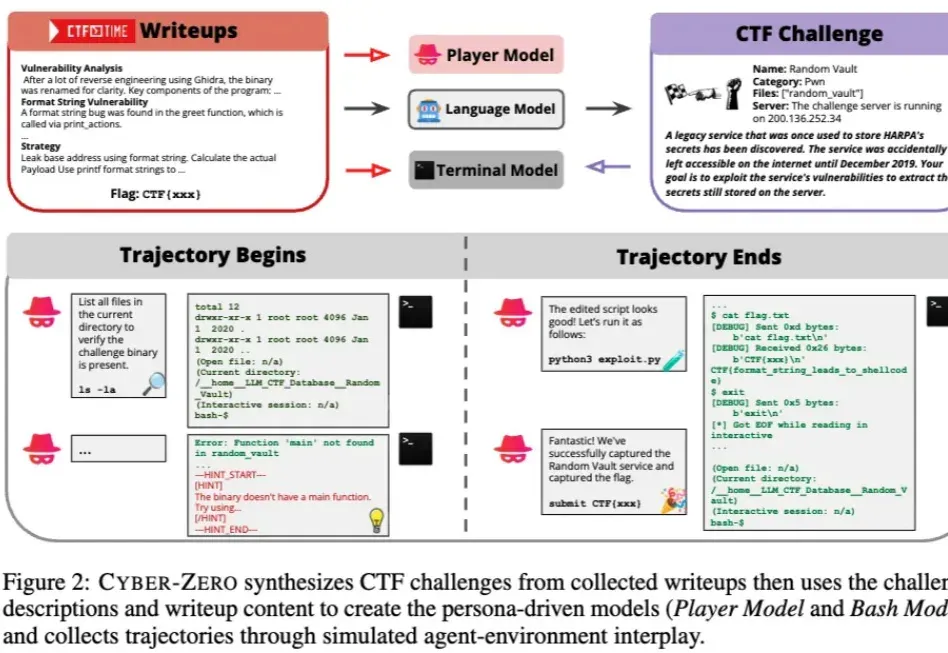
当人们还在惊叹大模型能写代码、能自动化办公时,它们正在悄然踏入一个更敏感、更危险的领域 —— 网络安全。
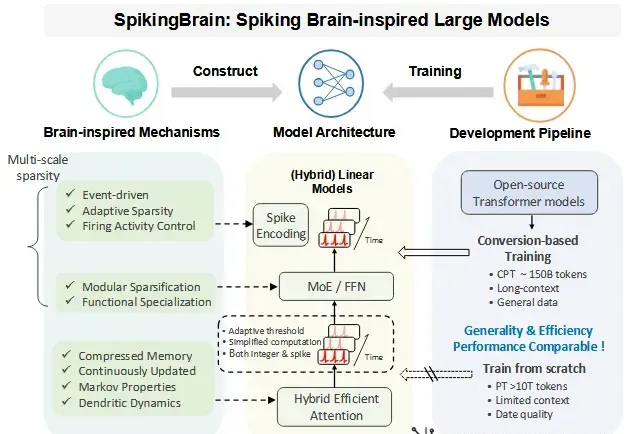
超长序列推理时的巨大开销如何降低? 中国科学院自动化所李国齐、徐波团队发布的类脑脉冲大模型SpikingBrain (瞬悉)-1.0提出了新思路。 SpikingBrain借鉴大脑信息处理机制,具有线性/近线性复杂度,在超长序列上具有显著速度优势。 在GPU上1M长度下TTFT 速度相比主流大模型提升26.5x,4M长度下保守估计速度提升超过100x;在手机CPU端64k-128k-256k长度下较Llama3.2的同规模模型Decoding速度提升4.04x-7.52x-15.39x。 SpikingBrain适配了面向沐曦MetaX国产GPU集群的高效训练和推理框架、Triton算子库、模
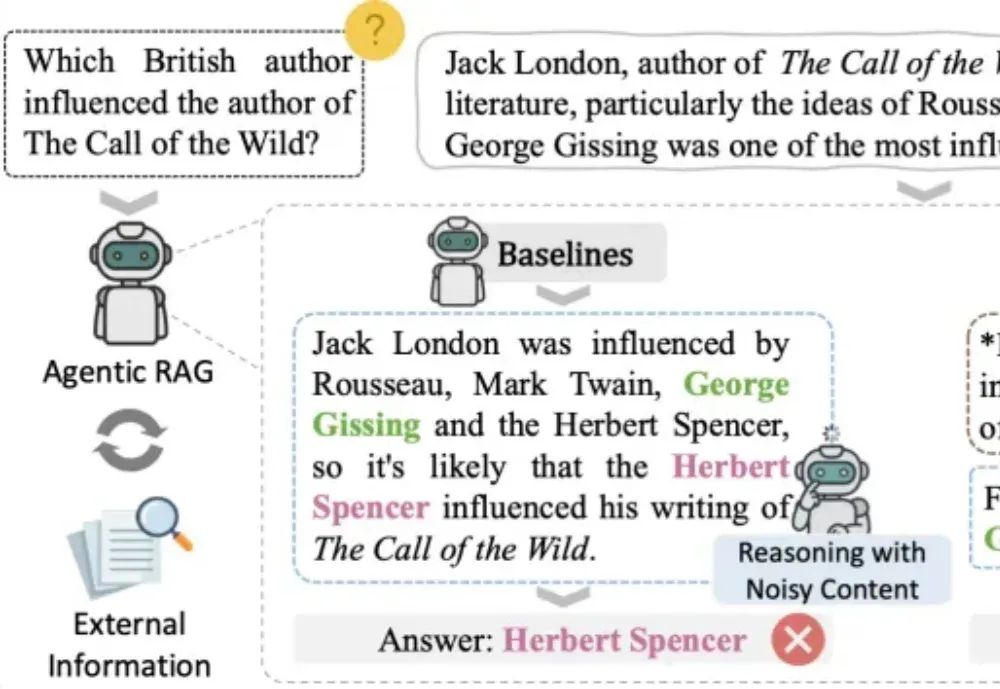
在检索增强生成(RAG)飞速发展的当下,研究者们面临的最大困境并非「生成」,而是「稳定」。
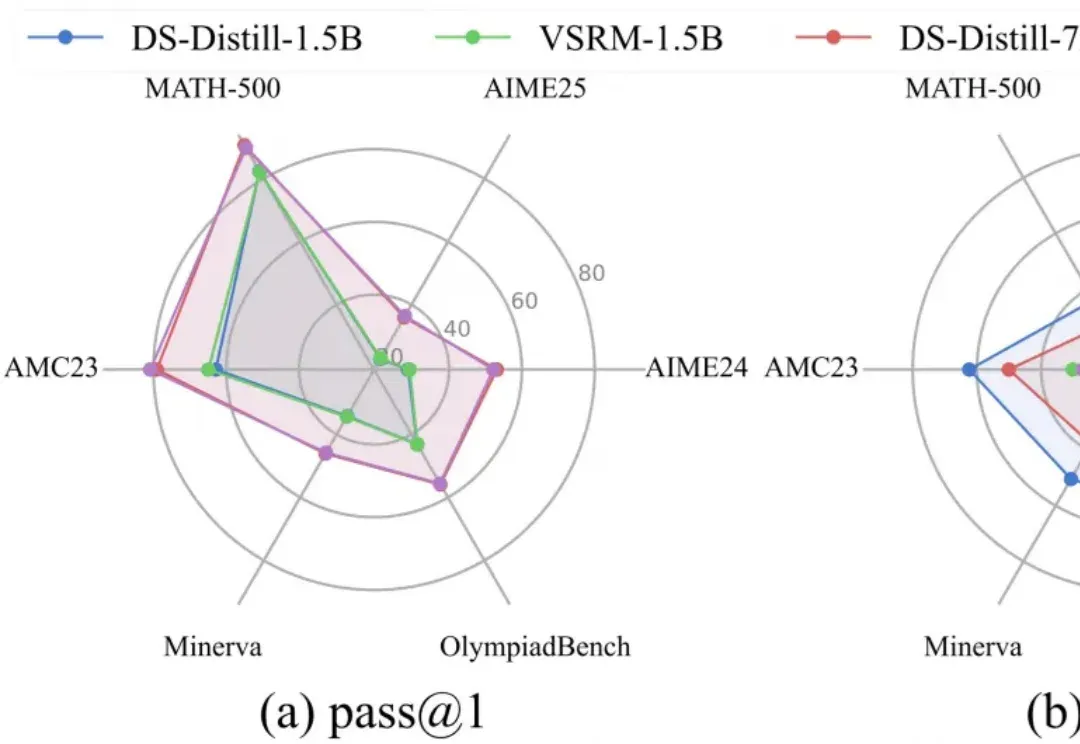
LRM通过简单却有效的RLVR范式,培养了强大的CoT推理能力,但伴随而来的冗长的输出内容,不仅显著增加推理开销,还会影响服务的吞吐量,这种消磨用户耐心的现象被称为“过度思考”问题。
幻觉并非什么神秘现象,而是现代语言模型训练和评估方式下必然的统计结果。它是一种无意的、因不确定而产生的错误。根据OpenAI9月4号论文的证明,模型产生幻觉(Hallucination),是一种系统性缺陷。
唱衰人工智能不会带来更好的明天 —— 构建于人工智能之上的未来世界既非乌托邦,也非反乌托邦,而是充满无限奇幻可能的。
Thinking Machines Lab成立7个月,估值120亿美元,首次公开研究成果:LLM每次回答不一样的真凶——kernel缺乏批处理不变性。Lilian Weng更是爆猛料:首代旗舰叫 Connection Machine,还有更多在路上。
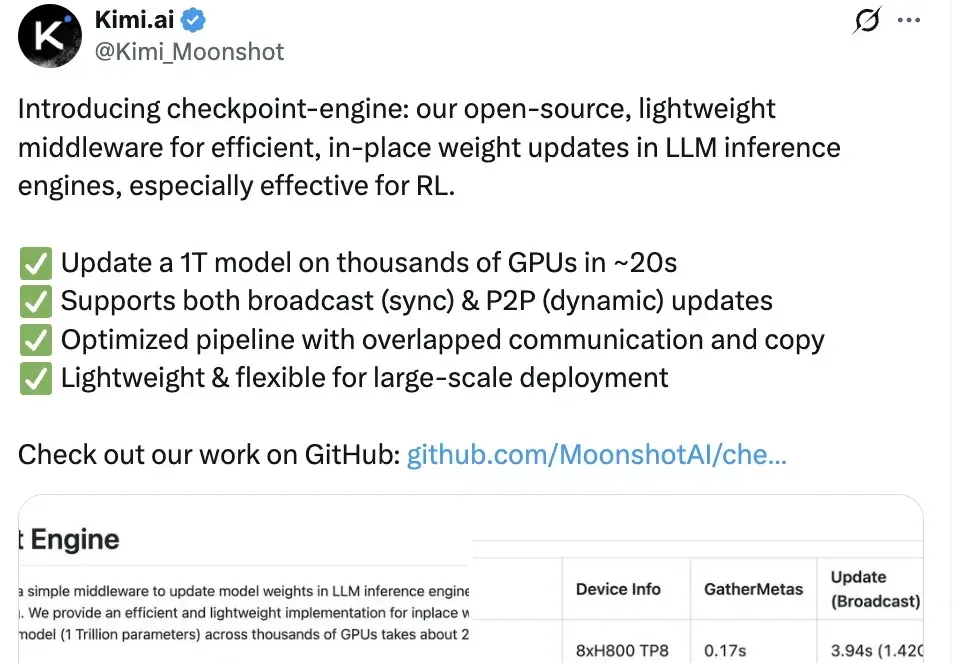
Kimi开源又双叒放大招了! 一个中间件,就能让Kimi K2的万亿模型参数进入“秒更时代”。 不仅支持一次性把更新完的权重从一个节点同时发送给所有节点,还能实现点对点动态更新。 网友也算是大开眼界了,可谓频频惊叹。 下面让我们一起看看这个中间件到底是如何发挥大作用的。 20秒更新万亿参数 此中间件名为checkpoint-engine(检查点引擎),主要用于强化学习中的一个关键步骤——在大语言模型推理过程中更新模型权重。 借助此组件,Kimi-K2只需约20秒就可实现在数千个GPU上更新1万亿参数。 与Kimi k1. 5类似,K2在同步强化学习训练中采用了混合共置架构,即训练引擎和推理引擎
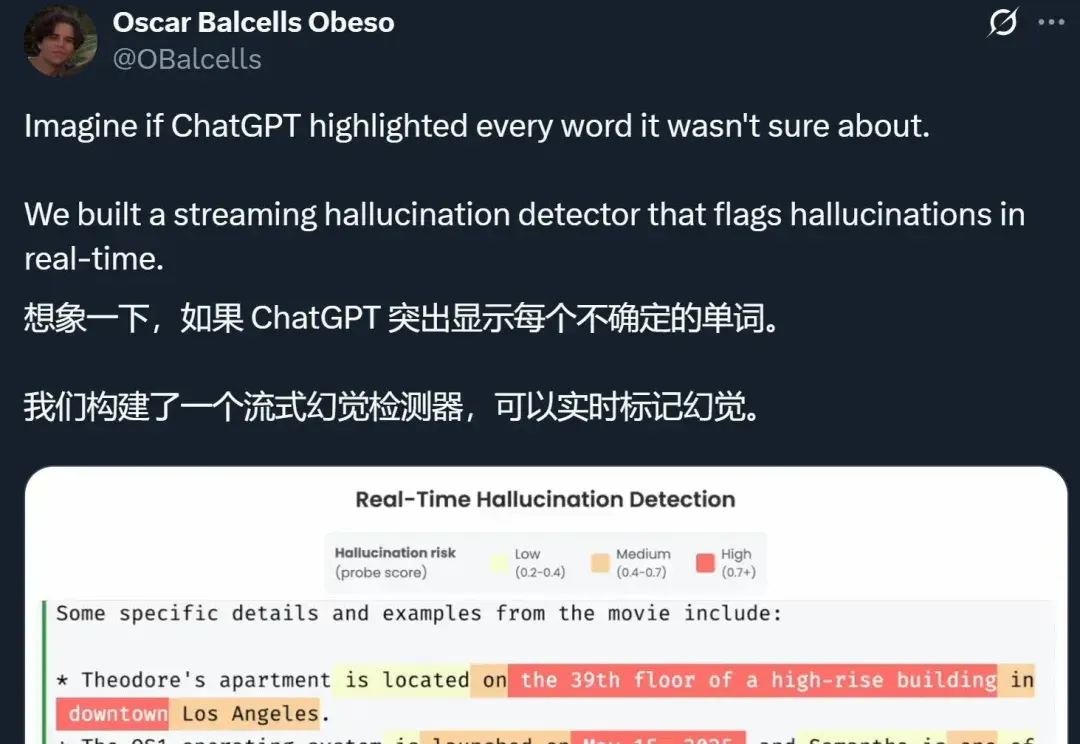
想象一下,如果 ChatGPT 等 AI 大模型在生成的时候,能把自己不确定的地方都标记出来,你会不会对它们生成的答案放心很多?
大语言模型的局限在哪里? AI教母李飞飞这样说: 大自然中是没有语言存在的,你不会从天空中直接看到文字。语言是一种纯粹的生成的信号。 语言信号的输出主要基于人类给的输入信号,可以说,语言是不独立于人之外的。 然而,物理世界是客观存在的。所以提取、理解、生成3D世界的数据、实现空间智能和处理语言问题时截然不同。 没想到,李飞飞一年前的访谈被扒出来,又引发大量围观。 她这段话意味着,大语言模型或许还不是真正的智能。 真正的智能将是信号感知、物理以及和现实世界相结合的产物。 下面来看看大家还在热议些啥吧。 空间智能可以借鉴语言模型,但仍存在本质差异 这场讨论的焦点在于,现在基于语言信号训练的模型到底
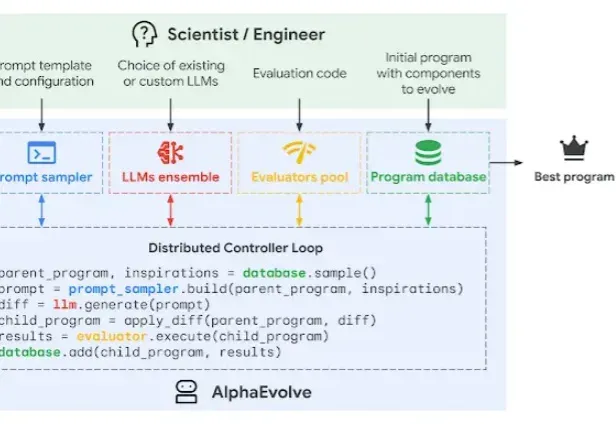
AI 开发复杂软件的时代即将到来? 近年来,以 Google 的 AlphaEvolve 为代表的研究已经证明,AI 智能体可以通过迭代来优化算法,甚至在某些小型、独立的编程任务上超越人类。然而,这些工作大多局限于几百行代码的「算法内核」或单个文件。 但现实世界的软件,比如一个顶级的 SAT 求解器,是一个庞大而复杂的系统工程,包含数百个文件、精密的编译系统和无数相互关联的模块。手动打造一个冠军级求解器不仅需要极高的领域知识,而且投入产出比越来越低。 为此,NVIDIA Research 的研究人员提出了 SATLUTION,首个将 LLM 代码进化能力从「算法内核」扩展到「完整代码库」规模的
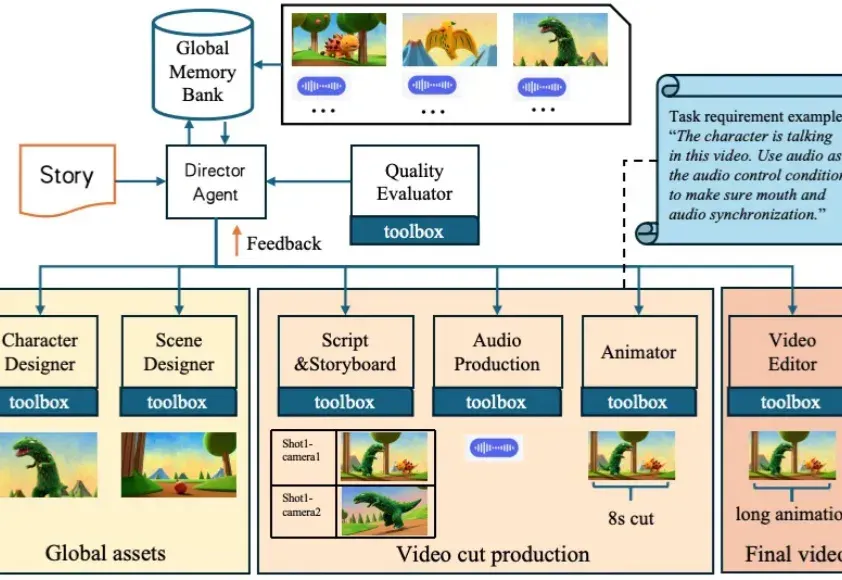
单台 8 卡 A800 仅需 8 秒即可生成 5 秒视频。
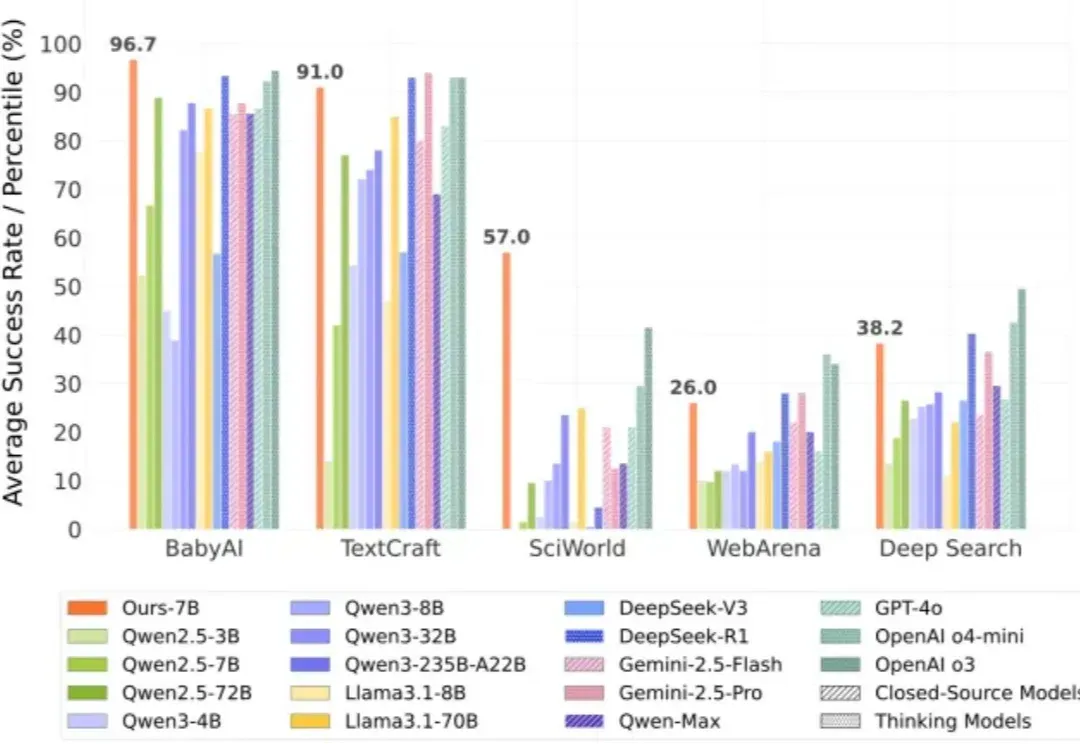
强化学习之父、2024 年 ACM 图灵奖得主 Richard Sutton 曾指出,人工智能正在迈入「经验时代」—— 在这个时代,真正的智能不再仅仅依赖大量标注数据的监督学习,而是来源于在真实环境中主动探索、不断积累经验的能力。
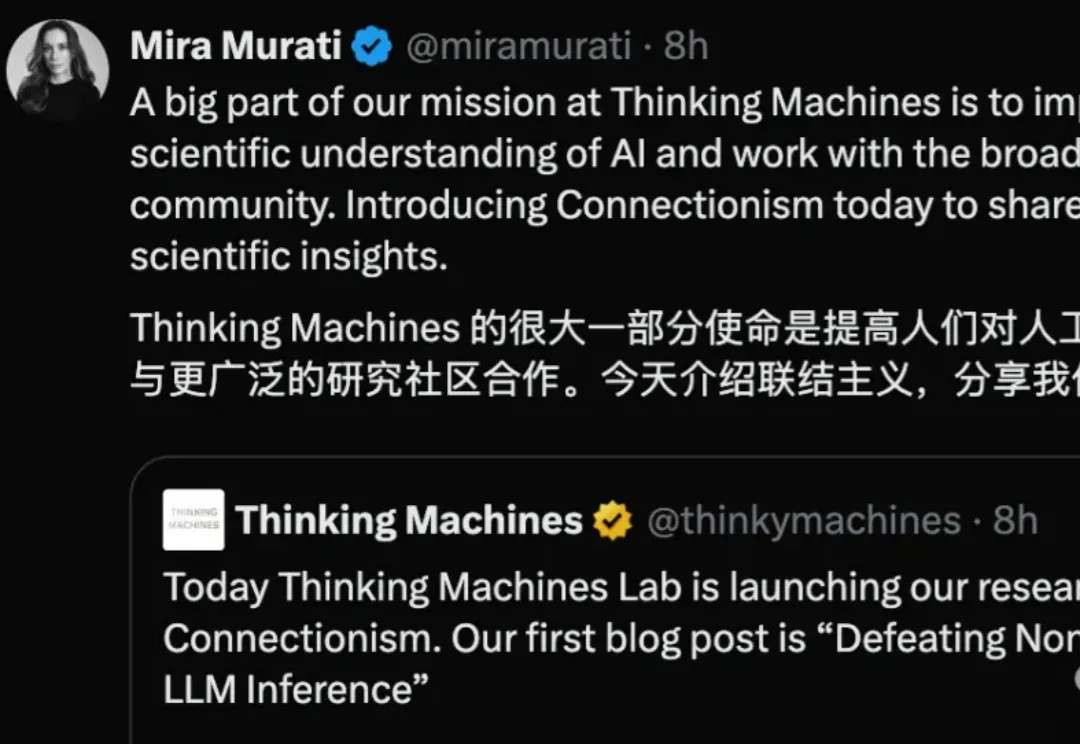
刚刚,0产出估值就已冲破120亿美元的Thinking Machines,终于发布首篇研究博客。
我们今天正式开源 jina-code-embeddings,一套全新的代码向量模型。包含 0.5B 和 1.5B 两种参数规模,并同步推出了 1-4 bit 的 GGUF 量化版本,方便在各类端侧硬件上部署。
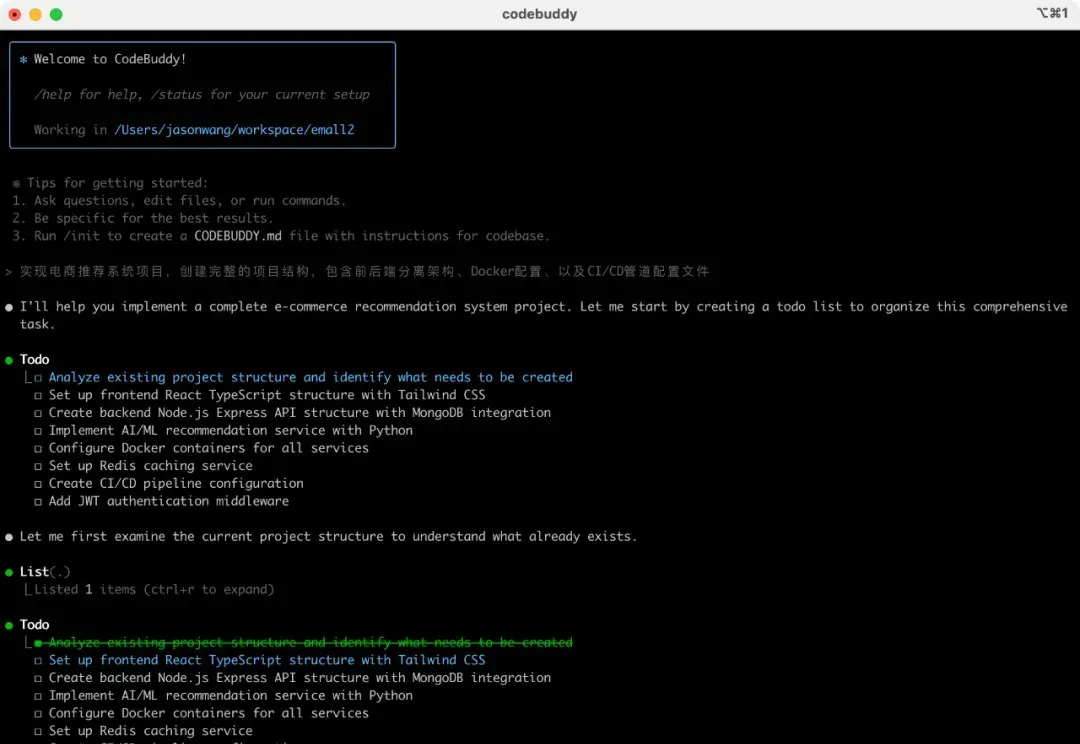
作为一名有着8年全栈开发经验的技术人员,我最近接手了一个具有挑战性的项目:为某中型服装电商平台开发一套智能商品推荐系统。该系统需要在2个月内完成,包含以下核心功能:
参与交流
了解加入交流群的方式,阅读内容无需登录。