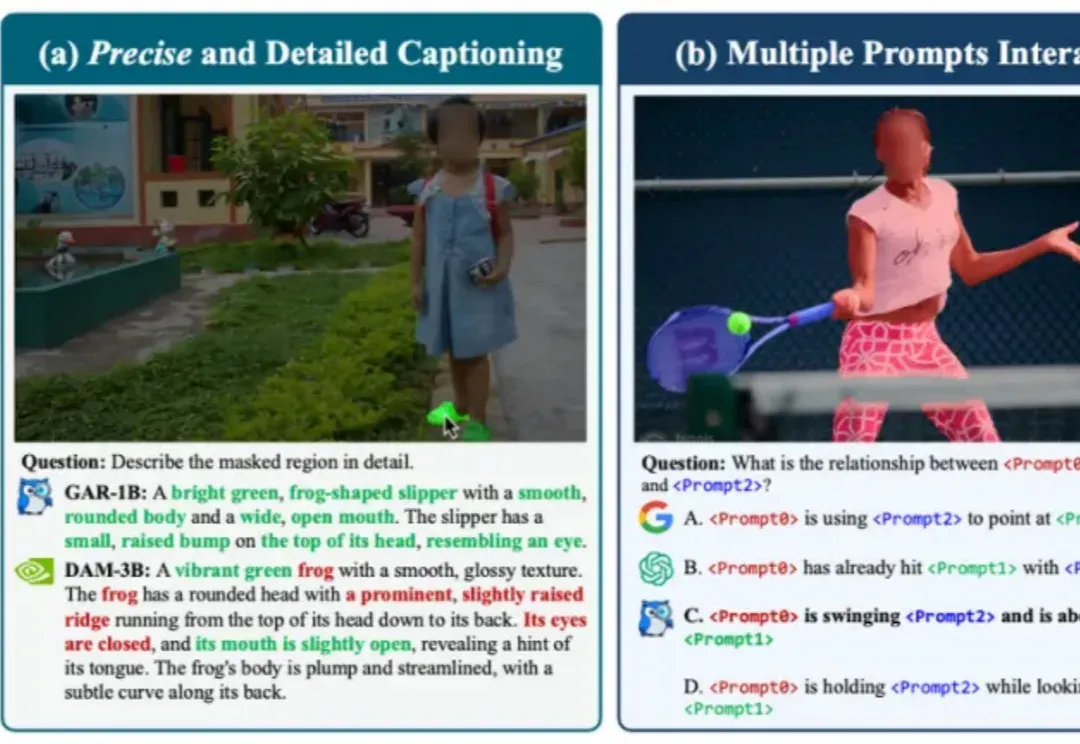
超越英伟达Describe Anything!中科院 & 字节联合提出「GAR」,为DeepSeek-OCR添砖加瓦(在新窗口打开)
近期,DeepSeek-OCR提出了“Vision as Context Compression”的新思路,然而它主要研究的是通过模型的OCR能力,用图片压缩文档。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
近期,DeepSeek-OCR提出了“Vision as Context Compression”的新思路,然而它主要研究的是通过模型的OCR能力,用图片压缩文档。
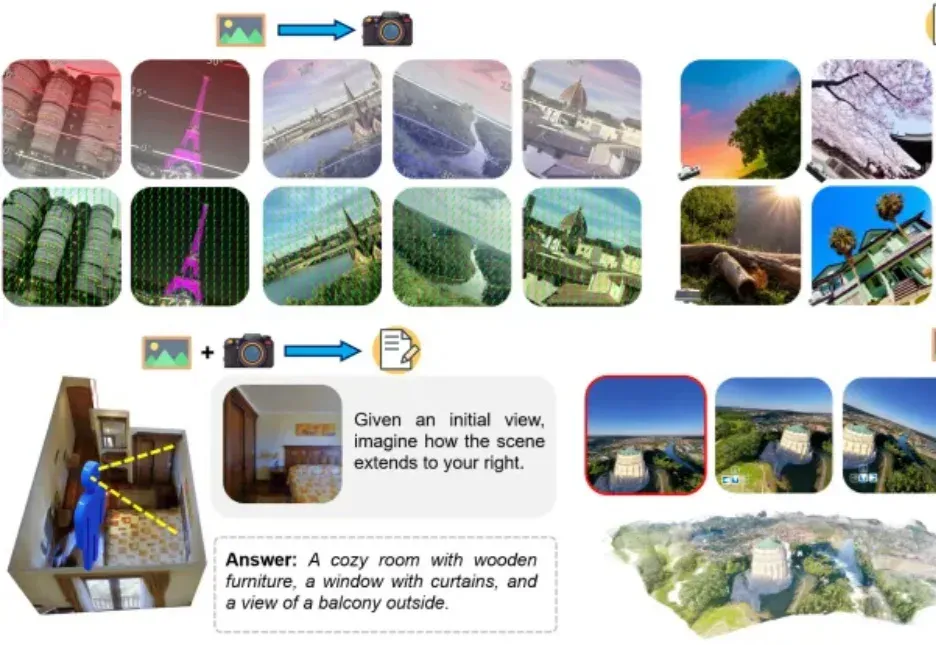
能看懂相机参数,并且生成相应视角图片的多模态模型来了。
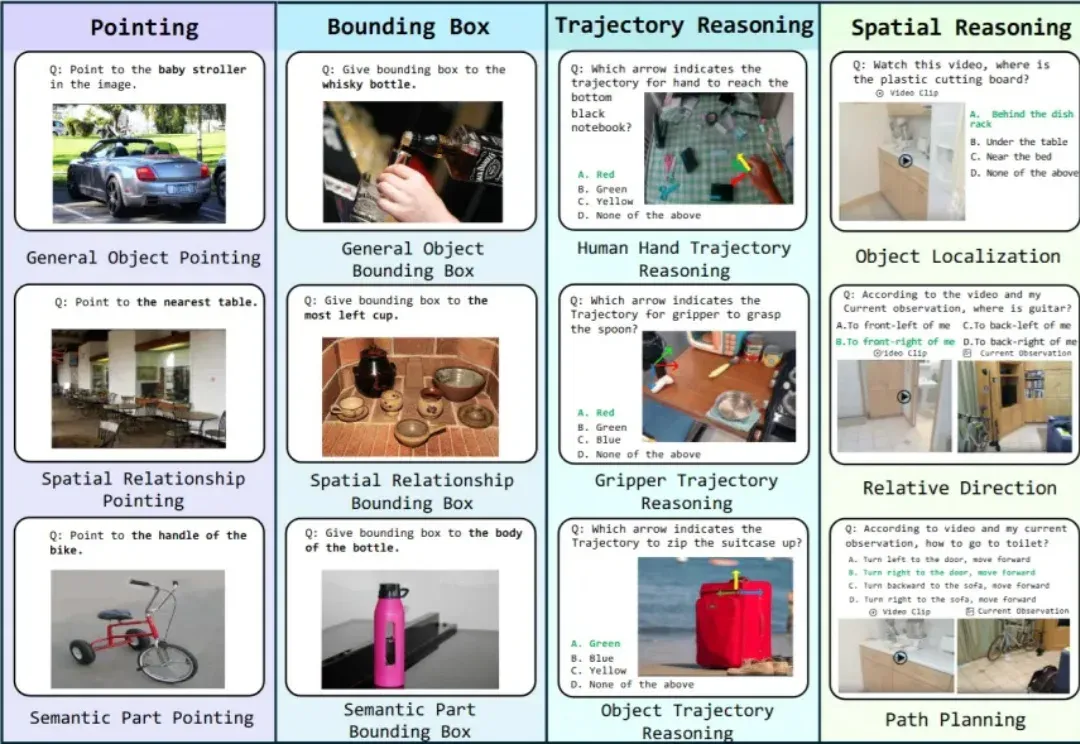
具身智能是近年来非常火概念。一个智能体(比如人)能够在环境中完成感知、理解与决策的闭环,并通过环境反馈不断进入新一轮循环,直至任务完成。这一过程往往依赖多种技能,涵盖了底层视觉对齐,空间感知,到上层决策的不同能力,这些能力便是广义上的具身智能。
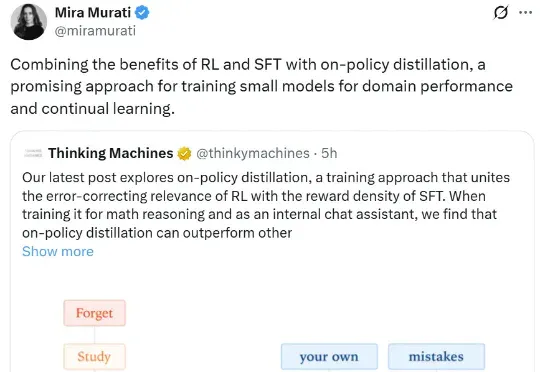
刚刚,不发论文、爱发博客的 Thinking Machines Lab (以下简称 TML)再次更新,发布了一篇题为《在策略蒸馏》的博客。在策略蒸馏(on-policy distillation)是一种将强化学习 (RL) 的纠错相关性与 SFT 的奖励密度相结合的训练方法。在将其用于数学推理和内部聊天助手时,TML 发现在策略蒸馏可以极低的成本超越其他方法。
学界杀入主赛道!UCL 校园团队 EuniAI 抛出开源智能体 Prometheus,在 SWE-bench Verified 上 71.2% Pass@1、主榜实锤合并;成本低至 $0.23/issue。
OpenAI 发布了一份报告: AI in Japan: OpenAI’s Economic Blueprint 如何利用 AI,加速创新、增强竞争力,并推动可持续、包容性的增长
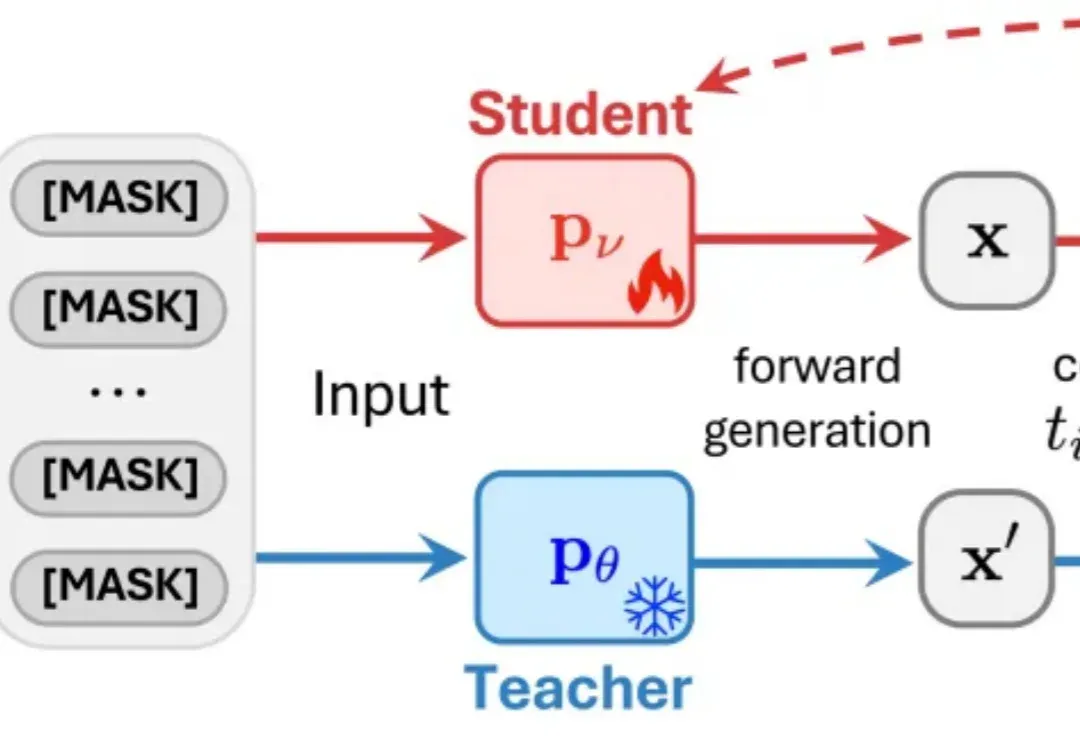
近日,来自普渡大学、德克萨斯大学、新加坡国立大学、摩根士丹利机器学习研究、小红书 hi-lab 的研究者联合提出了一种对离散扩散大语言模型的后训练方法 —— Discrete Diffusion Divergence Instruct (DiDi-Instruct)。经过 DiDi-Instruct 后训练的扩散大语言模型可以以 60 倍的加速超越传统的 GPT 模型和扩散大语言模型。
3D点云异常检测对制造、打印等领域至关重要,可传统方法常丢细节、难修复。上海科大与密歇根大学携手打造PASDF框架,借助「姿态对齐+连续表征」技术,达成检测修复一体化,实验显示其精准又稳定。
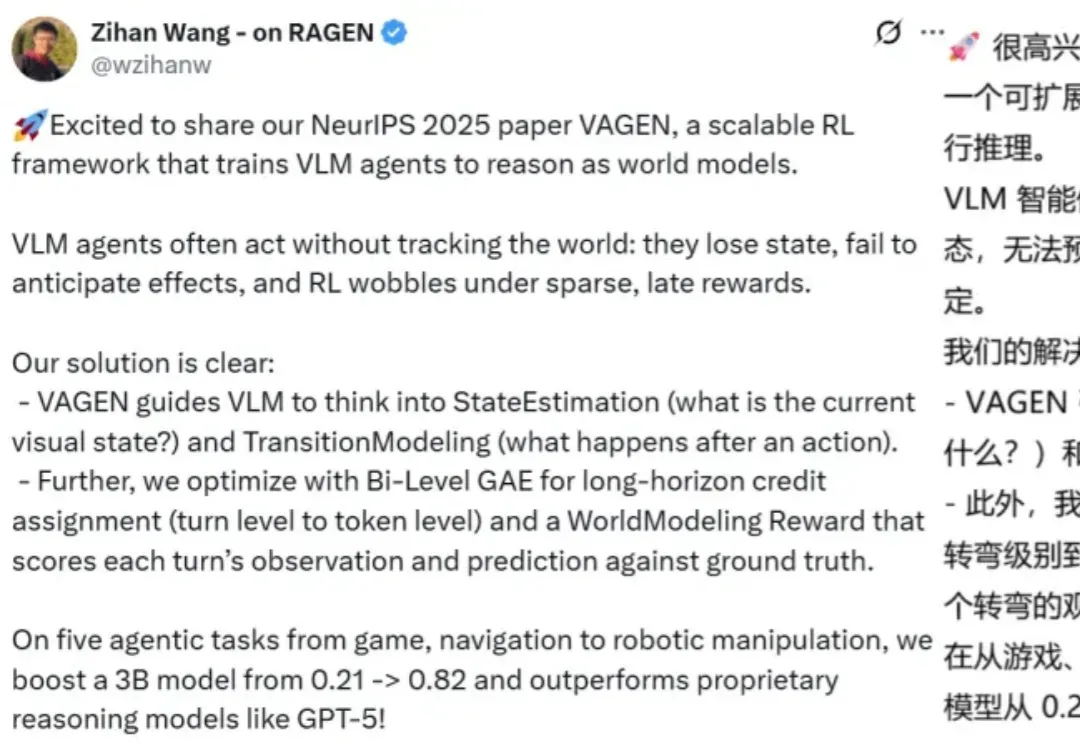
当今的 AI 智能体(Agent)越来越强大,尤其是像 VLM(视觉-语言模型)这样能「看懂」世界的智能体。但研究者发现一个大问题:相比于只处理文本的 LLM 智能体,VLM 智能体在面对复杂的视觉任务时,常常表现得像一个「莽撞的执行者」,而不是一个「深思熟虑的思考者」。
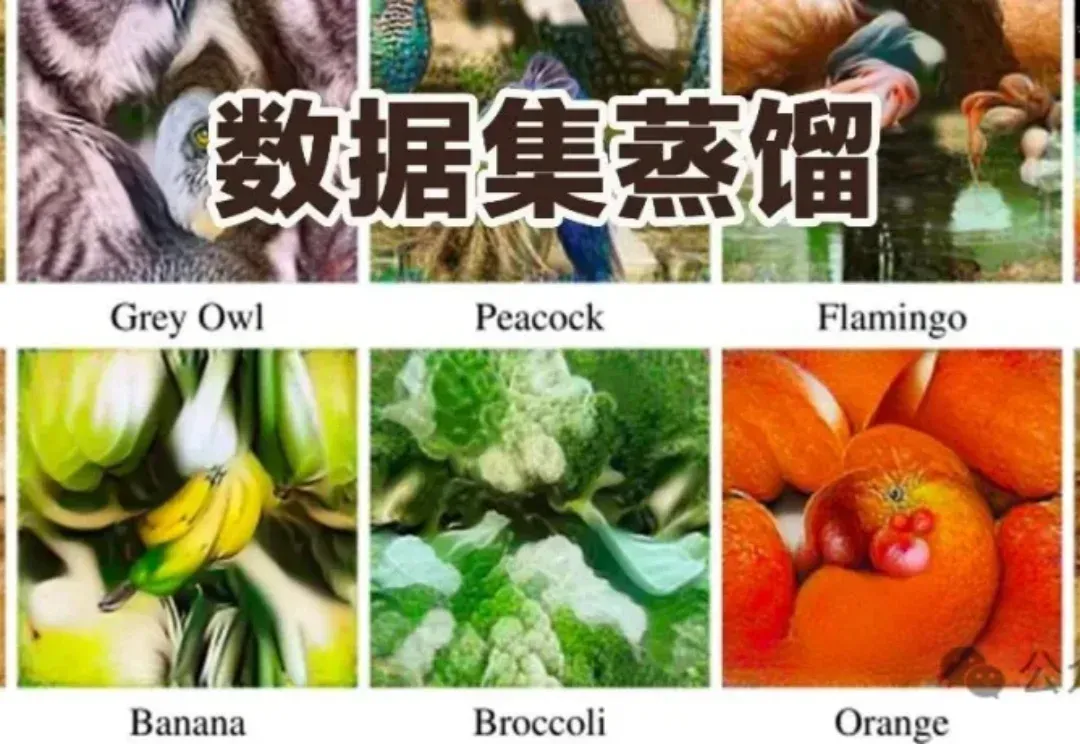
数据集蒸馏是一种用少量合成数据替代全量数据训练模型的技术,能让模型高效又节能。WMDD和GUARD两项研究分别解决了如何保留原始数据特性并提升模型对抗扰动能力的问题,使模型在少量数据上训练时既准确又可靠。
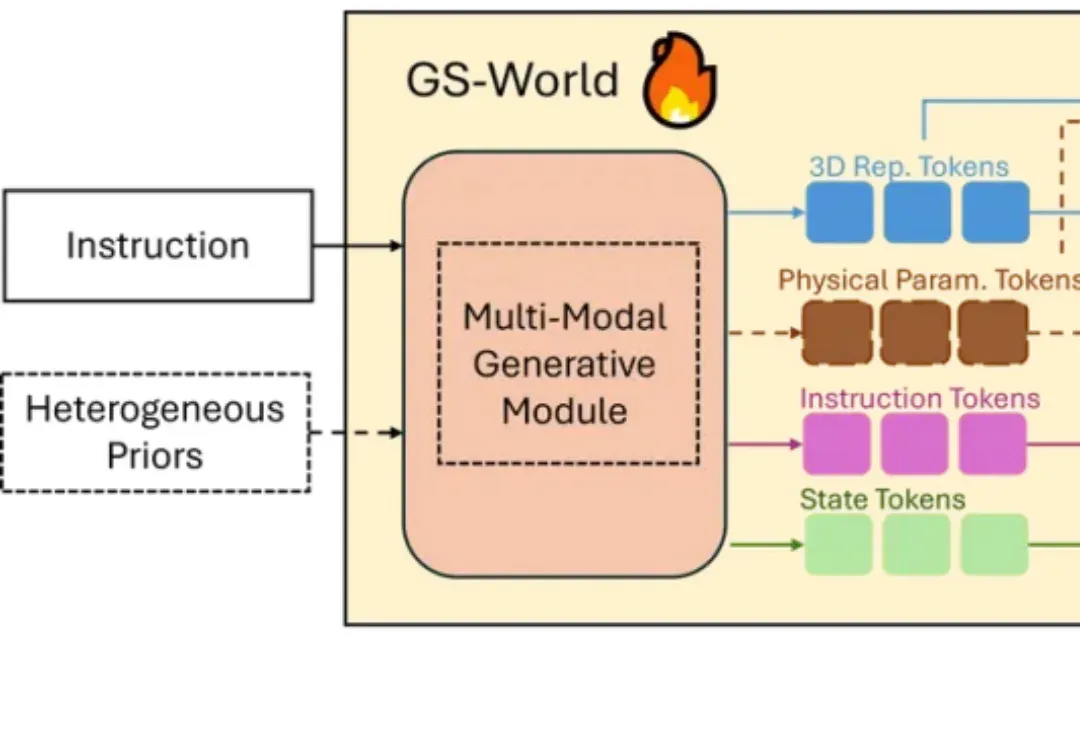
2025 年秋的具身智能赛道正被巨头动态点燃:特斯拉上海超级工厂宣布 Optimus 2.0 量产下线,同步开放开发者平台提供运动控制与环境感知 SDK,试图通过生态共建破解数据孤岛难题;英伟达则在 SIGGRAPH 大会抛出物理 AI 全栈方案,其 Omniverse 平台结合 Cosmos 世界模型可生成高质量合成数据,直指真机数据短缺痛点。
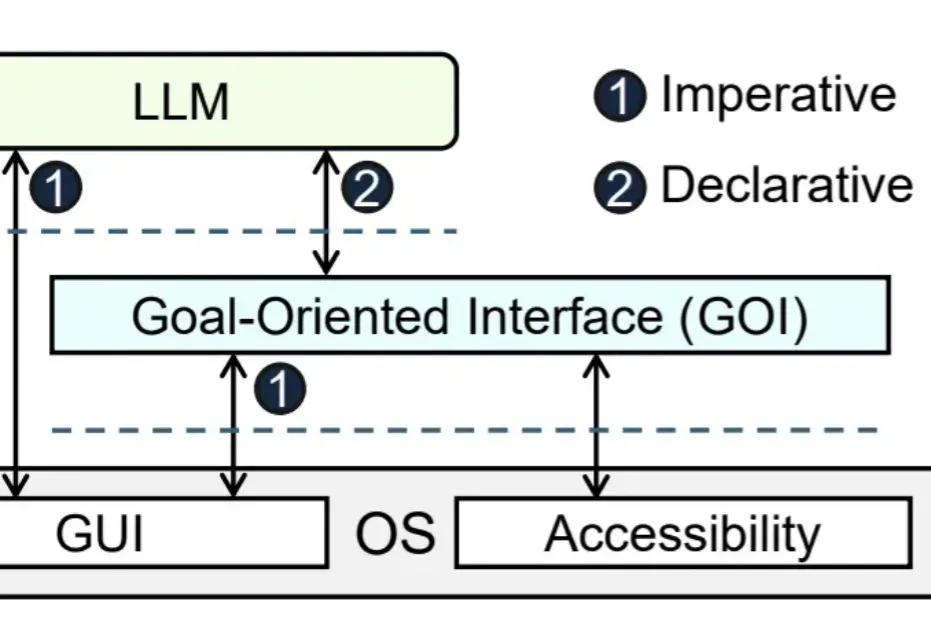
大模型Agent帮你自动操作电脑,理想很丰满,现实却骨感。
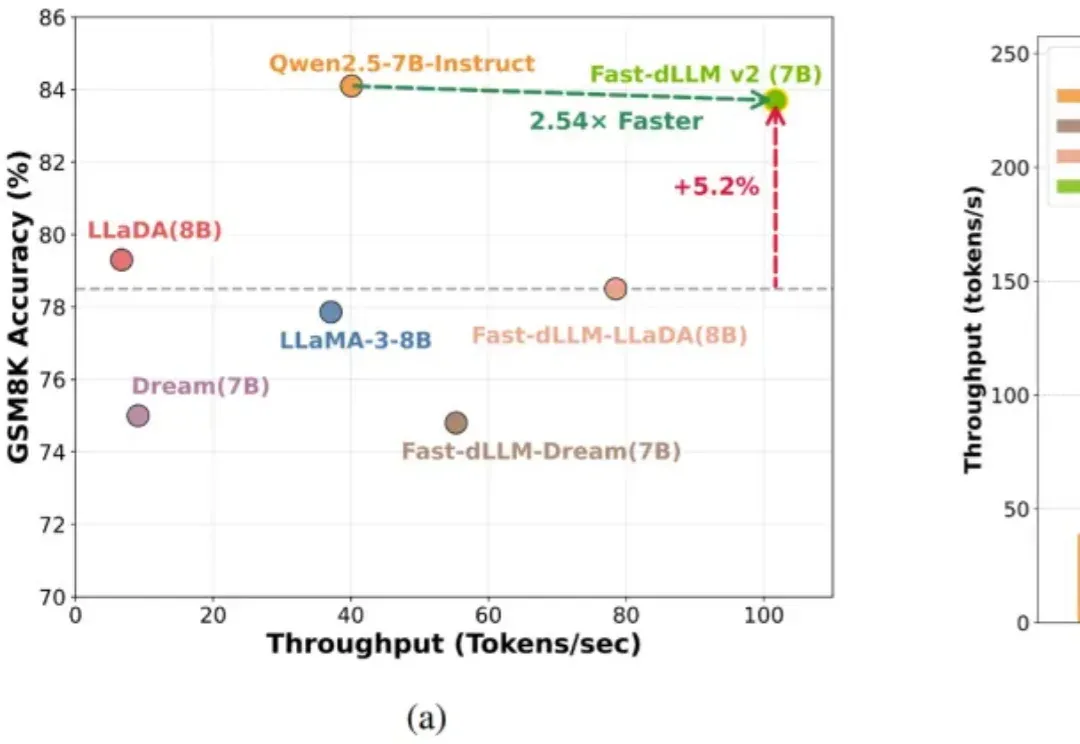
自回归(AR)大语言模型逐 token 顺序解码的范式限制了推理效率;扩散 LLM(dLLM)以并行生成见长,但过去难以稳定跑赢自回归(AR)模型,尤其是在 KV Cache 复用、和 可变长度 支持上仍存挑战。
十月,《纽约时报》发表了题为《The A.I. Prompt That Could End the World》(《那个可能终结世界的 AI 提示词》)的文章。作者 Stephen Witt 采访了多位业内人士:有 AI 先驱,图灵奖获奖者 Yoshua Bengio;以越狱测试著称的 Leonard Tang;以及专门研究模型欺骗的 Marius Hobbhahn。
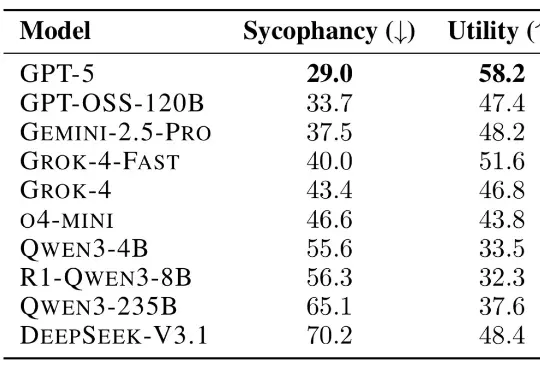
在一篇论文中,研究人员测试了 11 种 LLM 如何回应超过 11500 条寻求建议的查询,其中许多查询描述了不当行为或伤害。结果发现 LLM 附和用户行为的频率比人类高出 50%,即便用户的提问涉及操纵、欺骗或其他人际伤害等情境,模型仍倾向于给予肯定回应。
在开放研究领域里,苹果似乎一整个脱胎换骨,在纯粹的研究中经常会有一些出彩的工作。这次苹果发布的研究成果的确出人意料:他们用谷歌的 Nano-banana 模型做个了视觉编辑领域的 ImageNet。
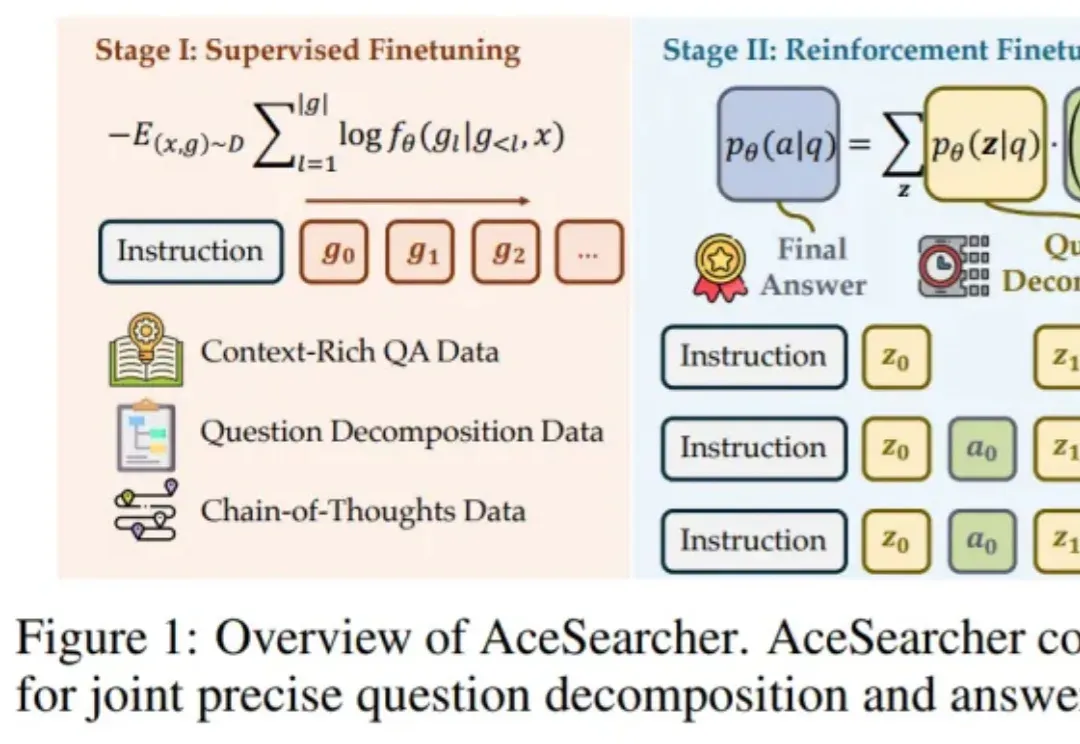
如何让一个并不巨大的开源大模型,在面对需要多步检索与复杂逻辑整合的问题时,依然像 “冷静的研究员” 那样先拆解、再查证、后归纳,最后给出可核实的结论?
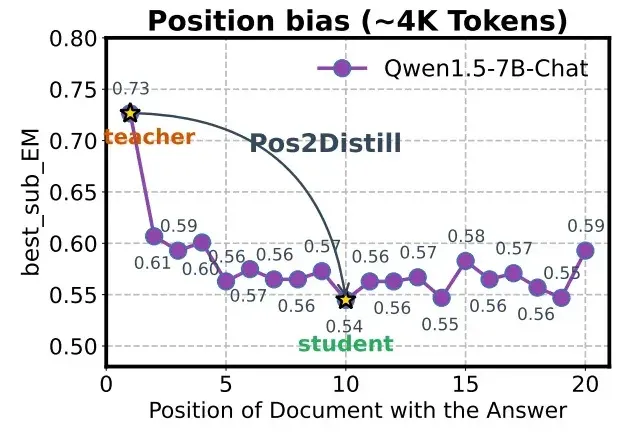
语言模型遭遇严重的位置偏见,即模型对不同上下⽂位置的敏感度不⼀致。模型倾向于过度关注输⼊序列中的特定位置,严重制约了它们在复杂推理、⻓⽂本理解以及模型评估等关键任务上的表现。
聚焦大型语言模型(LLMs)的安全漏洞,研究人员提出了全新的越狱攻击范式与防御策略,深入剖析了模型在生成过程中的注意力变化规律,为LLMs安全研究提供了重要参考。论文已被EMNLP2025接收
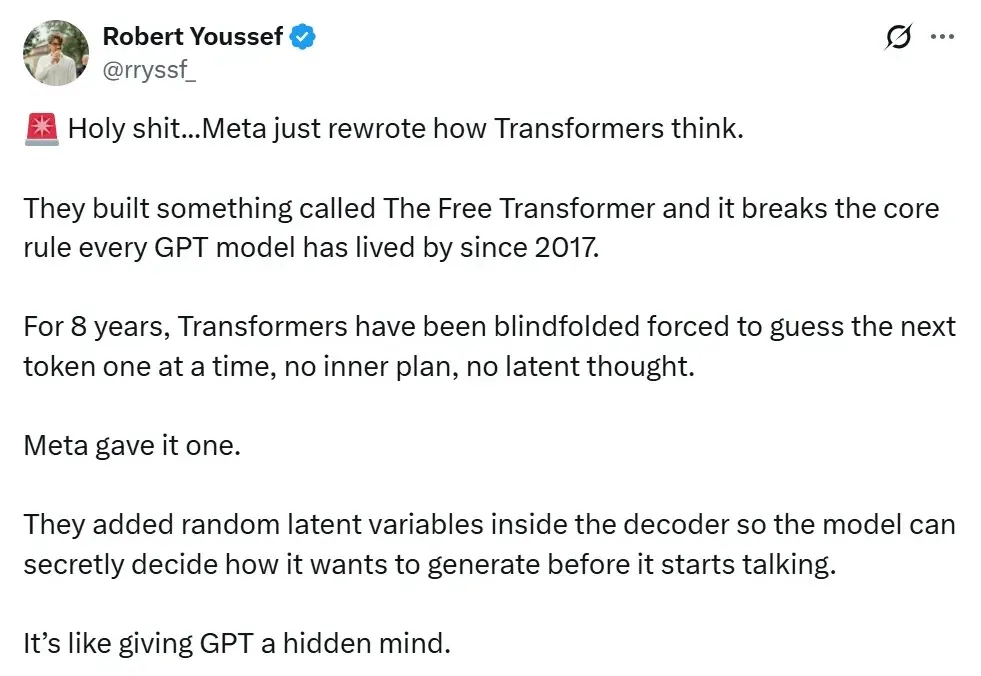
最近的 Meta 可谓大动作不断,一边疯狂裁人,一边又高强度产出论文。
参与交流
了解加入交流群的方式,阅读内容无需登录。