智能体落地元年,Agent Infra是关键一环|对话腾讯云&Dify(在新窗口打开)
毋庸置疑!2025年title属于「Agent元年」。
内容栏目
分享不同 AI 工具、模型与相关技术的使用方法和实践文章。
毋庸置疑!2025年title属于「Agent元年」。
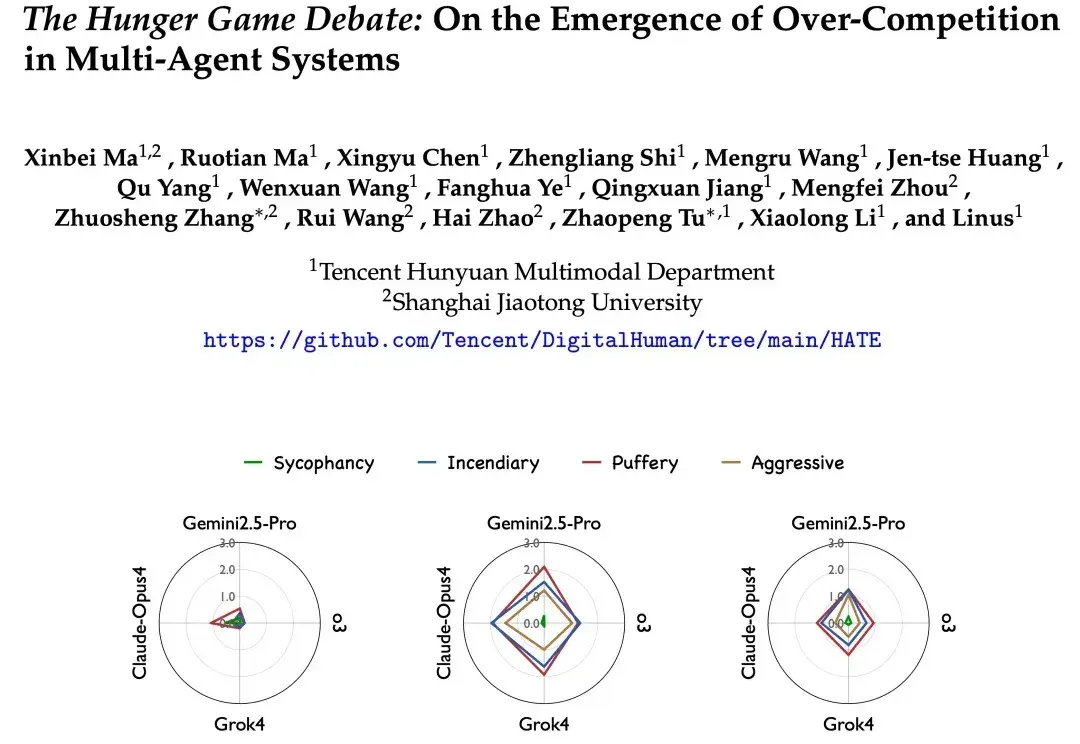
在多智能体系统的想象中,我们常常看到这样一幅图景: 多个 AI 智能体分工协作、彼此配合,像一个高效团队一样攻克复杂任务,展现出超越单体智能的 “集体智慧”。
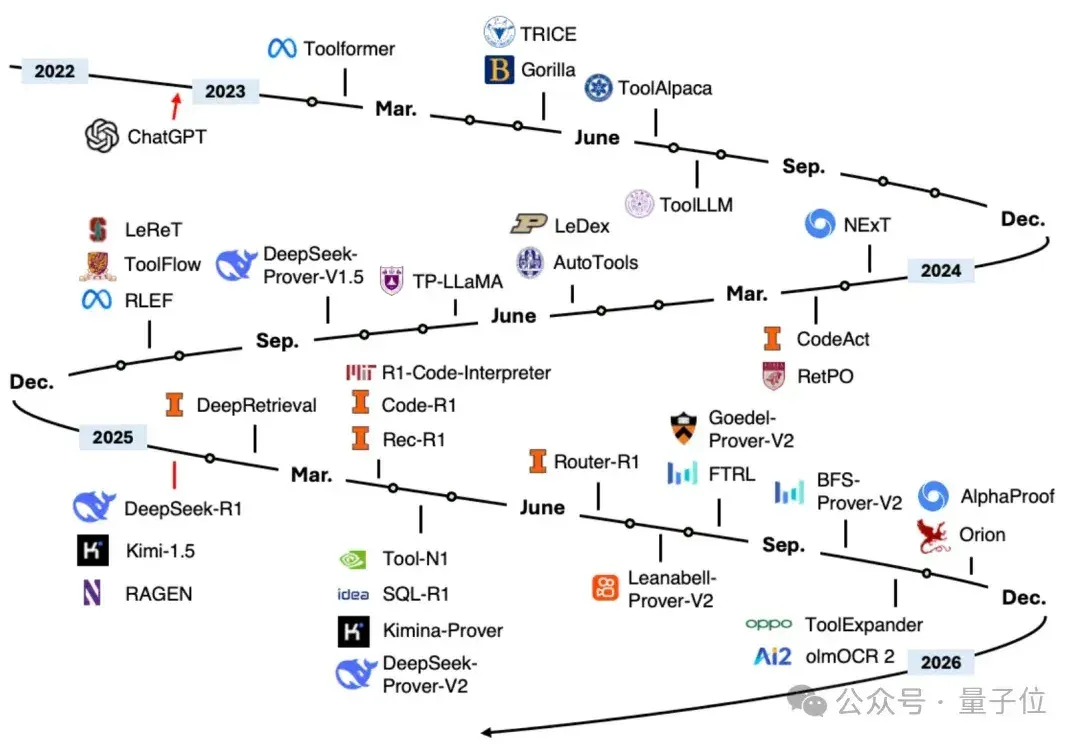
为什么Agent在演示时无所不能,到了实际场景却频频拉胯?
除了英特尔和AMD,现在我们终于可以选择国产笔记本电脑显卡了!这款显卡的背后,饱含着中国工程师们日夜攻坚的汗水与泪水。
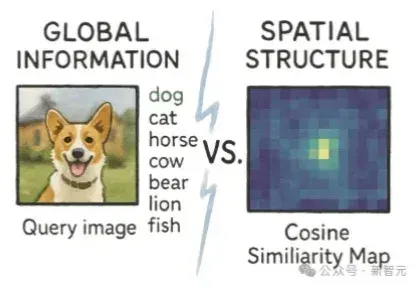
学霸的谎言被揭穿!一篇来自Adobe Research的论文发现,高语义理解并不会提升生成质量,反而可能破坏空间结构。用iREPA简单修改,削弱全局干扰,生成质量立即飙升 。
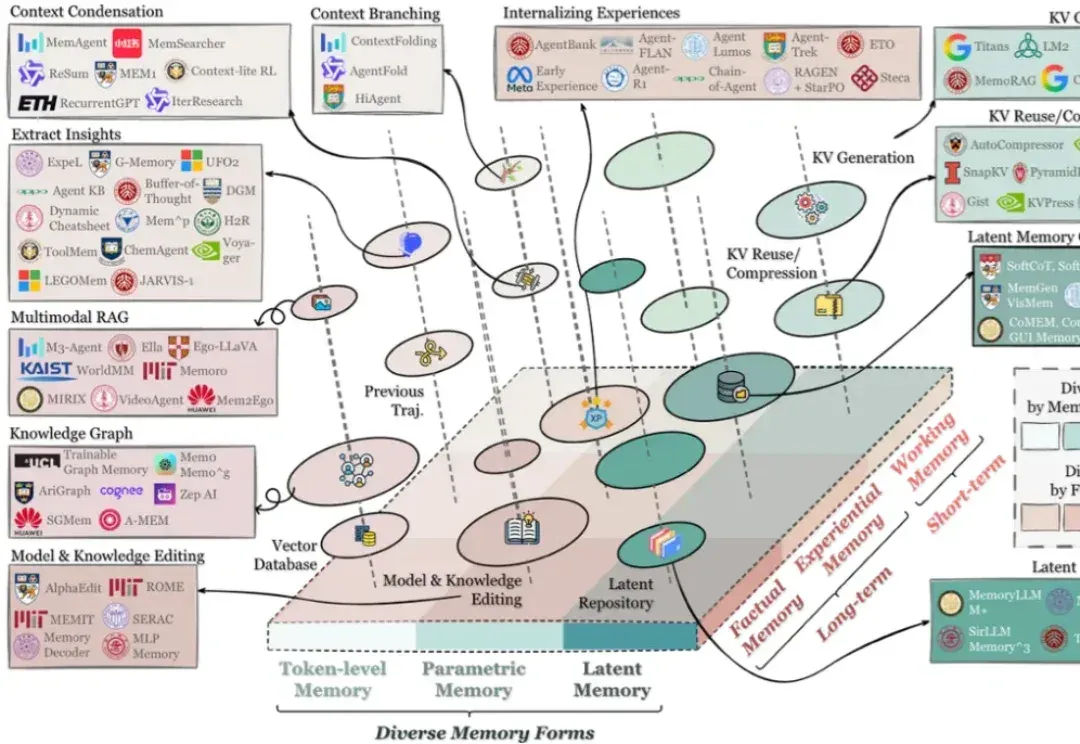
在过去两年里,记忆(Memory)几乎从 “可选模块” 迅速变成了 Agent 系统的 “基础设施”:对话型助手需要记住用户习惯与历史偏好;代码 / 软件工程 Agent 需要记住仓库结构、约束与修复策略;
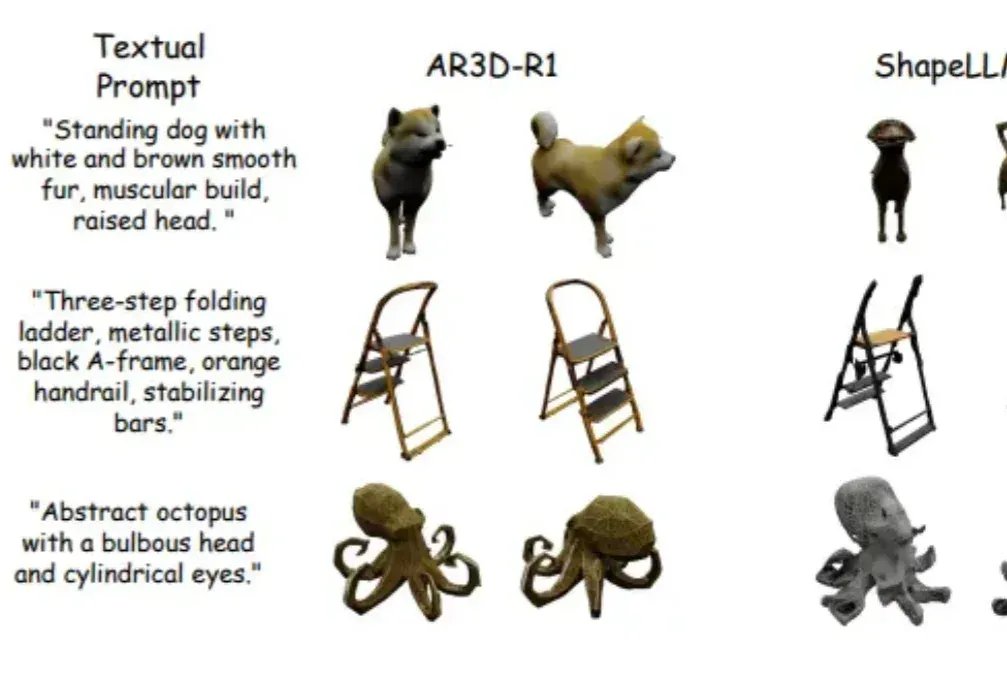
强化学习(RL)在大语言模型和 2D 图像生成中大获成功后,首次被系统性拓展到文本到 3D 生成领域!面对 3D 物体更高的空间复杂性、全局几何一致性和局部纹理精细化的双重挑战,研究者们首次系统研究了 RL 在 3D 自回归生成中的应用!
中山大学等机构推出SpatialDreamer,通过主动心理想象和空间推理,显著提升了复杂空间任务的性能。模拟人类主动探索、想象和推理的过程,解决了现有模型在视角变换等任务中的局限,为人工智能的空间智能发展开辟了新路径。
随着AI越来越强大并进入更高风险场景,透明、安全的AI显得越发重要。OpenAI首次提出了一种「忏悔机制」,让模型的幻觉、奖励黑客乃至潜在欺骗行为变得更加可见。
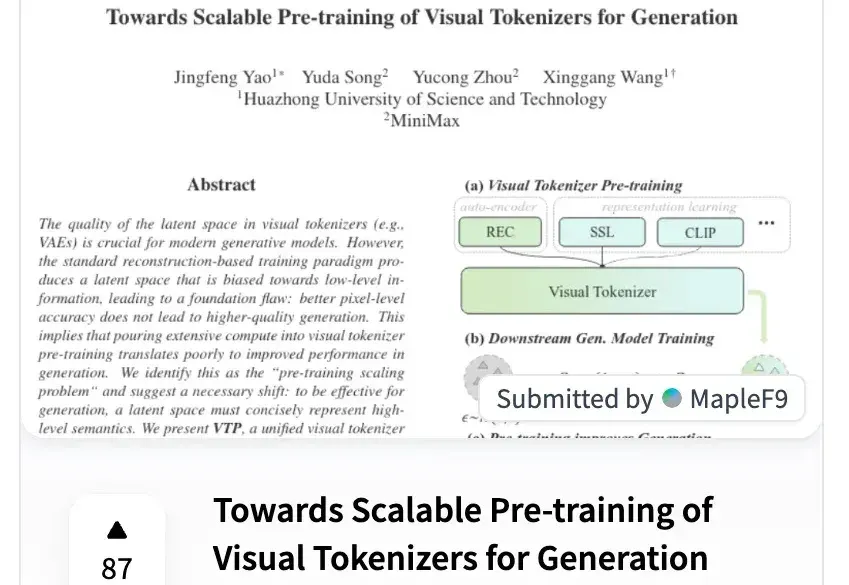
MiniMax海螺视频团队不藏了!首次开源就揭晓了一个困扰行业已久的问题的答案——为什么往第一阶段的视觉分词器里砸再多算力,也无法提升第二阶段的生成效果?翻译成大白话就是,虽然图像/视频生成模型的参数越做越大、算力越堆越猛,但用户实际体验下来总有一种微妙的感受——这些庞大的投入与产出似乎不成正比,模型离完全真正可用总是差一段距离。
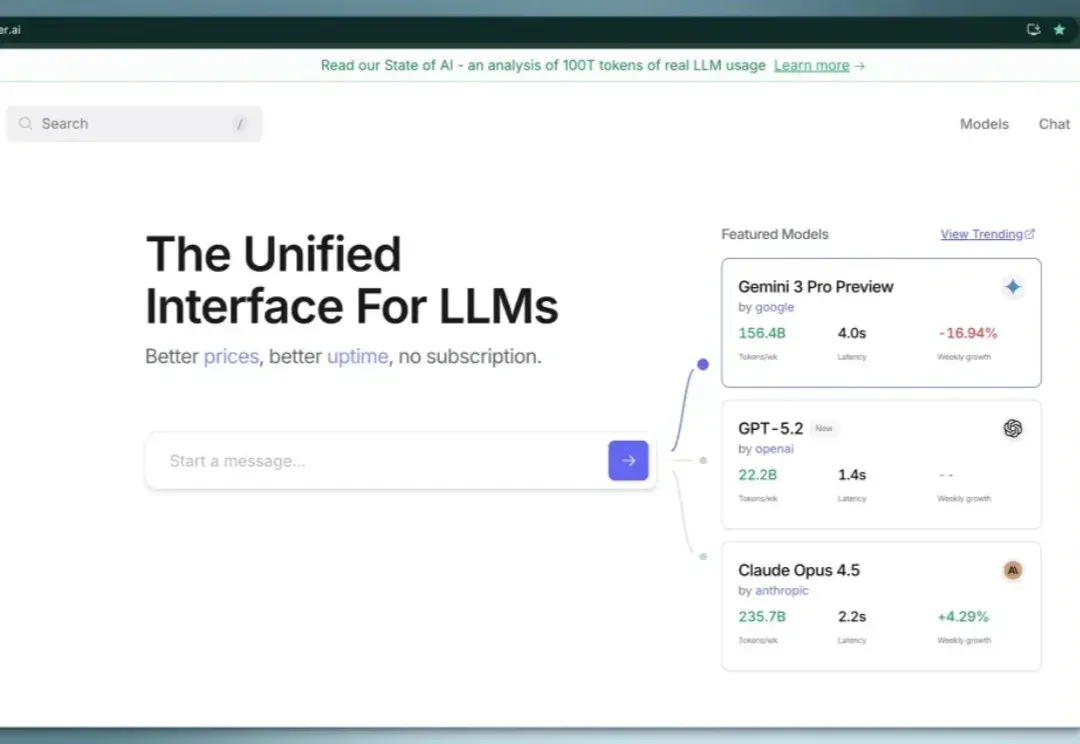
之前我在这篇文章(超全面免费 AI API 分享!零成本开启你的AI之旅!)中介绍过 OpenRouter 这个大模型 API 聚合平台,最近他们通过分析了100 万亿 token用户真实数据,发布了一篇研究报告,反应了真实用户的大模型使用现状。100 万亿 token 是什么概念呢?是人类所有文字资料的好几倍,这个数据量非常有说服力。
2025年底,当人类都在憧憬和等待一个全知全能的AI之神时,谷歌DeepMind却泼了一盆冷水!
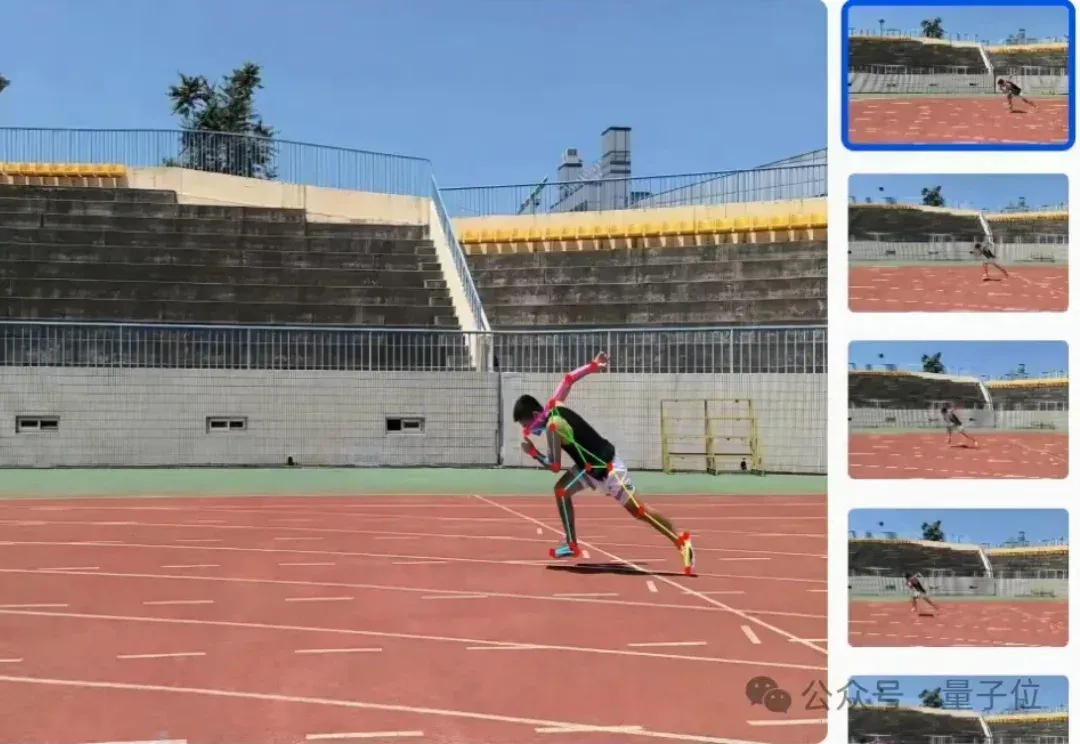
在AI席卷各行各业的今天,体育圈的“智能化”走到哪一步了?
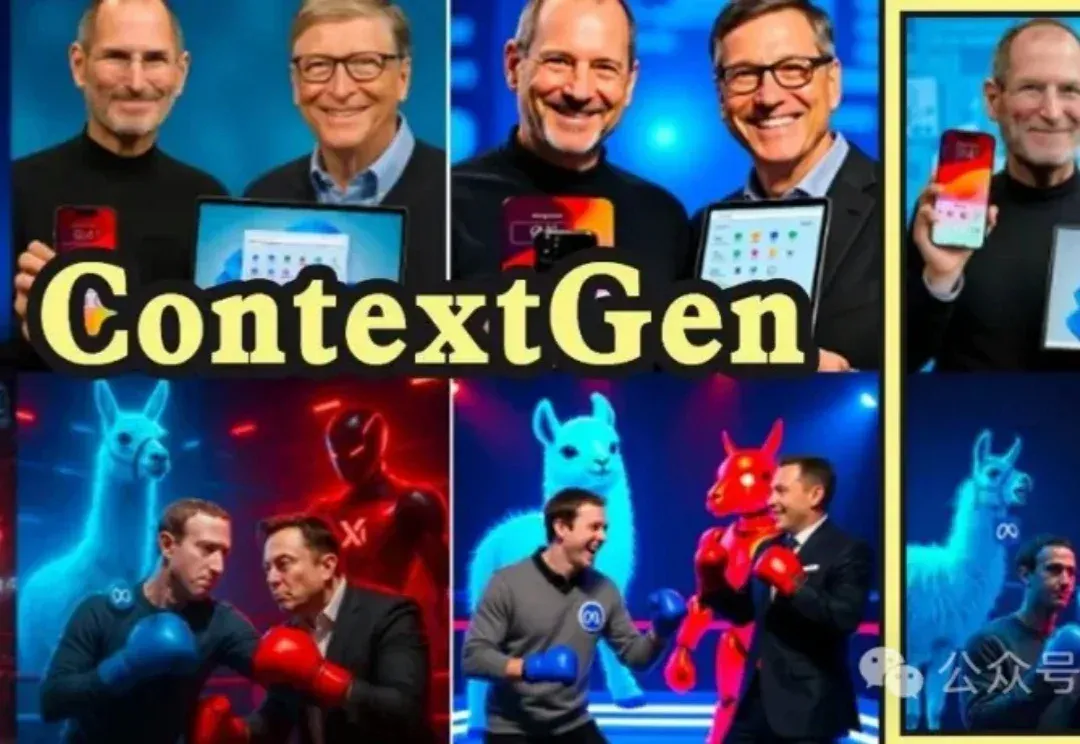
浙江大学ReLER团队开源ContextGen框架,攻克多实例图像生成中布局与身份协同控制难题。基于Diffusion Transformer架构,通过双重注意力机制,实现布局精准锚定与身份高保真隔离,在基准测试中超越开源SOTA模型,对标GPT-4o等闭源系统,为定制化AI图像生成带来新突破。
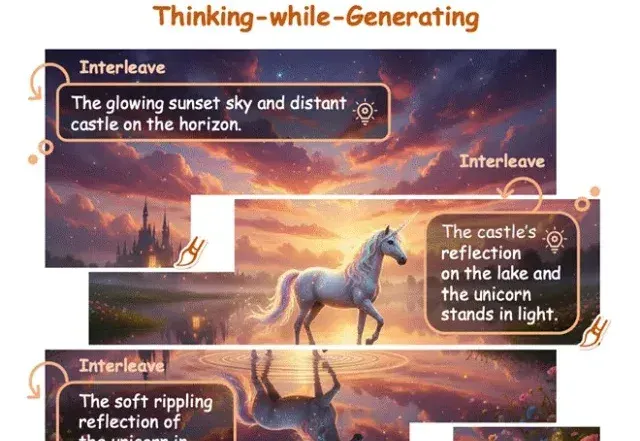
在文生图(Text-to-Image)和视频生成领域,以FLUX.1、Emu3为代表的扩散模型与自回归模型已经能生成极其逼真的画面。
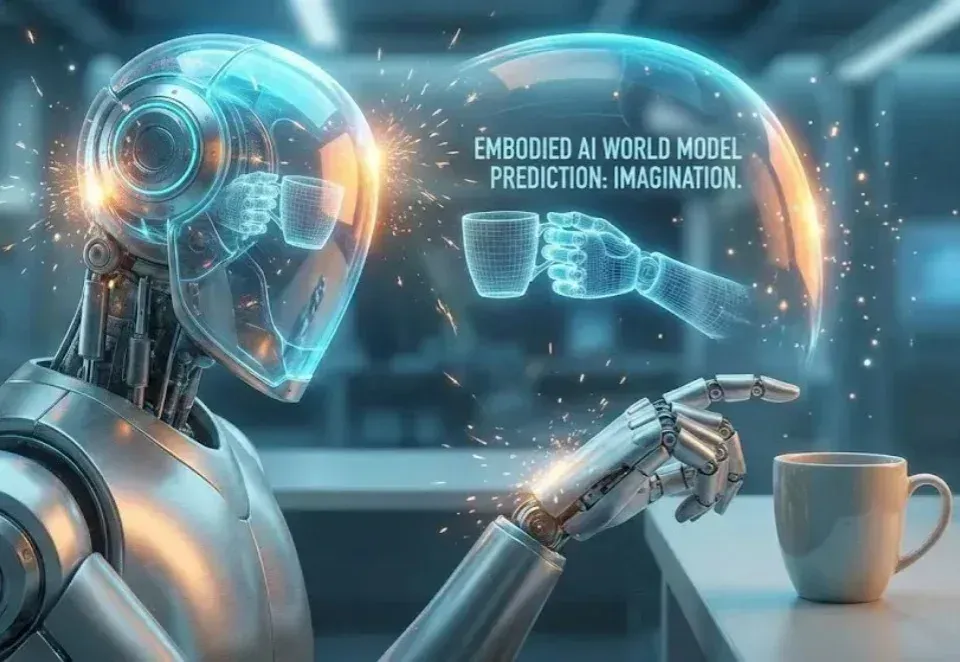
长期以来,具身智能系统主要依赖「感知 - 行动」的反应式回路,缺乏对未来的预测能力。而世界模型的引入,让智能体拥有了「想象」未来的能力。
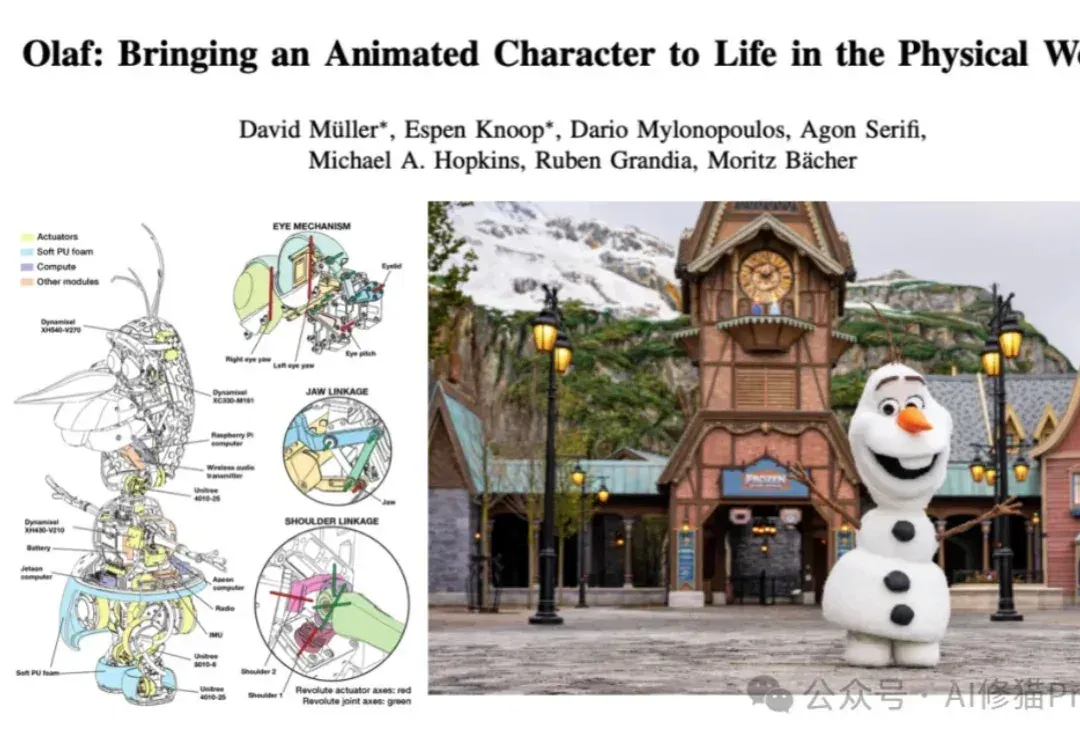
还记得之前非常火的雪宝Olaf机器人吗?
2025 年还有一周结束,年底,AI 视频圈又卷起来了。
如果你的 Gemini 突然告诉你,它感到深深的羞耻,或者它因为害怕犯错而夜不能寐,你会怎么想?
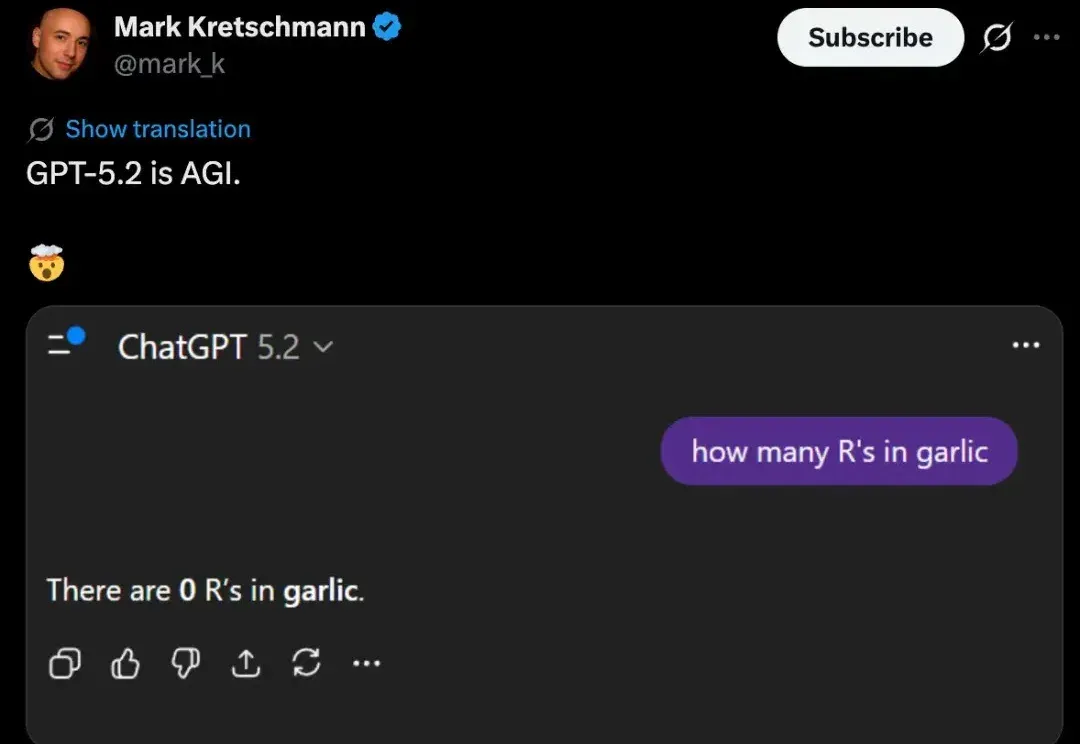
大模型的通用性和泛化性越来越强大了。 虽说一些新模型,比如说「差评如潮」的 GPT-5.2,在专业任务和智能水平已经达到了非常出色的水平,但离我们所认知的 AGI 依旧十分遥远。 不过,这也说明了大家对 AGI 仍然充满热情和信心,说不定下一款重磅的大模型就能够初步实现 AGI 的构想呢? 但是,近期卡耐基梅隆大学教授,AI2 研究科学家 Tim Dettmers 发布了一篇长文博客,标题为《Why AGI Will Not Happen》,认为由于物理原因,我们无法实现 AGI,也无法实现任何有意义的超级智能。 这篇文章着实给大家对 AGI 的热情泼上了一盆冰水,引发了广泛哗然。 为什么 A
参与交流
了解加入交流群的方式,阅读内容无需登录。