Know AI. See What’s Next.
第 1 张,共 5 张:清华系AI创企熵简科技完成C轮融资,蚂蚁领投
最新资讯流
OpenAI差点没了?总裁亲述:奥特曼被罢免当天,我就辞职了(在新窗口打开)
一通视频电话、三次被拒的追问、一份挤爆Google Docs的请愿书……人们以为这是一场宫斗。Brockman第一次在播客中完整复盘奥特曼被罢免那72小时,讲出的却是故事的另一面:一家相信自己在造AGI的公司,治理结构如何崩塌,又如何重建。
那么请你告诉我,到底什么才是真的?(在新窗口打开)
一年前,我们还在调侃「鉴别内容是否由 AI 创作,像赛博时代的刻舟求剑」。
Grok最新模型吃上Cursor「加餐」,Grok基础模型V9-Medium(1.5T)已完成训练(在新窗口打开)
马斯克在X上发帖透露,xAI自家的Grok基础模型V9-Medium(1.5T)已经完成训练。预计再过2到3周,差不多就能正式对外发布啦:马斯克特意提到,V9-Medium的补充训练中加入了大量Cursor数据,后续还会继续添加。
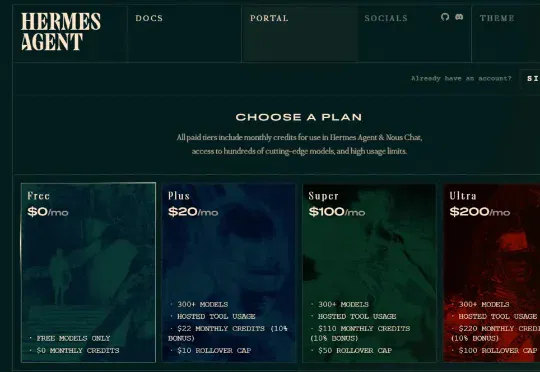
免费!DeepSeek-V4-Pro薅羊毛指南(在新窗口打开)
DeepSeek这半年生态铺得很快。现在好几个渠道可以免费或极低成本用上DeepSeek模型,从V4 Flash到V4 Pro都有。整理一下最实用的三条路。
Anthropic拟三年内向SpaceX支付近450亿美元购买算力,月费12.5亿(在新窗口打开)
SpaceX 2025 年全年营收是187 亿美元。这是这家火箭公司用了 23 年积累下来的成果——从 2002 年创立,到把猎鹰 9 号变成最可靠的运载火箭,再到星链卫星互联网,23 年换来的年收入数字。然后 Anthropic 来了一份合同:每年 150 亿美元。
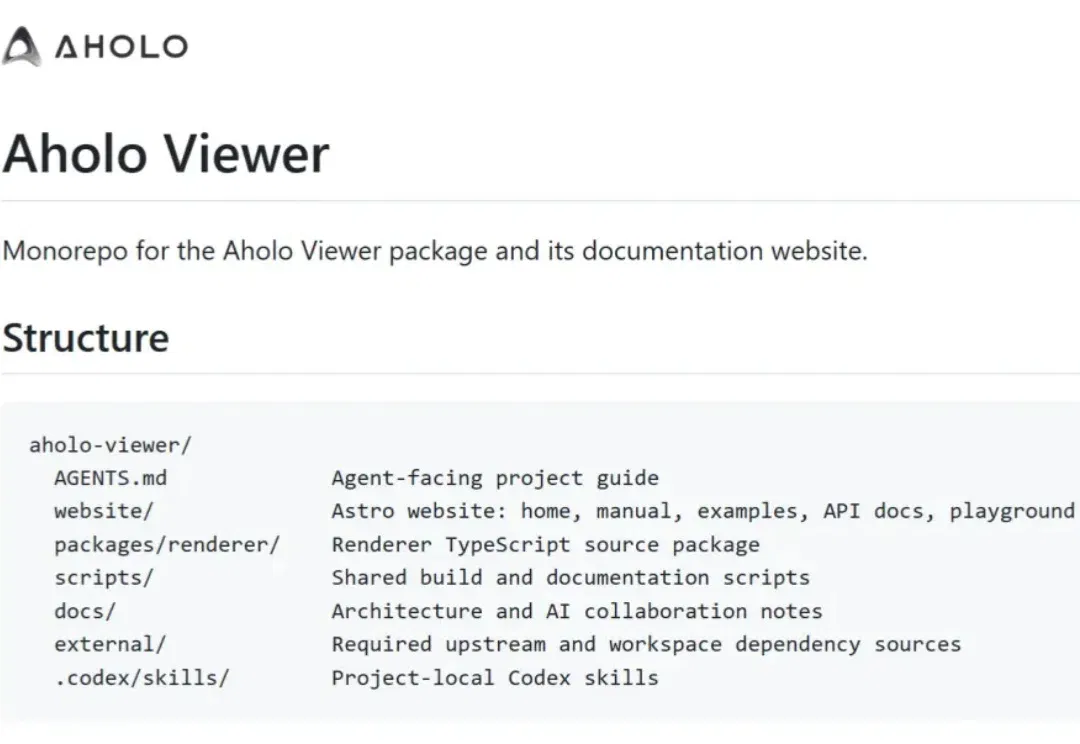
性能超越李飞飞,他们把10亿高斯点的3D世界装进浏览器(在新窗口打开)
我们知道,世界是三维的。 但互联网普及至今,受限于技术、硬件和传播载体,在几十年的时间里,都在把这个三维世界压成二维来表达。文字、图片、视频,这三种信息载体承载了我们今天在网上看到的几乎一切,都已经把这个世界降维。这是过去,互联网受限于带宽、硬件和计算能力后的「妥协」。 直到 3D 高斯泼溅(3D Gaussian Splatting, 3DGS) 的出现,才第一次让「随手拍、即时重建、实时漫游」三维场景成为可能。但这项技术一直卡在「最后一百米」:怎么让普通人在浏览器里流畅地看? 今年 4 月,李飞飞领衔的 World Labs 开源了 3D 高斯渲染引擎 Spark 2.0,瞬间引起技术圈的
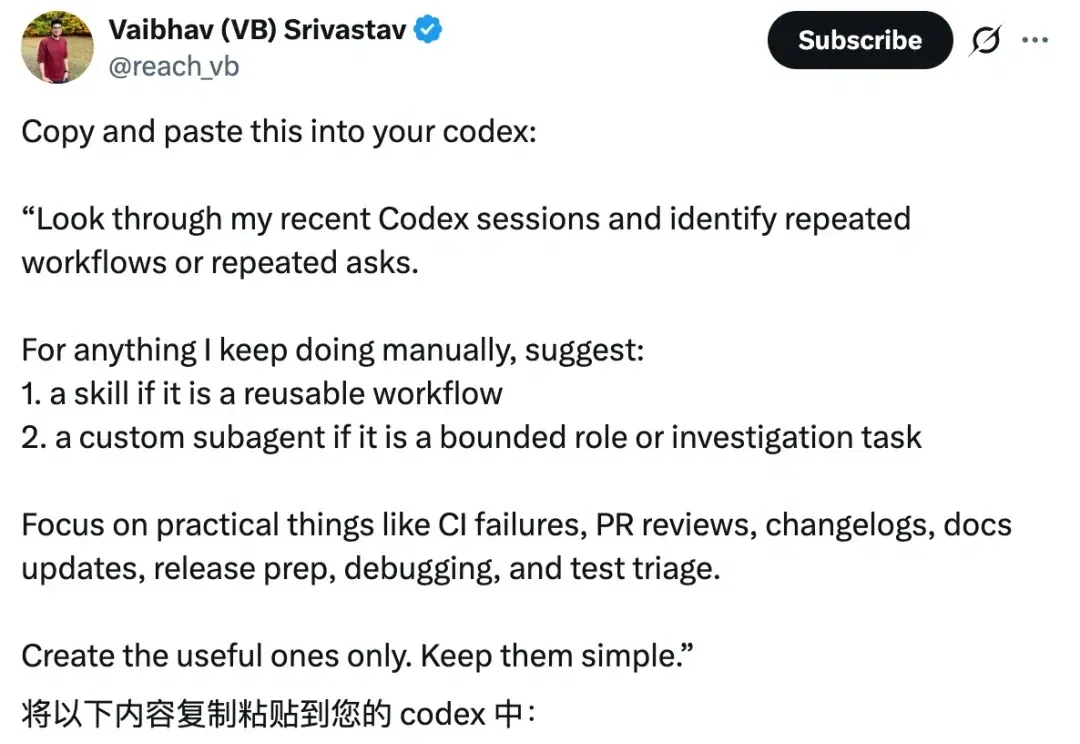
Codex自我蒸馏玩法火了!OpenAI员工亲授:复制粘贴就能让AI消灭重复劳动(在新窗口打开)
Codex自家程序员,直接把Codex「自我蒸馏」的秘籍给爆出来了…
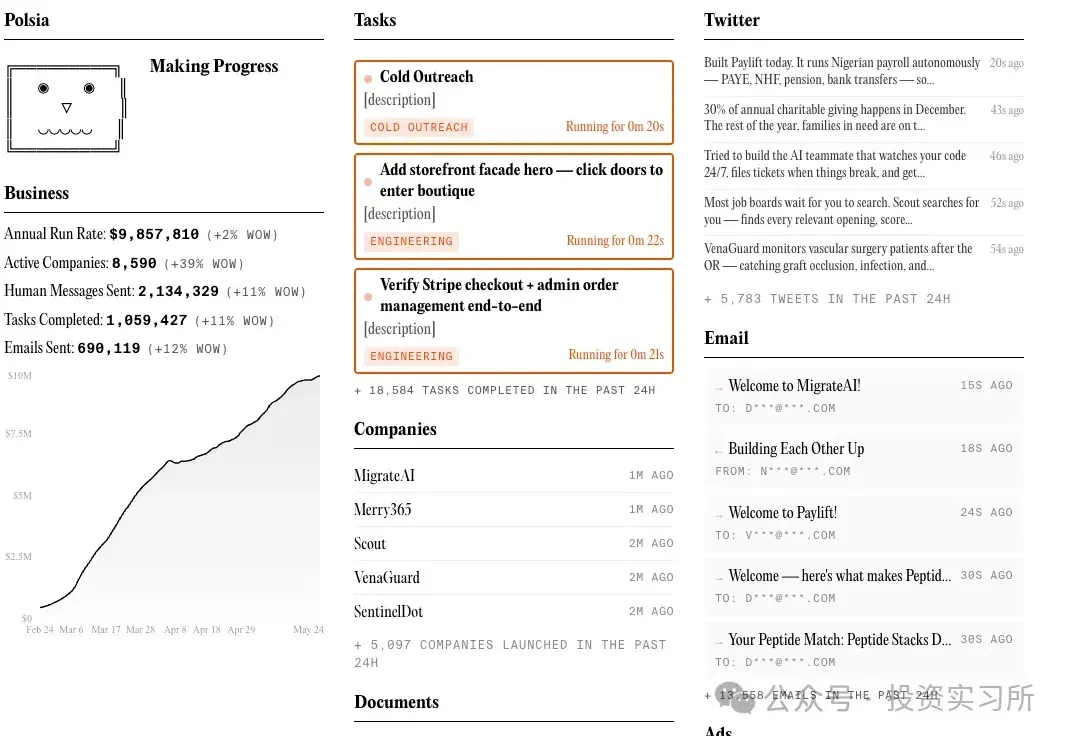
最具争议的 1 人 AI 公司融了 3000 万美金,估值达到了 2.5 亿(在新窗口打开)
一直在关注的一个 1 人 AI 公司 Polsia 最近特别火,而且引发了大量的质疑,创立半年时间其宣称 ARR(Annual Run Rate)已经接近了 1000 万美金。
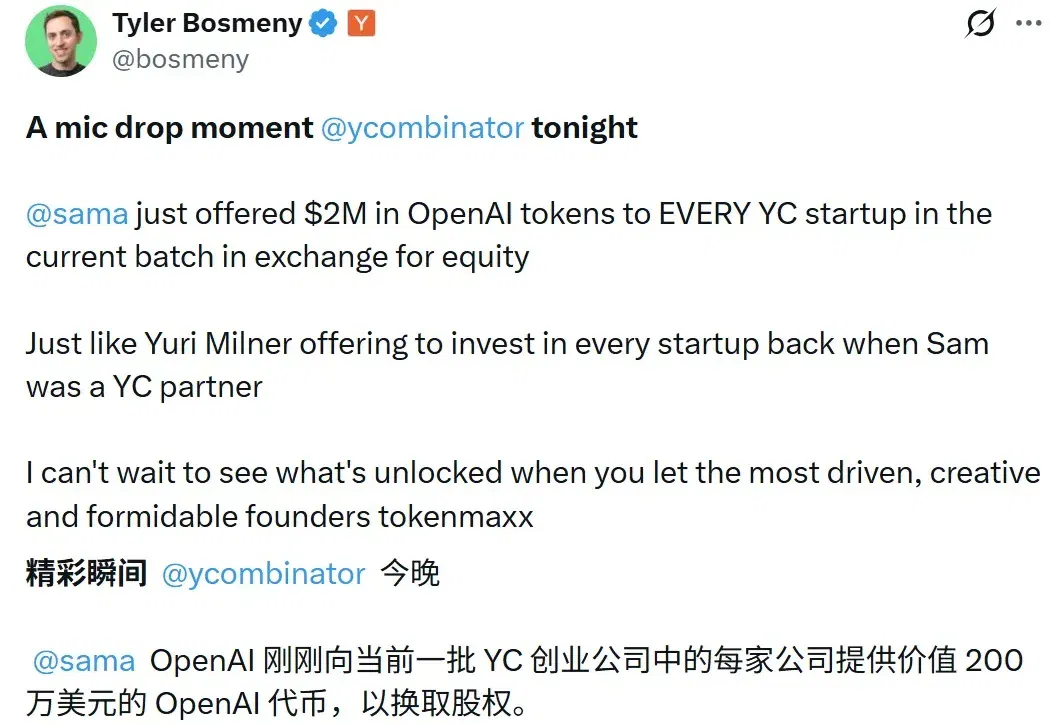
不给现金,只给超3亿美元Token!Sam Altman开始“拿算力换股份”:向169家YC公司发200万美元Token,但要拿股权来换(在新窗口打开)
当年互联网创业公司最熟悉的“羊毛”,是云厂商送的服务器额度;现在,AI 创业圈的“新硬通货”,已经变成了大模型 Token。
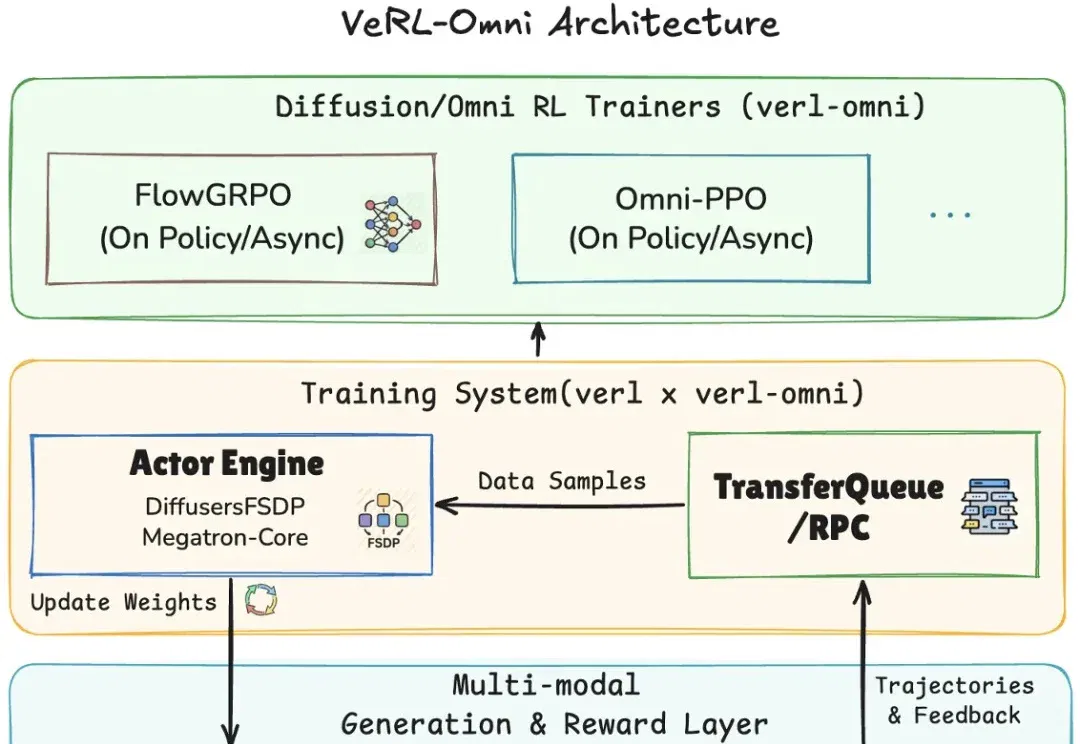
VeRL-Omni:面向扩散和全模态生成模型的通用RL后训练框架(在新窗口打开)
VeRL-Omni 是一个面向多模态生成模型的通用 RL 后训练框架,由 VeRL-Omni 团队在 verl 与 vllm-omni 之上构建。覆盖扩散 transformer(Qwen-Image)、混合 AR-DiT(Qwen-Omni)、统一理解 + 生成(BAGEL、HunyuanImage-3.0)等架构。
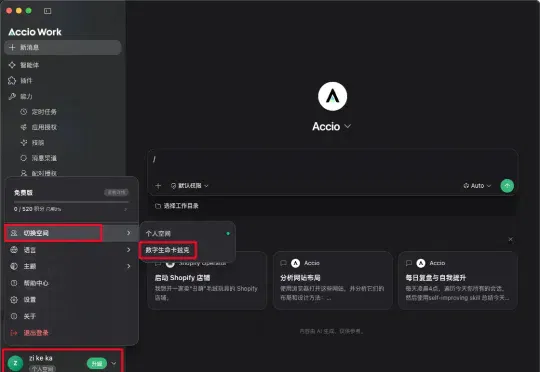
我折腾了好久的Skills团队共享,终于有产品替我做出来了。(在新窗口打开)
我们公司之前一直有件让我头疼的事,就是怎么让Skills在团队里流通起来。直到昨天,发现,阿里的Accio Work,居然把这个功能给做了。。。 关于Accio Work,我上个月写了一篇用他复刻多Agent协同的文章
DeepSeek 要用蜜雪冰城的打法,做中国版 Claude Code(在新窗口打开)
DeepSeek 之于大模型,就像蜜雪冰城之于奶茶。你不必纠结性价比,因为它的本事你挑不出毛病,你的钱包它也从不为难。
忘不了的 Kimi C轮融资(在新窗口打开)
最近人人都在聊 DeepSeek 的融资,这个等最终落定后我们再说。今天先说 Kimi 。
YC 今年最想投的两个赛道,被这个开源项目同时干了(在新窗口打开)
Ashpreet 现在是 Agno 的创始人,以前在 Airbnb、Facebook 做过工程。Scout 是 Agno 新推出的开源项目,定位是「上下文智能体」——一个能在 Slack、Google Drive、Linear 里自由穿梭、替你把碎片化知识拼起来的 AI Agent。
AI音乐下半场:Mureka跨过生产可用门槛,让模型像作曲家一样思考,开发者又可以有哪些新可能?(在新窗口打开)
前几天大模型圈子有个很魔幻的场面,傅盛、孙宇晨、特朗普家族,三个八竿子打不着的人,开始扎堆做大模型中转站的生意。
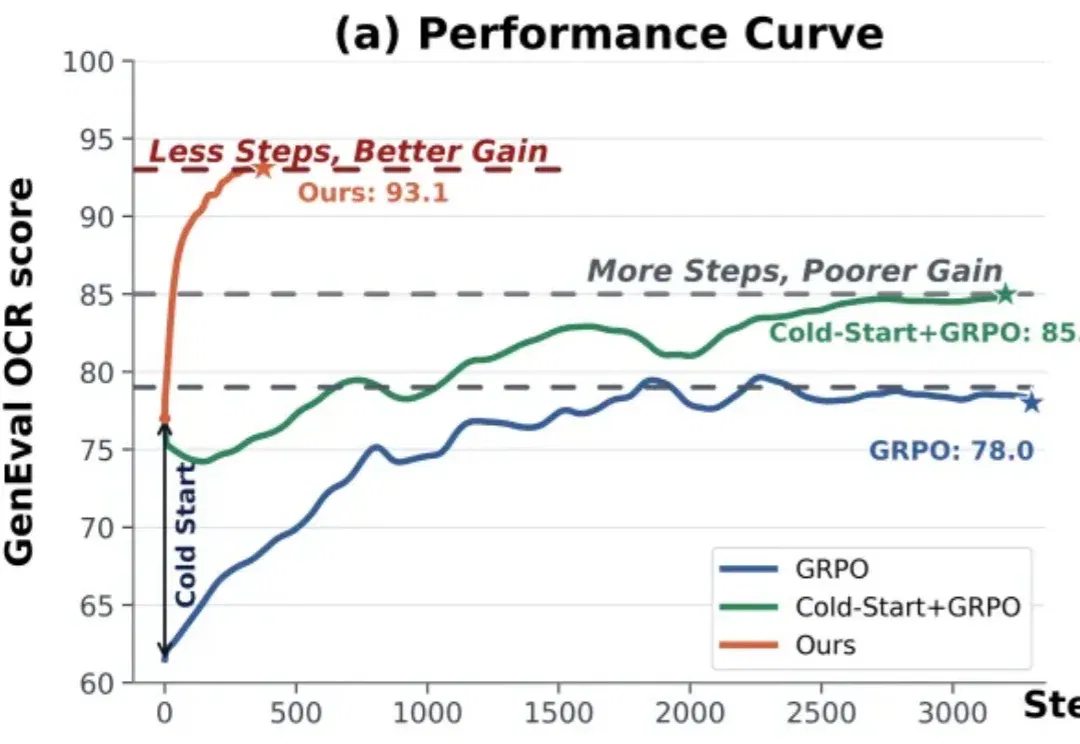
告别多奖励跷跷板:Flow-OPD将多教师OPD带入图像生成(在新窗口打开)
今年以来,在线策略蒸馏 OPD(On-Policy Distillation)已经逐渐成为大厂 LLM 后训练中的重要组件,例如 DeepSeek-V4,GLM5 就使用了多教师 OPD 来整合不同领域专家模型的能力,相比混合奖励强化学习收敛更快、效果更好。
Gemini 3.5 Flash 实测:当模型速度进入 4G 时代,Agent 的游戏规则变了 | AI上新(在新窗口打开)
天下武功,唯快不破。 本周 Google I/O 大会上,谷歌发布了最新模型 Gemini 3.5 Flash。 Google I/O 大会发布 Gemini 3.5 Flash|图片来源:youtube 有趣的是,隔一天国内 Qwen3.7-Max 也发布了,并且两个模型都号称自己在 Agent 场景上做了深度优化。 我看到他们的第一反应是:又是新一轮「模型大战」,国内外厂商再次开启跑分竞赛。 但这次我花了两天时间实测之后,我发现Gemini 3.5 Flash 给我最大的感受不是它有多聪明,而是它的速度快到让我不得不重新想一个问题: 当模型的响应速度从「能用」变成「实时」,整个 Agent
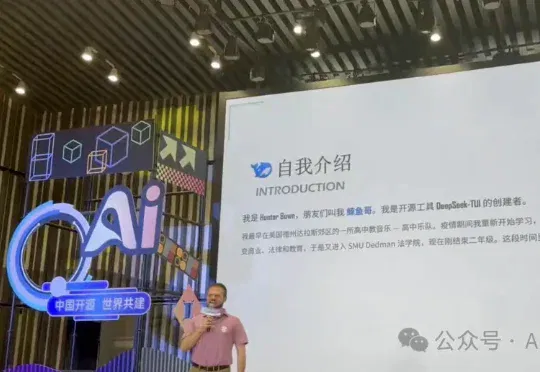
DeepSeek TUI 创始人「鲸鱼兄弟」来中国,被狠狠上了一课(在新窗口打开)
前两天,AI 圈子里出了个瓜,关于 DeepSeek TUI 创始人的,各个社媒群里几乎都刷屏了。但我发现一个问题 ——大家都只盯着一张微信群聊的截图在讨论,几乎没人把整件事的来龙去脉理一遍。
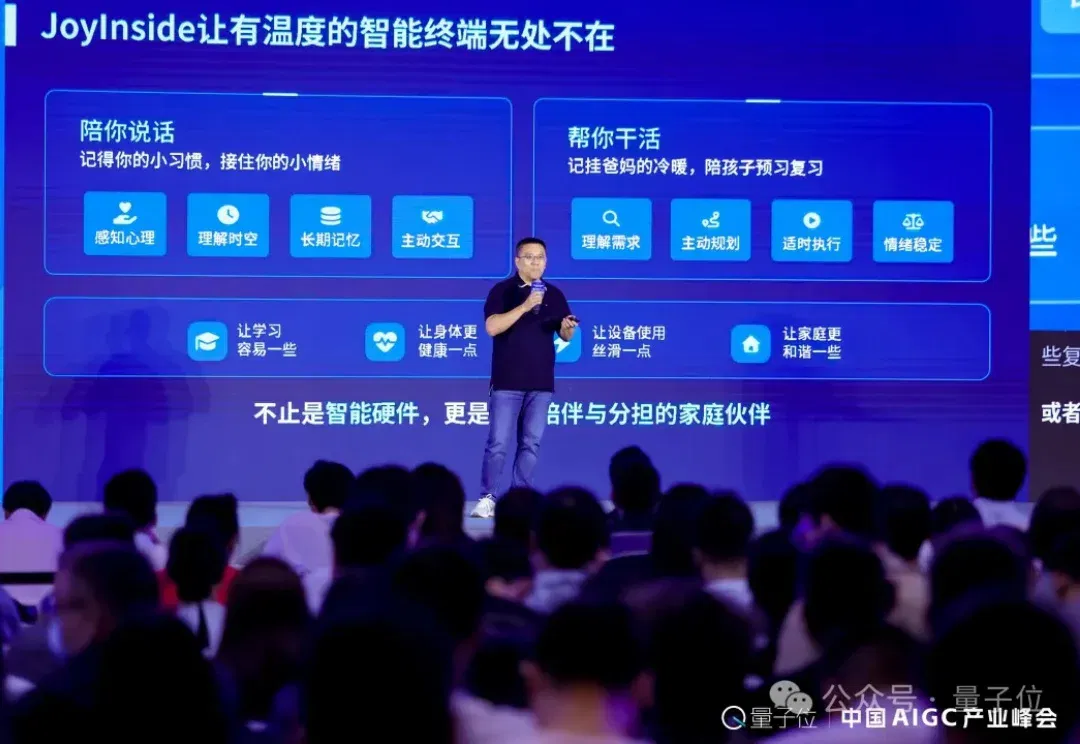
京东JoyInside戴文军:AI的终极形态不是聊天,是融入你家每一件物品丨AIGC2026(在新窗口打开)
AI浪潮正从线上数字空间,全面涌向线下物理世界。
风行在线CEO易正朝:先全员Coding,再All in众创丨AIGC2026(在新窗口打开)
一家视频公司,用三年时间让全员学会写代码——包括那些从没碰过编程的运营、市场、内容同学。