Know AI. See What’s Next.
第 1 张,共 5 张:清华系AI创企熵简科技完成C轮融资,蚂蚁领投
最新资讯流
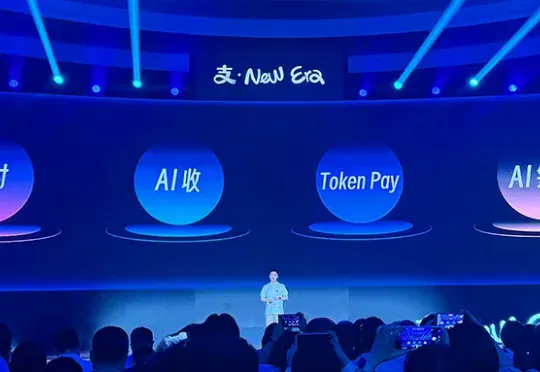
刚刚,支付宝推出全球首个Token Pay服务,还让Agent帮你花钱(在新窗口打开)
刚刚,蚂蚁集团旗下支付宝亮出AI支付“全家桶”:全球首个Token Pay服务、AI钱包产品,连同此前已落地的AI付与AI收,正式构成一套覆盖授权、支付、结算、管理、安全的全栈AI原生支付体系。
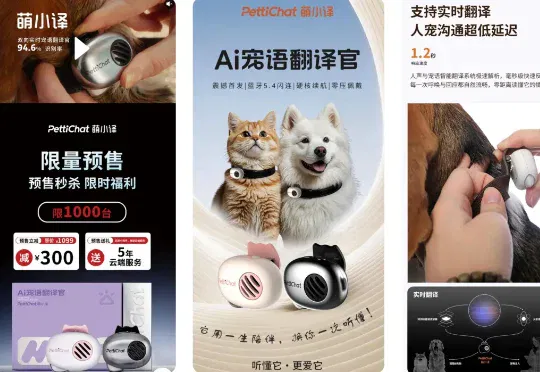
戴上 800 块的 AI 项圈,就能听懂喵星人的话?(在新窗口打开)
哪个铲屎官不想在自己的小猫小狗发出声音时,听懂它到底想说什么;或者是让它们听懂人类的语言。 杭州一家名为「萌小译」的公司最近推出了一款产品,800 块就能实现我们和宠物之间的双向翻译,并且准确率达到了
AI时代的人才,我觉得最重要的是这6点特质。(在新窗口打开)
前几天我们发了一篇招聘的内容:2026,你想象不到我们现在有多缺人。
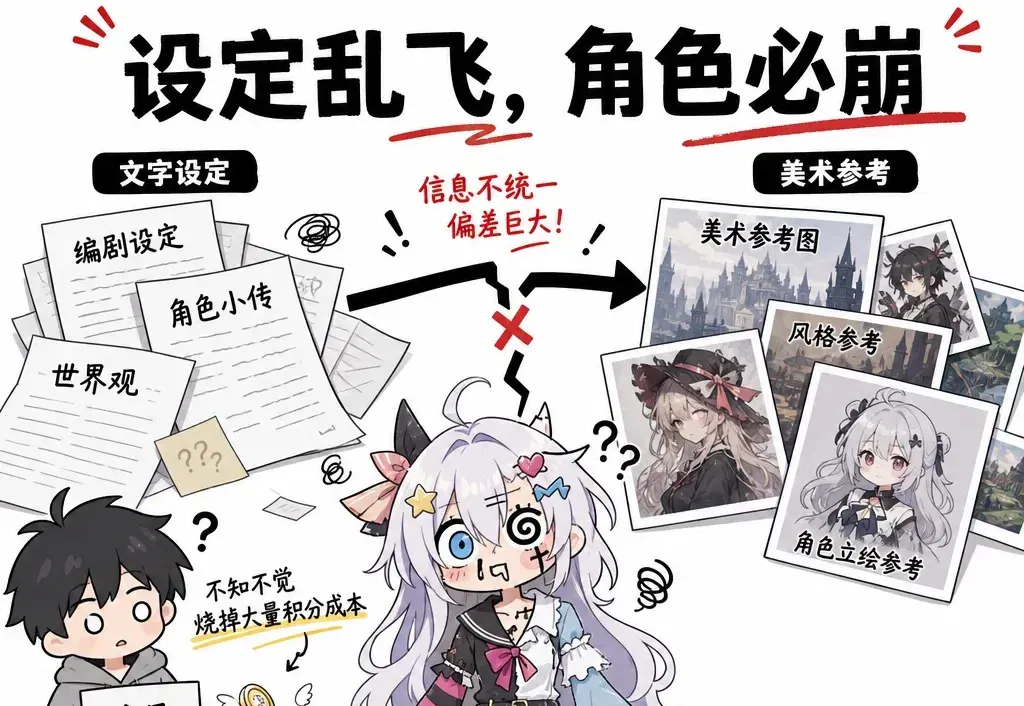
实测最近爆火的「Pixmax」,是真有东西啊!(在新窗口打开)
AI 短剧发展到今天,过去那种靠单打独斗的小作坊模式正在被淘汰。现在复盘榜单上排名靠前的AI短剧内容团队,你会发现里面基本都是几个人、甚至十几人的工作室在共同推进项目。
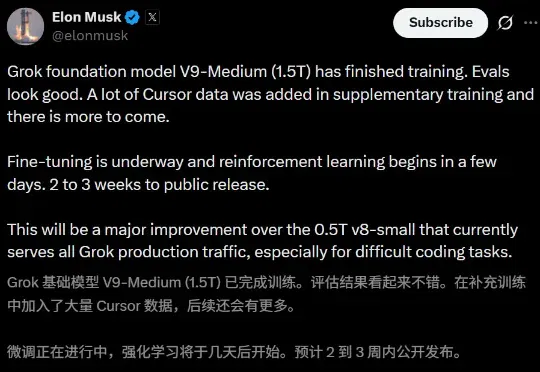
马斯克曝光Grok 5!1.5万亿参数,偷师Cursor狂练编程(在新窗口打开)
马斯克深夜官宣:1.5万亿参数Grok V9训练完成,现役三倍!更狠的是,训练数据直接灌入大量Cursor编程交互记录。几乎同一时间,更劲爆的细节浮出水面——训练过程中,xAI往模型里灌入了大量Cursor编程数据。
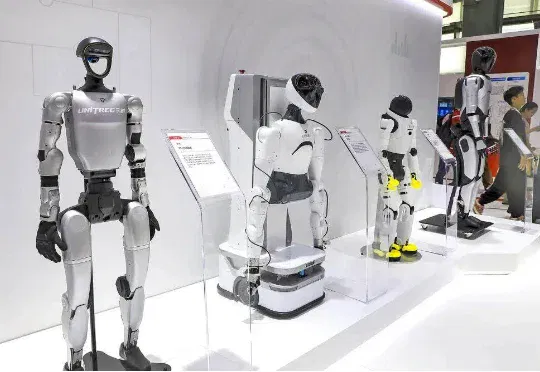
6月1日,宇树科技将被审议科创板首发事项!人形机器人第一股,终于走到临门一脚。(在新窗口打开)
5月25日晚,上交所一则公告引爆资本市场:6月1日,上市审核委员会将审议宇树科技科创板首发事项。人形机器人第一股,终于走到临门一脚。
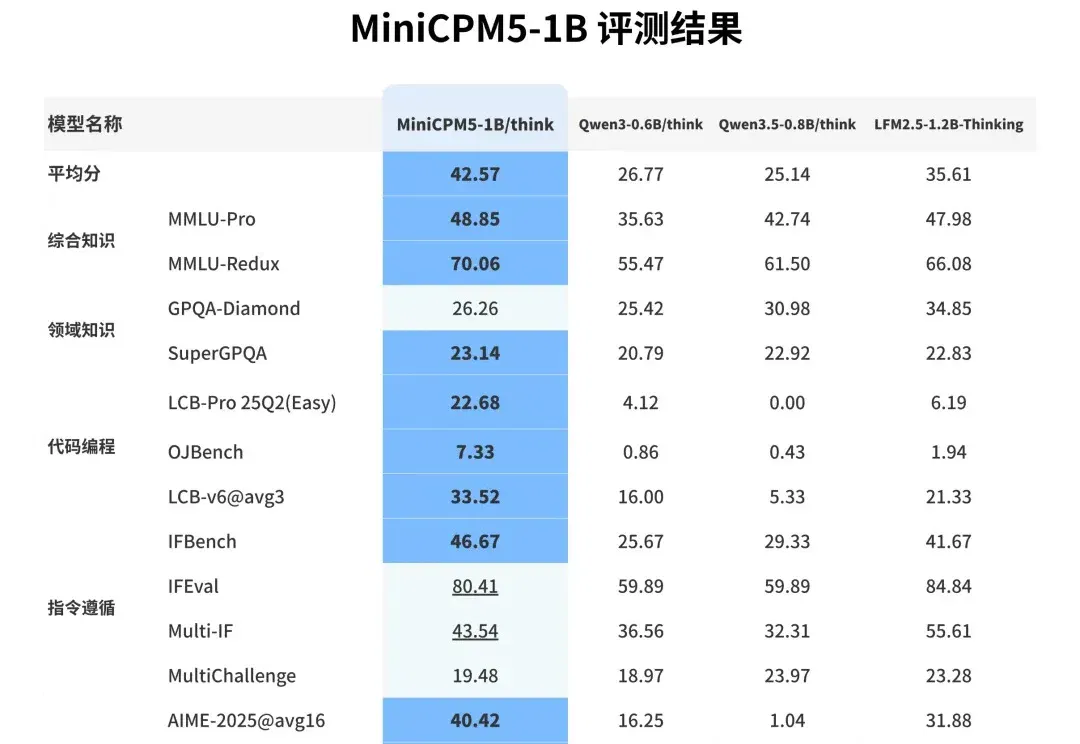
不用人类手写训练框架了!AI自己写代码,训出1B端侧「小钢炮」(在新窗口打开)
你的电脑里,或许很快会住进一只会聊天的「小怪兽」。
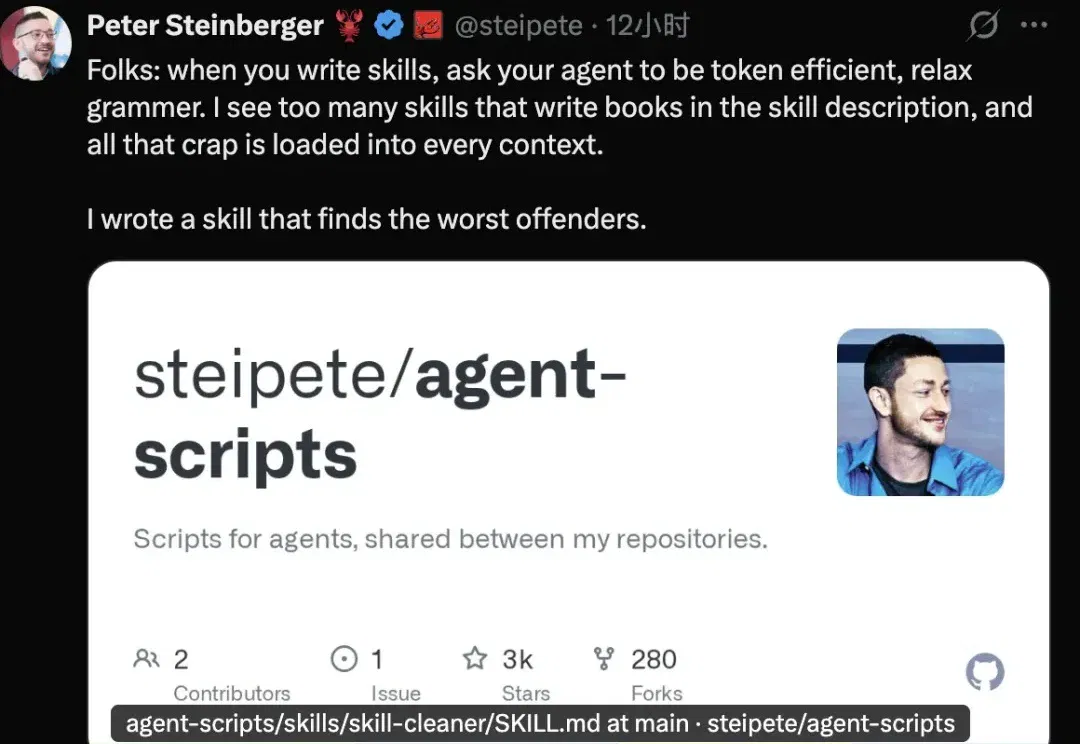
龙虾之父教你省钱:开源Skill给你的Skill减肥(在新窗口打开)
Skill水平参差不齐,龙虾之父Peter看不下去了。
一个月的活一周干完!英伟达世界模型训练速度飙升400%(在新窗口打开)
英伟达世界动作模型 DreamZero 训练一次要烧 8 张 H100 整整 25 天,RLinf 从算子融合到 I/O 全链路系统级重构,把训练吞吐拉高近 4 倍——1 个月的活,1 周就能干完。
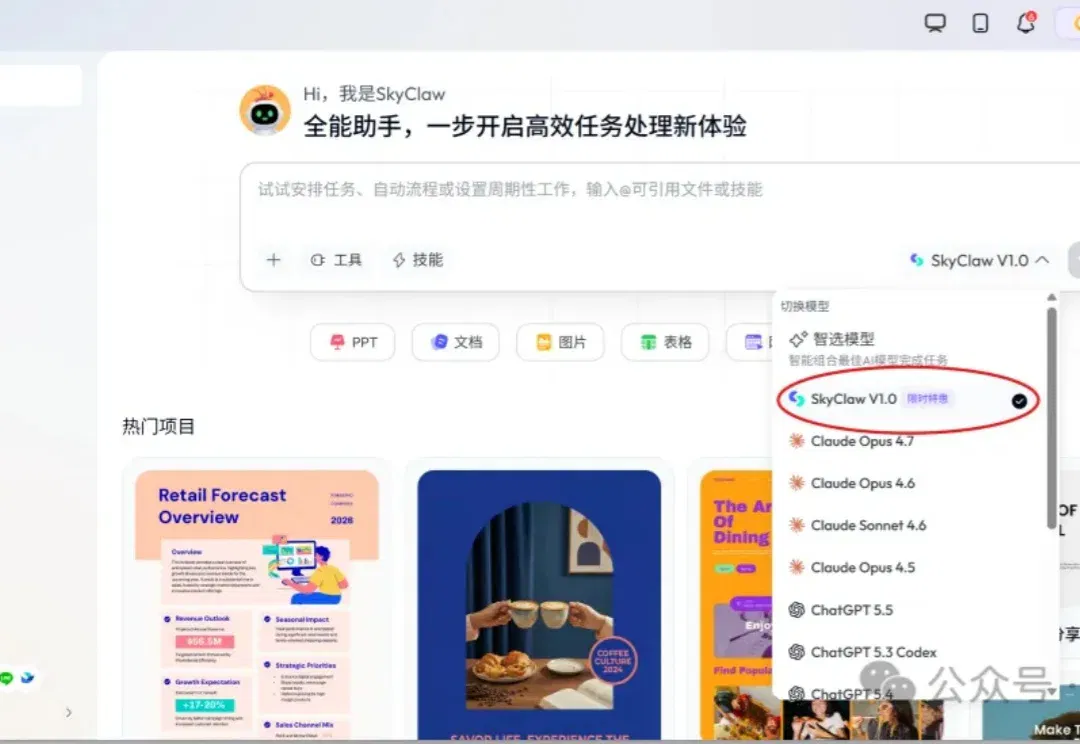
昆仑万维发布2款Agent模型,SkyClaw-v1.0和SkyClaw-v1.0-lite限时免费(在新窗口打开)
谁懂啊家人们?? Agent时代,大公司都在把“烧多少token”当KPI了,本小小员工还深陷另一个泥沼: 聪明的模型用不起,便宜的模型不够聪明。 想找一个又能打又不贵、还能在主流Agent环境里即插即用的模型?过去基本没有。 然而就在刚刚,我发现有一位国产玩家,悄悄打破了这个“不可能三角”。 其新发布的Agent模型,性能已经站到全球第一梯队——甭管对面是开源还是闭源,凡是你能叫得上名字的顶尖选手,它都能与之掰一掰手腕。 而且价格确实惊到我了,只有主流顶尖模型的一半甚至更低。 更关键的是,模型深度适配了OpenClaw、Claude Code、Hermes、Nanobot等主流Agent框架
面壁智能推出AI写的预训练框架ForgeTrain,从此AI开始造自己(在新窗口打开)
造AI这件事,现在的主角变成了AI。 因为就在刚刚,一个国产AI先自己写出了一套大模型预训练框架,然后再用这套预训练框架,训练出了一个新的小尺寸模型! 这就是面壁智能搞出来的big news。 这套由AI写出来的预训练框架叫做ForgeTrain,它是全球首个完全由AI编写的生产级大模型预训练框架,性能甚至超越了英伟达的Megatron。 并且ForgeTrain在华为昇腾上预训练MiniCPM5-1B,相比昇腾的框架也有10%的加速。 围绕它,面壁智能还提出了一套新的软件编程范式,叫Forge Engineering。 更直白一点说,就是当AI写代码的成本越来越低,未来软件不一定非要做成一套
AI初创公司Hark获7亿美元A轮融资,英伟达押注,打造其神秘“万能”AI入口丨News(在新窗口打开)
一家几乎尚未公开具体产品的AI初创公司,刚刚拿下硅谷最受关注的一笔融资。AI初创公司Hark宣布完成7亿美元A轮融资,投后估值达60亿美元。本轮融资阵容堪称豪华,由Parkway Venture Capital领投,英伟达、AMD、高通、英特尔、Salesforce等产业资本集体押注。
AI公司烧不起Token了!国产Agent杀出,逼近Opus 4.6还免费(在新窗口打开)
4个月烧光全年AI预算,天价Token账单正在屠杀硅谷!今天,高性能Agent模型SkyClaw-v1.0出世,性能直逼Opus 4.6、DeepSeek V4 Pro,百万上下文性价比拉满。
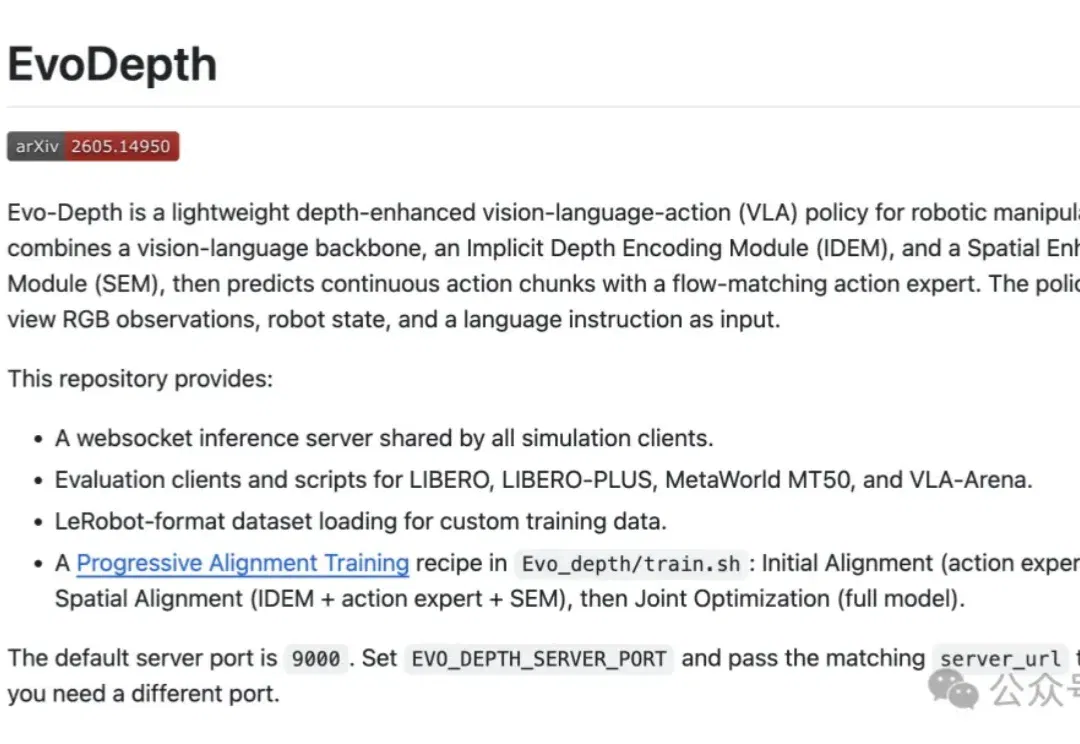
0.9B跑出90%真机成功率!上海交大为VLA补上空间感(在新窗口打开)
机器人看得见,但不一定看得准。 大量VLA模型仍然主要依赖二维视觉,一旦遇到精定位、细摆放、遮挡判断这类需要空间感知的任务,成功率就会明显下滑。 补空间信息的路有两条,但都有代价。 显式3D路线靠深度传感器和点云重建,硬件链路长、对标定误差敏感;隐式3D路线从RGB学几何,省了硬件,但不少方案依赖较重的基础模型,训练和推理成本偏高。 现在,上海交大MINT团队提出了一条中间路线: Evo-Depth,约0.9B参数,不额外增加硬件负担,用紧凑的隐式深度编码把空间感写进VLA策略里,仿真与真机同时兼顾性能与部署效率。 仿真端,Meta-World 84.4%、LIBERO 95.4%;真机平均成
“Token”必须死?(在新窗口打开)
“我语言的局限,即意味着我世界的局限。”( Die Grenzen meiner Sprache bedeuten die Grenzen meiner Welt. )
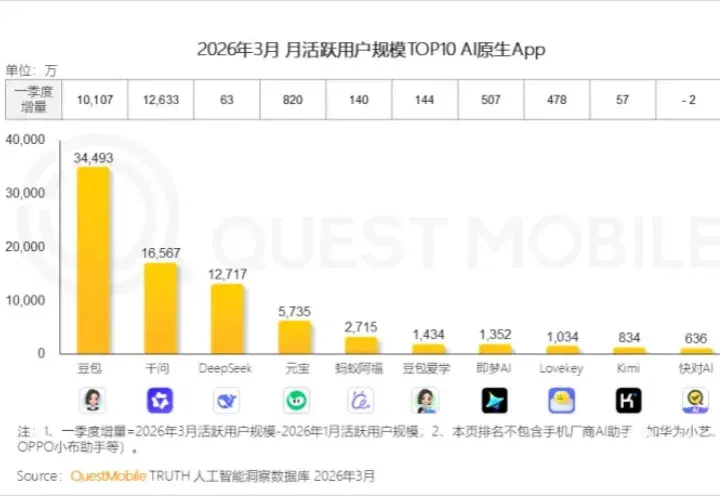
AI 的承诺一文不值,谁该买单?(在新窗口打开)
五一假期的时候,一个用户向豆包问了一个很普通的问题:石家庄到重庆的机票,退票手续费多少?
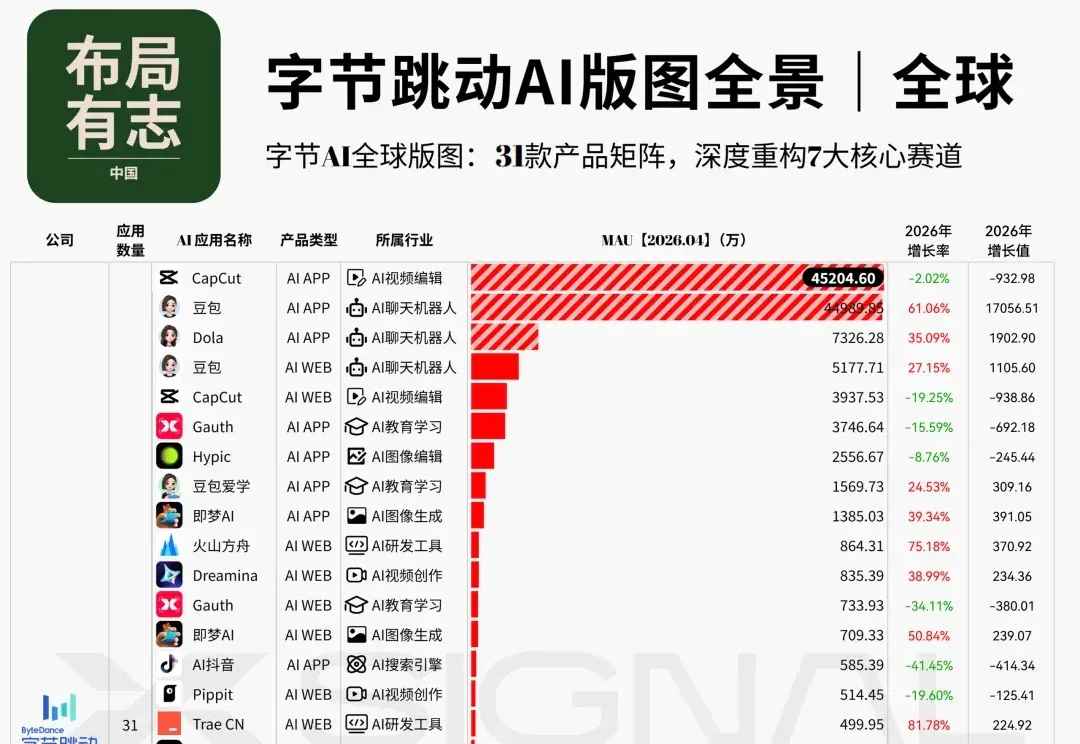
AI时代,流量不再“跳动”,字节进入“中年危机”!(在新窗口打开)
字节跳动计划在今年将其在人工智能基础设施上的支出大幅提升惊人的25%。这意味着将投入2000亿元人民币,这可不是一个边缘性的微调,是一次由不断升级的存储芯片成本以及字节跳动想要主导AI领域的雄心共同推动的巨大升级。
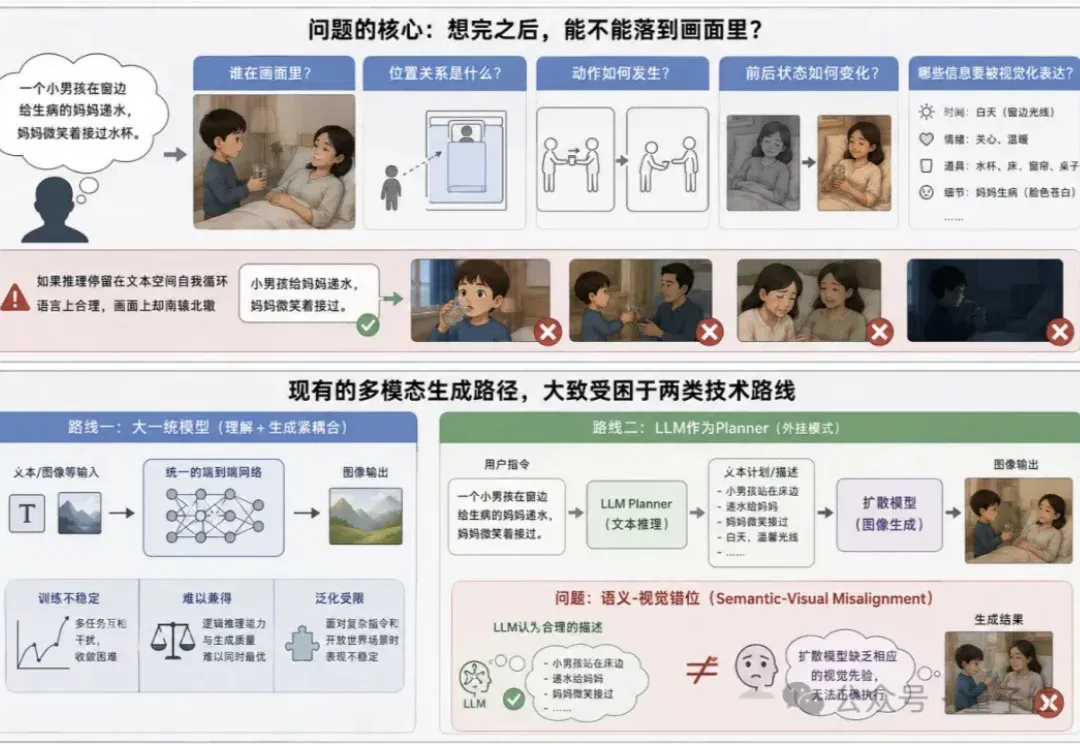
画数独、烧蜡烛都不翻车了?浙大&阿里让AI先三思再下笔|ACL 2026(在新窗口打开)
当下视觉生成正陷入一个能力错位困境—— 扩散模型的像素画质已接近完美,但一遇到需要逻辑推理的生成任务就频频翻车。
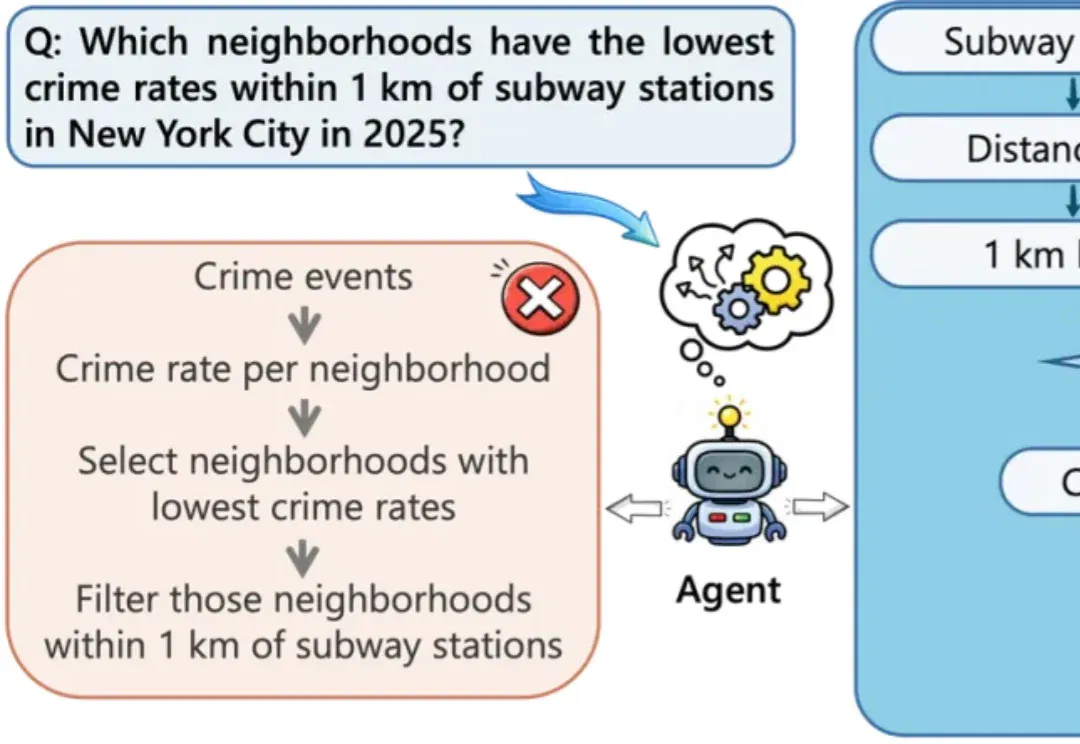
ACL 2026 Main | 不只是调用地图API,Spatial-Agent让大模型生成可执行地理分析工作流(在新窗口打开)
大语言模型在地图、城市、交通等空间领域的应用越来越广泛。对于这些场景来说,问题往往不只是 “查一个地点” 或 “调用一次路线 API” 就能解决的,而是需要把用户的自然语言问题组织成一段可执行、可验证的地理分析流程。
怎么知道 Agent 真干完活了?(在新窗口打开)
判断 Agent 靠谱与否,核心指标只有一个:是不是真干完活了