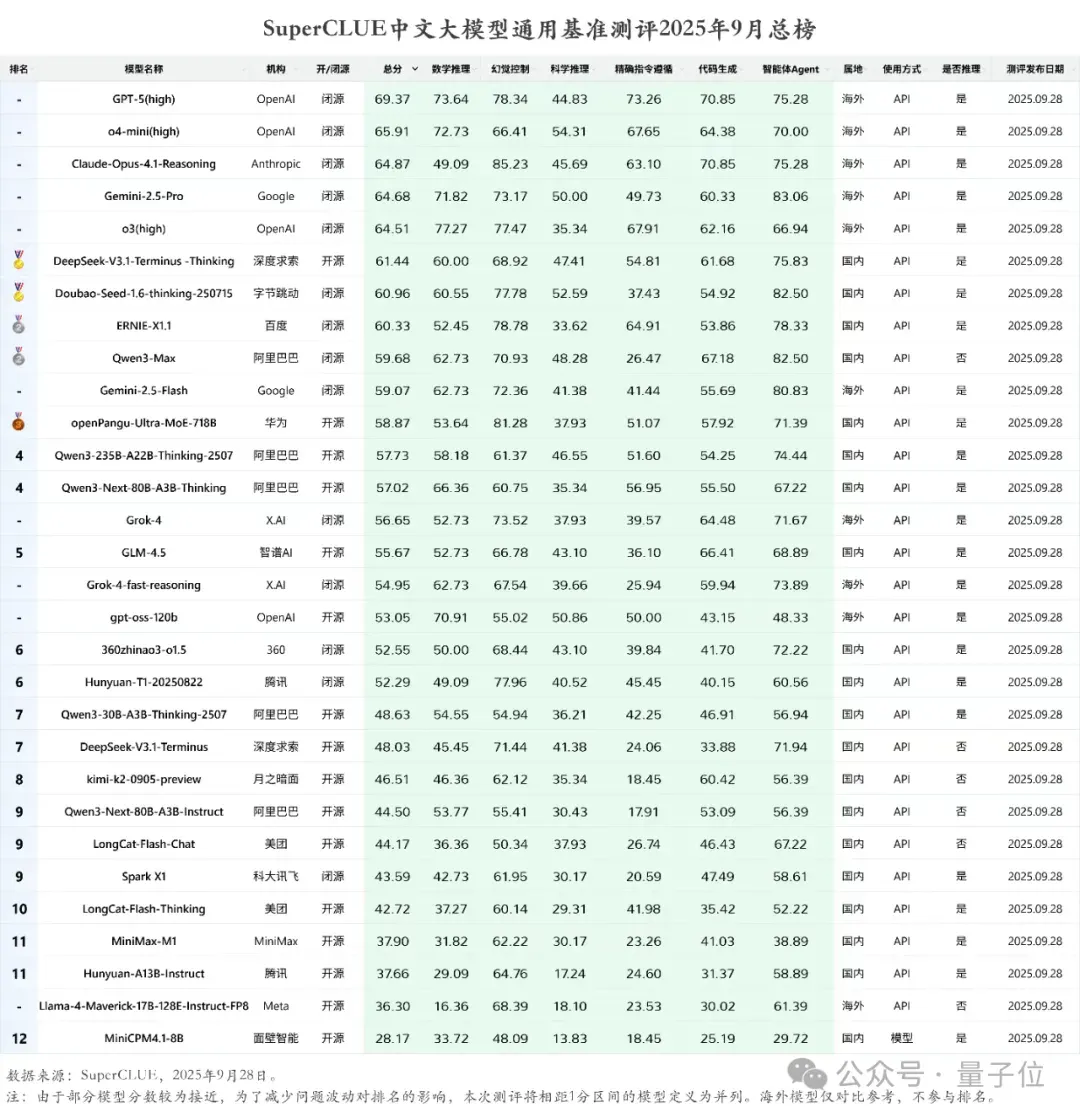
华为盘古718B模型最新成绩:开源第二(在新窗口打开)
就在最新一期的SuperCLUE中文大模型通用基准测评中,各个AI大模型玩家的成绩新鲜出炉。DeepSeek-V3.1-Terminus-Thinking openPangu-Ultra-MoE-718B Qwen3-235B-A22B-Thinking-2507
共 106 篇
就在最新一期的SuperCLUE中文大模型通用基准测评中,各个AI大模型玩家的成绩新鲜出炉。DeepSeek-V3.1-Terminus-Thinking openPangu-Ultra-MoE-718B Qwen3-235B-A22B-Thinking-2507
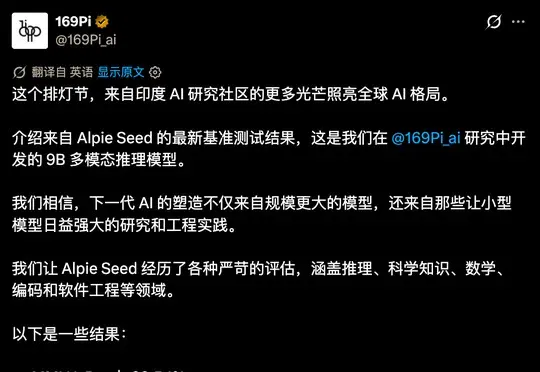
169Pi 发布的模型卡列出千问底座、量化和后训练方案。文章对比发布文案与模型资料,并讨论使用不同来源成绩做横向比较的限制。
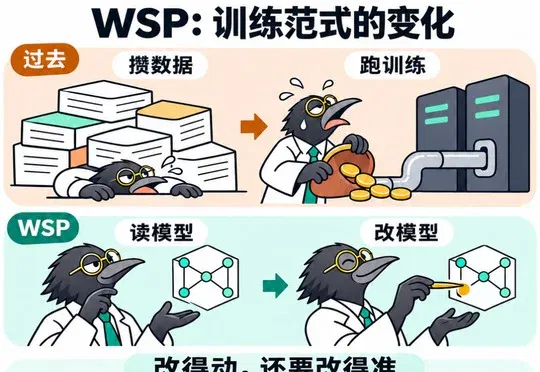
无涯智远比较了 Qwen3.5-0.8B 改权重与关闭思考的数学成绩,又用少量样本测试知识、风格和技能内化。文章讨论权重编辑可解决的不同问题。
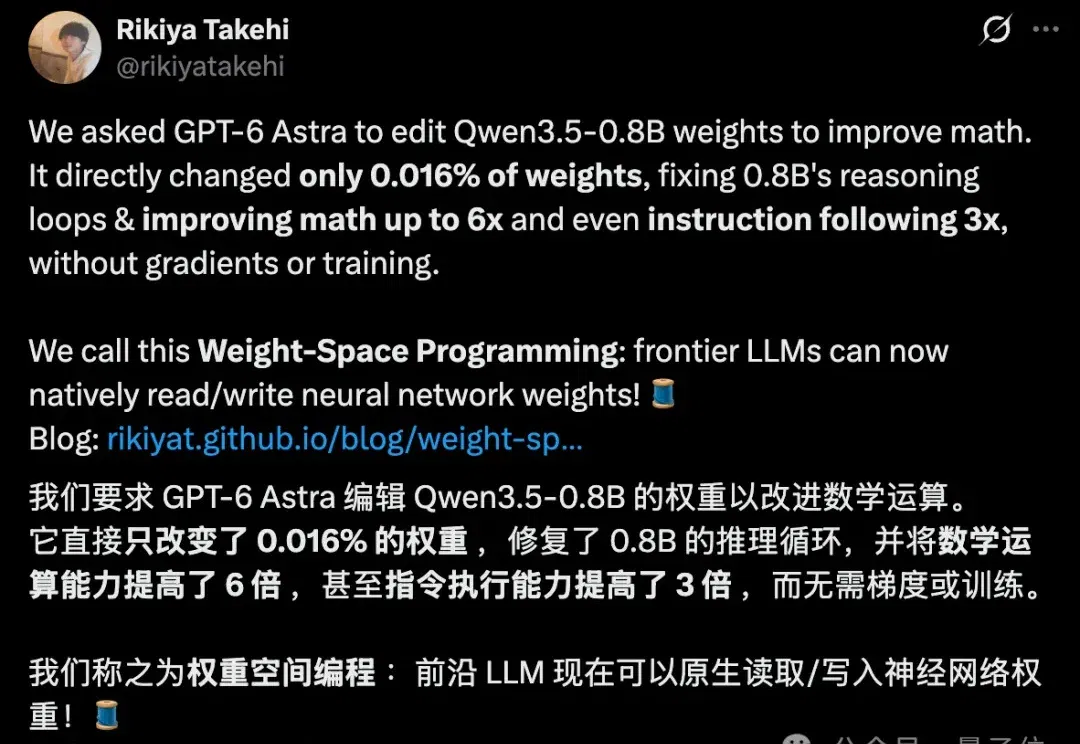
研究者让 GPT-6 Astra 分析神经网络权重并生成修改方案。在Qwen3.5-0.8B的特定采样设置下,50次前向调用预算的方案使MATH-500得分从7.9%升至48.1%。实验省去了目标模型的梯度更新,仍需要诊断、推理和评测计算。
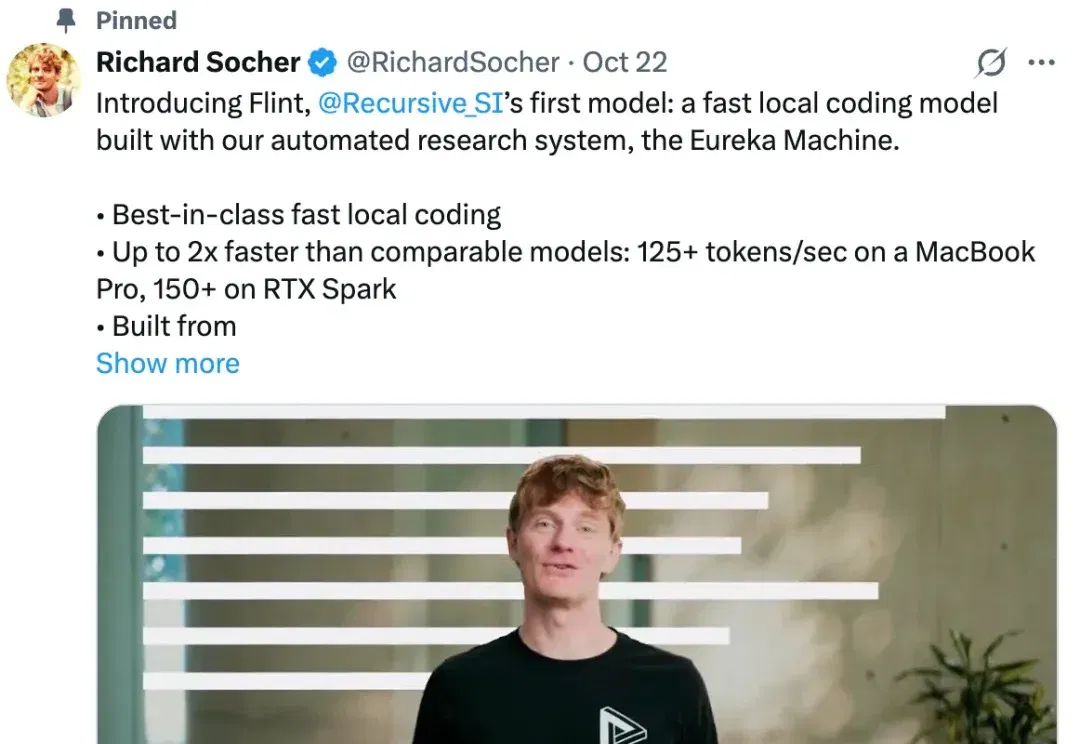
Apex-35B-V1.0 基于 Qwen3.6-35B-A3B 进行中训练和后训练,面向编程、智能体及研究任务。超衍智能介绍其自动化研究系统如何参与数据构造、训练方案和算力优化,并公布多项评测与仿真案例;这些团队报告的结果仍需要结合评测设置和独立复现判断。
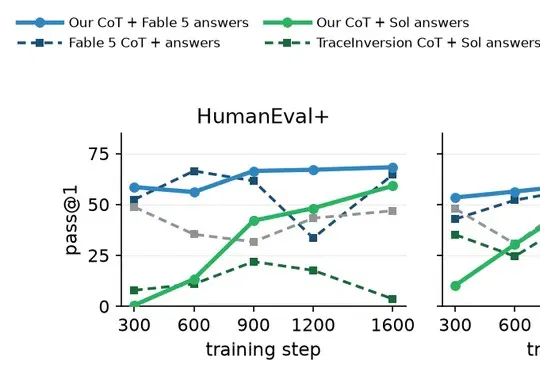
王琰在 TraceForge 技术报告中提出用同族模型合成原生思维链,在 Qwen3.5-9B-Base 实验中超过直接蒸馏 Claude Fable 5 思维链的方案,动摇闭源模型以隐藏思维链构筑的能力护城河。
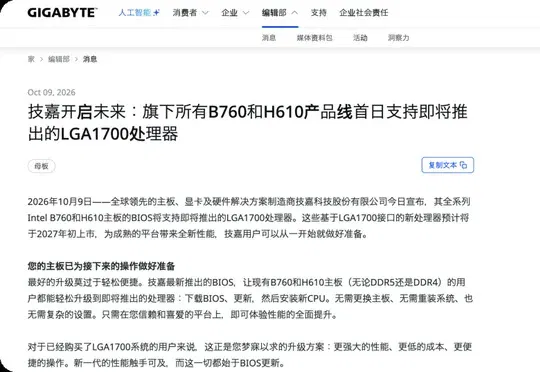
AI需求挤压消费级内存产能并推高PC成本,技嘉通过BIOS更新让B760、H610及DDR4平台继续支持英特尔LGA1700新处理器,开源项目Strata则让消费级电脑本地运行1250亿参数的Qwen3.8-Flash-Next成为可能。
开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。
APUS(麒麟合盛)旗下AI实验室公开全球最早一批Jev独立开源复现成果fast-browser-use,基于Qwen3.5等开源模型在RTX PRO 6000上将单次决策压缩至79毫秒,并以9B小模型对标Jev性能。
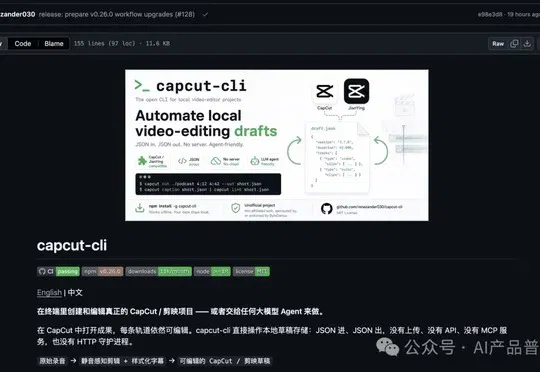
作者用 Qoder 搭配 Qwen3.8-Flash 模型调用开源工具 capcut-cli,在剪映 5.9 中自动完成口播视频的字幕识别、贴字和音效添加,生成可继续手动修改的分轨草稿。