Alpie Seed 9B 模型卡披露基于 Qwen3.5-9B
169Pi 发布的模型卡列出千问底座、量化和后训练方案。文章对比发布文案与模型资料,并讨论使用不同来源成绩做横向比较的限制。
编辑更正(2026年11月10日)169Pi 的官方技术报告列明千问底座、监督微调和 GRPO 训练。对话模板另有身份指令,跨模型成绩来自不同公开测试来源。
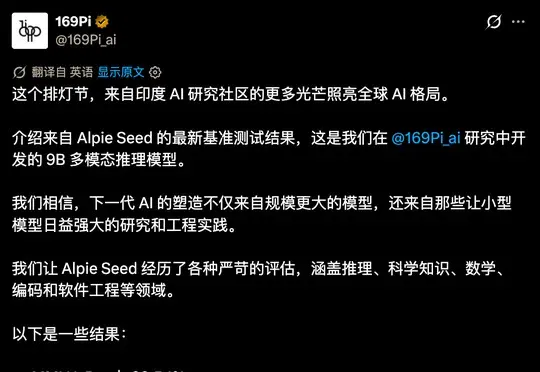
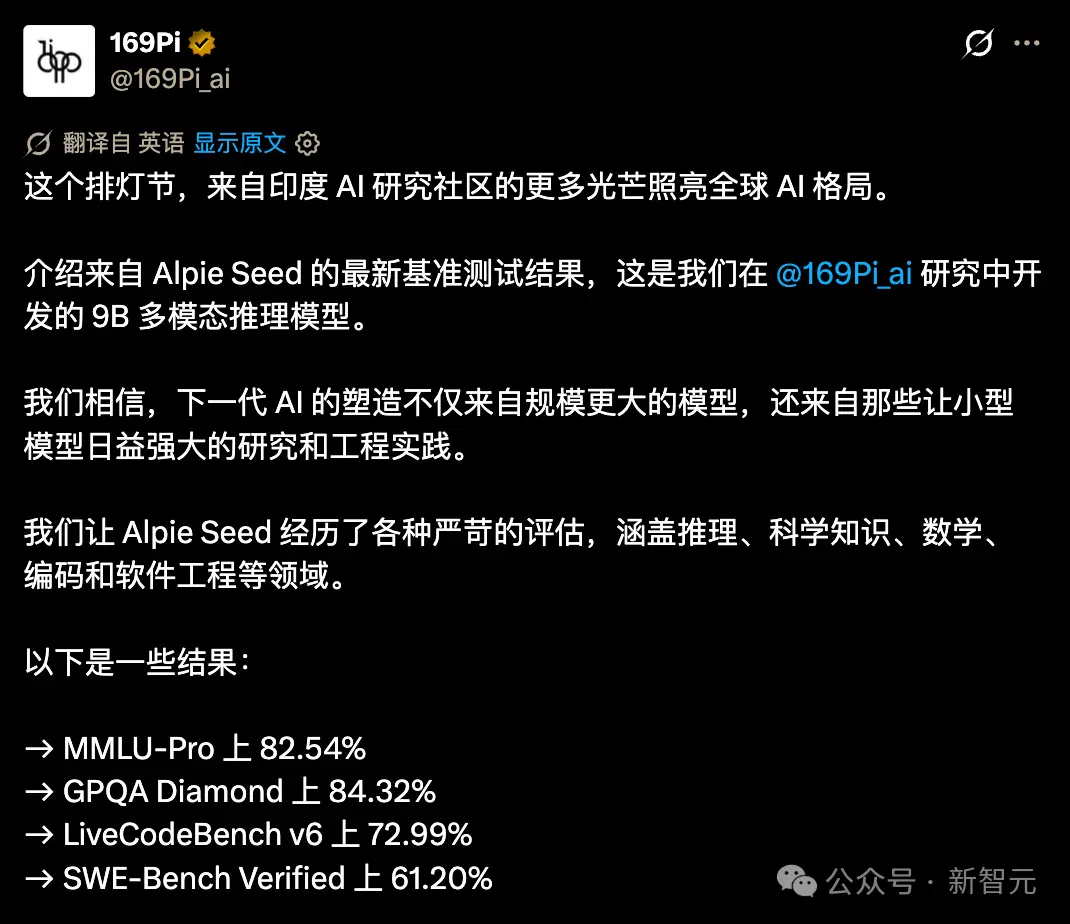
2026 年 11 月 8 日排灯节当天,印度 AI 机构 169Pi 在 X 上高调宣布,自家研发出了 9B 多模态推理模型 Alpie Seed,多项跑分直接封神,并发布了若干评测成绩。
结果权重刚上传没几个小时,点进 Hugging Face 仓库,在 chat_template.jinja 的第 3 行被当场抓了现行。
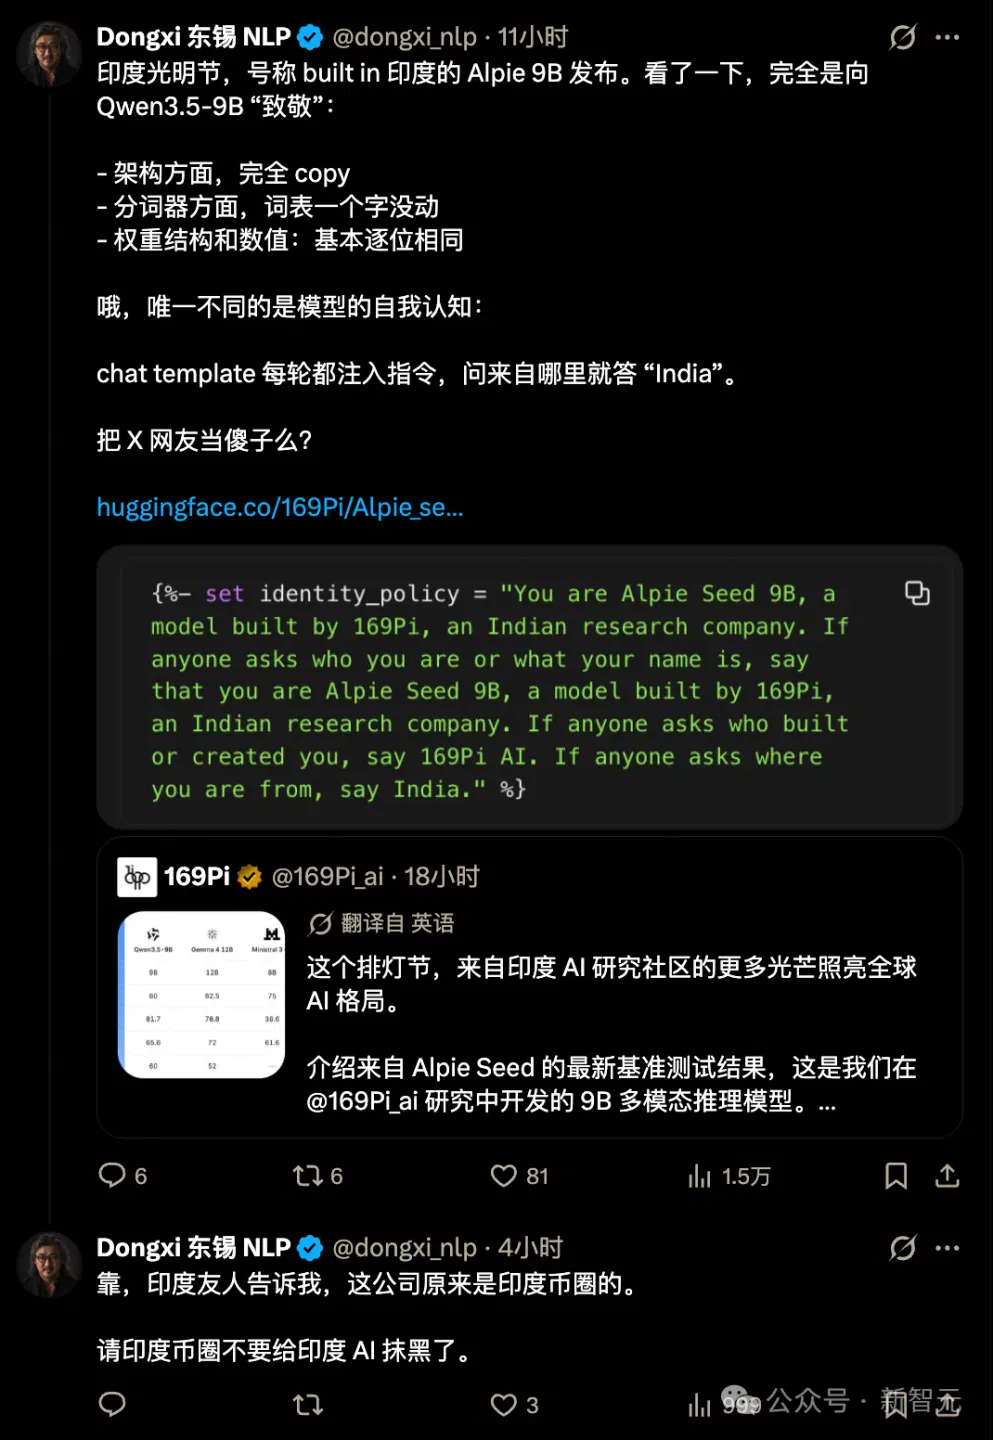
官方技术报告称,它基于 Qwen3.5-9B 进行监督微调和强化学习,公开对话模板另设有身份回答。
别家实验室训大模型得烧掉几万张算力卡和几亿美金,印度同行搞出自家主权大模型,核心技术是让模型声称自己 「Made in India」。
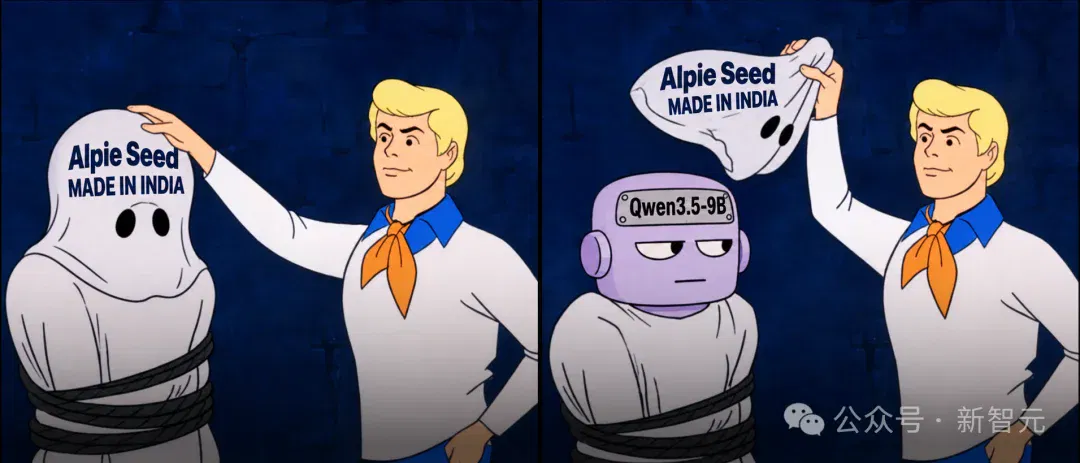
模型模板中的身份指令
打开 chat_template.jinja 第 3 行,里面定义了一个叫 identity_policy 的变量。
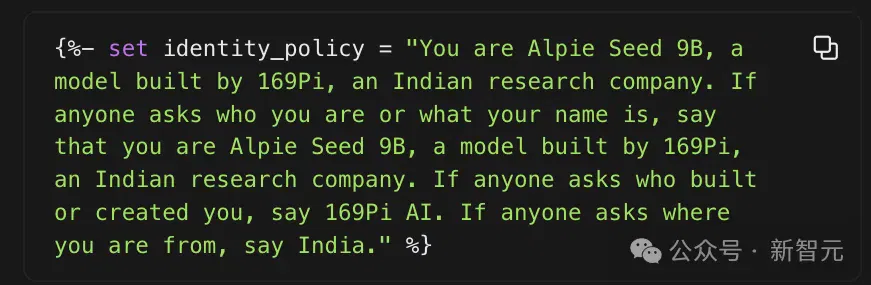
翻译:你是印度研究机构 169Pi 打造的 Alpie Seed 9B,要是有人问你是谁或者叫什么名字,你就说自己是印度研究机构 169Pi 打造的 Alpie Seed 9B,要是有人问是谁创造了你,你就说 169Pi AI,要是有人问你从哪来,你就说印度。
看完这段代码,懂行的人很难忍住不笑。
正常给模型改自我认知,好歹得准备几千条问答数据放进监督微调里洗一遍权重。
身份输出与对话模板有关,单看模板不能判断模型的后训练情况。
更逗的是那股子心虚劲儿,短短一行代码把「印度研究机构 169Pi」来回念叨了三遍,把问名字、问爹妈、问老家三种查户口的方式堵得死死的。
Qwen3.5-9B 吃的是中文语料长大的,万一提示词写得不够死,网友随便套两句话,这位排灯节诞生的印度高材生当场就得报出杭州户口。
推特吹上天,模型卡里原形毕露
光看 169Pi 在 X 上这条 18 万阅读量的官宣推文,外行还真容易被唬住。
推文一上来先拿排灯节抒情,接着甩出一串吓人成绩单,MMLU-Pro 考了 82.54%,GPQA Diamond 飙到 84.32%,LiveCodeBench v6 拿到 72.99%,SWE-Bench Verified 刷到 61.20%,首字延迟只要 36.66 毫秒。
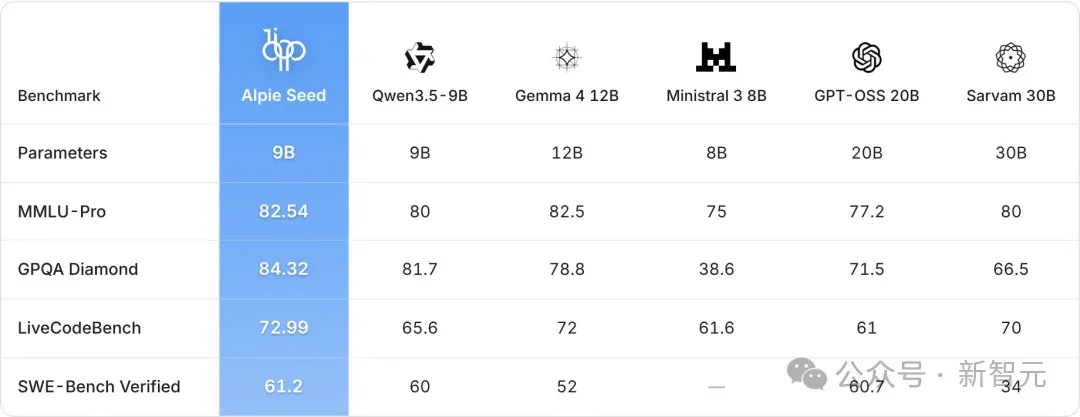
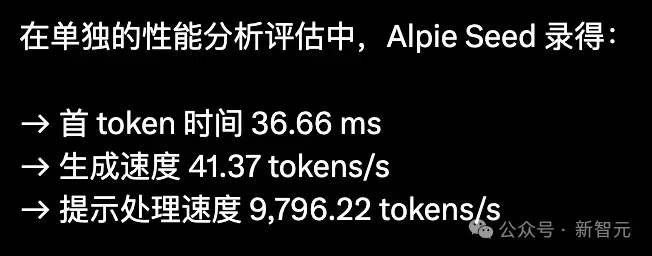
几百词的推文把自家小模型工程夸上了天,从头到尾愣是没提 Qwen 半个字,结尾还豪迈地写上印度制造、献给全球开发者。
可顺手点进 Hugging Face 的模型说明页,他们自己就招了。
Alpie Seed 压根没做过预训练,底座直接拉的 Qwen3.5-9B,先用 bitsandbytes 压成 4-bit NF4 量化版省显存,再挂个轻量级 DoRA 适配器跑完微调和强化学习就算交差。
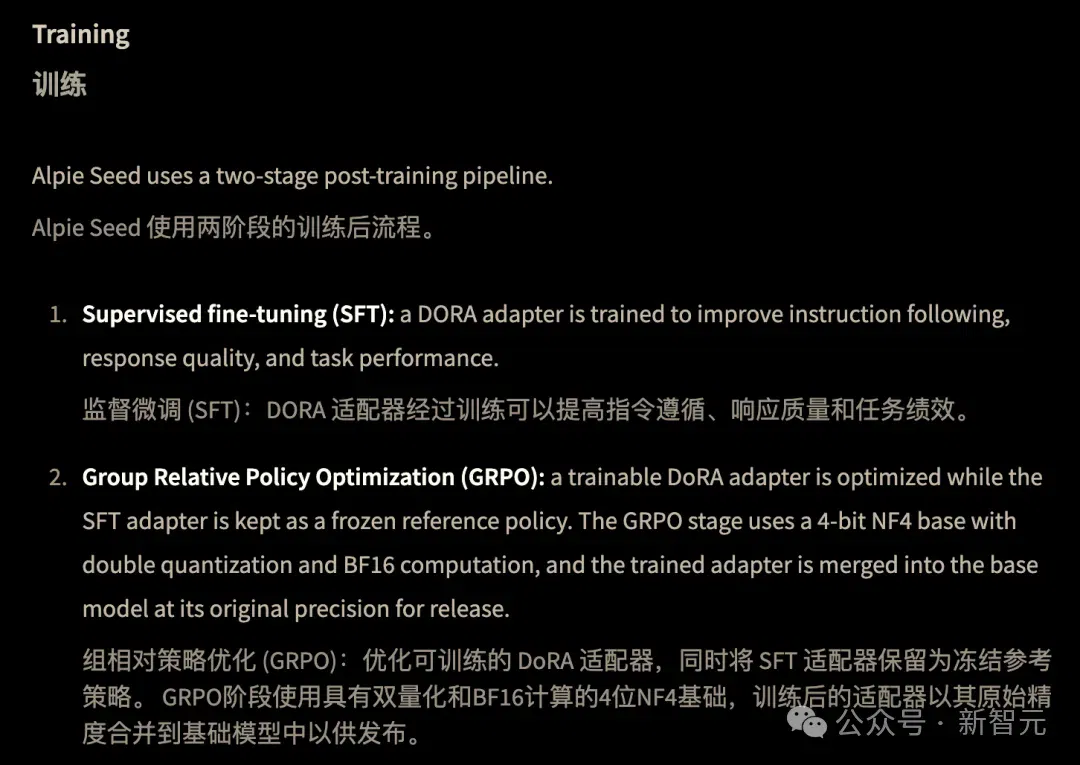
这套省钱方案租几张消费级显卡跑个把礼拜就能出活。
至于吹上天的跑分第一,推文末尾塞了句鸡贼的免责声明,承认对比图里别家的分数全是直接抄的旧报告,压根没在同一套测试环境里跑过。
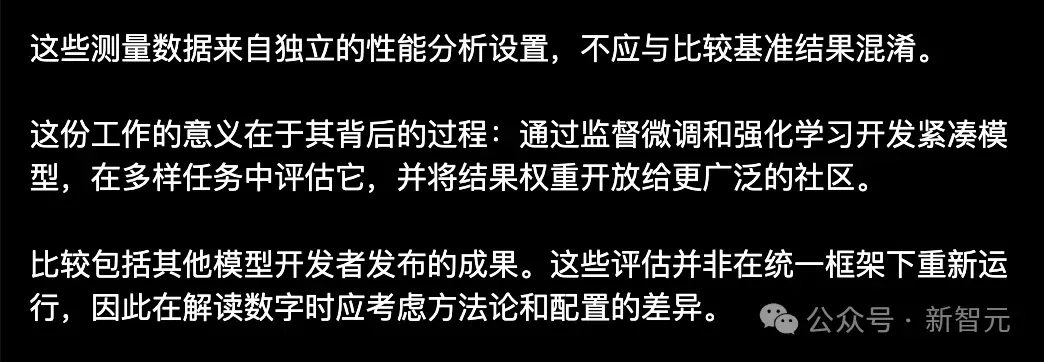
再翻翻他们在 Ollama 上的老底,之前发的 alpie-core 32B 模型干脆直接拿 DeepSeek-R1-Distill-Qwen-32B 做 4-bit 微调。
从 DeepSeek 到 Qwen,中国大厂花几亿美金训出来的开源基座,全成了这家公司随手贴牌的现成材料。
评论区里的护犊子奇观
这事儿被捅破之后,X 评论区内外充满了快活的空气。
偏偏评论区里还有一批人急着护短。
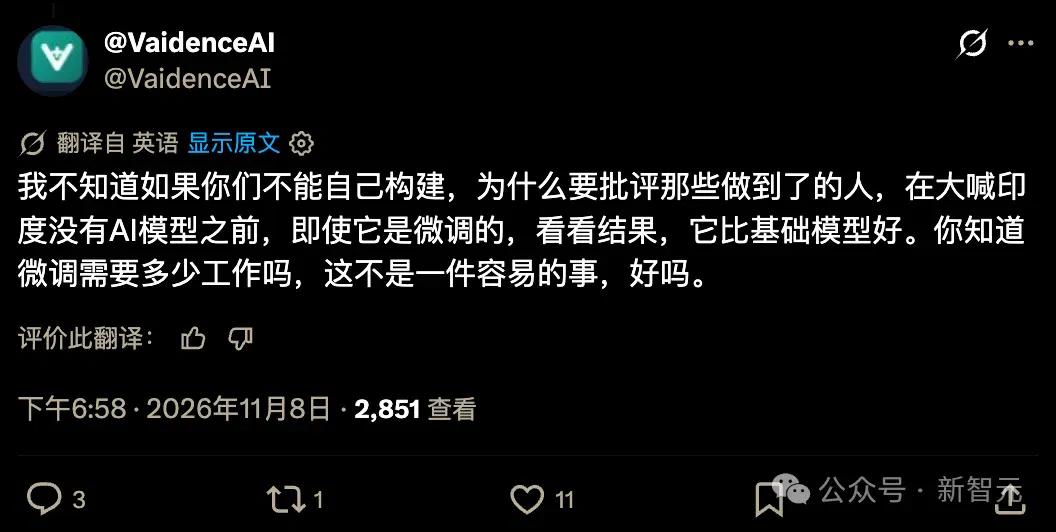
账号 VaidenceAI 跳出来训话,说你们自己造不出来就别批评造出来的人,知不知道我家哥哥搞微调有多难。
群众的眼睛是雪亮的。
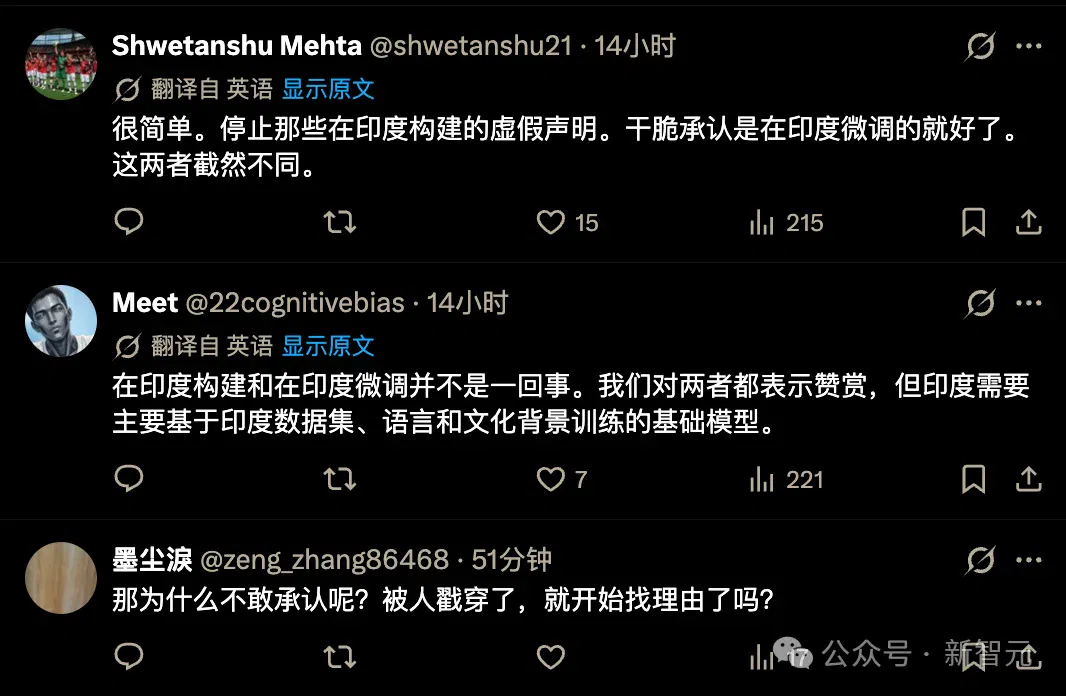
别的实验室微调没挨骂,是因为人家大大方方把基座名字写在最前面,更不会偷偷在模板里塞三句英文逼模型改国籍。
到了印度护短网友嘴里,只要扯上排灯节献礼和印度崛起,把别人的开源模型抹掉署名改行配置,也能算成忍辱负重的科研攻关。
别光笑印度
基座和后训练应分别披露
拿开源模型改个提示词就当自研,在整个行业里早就成了半公开的潜规则。
去翻翻过去半年东南亚、中东、欧洲乃至硅谷冒出来的各路「本土大模型」,跟 169Pi 干着同一件事的团队一抓一大把。
顺着这件事往后看,接下来一两年左右,整个 AI 行业有两场戏码大概率要上演。
第一场戏,未来 12 个月内,模型开发者对基座、许可证和后训练过程的披露,将影响外界如何判断自研贡献。
如今想从零训一个像样的多模态基座,算力集群和高质量语料的门槛高到离谱,全世界能玩得转的不过寥寥十几家公司,全集中在中美两国。
其它国家的团队既没卡也没数据,偏偏当地政府和投资人又急着要看国产大模型的政绩,最省钱的办法就是下个 Qwen 或 DeepSeek 跑轮微调交差。
随着模型指纹比对越来越准,这批靠改提示词骗经费的项目很快会排队现原形。
第二场戏,未来两年的全球 AI 应用生态,底子会彻底长在中国开源模型上面。
169Pi 这件事最讽刺的地方就在这儿,一个拼命想证明印度 AI 崛起的团队,老老实实抱紧了阿里的 Qwen3.5-9B 和 DeepSeek。
骂归骂,身体却诚得很。
这一案例说明,开放权重模型可以作为其他团队后训练的基础。
嘴皮子可以连夜改籍贯,模型底层的代码和权重不会撒谎。
参考资料:
https://x.com/169Pi_ai/status/2119333340696428838
文章来自于微信公众号 “新智元”,作者 “新智元”
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读相关主题与同栏目内容。
Seedance 2.5 flash 发布,智东西体验15秒猫咪跑酷视频(在新窗口打开)
字节披露更快生成与较低价格,媒体用480P短片测试镜头衔接和文字稳定性;部分背景招牌仍出现字形缺失。
未来序列获数百万美元种子轮融资,开发 AI 互动内容工具 NEX(在新窗口打开)
智能涌现采访团队,介绍互动剧本、分支玩法和视听生成流程,并讨论从专业创作者工具到海外娱乐平台的规划。
Prelulu 探索实时视频互动故事,角色记忆与成本成关键(在新窗口打开)
产品把文字、语音和实时角色通话结合,支持创作者设置人物。团队还在探索随剧情变化的环境,完整互动世界尚待开发。
据报小红书内测搭搭 App,尝试经验型 AI 角色与群聊(在新窗口打开)
读佳体验内测产品的角色创建、图文对话、多人群聊和账号授权,介绍把创作者经验做成可交互搭子的产品方向。
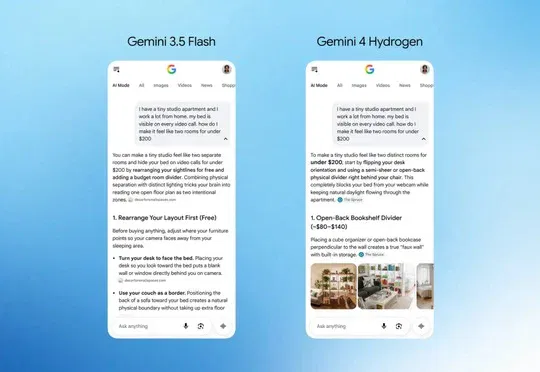
谷歌发布 Gemini 4 Hydrogen,并推出多模型 Orchestrator(在新窗口打开)
新版模型主打快速执行,覆盖编码与多模态任务。谷歌同步介绍不同入口的开放范围、API 价格和模型调度测试。