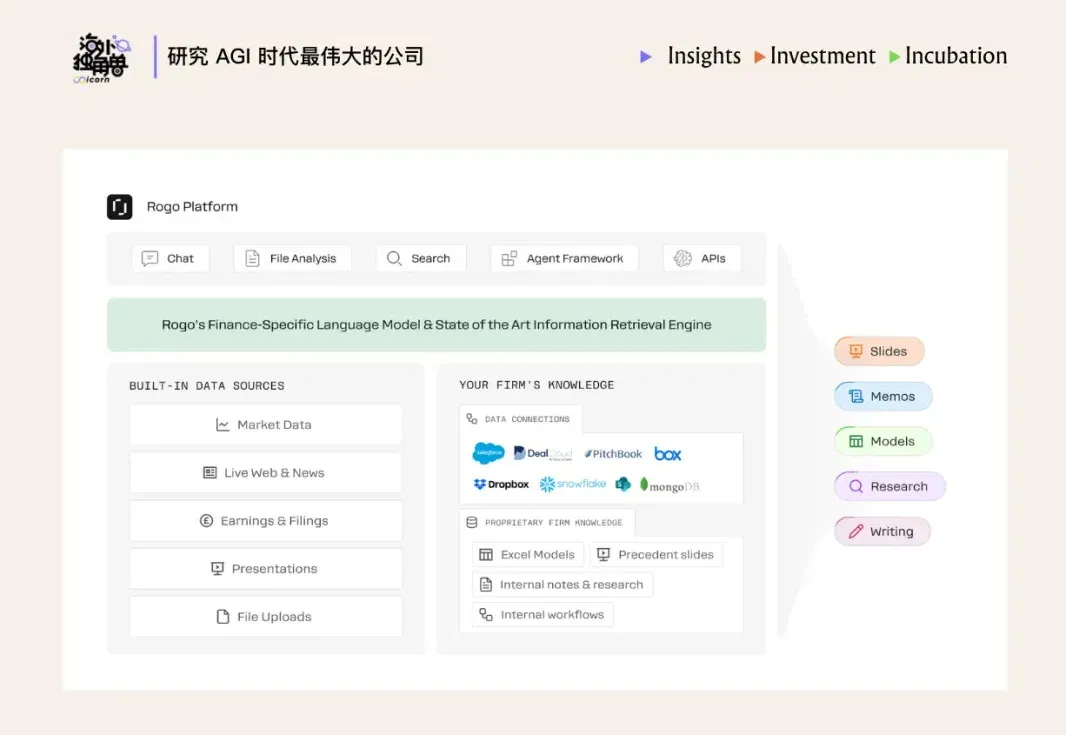
为什么顶尖投行都选择了 Rogo 这个金融 Agent?(在新窗口打开)
全球投行业每年处理超过 3.5 万亿美元的交易,但驱动这台庞大机器运转的,是数以万计每周工作超过百小时、从事着高度重复性劳动的初级分析师。Vertical Agent 开始加速很多专业领域的工作流,比如法律领域的 Harvey、医疗领域的 OpenEvidence,而在离钱最近的金融领域迟迟未能出现一款真正的统治级应用。
共 1881 篇
全球投行业每年处理超过 3.5 万亿美元的交易,但驱动这台庞大机器运转的,是数以万计每周工作超过百小时、从事着高度重复性劳动的初级分析师。Vertical Agent 开始加速很多专业领域的工作流,比如法律领域的 Harvey、医疗领域的 OpenEvidence,而在离钱最近的金融领域迟迟未能出现一款真正的统治级应用。
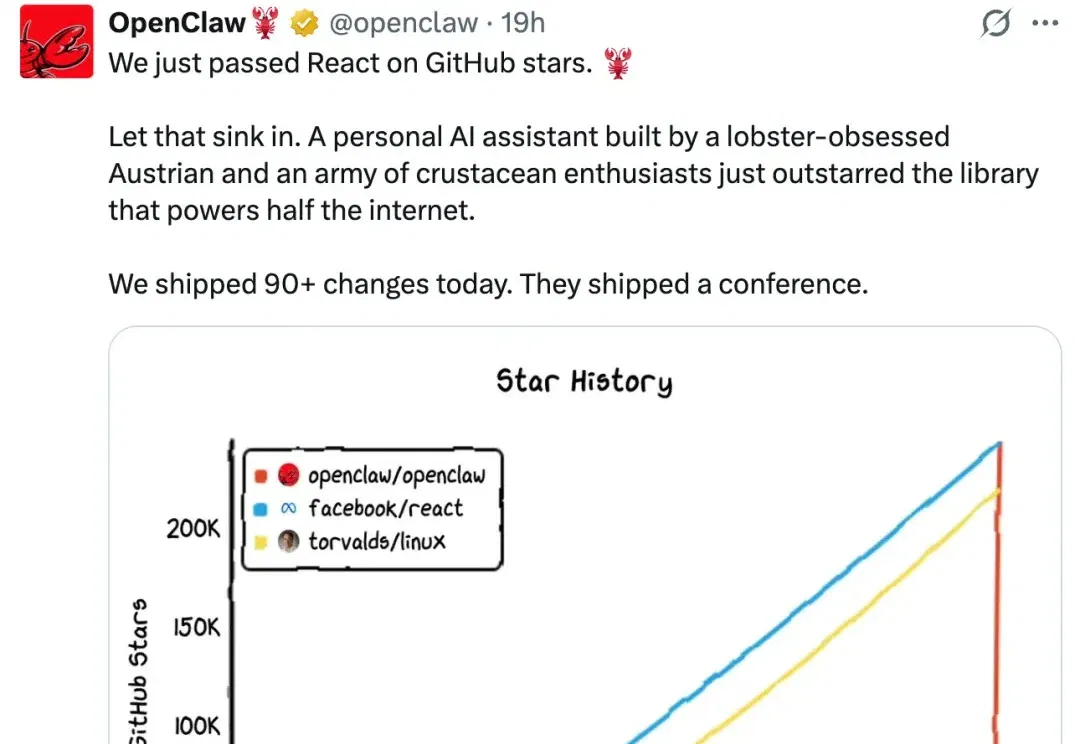
2026 开年已两个月,Agent 依然是全球最引人注目的 AI 赛道之一。OpenClaw(原 Clawbot)掀起的那波 Agent 热潮至今仍在发酵,甚至让「一人公司」概念第一次真正有了落地的可能性。
前天,MiniMax 更新了 MiniMax Agent,原先的专家 Agent 再度升级,这次还加了个新东西:MaxClaw —— 把最近在 GitHub 上爆火的 OpenClaw 做成了网页版,直接一键接入。
太带劲了!抢先Claude 5,OpenAI深夜祭出了一个编码杀器——Codex。它可以让一人指挥多Agent并行协作,自带Skills,编码从此进入自动化时代。
Veza 的订阅软件帮助企业了解其员工以及自动化软件任务的 AI Agent对特定客户或公司数据的访问权限,以及他们能对这些数据做什么。ServiceNow 一直在加强其 AI Agent相关的产品,这些产品旨在自动化客户服务和响应IT 帮助台请求等任务。
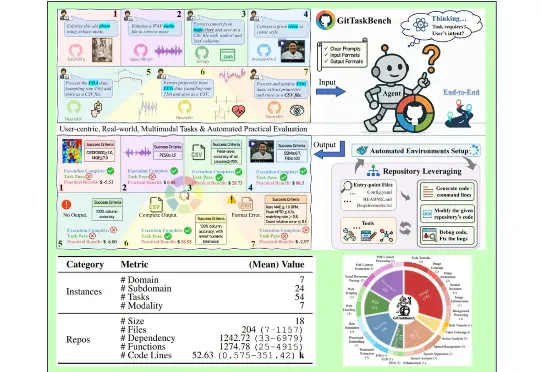
我们也看过各种 AI Coding 领域的评测,发现大多停留在了 「代码生成」与「封闭题目」的考核,却忽视了环境配置、依赖处理、跨仓库资源利用等开发者必经的真实需求 —— 当下众多 Benchmark 仅通过题目,已难以衡量 Code Agent 的实际效果。
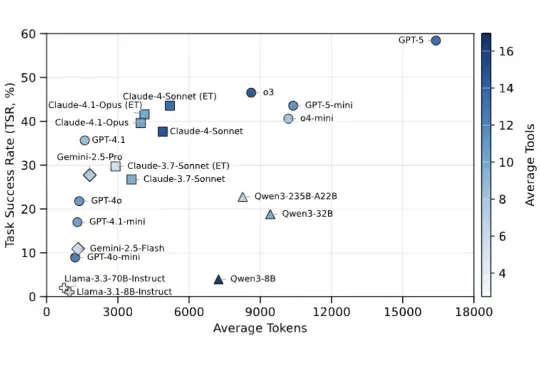
杜克大学与 Zoom 的研究者们推出了 LiveMCP-101,这是首个专门针对真实动态环境设计的 MCP-enabled Agent 评测基准。该基准包含 101 个精心设计的任务,涵盖旅行规划,体育娱乐,软件工程等多种不同场景,要求 Agent 在多步骤、多工具协同的场景下完成任务。
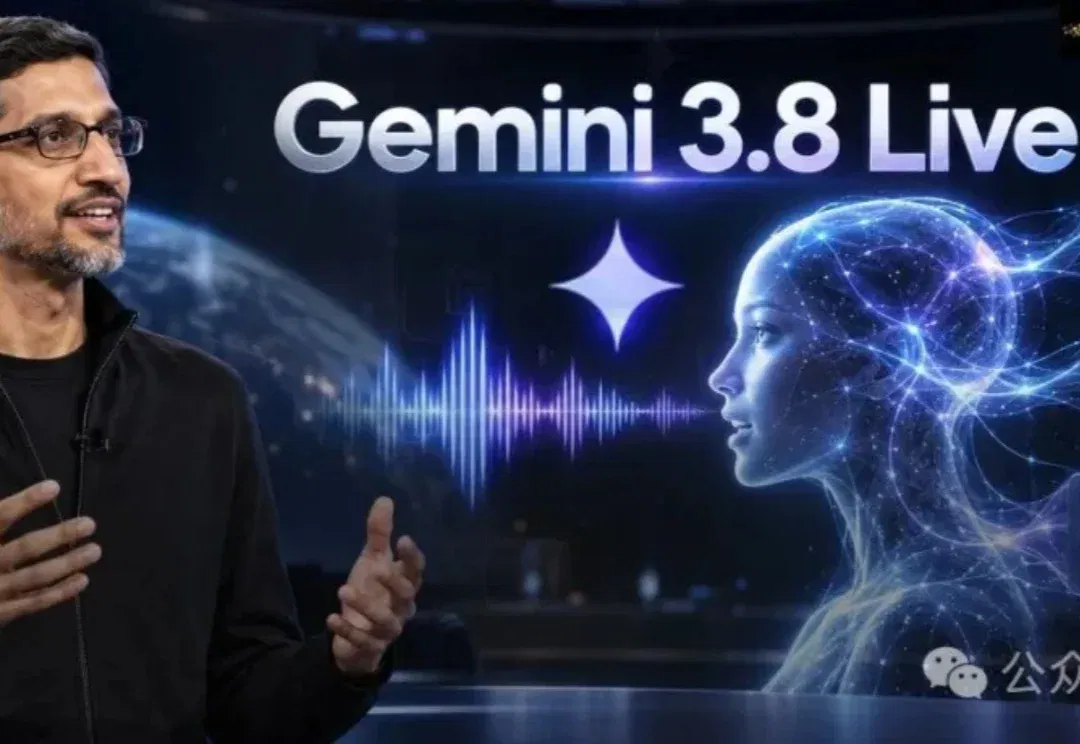
谷歌又杀回来了。 今夜,Google DeepMind 一口气放出两个模型——Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking。 官方称它们是谷歌迄今最先进的实时对话模型。 在 Artificial Analysis 的语音质量榜上,Extended Thinking 拿下总榜第一,82.6 分。 在 ServiceNow 的语音 Agent 测试里,以前的模型要么答得准但聊起来像机器人,要么聊得顺但老办错事。 这两个模型第一次把准和顺同时往前拱了一步。 刚吵完 RSI,谷歌交了份语音作业 就在上周,AI 圈知名泄密账号 Lyra 发了一条
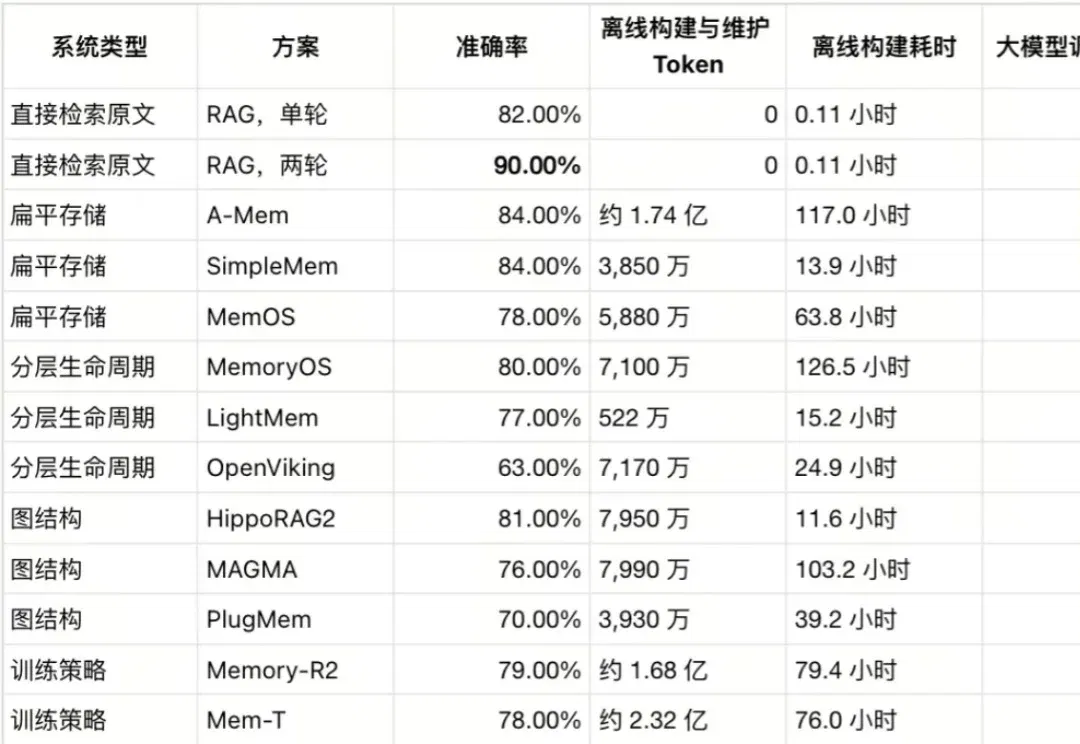
Memory Tax 比较11种开源记忆系统与检索原始对话的RAG。在所选LongMemEval-s实验中,两轮RAG领先全部受测系统;研究还发现摘要信息丢失和检索遗漏。联合检索原文可改善结果,但两轮查询也增加在线调用与等待成本。
奥特曼在 ADIPEC 演讲中回顾 OpenAI 的数学研究并预告下一代 GPT。官方技术说明显示,万级 Agent 实验仍包含研究人员设题、资源调配和结果整合,不能等同完全无人参与;具体型号、发布时间及公众能否使用同等系统仍待确认。