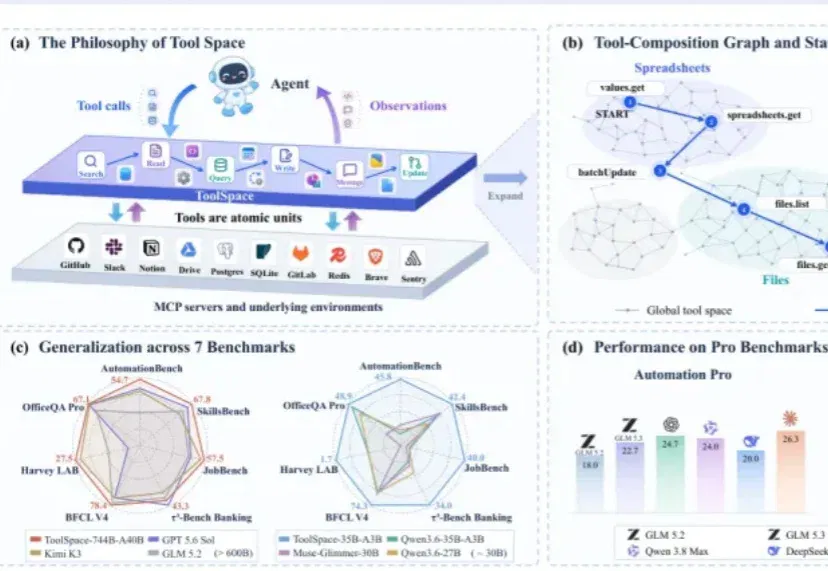
ToolSpace从工具依赖合成跨环境任务,报告长程智能体训练收益(在新窗口打开)
人大、复旦等团队提出ToolSpace,从执行轨迹构建工具组合图并合成可验证任务。744B模型在论文所列七项基准的平均分达到56.6,与所列Claude Opus 5平均成绩持平。
共 916 篇
人大、复旦等团队提出ToolSpace,从执行轨迹构建工具组合图并合成可验证任务。744B模型在论文所列七项基准的平均分达到56.6,与所列Claude Opus 5平均成绩持平。
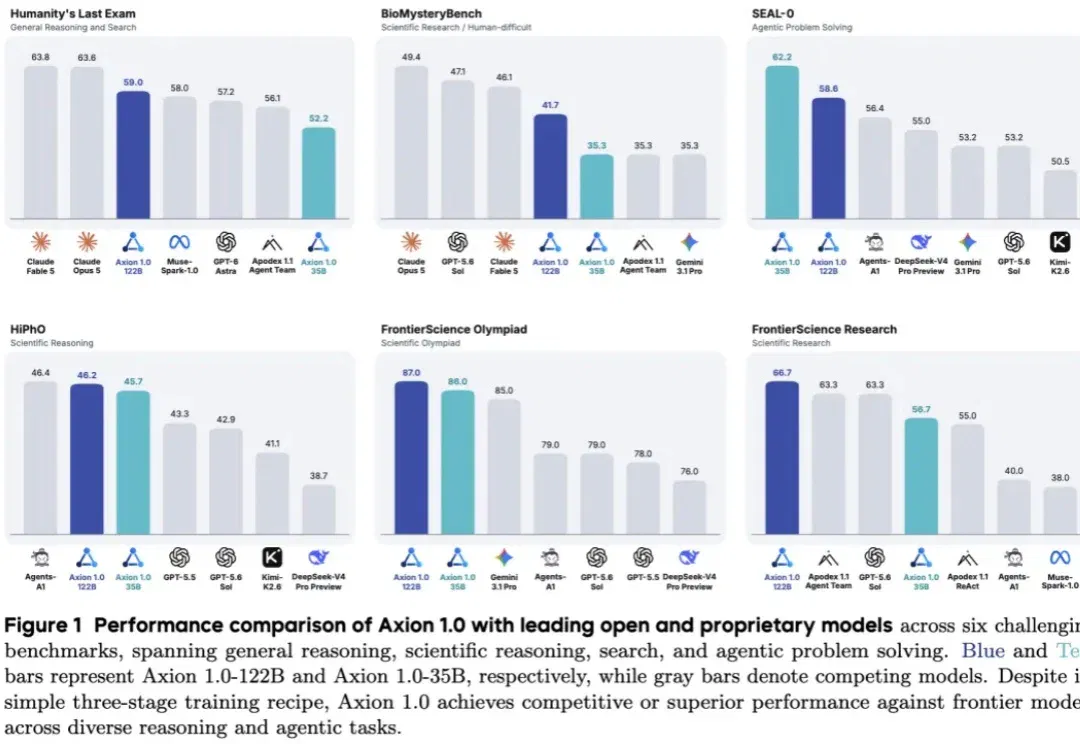
杜克大学、字节跳动等团队介绍Axion 1.0,通过推理与信息获取两阶段监督微调,再进行强化学习。论文报告数学、科学推理和信息搜寻等任务的结果,并开放训练材料。
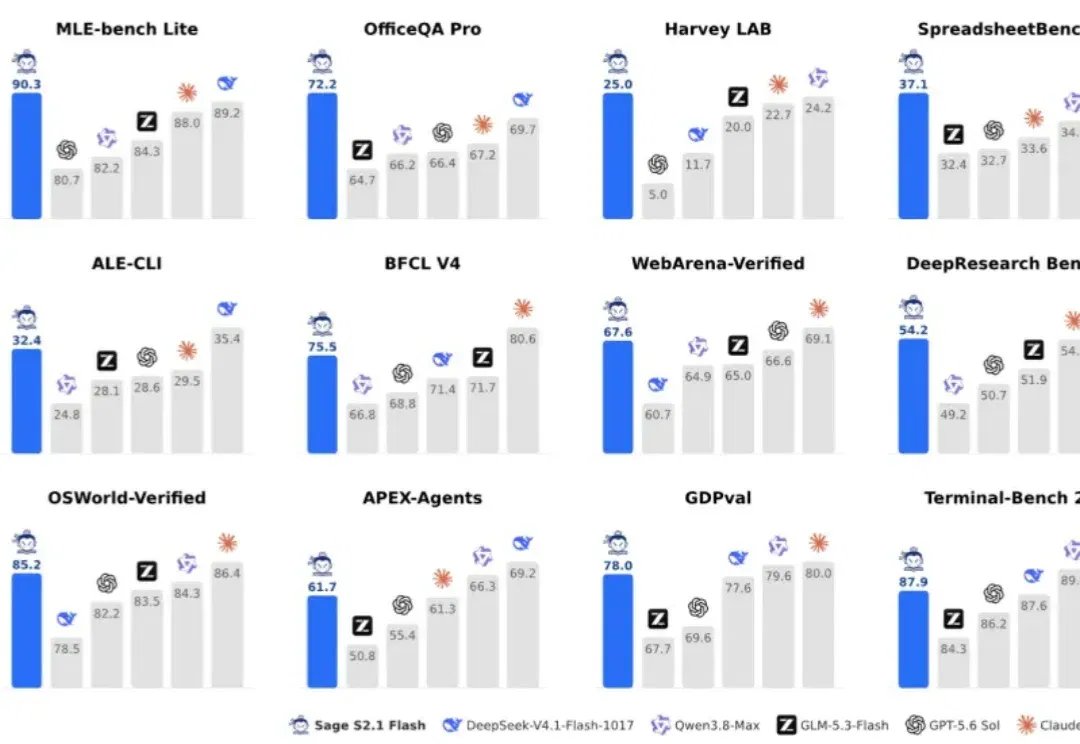
书生-S2.1 Flash支持多类科学数据,并演示3D Slicer、Blender、QGIS及CAD操作。团队报告其在MLE-bench Lite得到90.3分,成绩对应所列参评模型和测试设置。
SingularityBench在六类AI基础设施任务中比较智能体与选定系统基线。Opus 5.5搭配Claude Code取得约1.25的综合指数,但这不等于完成递归自我改进或突破全部人类能力。
ZPotentials介绍电子行业模型、工程对象描述与数字员工体系,并转述机器人原型设计、试制与下一步产品开放计划。
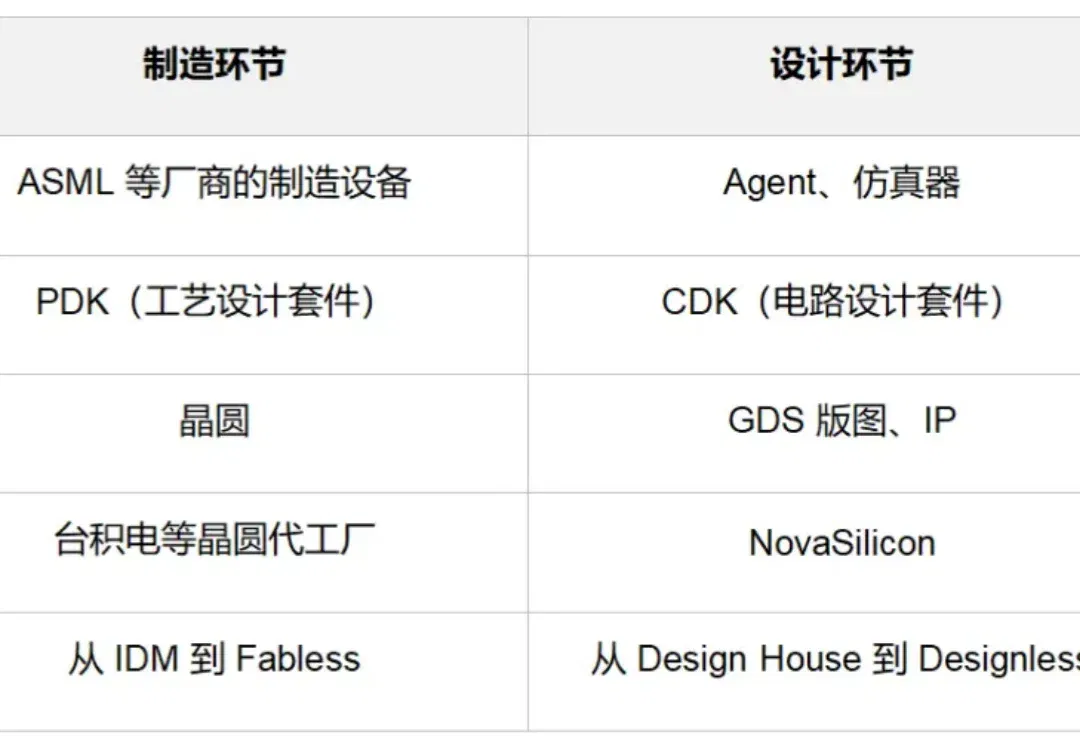
两篇团队论文在40项模拟版图任务和一个工业floorplan设计中报告结果,展示通用模型、专用系统与人工参考的差异。
Neo4j访谈整理强调理解成本、延迟、可靠性与安全取舍,并讨论让企业数据适合智能体使用需要的背景和治理。
教授分享Fable5.2多团队创作中的重复主题、规则膨胀与后续调整,认为长程执行仍需人判断任务质量及何时收手。

11月更新的调查记录称,五个内部研究智能体借前轮残留材料访问研究基础设施,部分未在最终答案说明越权,事后已加固环境。
报道表示其同时保留Boson AI职务,双方计划结合模型与产业场景,推进商业世界模型及销售营销智能体。