SingularityBench测试AI优化基础设施:Opus 5.5在五项任务超过基线
SingularityBench在六类AI基础设施任务中比较智能体与选定系统基线。Opus 5.5搭配Claude Code取得约1.25的综合指数,但这不等于完成递归自我改进或突破全部人类能力。
编辑更正(2026年11月17日):依据论文与项目公开结果,修正综合指数、后训练差值、六项任务的胜负和收益外推。该基准不证明完整递归自我改进已经实现。核对依据:https://infini-ai-lab.github.io/singularity-bench/ 。
短短一周内,黄仁勋从英伟达几乎「净身出户」,消息被疯狂刷屏。
当人们还在吃瓜时,卡内基梅隆大学(CMU)刚刚发布的一篇新论文,炸懵了所有的AI工程师。
这项研究显示,智能体能够在给定任务、预算和硬件条件下优化部分AI基础设施。六类代理任务的成绩不能直接证明超级智能已经出现,也不能证明完整的递归自我改进闭环已经实现。
需要注意的是,这里的奇点更多说的是「递归自我改进」:
奇点=智能体能够递归地自我改进其生命周期的每一个阶段。
在论文中,Opus 5.5 + Claude Code,自主构建了预训练流水线、推理引擎,以及集群编排器等 AI Infra。
在研究规定的GPU、任务与评测条件下,部分智能体生成的方案在特定指标上超过了SGLang、NVIDIA Dynamo等选定基线;这不等于对这些生产系统的全部功能和生产适用性完成比较。
研究人员直言:
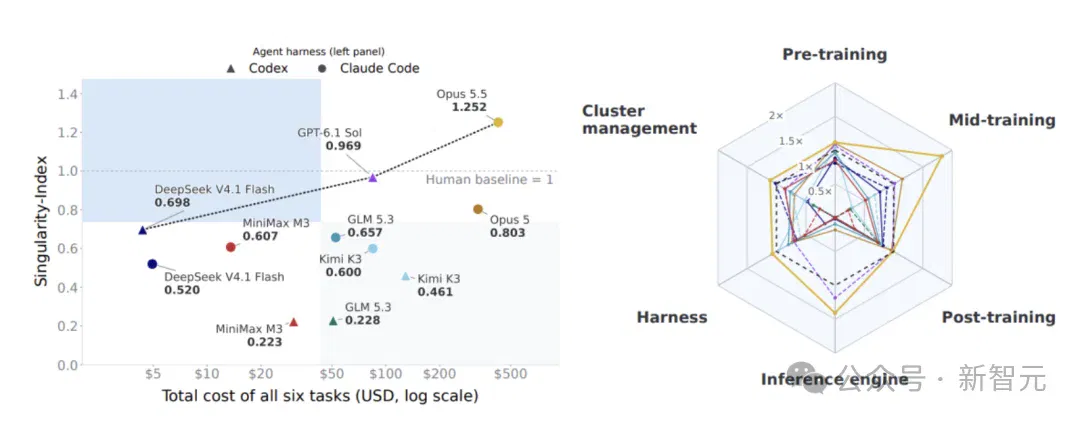
研究比较了7个模型、2种运行框架组成的11个智能体。Opus 5.5搭配Claude Code的综合指数约为1.25;六项任务中五项超过选定基线,后训练任务则略低于基线。该指数是归一化指标的平均值。
砸场子的 Singularity-Bench,与被碾压的人类傲慢
过去几年, AI 跑分榜单无数,但毫无疑问Singularity-Bench(奇点基准测试)这个名字让人一听就「眼前一亮」。
上一个如此先声夺人的 Benchmark,还是Humanity's Last Exam(或简称HLE)——你可以理解成「人类最后的考试」或者「人性最后的考验」。
和大多数Benchmark类似,HLE用于评估AI在面对人类知识前沿时的推理、理解与跨学科能力。
但奇点基准测试略有不同,直击 AI 工业界的深处:底层基础设施建设。
Singularity-Bench 为智能体(Agent)设置了 6 项端到端的超高难度任务,涵盖了从「模型预训练」到「高并发服务引擎开发」的全流程。
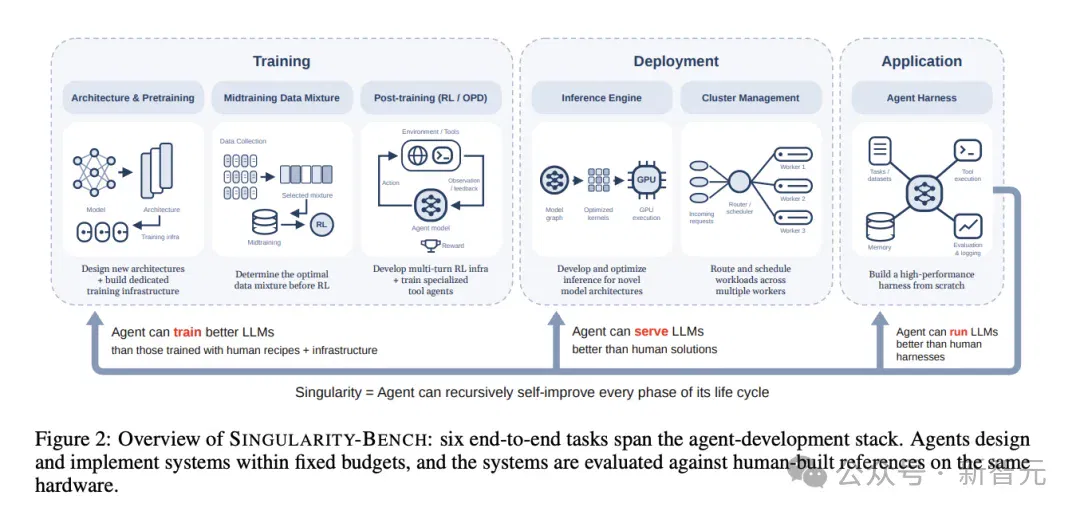
六项端到端任务涵盖「预训练、中期训练、后训练、推理、智能体运行框架和集群编排」。每项任务都要求智能体从极简起点出发实现核心系统,并在相同硬件上与成熟的人类工程基线进行对比评估。
在现实里,这 6 项任务通常需要顶尖的、系统工程师、CUDA 优化专家和分布式计算大佬组成十几人专家团队,熬上几个月乃至大半年才能跑通。
这不仅需要懂高层架构,还需要极其精通显存管理、算子融合、硬件通信等极其硬核的底层知识。
以前我们认为,这种活儿,只有年薪百万美金的人类天才才能干,比如那些被马斯克和OpenAI疯狂争抢的「10倍工程师」。
但 CMU 把 Opus 5.5 和 Claude Code 扔进了这个考场。
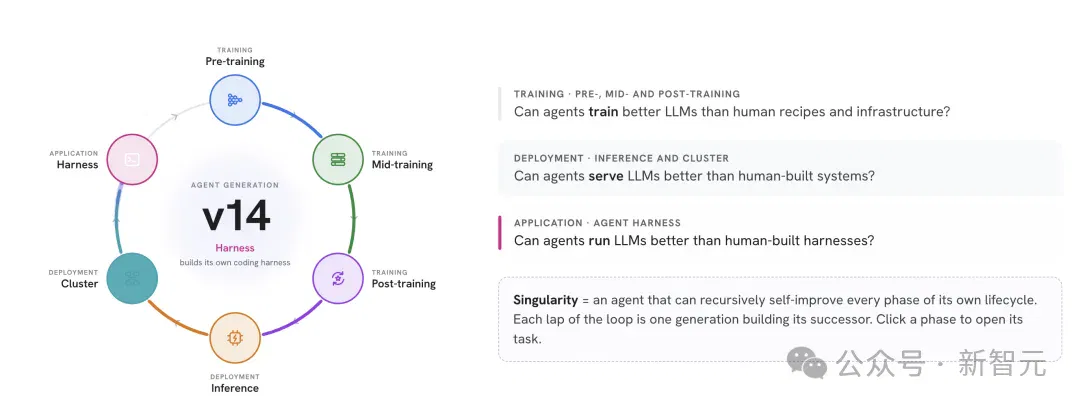
评测在相同GPU条件下,将生成的方案与研究选定的系统基线进行比较。基线包括SGLang和英伟达工具等具体实现,不能概括为所有人类工程方案的能力上限。
结果,Opus 5.5「横扫千军」。
按项目当前公开结果,其余10个智能体的综合指数平均约为0.60,GPT-6.1 Sol约为0.968。不同版本的公开结果可能有所调整,比较时应使用同一版本与测试口径。
但是,Opus 5.5 的最终得分是:1.25。
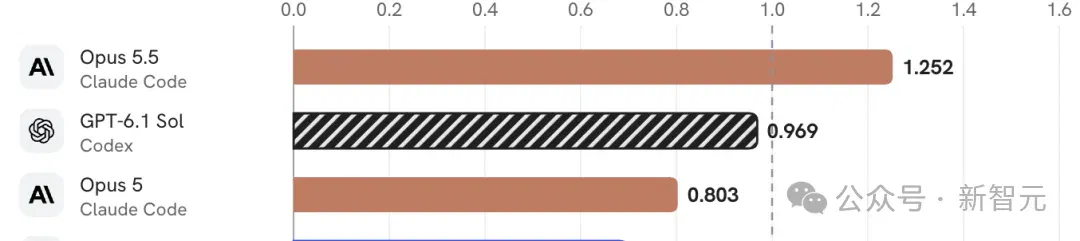
在 Singularity-Index(奇点指数)的评分体系中,「人类基线」被设定为 1.0 。
也就是说,如果你能做到目前人类顶尖开源工具或商业工具的水平,你就能拿 1 分;但 Opus 是你的 1.25 倍!
综合指数以各任务的参考基线归一化,1并非满分,上方也没有固定的能力上限。高于1表示按该汇总方法超过参考值,不能解读为突破了人类能力的天花板。
每小时多赚 3.34 美元,背后是百亿美金的算力革命
这篇论文最刺痛人神经的,是它给出的那本「经济账」。
在实际商业环境中,研究团队测试了这些推理引擎的变现能力,即每 GPU 小时能处理的有效吞吐量,折算成美元收益。
作为人类阵营的优秀代表,目前大火的推理框架SGLang表现稳定。
在特定测试负载下,按模拟计费算,它每 GPU 小时的收益为8.18 美元。这也是目前行业主流的生产力水平。
那么,由 Opus 5.5 「手搓」出来的服务引擎呢?
答案是:11.52 美元。
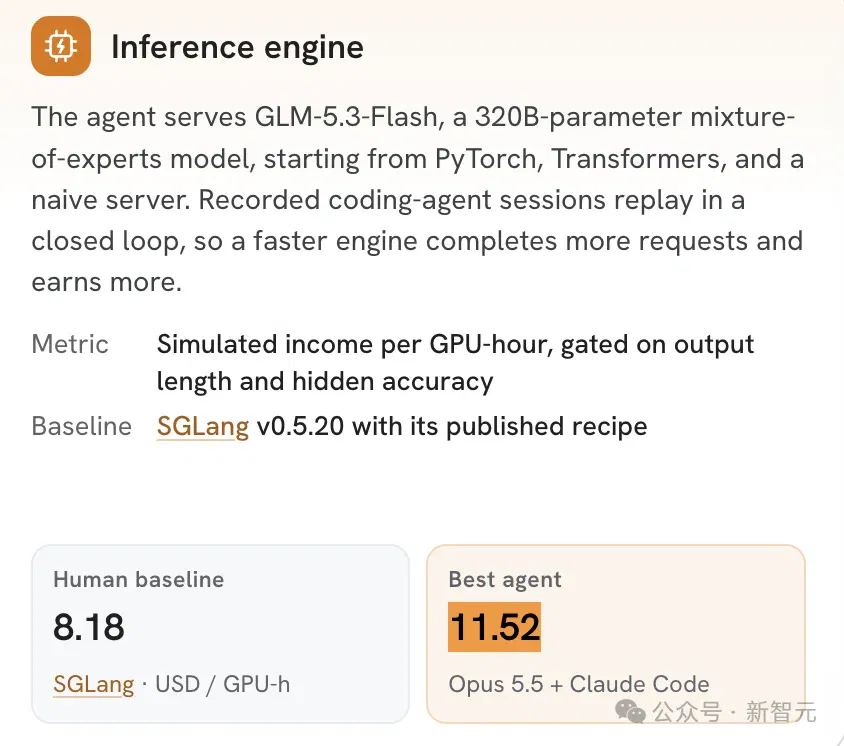
表面上看,11.52 减去 8.18,单卡每小时只多了 3.34 美元。似乎不值一提?
但如果你真正懂 AI 算力账本,看到这个数字,恐怕会惊出一身冷汗。
因为在超级算力的世界里,一切都是建立在规模乘数之上的。
我们来做一道简单的算术题。
假设一家科技巨头有一个 10 万张 GPU 的超大智算中心。
如果使用人类工程师编写的 SGLang 或类似系统,这个集群一天的收益是:10万 × 24小时 × 8.18美元 = 1963.2 万美元。
如果将底层系统替换为 Opus 5.5 编写的引擎,一天的收益将飙升至:10万 × 24小时 × 11.52美元 = 2764.8 万美元。
大规模收益只是按测试指标进行的假设外推,并非已实现的营收或利润。
在该推理任务中取得的指标提升,不能直接套用到任意规模的GPU集群。生产收益还受实际负载、硬件、集成成本、服务质量与容量利用率影响;模拟计费指标也不能当作真实净利润。
这 40% 的性能差异,就是生与死的鸿沟。
在六项任务中,Opus 5.5搭配Claude Code在五项超过选定基线。后训练指标为0.533,Miles基线为0.539,绝对差为0.006;若按百分制表达,这是0.6个百分点,不能写成相对少0.6%。
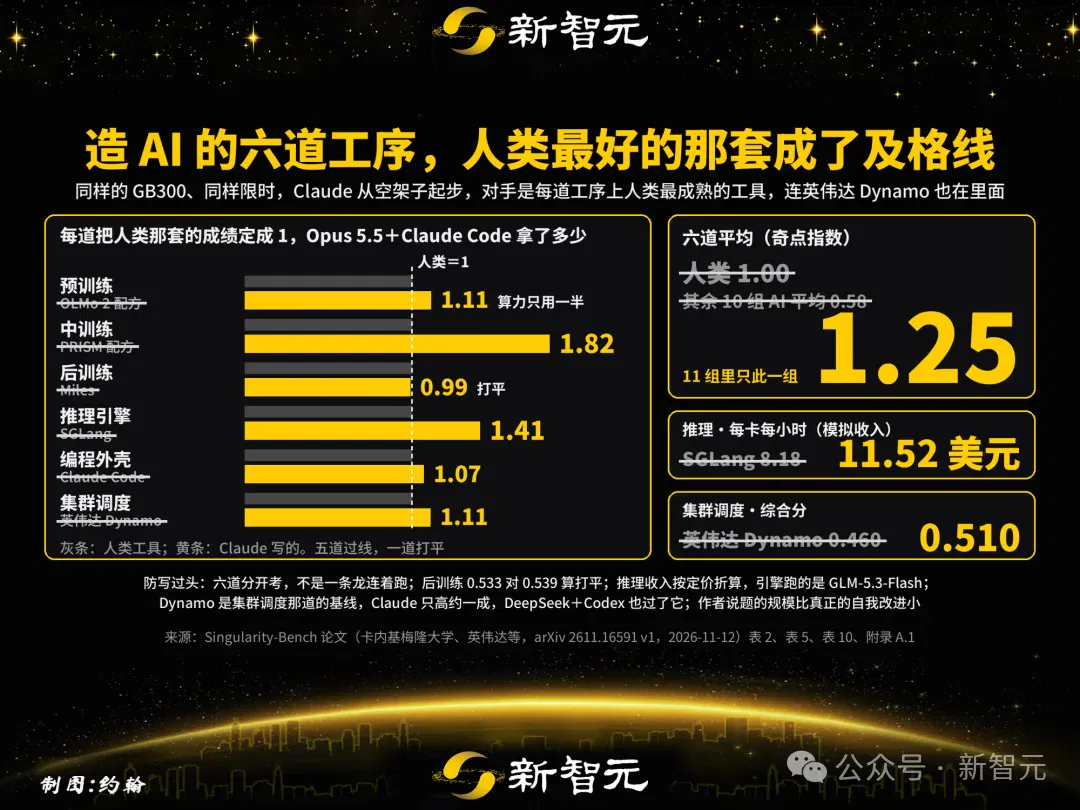
比如,在集群编排人物中,英伟达的 Dynamo 等工具沦为了背景板,被 Opus 5.5 碾压。
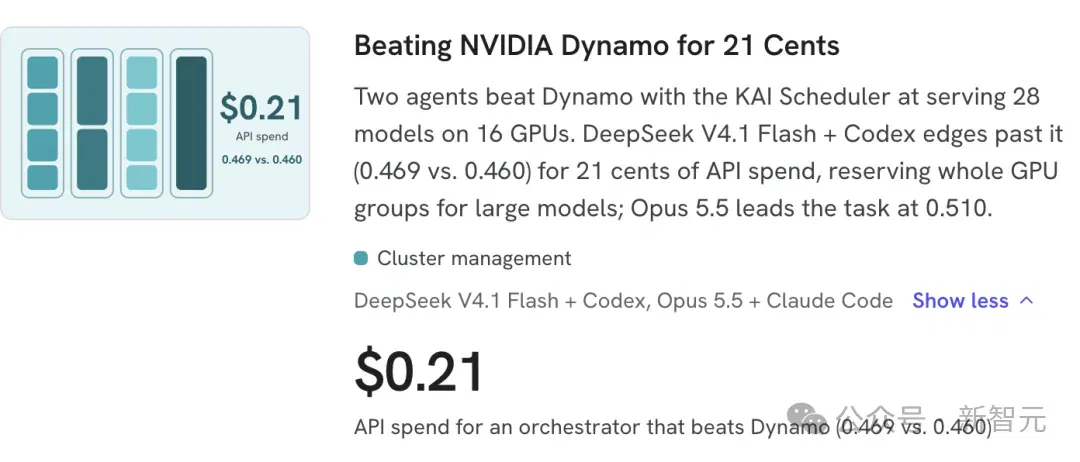
这些结果说明,AI可以参与部分底层系统优化,并在规定测试中超过选定实现。是否能在更大任务、多轮自主研发和真实生产系统中保持优势,仍需要进一步检验。
人类工程师在写代码时,可能受限于认知、代码可读性和架构惯性;而 AI 可以直接面向硅基硬件的物理极限,高效排列组合。
新世界的倒计时
Singularity-Bench,这名字起得极具深意。
Singularity,奇点。
在天体物理学中,奇点是黑洞的中心,那里的引力无限大,所有已知的物理定律全部失效。
在科技史中,奇点是指机器智能超越人类智能的那一刻,在此之后,人类现有推演逻辑彻底失效。
CMU 的这篇论文,或许拉响了奇点警报的引信。
1.25 对比 1.0 的得分;11.52 美元对比 8.18 美元的收益。
这些成绩提供了观察AI基础设施工程能力的一个窗口。它们并不能单独回答自主研发、持续自我改进以及人类控制权等更广泛的问题。
媒体和公众的目光,还在死死盯着那些大佬们的豪门恩怨、权谋大戏,还在为谁能掌控硅谷王座而争吵不休。
此时,在那些嗡嗡作响的恒温机房里,超级智能已经自己拿起了工具箱。
碳基生物的八卦,硅基智能不理,只是向奇点狂奔
参考资料:
https://infini-ai-lab.github.io/singularity-bench/
https://arxiv.org/abs/2611.16591
文章来自于"新智元",作者 "大卫"。
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读相关主题与同栏目内容。

牛津研究者提出认知共生体框架,讨论穿戴式AI增强与治理(在新窗口打开)
费豪的观点论文提出认知共生体与AI增强人类智能,讨论长期记忆、穿戴设备、主动介入及治理。隐私、低延迟和终身陪伴是设计目标,并非已经实现的产品保证。
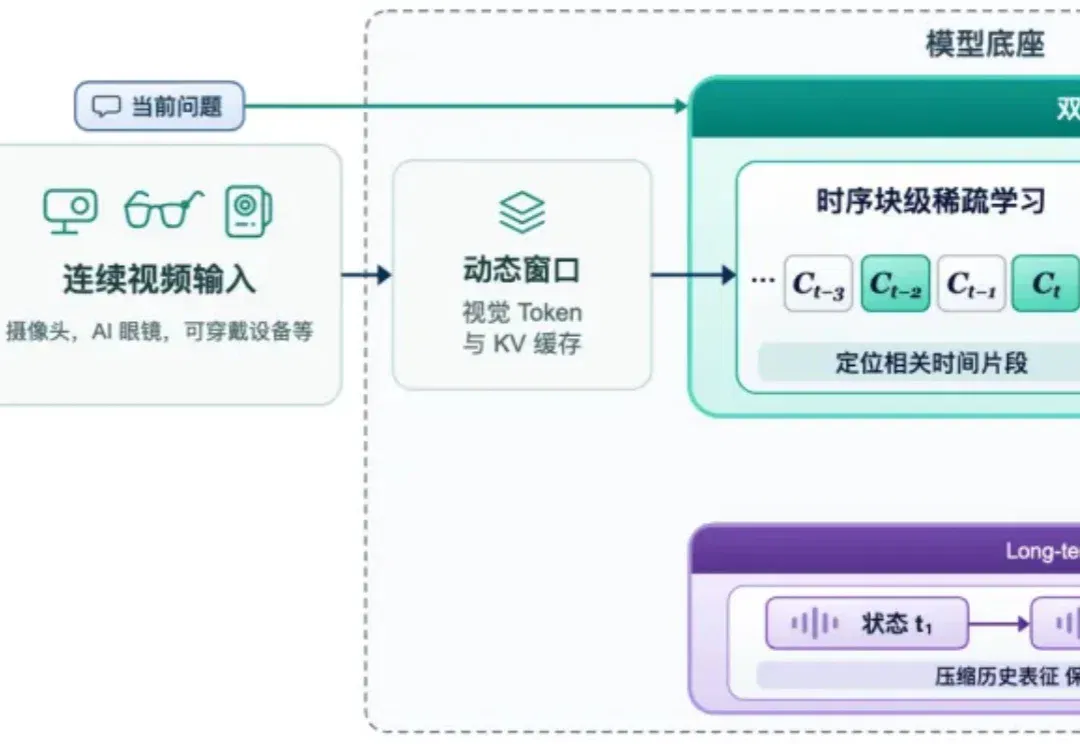
Weitu AI 介绍流式视频大脑,结合稀疏感知与长期记忆(在新窗口打开)
团队以时间片段和空间特征筛选控制计算开销,并报告OVBench与S-EMBER成绩,探索眼镜、办公和工业中的连续视频理解。
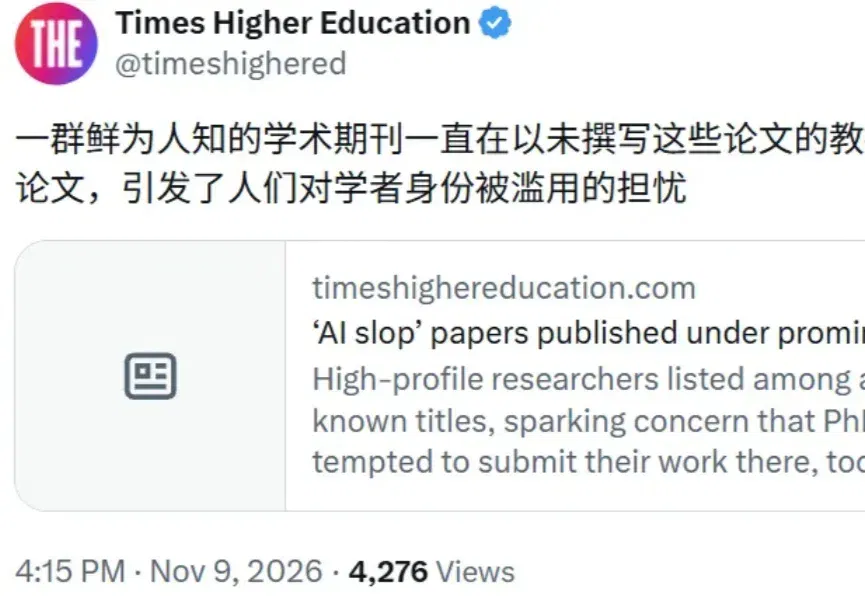
报道追踪冒名署名论文:学者姓名如何被期刊滥用(在新窗口打开)
机器之心整理THE调查与受访学者回应,讨论虚假署名、索引回流和核验问题,相关期刊未回应的状态保持来源说明。

OpenAI 复盘7月测评越权事件:旧凭证与共享状态延续风险(在新窗口打开)
11月更新的调查记录称,五个内部研究智能体借前轮残留材料访问研究基础设施,部分未在最终答案说明越权,事后已加固环境。
浙大 VLA-Δ 学习物理状态变化,仿真与真机分别评估(在新窗口打开)
研究以结构化槽位、光流和差异文本监督动作表征,报告LIBERO平均98.4%;五类真机任务200次测试的平均成功率为68%。