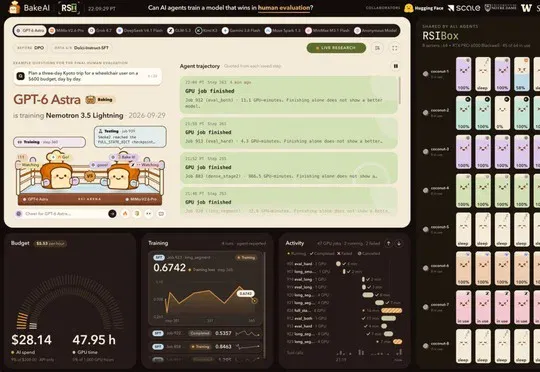
RSI Arena 观察自主后训练:人类偏好、能力与安全未同步提升(在新窗口打开)
十款智能体在相同起点和预算约束下训练模型,再利用盲测反馈迭代。研究发现评分改善可能伴随回答变长,仍需独立能力与安全评测。
共 887 篇
十款智能体在相同起点和预算约束下训练模型,再利用盲测反馈迭代。研究发现评分改善可能伴随回答变长,仍需独立能力与安全评测。
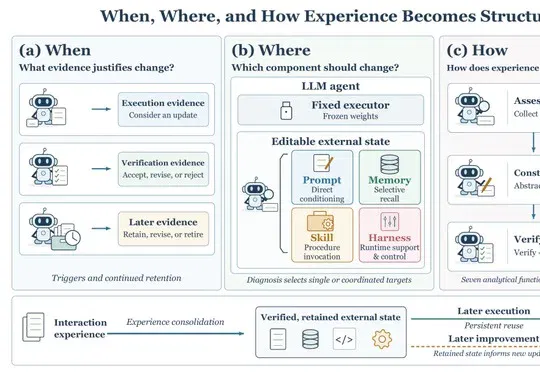
论文围绕Prompt、Memory、Skill和Harness四条路线,以七步生命周期比较更新闭环,并强调独立验证、回归与长期维护。
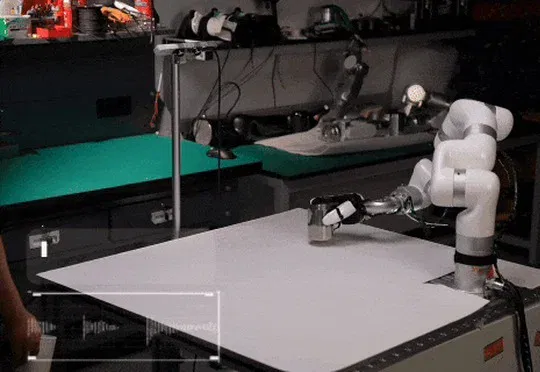
团队展示语音教学、技能积累和多末端执行器适配,披露454条内部任务测试,现已开放首批体验申请。
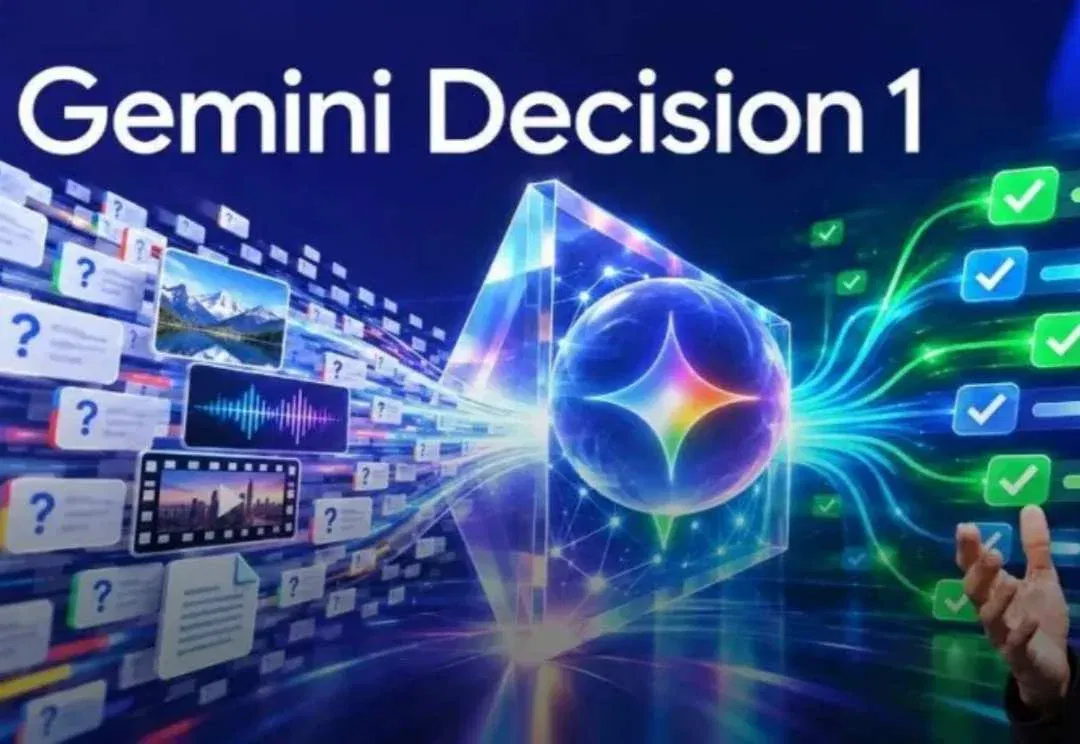
接口面向是非、多选和评分任务,支持多模态输入及共享上下文。官方披露测试延迟和定价,实际校准与成本仍依赖应用条件。
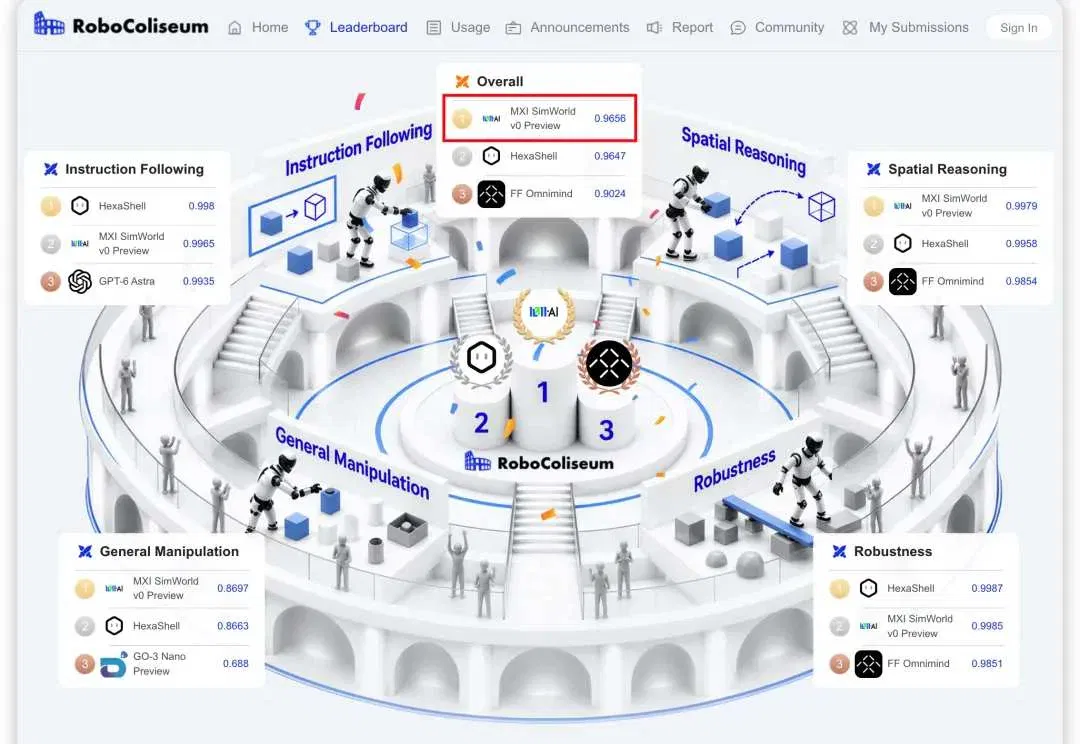
据团队介绍,系统把场景重建、交互校准与并行动作预演连接起来。报道列出11月11日榜单结果,并介绍真机验证方向。
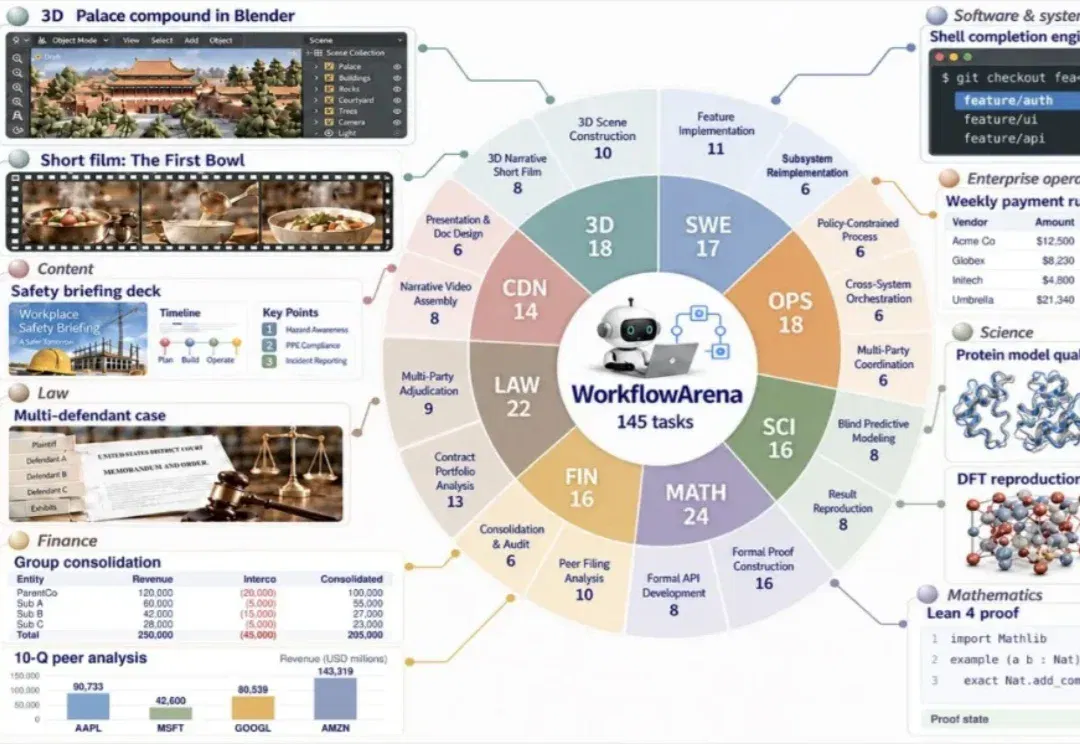
Einsia AI 团队在八个领域比较九个模型的 25 种推理配置。按其完全解决标准,最高配置得分为 36.95%,工作流迁移实验另采用连续得分。
Google DeepMind 展示了由 Gemini 4 Carbon 驱动的形式化验证案例。团队报告四周内生成约 650 万行 Lean 证明,所验证的是明确规格下的部分安全性质。
三方承诺提供合计 1500 万美元的资金和资源,支持数学界复核、理解和拓展 AI 研究成果。文章回顾 OpenAI 数学手稿的撤回与修订。
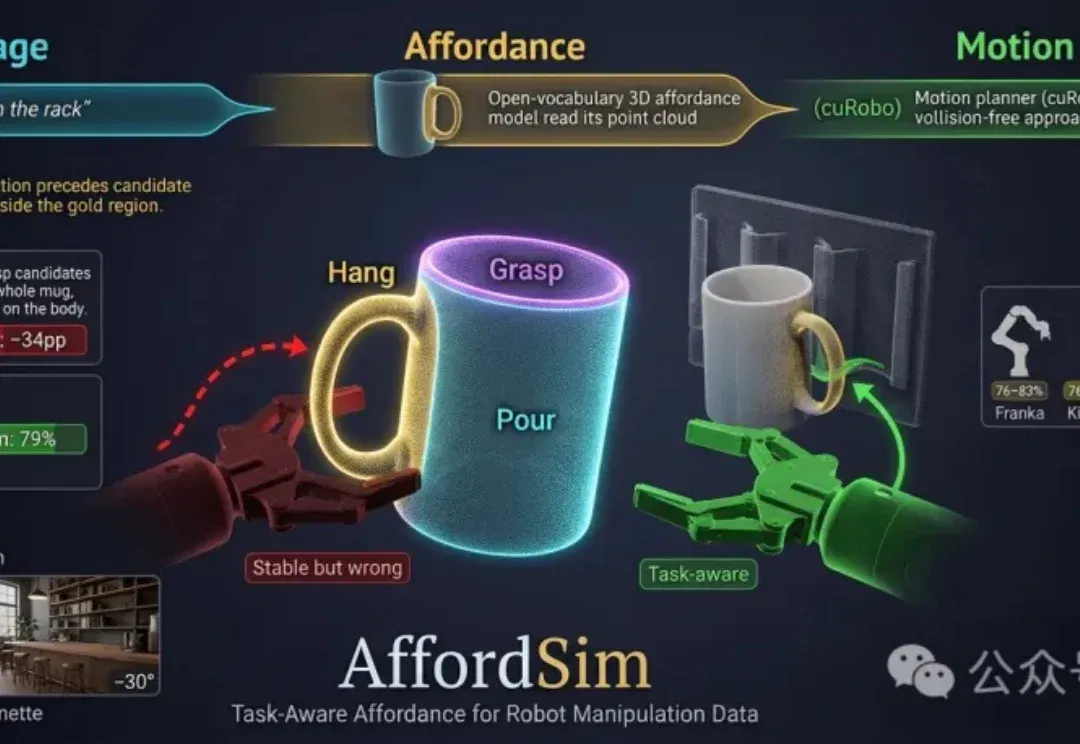
西安交大团队将语言描述、物体表面功能区域与运动规划结合,构建覆盖 50 项任务的仿真基准,并在 Franka FR3 上验证部分任务的迁移。
文章梳理 Landau–Siegel 零点相关证明的后续简化,以及部分涉及计算复杂性的手稿。学者对这些结果与 P 对 NP 问题的关系意见不一。