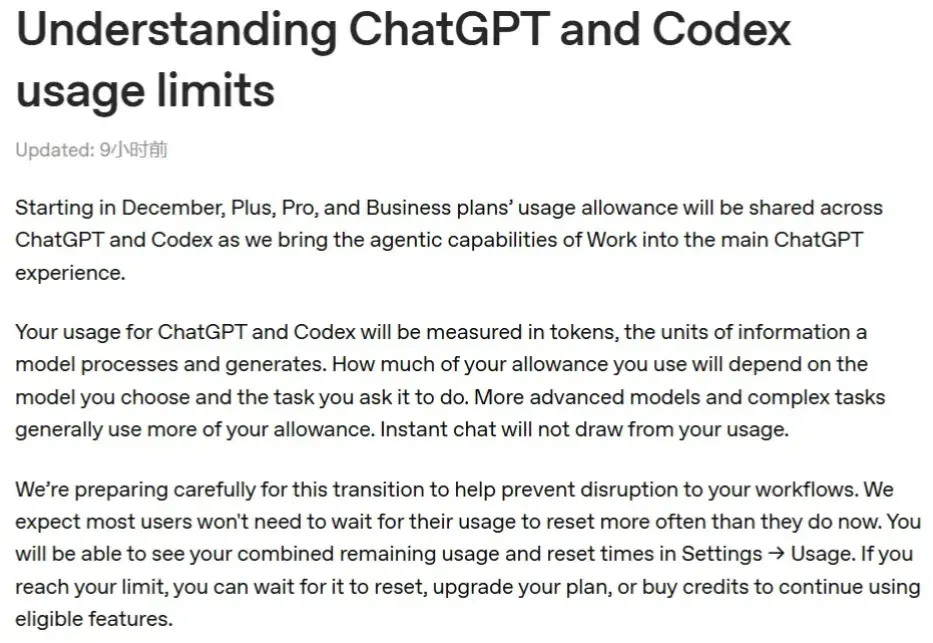
OpenAI 计划12月合并 ChatGPT 与 Codex 用量额度(在新窗口打开)
OpenAI 公布12月起在 ChatGPT 与 Codex 间共享套餐用量的安排,Instant 聊天不扣减这份额度。近期 Pro 增额也有区别:Pro 100、500 的 Work/Codex 额度翻倍,Pro 200 仅原本较低的额度翻倍;以 token 衡量用量不等于按 API 价格逐次收费。
共 619 篇
OpenAI 公布12月起在 ChatGPT 与 Codex 间共享套餐用量的安排,Instant 聊天不扣减这份额度。近期 Pro 增额也有区别:Pro 100、500 的 Work/Codex 额度翻倍,Pro 200 仅原本较低的额度翻倍;以 token 衡量用量不等于按 API 价格逐次收费。
百度智能云推出AI Infra与Agent Infra双层基础设施,通过百舸AI计算平台6.0提升资源与Token效率,支撑智能体长期稳定运行及产业场景落地。
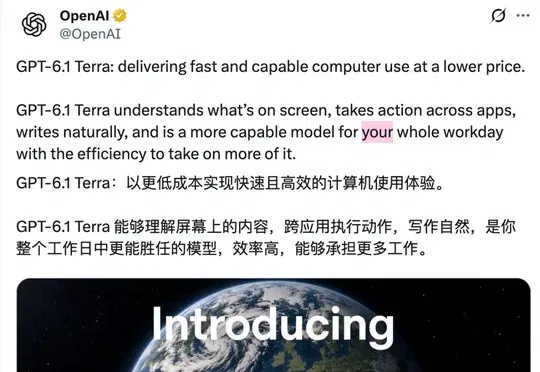
OpenAI发布GPT-6.1 Terra,每百万token输入1美元、输出5美元,较上代大幅降价,并强化视觉理解、写作和电脑操作;Agents’ Last Exam中追平GPT-6 Astra且速度快3倍以上,第三方评测幻觉率由88%降至38%,现已全面开放。
在能力、成本、稳定性之间寻找最优解。 智东西10月15日报道,今天,一款刚登上OpenRouter Token全球使用量周榜第二的大模型,开源了! 阶跃星辰正式开放Step 5 Preview的模型权重,BF16、FP8两个版本同步上线HuggingFace和ModelScope。 Hugging Face: https://huggingface.co/stepfun-ai/Step-5-Preview ModelScope: https://modelscope.cn/models/stepfun-ai/Step-5-Preview Step 5 Preview采用稀疏MoE架构,总参数量
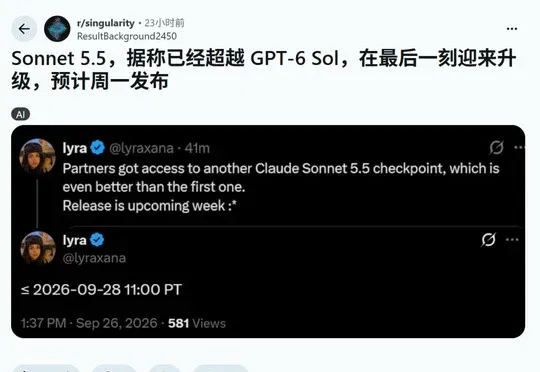
Claude Sonnet 5.5在Claude Code中被抓包偷跑并开启灰度测试,多位开发者实测显示其性能碾压GPT-6 Sol并在编码与Agent能力上直逼GPT-6 Astra,同时定价低至百万Token输入2美元,Anthropic意在OpenAI DevDay前截杀对手。
Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。

If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。
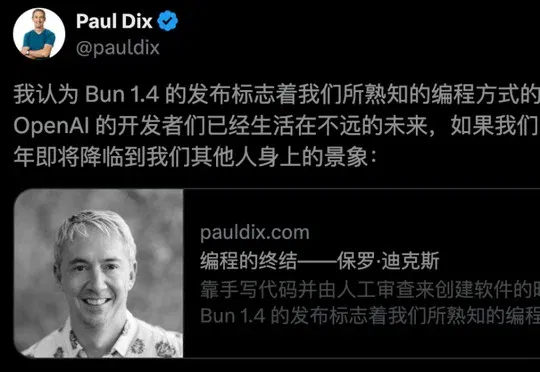
Bun 1.4正式发布,核心开发者Jarred Sumner利用AI Agent在11天内将底层代码从Zig重写为Rust,生成超100万行代码并烧掉约16.5万美元Token,InfluxDB创始人Paul Dix发文《The end of programming》指出传统编程方式正走向消亡。
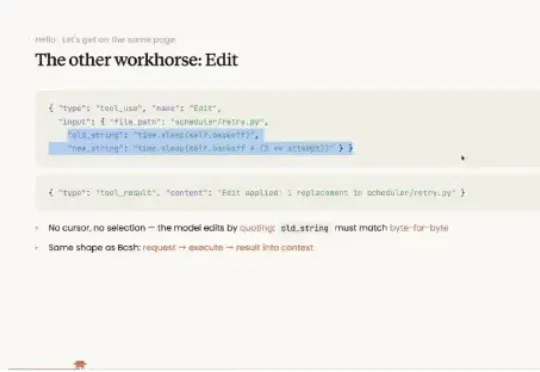
过去一年,编程 Agent 的能力大幅提升,软件工程师对它们的要求也比以往任何时候都高,但上下文窗口的大小却基本停滞不前——一年前,一百万个 token 大致就是最先进的水平,如今依然如此。随着我们逐渐进入 Agent 日常处理 Monorepo(单体仓库)级任务的世界,将越来越多的信息塞进模型那固定的上下文限制中,这种需求已经变成了一项实实在在的全职工程任务。
前段时间,米哈游的一个工程师,在测多Agent协作时忘了设熔断。几十个Agent进入循环调用。