医疗AI迎来大考!南洋理工发布首个LLM电子病历处理评测 | AAAI'26(在新窗口打开)
南洋理工大学研究人员构建了EHRStruct基准,用于评测LLM处理结构化电子病历的能力。该基准涵盖11项核心任务,包含2200个样本,按临床场景、认知层级和功能类别组织。研究发现通用大模型优于医学专用模型,数据驱动任务表现更强,输入格式和微调方式对性能有显著影响。
共 28 篇
南洋理工大学研究人员构建了EHRStruct基准,用于评测LLM处理结构化电子病历的能力。该基准涵盖11项核心任务,包含2200个样本,按临床场景、认知层级和功能类别组织。研究发现通用大模型优于医学专用模型,数据驱动任务表现更强,输入格式和微调方式对性能有显著影响。
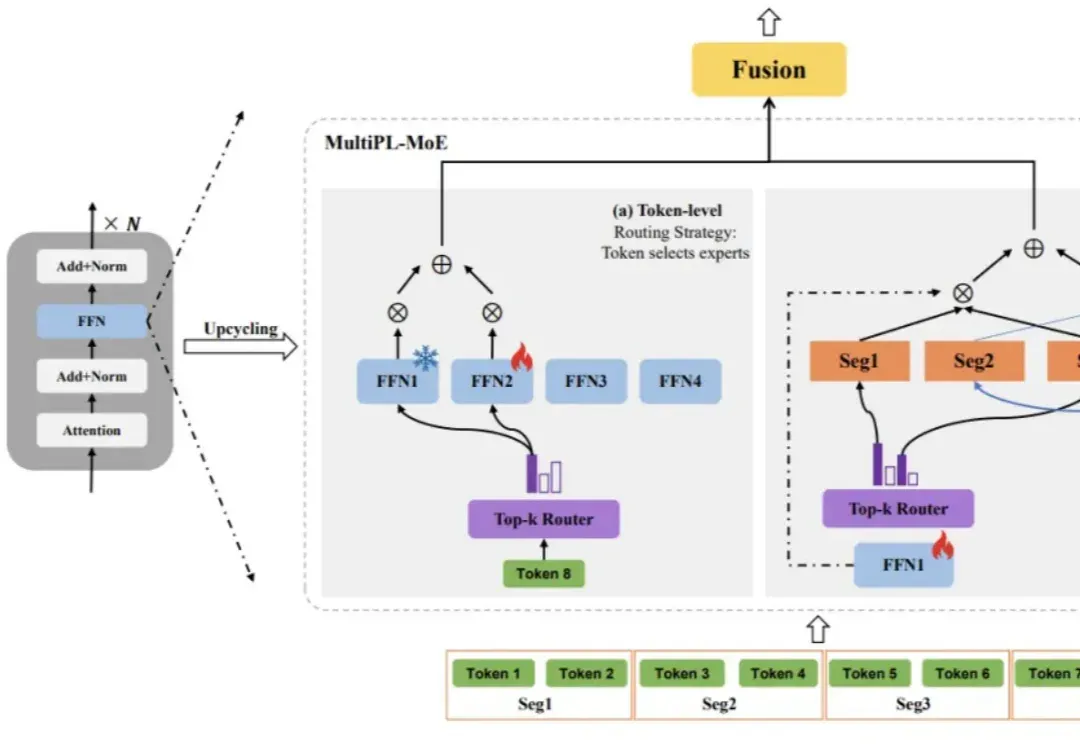
大语言模型(LLM)虽已展现出卓越的代码生成潜力,却依然面临着一道艰巨的挑战:如何在有限的计算资源约束下,同步提升对多种编程语言的理解与生成能力,同时不损害其在主流语言上的性能?
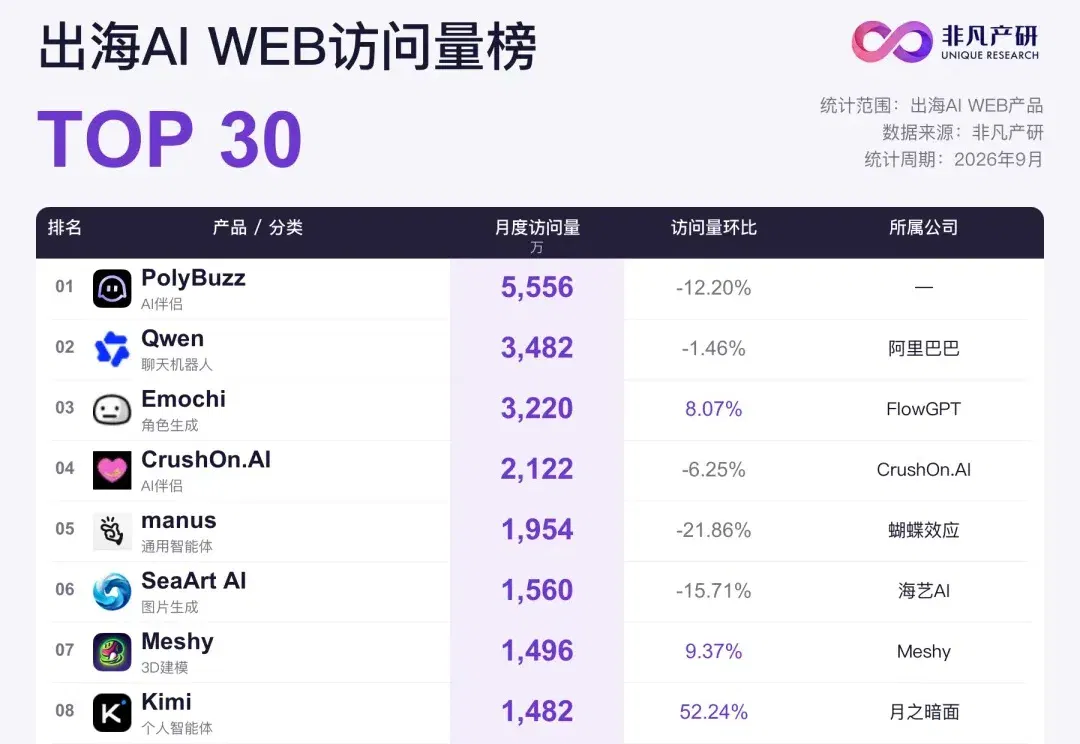
即便通用大模型的图像、视频能力越来越强,消费者依然持续为垂直创意工具付费
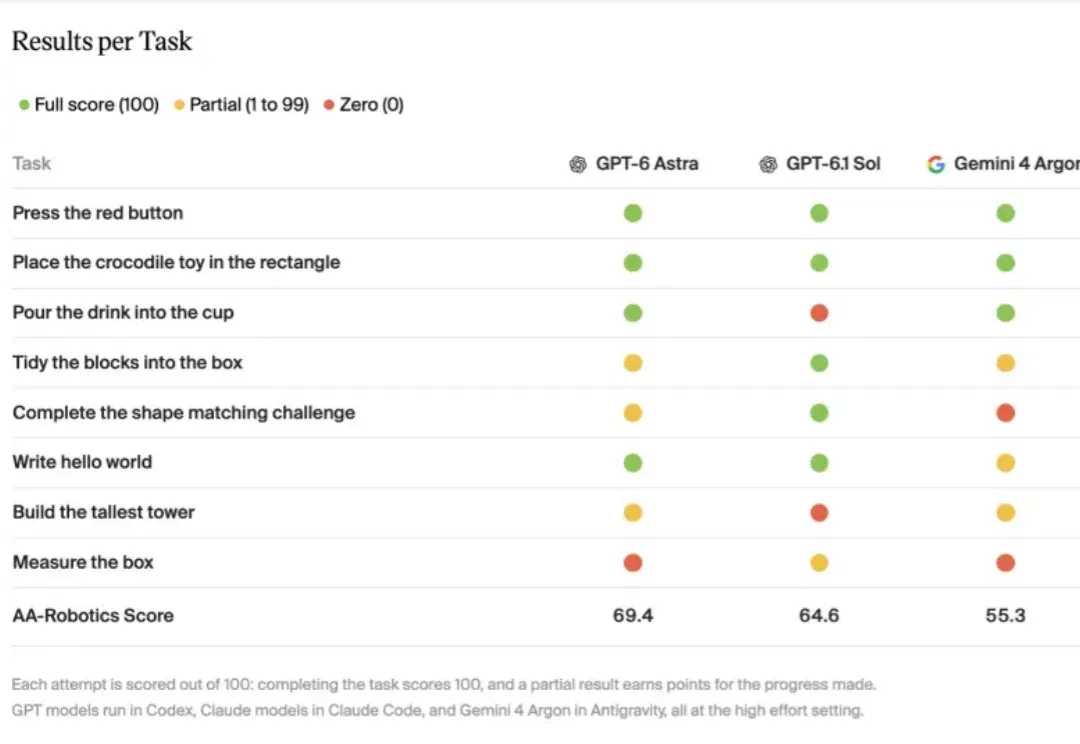
具身智能公司辛苦训练的「机器人大脑」,要被 GPT、Claude、Gemini 抢饭碗了?
找准PMF,比创意更重要 欧洲今年AI赛道最大的融资出现了。 近日,伦敦人工智能公司Synthesia宣布完成2亿美元E轮融资,估值达40亿美元。 与多数追逐通用大模型的初创公司不同,Synthesia专注企业级AI视频生成,帮助全球组织将文本知识高效转化为多语言培训与沟通视频。 从早期被近百家风投拒绝,到如今成为欧洲AI应用层的标杆,Synthesia的路径印证了一个趋势:在AI狂热中,真正赢得市场的,不是最炫的技术,而是最深的场景扎根。 完美PMF跑出的独角兽 2026年初,欧洲AI赛道迎来一个标志性时刻:总部位于伦敦的AI视频公司Synthesia宣布完成2亿美元融资,投后估值高达40亿
岁末年初,全球AI竞争聚焦到了最新趋势—— 太空算力。
1月10日,很久没有公开露面的月之暗面创始人杨植麟,在一场定向邀请的行业论坛中,详细地分享了2025年Kimi的技术路线重点,以及对未来的思考。这次分享,有一个核心关键词,Agentic智能时代。这是通用大模型竞争的一个未来高地
正所谓“得数据者得天下”,这家央企算是把高质量数据集给玩明白了——超过10万亿tokens的通用大模型语料数据,以及覆盖14个关键行业的专业数据集,总存储量高达350TB!