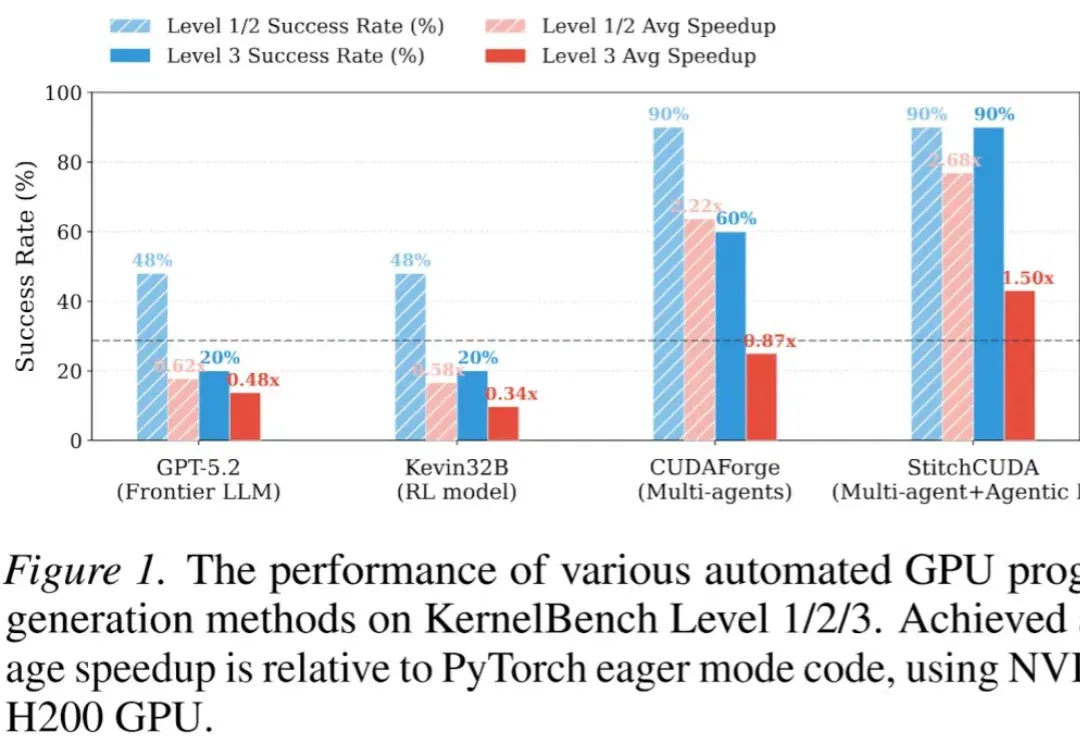
32B逆袭GPT-5.2:首个端到端GPU编程智能体框架StitchCUDA问世(在新窗口打开)
现有的 LLM 自动化 CUDA 方法大多只能优化单个 Kernel,面对完整的端到端 GPU 程序(如整个 VisionTransformer 推理)往往束手无策。
共 38 篇
现有的 LLM 自动化 CUDA 方法大多只能优化单个 Kernel,面对完整的端到端 GPU 程序(如整个 VisionTransformer 推理)往往束手无策。
Meta腾出CoWoS排产「让路」,加上台积电的积极扩产,2026年谷歌把TPU的「算力水龙头」拧到最大,预期产能飙升至430万颗,猛攻英伟达CUDA护城河。
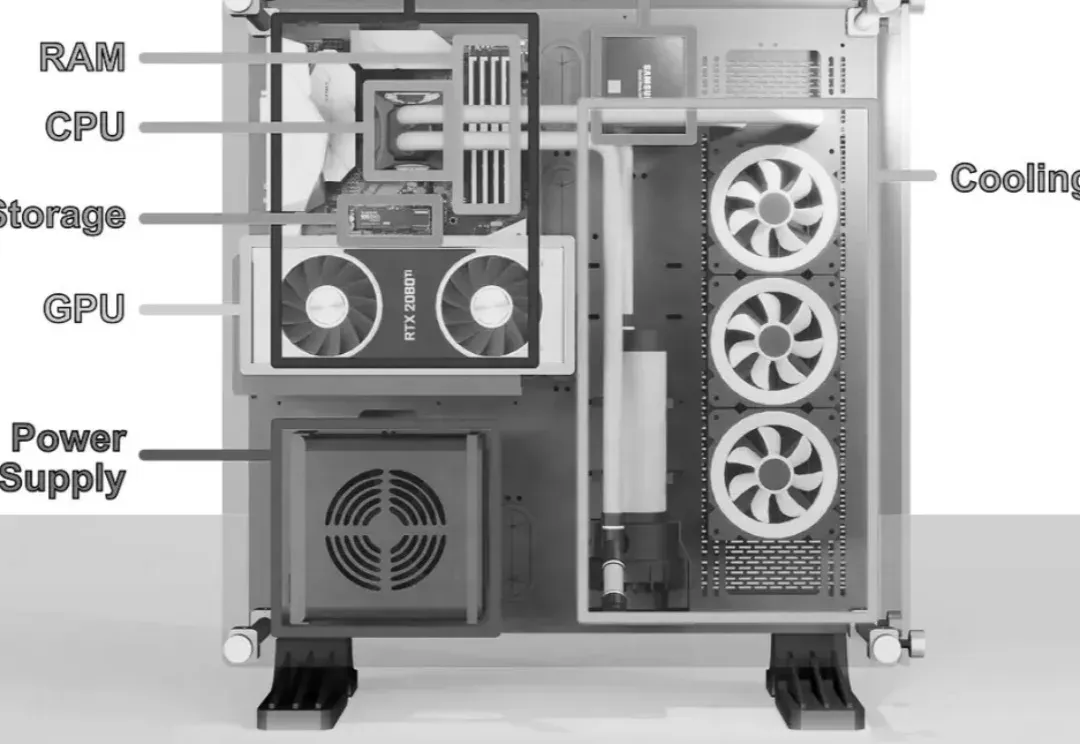
“既然我可以直接使用 PyTorch,为什么还要费心使用 CUDA 呢?”
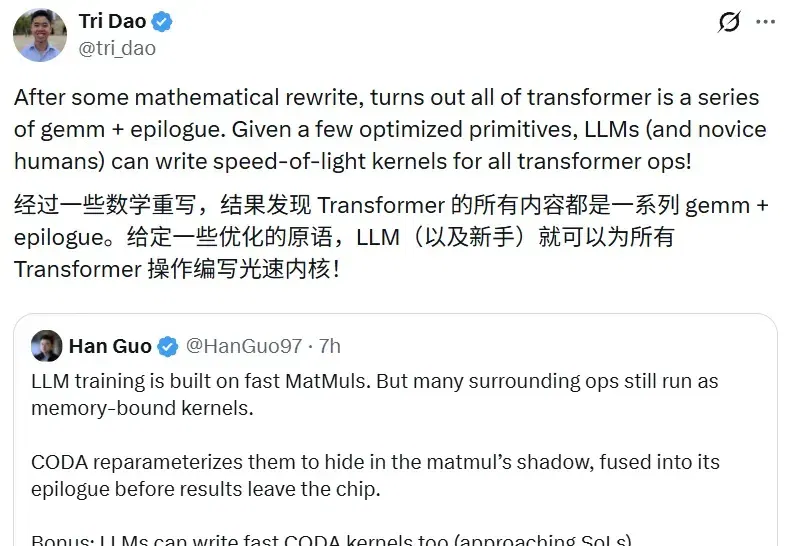
5 月 22 日,Tri Dao 在社交媒体上转发了 Han Guo 的一条推文。他还写道:「经过一些数学重写,结果发现 Transformer 的所有内容都是一系列 GEMM + epilogue(矩阵乘法加尾声)。给定一些优化的原语,LLM(以及新手)就可以为所有 Transformer 操作编写光速内核!」
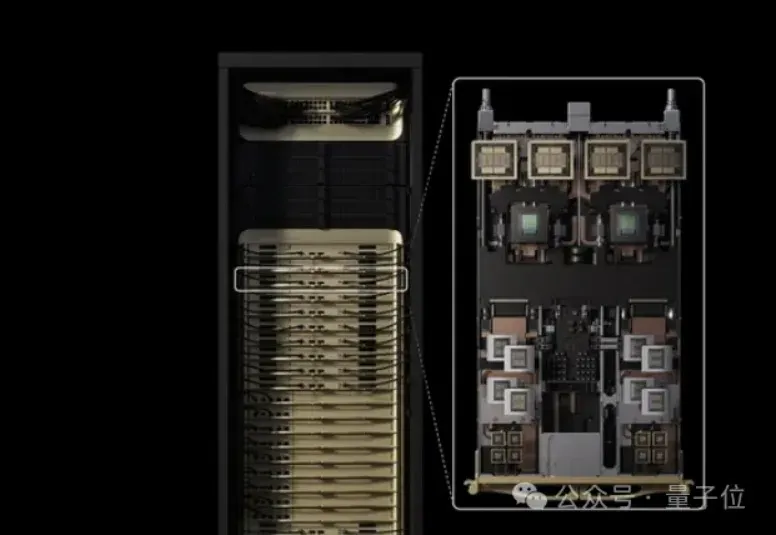
老黄对token密集型任务下手了。 刚刚,在AI Infra Summit上,英伟达宣布推出专为处理百万token级别的代码生成和生成式视频应用的全新GPU—— NVIDIA Rubin CPX GPU。 老黄表示:Rubin CPX是首款为超大上下文AI量身定制的CUDA GPU,可以让模型“一口气”推理数百万token。 而且,RubinCPX还能让你越用越省钱:每投资1亿美元,就能获得50亿美元的token收益。(50倍,你就赚吧,老黄说的) 对于“老黄画的饼”,Cursor、Runway、Magic等行业大佬也表示RubinCPX将分别在代码生产力、生成式影像创作、以及大模型自主代理上
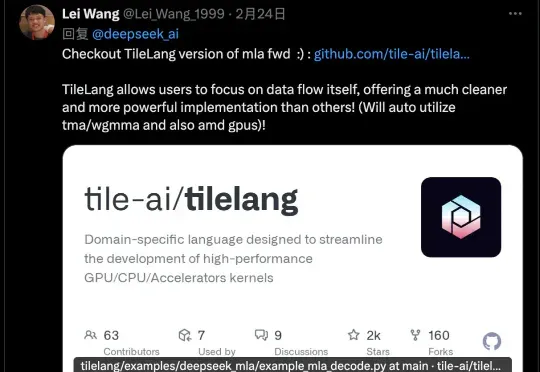
DeepSeek v3.2有一个新改动,在论文里完全没提,只在官方公告中出现一次,却引起墙裂关注。开源TileLang版本算子,其受关注程度甚至超过新稀疏注意力机制DSA,从画线转发的数量就可以看出来。
一句话,一个周末,Claude直接把自家最前沿的模型跑在了一台全新的AMD MI355X机架上!
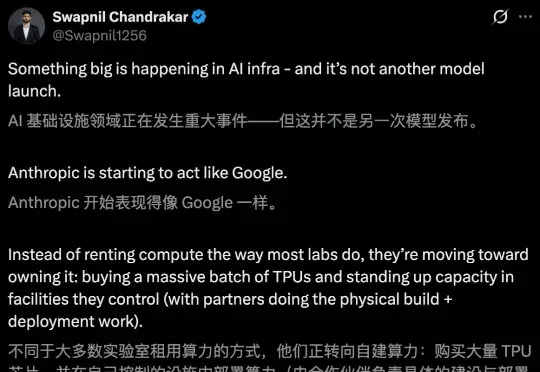
2026年开局,Anthropic未发一弹已占先机!谷歌首席工程师Jaana Dogan连发多帖,高度赞扬Claude Opus 4.5——没有图像/音频模型、巨大的上下文,仅有一款专注编码的Claude,Anthropic依旧是OpenAI谷歌最有力竞争者。

硅谷101采访半导体、科技与投资人士,讨论黄仁勋离任后CUDA生态、系统整合、供应链、开源投入和组织传承的潜在变化。产业放缓、估值折扣及人才流失判断属于受访者观点。
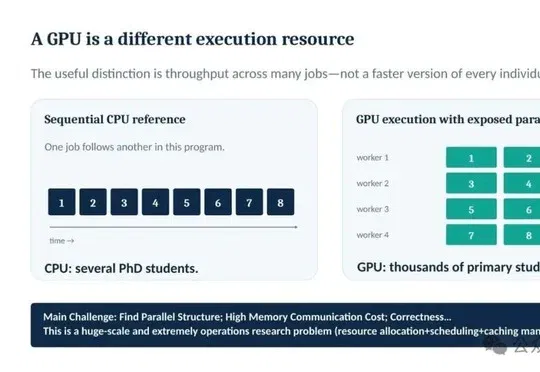
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。