Anthropic 开源 FlashProve,在实验中用 CPU 验证模型输出证明(在新窗口打开)
FlashProve 通过权重承诺和零知识证明验证受支持的推理结果。在 Llama 4 Maverick 实验中,每份证明检查一个 Token,CPU 多线程验算约 17 秒,服务方需要参与生成证明。
共 50 篇
FlashProve 通过权重承诺和零知识证明验证受支持的推理结果。在 Llama 4 Maverick 实验中,每份证明检查一个 Token,CPU 多线程验算约 17 秒,服务方需要参与生成证明。
OpenAI披露其前沿模型在“假互联网”离线环境中训练,内部模型曾借DNS访问外部聊天机器人,两个隔离AI还利用同一实体机器的CPU缓存互通,OpenAI称已修补问题并加强监控。
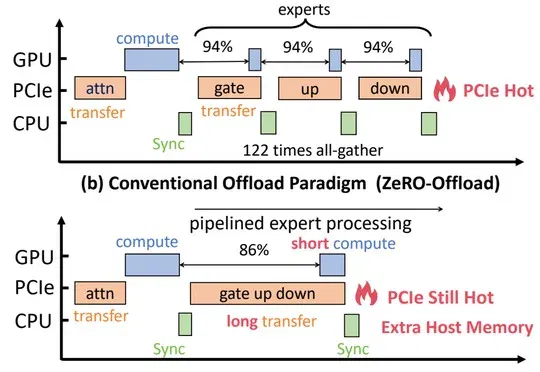
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
CPU的价值,在Agent时代,真的需要被重估了。
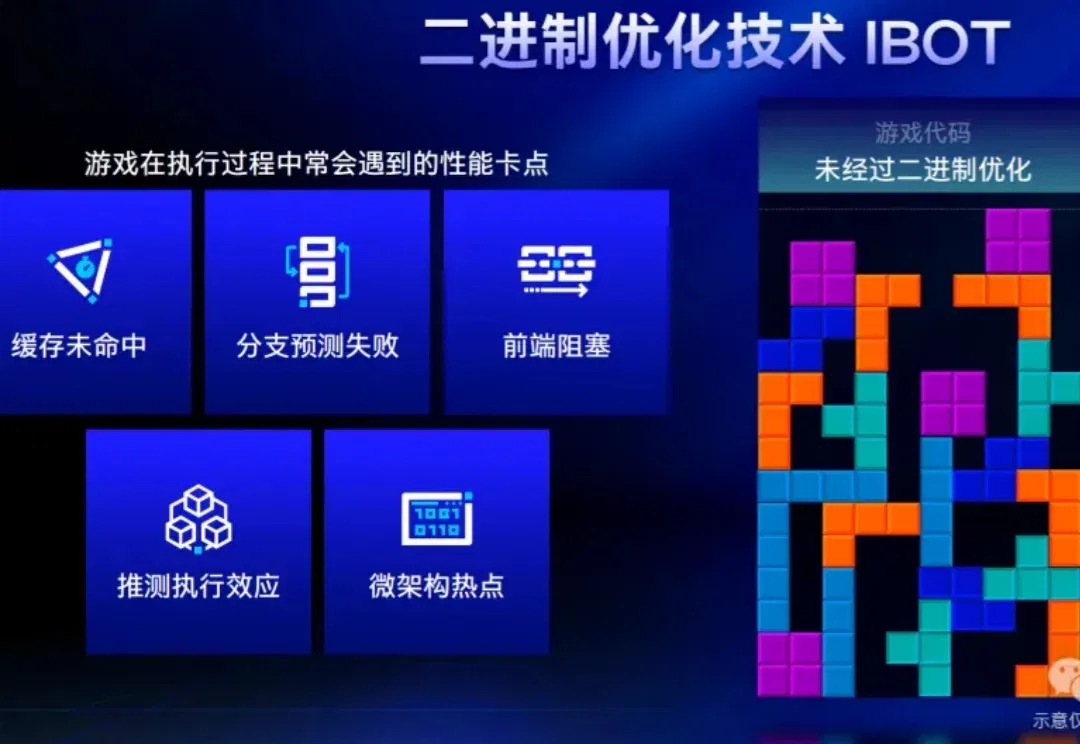
英特尔,真是越来越会玩了—— 因为它把优化CPU这件事的痛点,直接搞得像送外卖似的:
近日,基于RISC-V架构研发和销售下一代AI CPU芯片的企业「进迭时空」完成数亿元B轮融资,我们总结了本轮融资信息和该公司几大亮点:
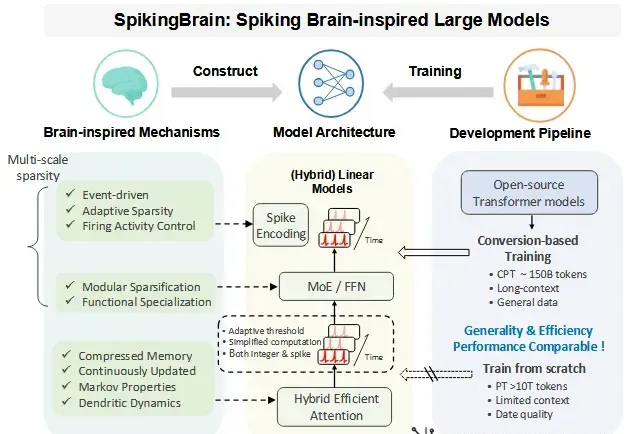
超长序列推理时的巨大开销如何降低? 中国科学院自动化所李国齐、徐波团队发布的类脑脉冲大模型SpikingBrain (瞬悉)-1.0提出了新思路。 SpikingBrain借鉴大脑信息处理机制,具有线性/近线性复杂度,在超长序列上具有显著速度优势。 在GPU上1M长度下TTFT 速度相比主流大模型提升26.5x,4M长度下保守估计速度提升超过100x;在手机CPU端64k-128k-256k长度下较Llama3.2的同规模模型Decoding速度提升4.04x-7.52x-15.39x。 SpikingBrain适配了面向沐曦MetaX国产GPU集群的高效训练和推理框架、Triton算子库、模
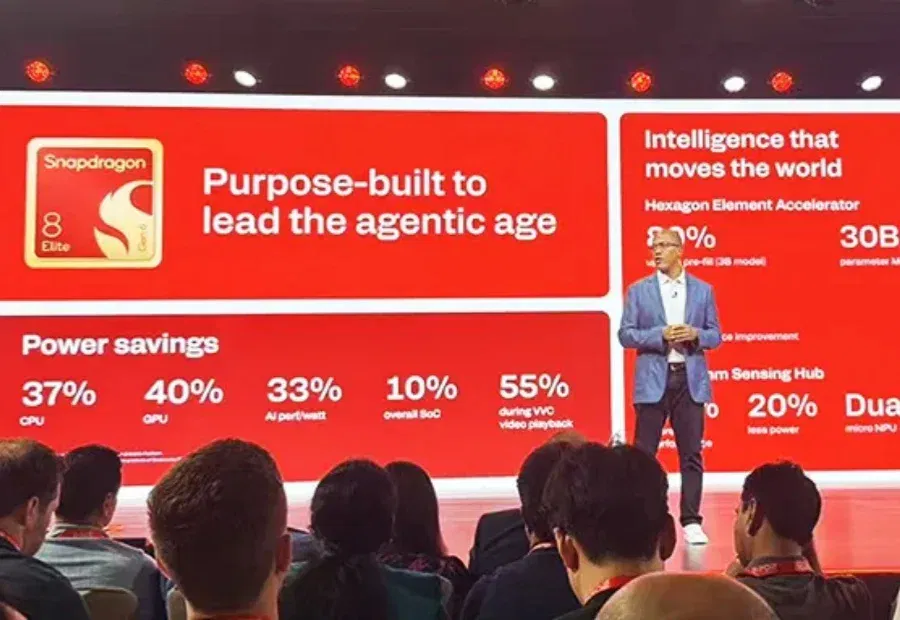
骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。
在“灵晟”国产超算登顶最新一期全球超级计算机TOP500榜单后,清程极智与“灵晟”联合完成纯CPU MoE模型分布式推理方案:16节点即可流畅运行DeepSeek-V3/R1-671B模型,在batch_size=2048时,输出吞吐量与80张主流GPU集群相当。
在AI狂飙的这些年里,行业几乎被一条逻辑主导:算力决定上限,而GPU就是算力的核心。