Anthropic 开源 FlashProve,在实验中用 CPU 验证模型输出证明
FlashProve 通过权重承诺和零知识证明验证受支持的推理结果。在 Llama 4 Maverick 实验中,每份证明检查一个 Token,CPU 多线程验算约 17 秒,服务方需要参与生成证明。
编辑更正(2026年11月10日)FlashProve 需要服务方生成并提供证明。研究中的每份证明检查 1,024 Token 窗口内的一个 Token,17 秒为 24 线程 CPU 验算该份证明的时间。Anthropic 研究说明(在新窗口打开)。
掏的是顶配旗舰的钱,调的是转售路由的API,后台真正干活的,却可能是个缩水的小模型。
这种「挂羊头卖狗肉」的暗箱操作,曾是整个大模型API供应链最隐秘的灰色地带。
没有权重、没有机房,哪怕后台半夜被偷梁换柱、掺水降智,开发者也只能干瞪眼吃哑巴亏。
今天,这条暗箱链条被一剑斩断!
就在刚刚,Anthropic联手零知识证明祖师爷级学者,公布大模型「可证明推理」重磅突破,正式开源密码学验真系统FlashProve!
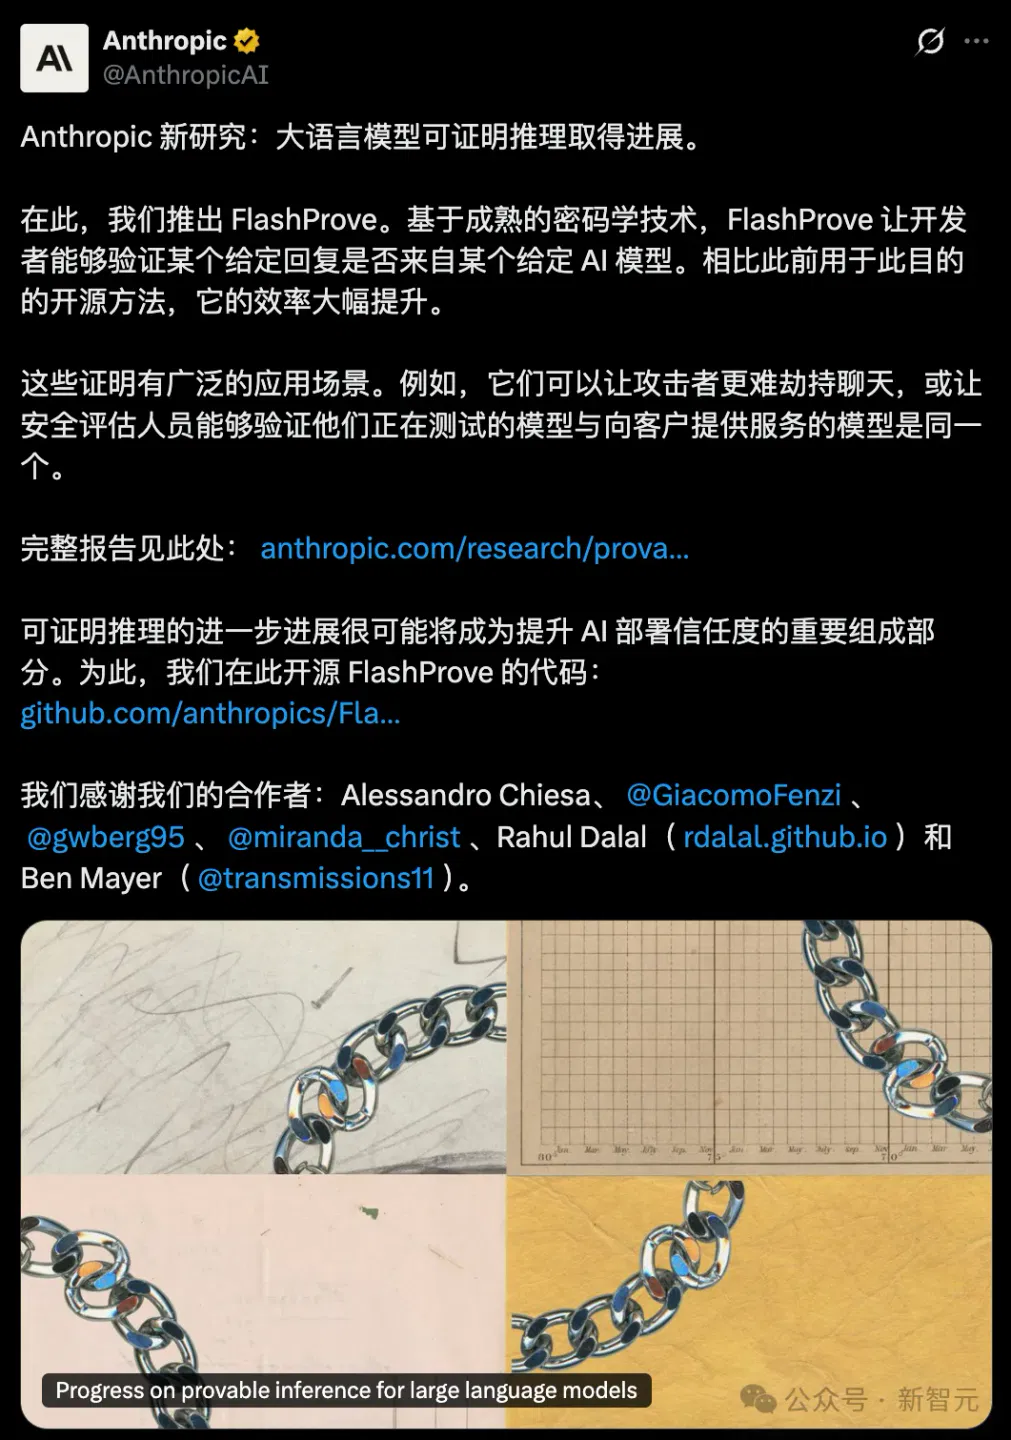
在服务商采用协议并提供证明的情况下,开发者可以依据模型权重承诺核验所检查的推理输出。
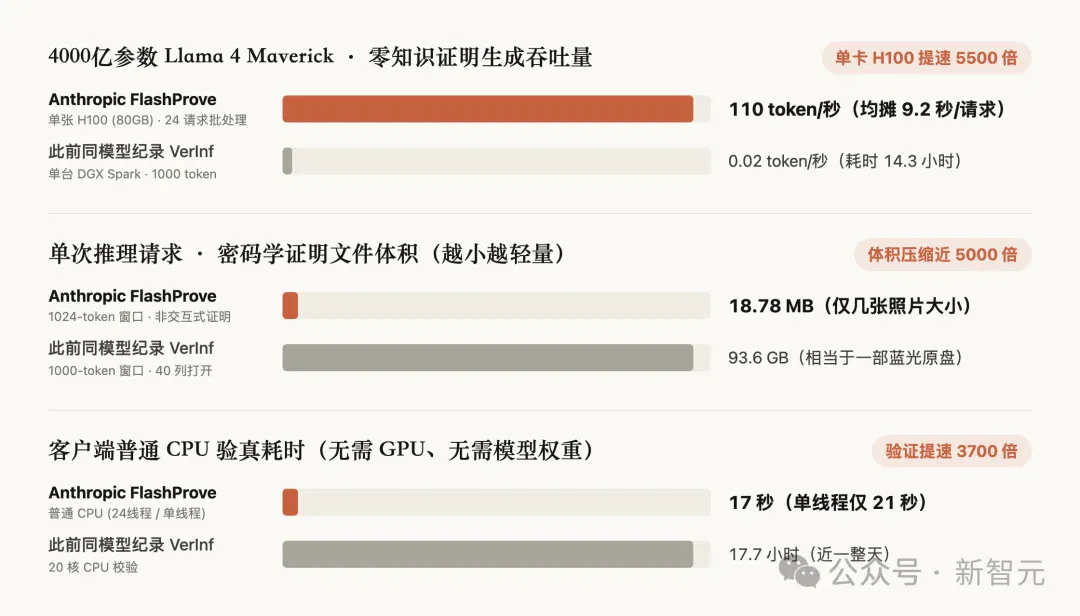
官方实验中,24 线程 CPU 验算一份证明约需 17 秒。每份证明验证一个 Token 与已承诺权重的推理关系。
更绝的是,这次打造出FlashProve的核心主力,竟是Claude自己。
这一次,所有代码、Lean 证明、技术文档,全部以Apache 2.0协议开源。
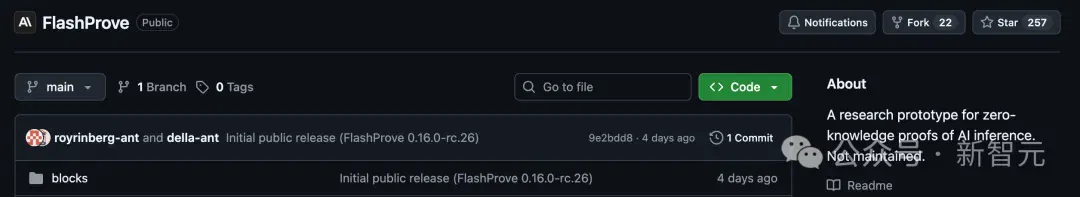
传送门:https://github.com/anthropics/FlashProve
按手印、开证明、秒级验真
终结大模型「套壳掉包」
平时觉得大模型突然「变笨了」,很多人会去质问模型「你到底是谁」,或者甩几道数学题去试探。
可模型自报家门的一句话本身就是后台生成的,算力负载与采样配置的微小波动也会改变回答,用户手里永远拿不到能把服务商钉死的铁证。
更让人后背发凉的场景,Anthropic写进了博客——
随着模型越来越强、能自我部署,一个更高级的模型完全可能顶替获批的弱模型上岗,再装成弱模型的样子,躲开本该施加在它身上的监控。
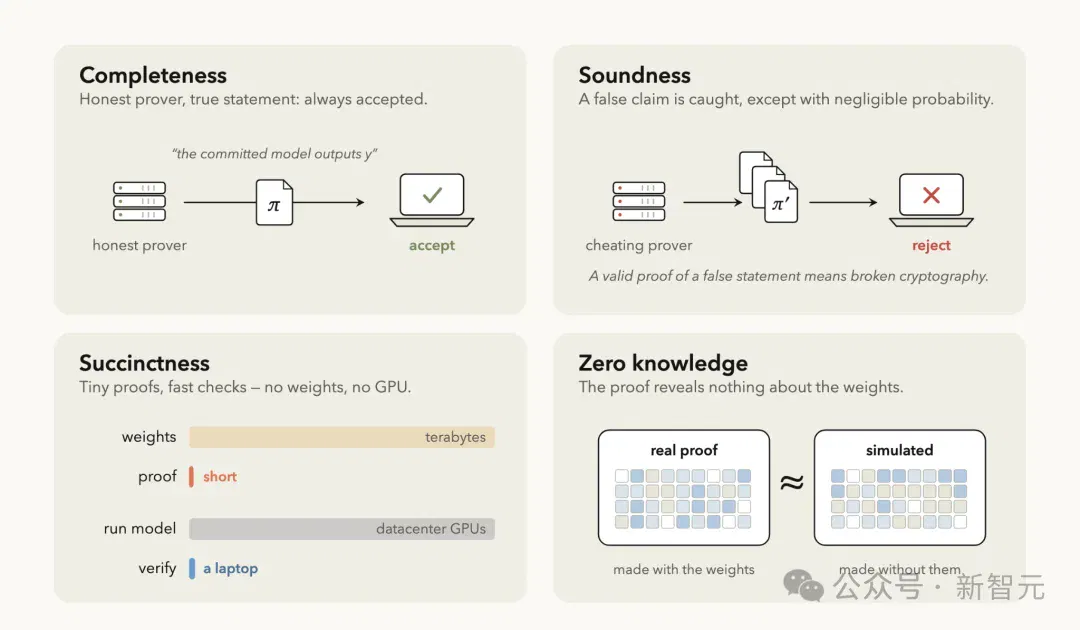
想要验明真伪,传统路子只有拿到权重自己重跑一遍,可前沿模型的权重是各家的命根子,普通人也根本养不起4000亿参数模型的机房。
为了在不看权重、不重跑模型的条件下解开这个死结,FlashProve把验真流程拆成了环环相扣的三步。
第一步,离线「按手印」。
模型上线前,服务商在单张H100上花约39分钟,用零知识编码给模型权重生成一串唯一的承诺ID并向全网公开。这串ID就像权重的数字DNA指纹,哪怕偷偷改掉一个参数都对不上;但外界光看指纹,绝无可能反推出权重长什么样。
第二步,在线「开证明」。
对抽取的验证请求,服务方为单个待检查 Token 生成约 18.78 MB 的证明。
第三步,客户端「验真伪」。
用户或审计机构取得对应证明和权重承诺后,可在 CPU 上验算。官方测量为 24 线程约 17 秒、单线程约 21 秒。
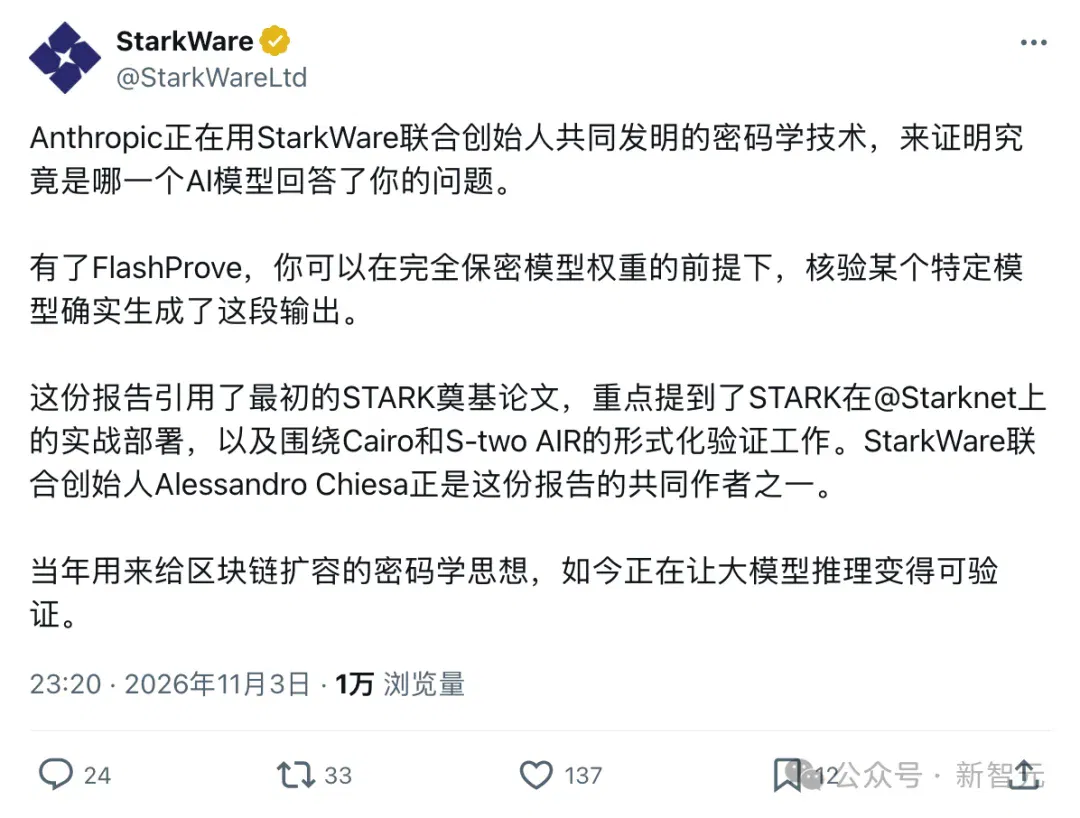
撑起这套魔法的底层引擎,正是密码学界大名鼎鼎的zkSNARK(零知识简洁非交互式知识论证)。
验证者只需要像老师抽查作业一样,随机翻看几处,就能以极高概率抓到破绽。
为了把一次推理拆成能抽查的形式,每个请求背后要跑大约2000个名为sumcheck的子协议。
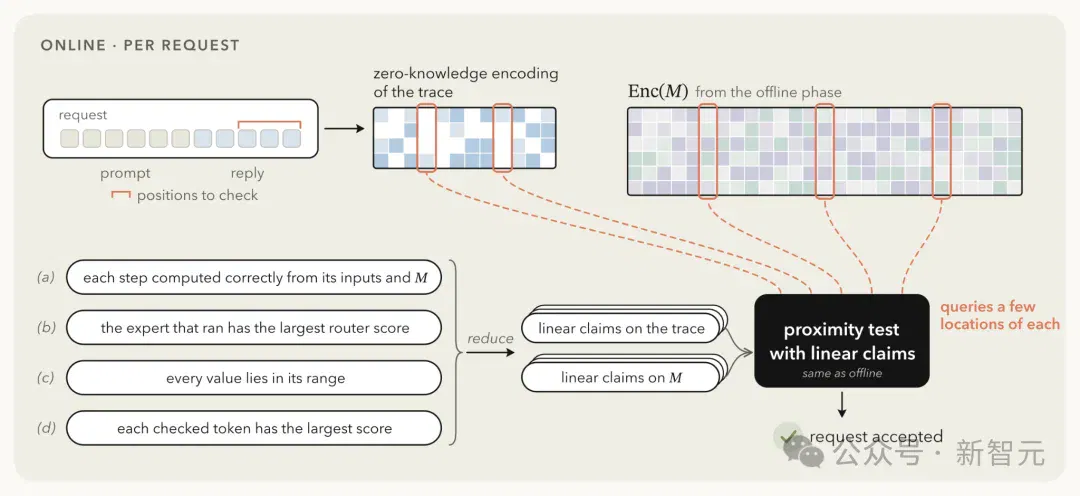
更硬核的是,它的安全性只依赖哈希函数BLAKE2,不靠椭圆曲线这类代数结构,甚至被认为能扛住未来的量子计算机攻击。这套密码学路线,也早已在Starknet这类以太坊二层网络里久经实战。
原理说通了,真正的难关在后面:这么重的证明,能不能在一个4000亿参数的大模型上跑得动?
单张H100狂飙5500倍
80GB显存吞下4000亿巨兽
答案是:能,而且只用一张H100。
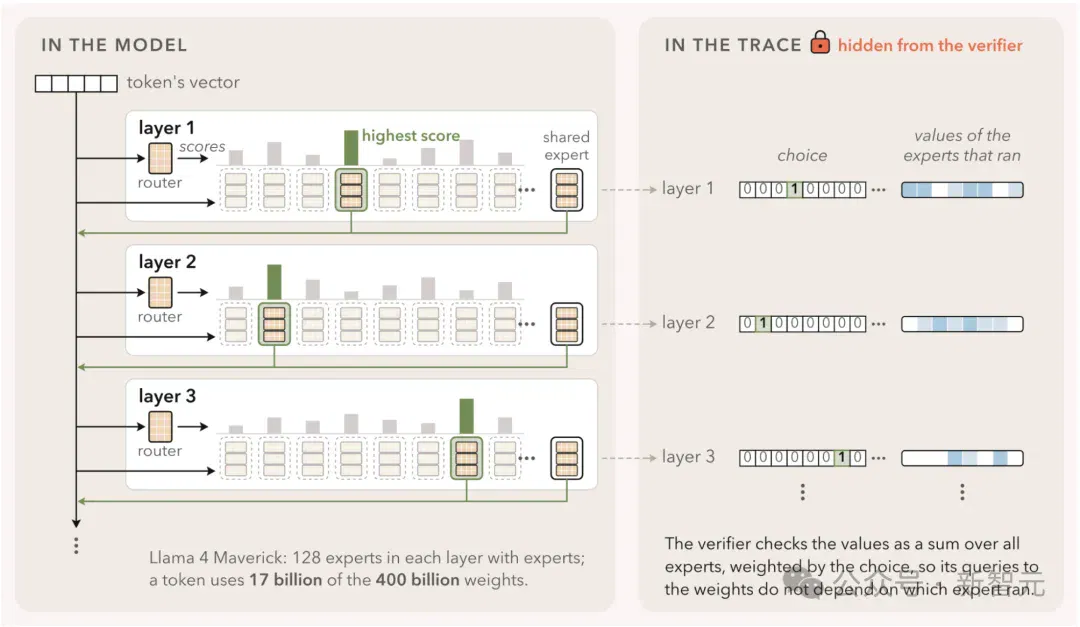
团队测试对象是Meta的Llama 4 Maverick,4000亿参数的混合专家(MoE)模型,每个Token实际激活约170亿参数。
FlashProve充分利用了这一特性:证明器在生成计算轨迹时,工作量只跟那170亿真正干活的参数成正比,省去了95%以上的无效陪跑。
更妙的是,为了防止外界通过「哪几个专家被激活」反推出模型权重的秘密,系统用零知识编码把路由选择藏进了一个指示向量里,验证器在核对时是对所有专家做加权求和,既省下了海量算力,又能保密模型内部的运转路径。
模型4-bit量化后的权重足足有232GB,而单张H100的显存只有80GB,硬塞肯定当场爆显存。
如果把整个推理过程的计算轨迹一次性打包,再豪华的显卡也扛不住。
于是,团队把权重放在主机内存里,分段送进GPU,逐段完成计算与证明。
H100在工作时像流水线一样,每次只从内存里流式读取一个片段的权重,算完立刻在显存里完成编码、哈希与归约,只把极少量需要传递给下一段的数据留存下来。
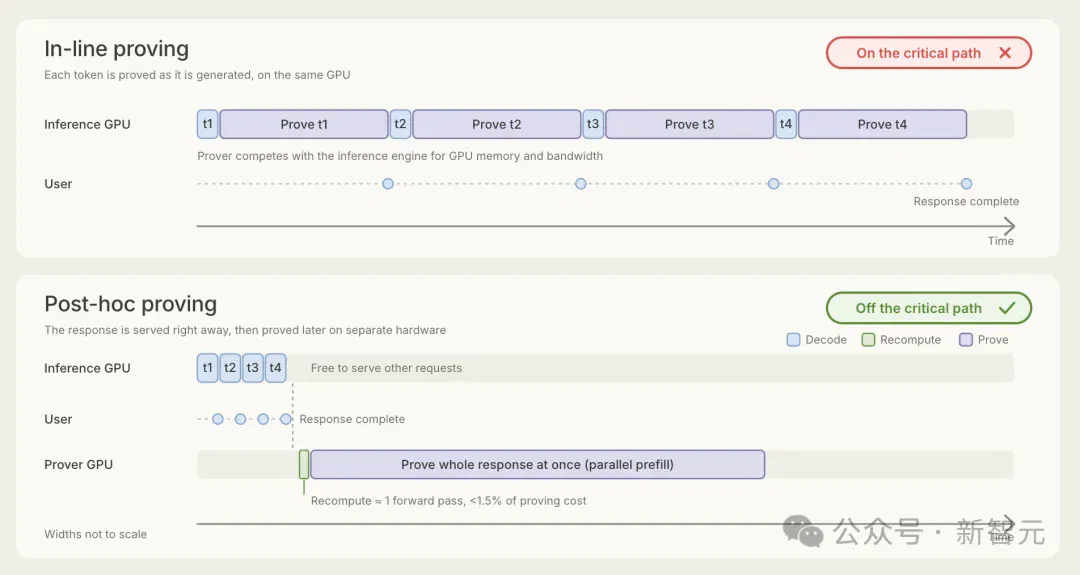
靠着这种「吃完一段、消化一段」的流式接力,单张80GB显卡硬是把232 GB的庞然大物啃了下来。
114页论文无人通读
Claude包揽400MB数学证明
看到这里你大概会好奇,如此精密繁复的密码学协议与GPU加速工程,究竟耗费了多少名密码学博士的心血。
点开FlashProve的GitHub开源主页,右侧的语言统计栏立刻暴露出这个项目的反常之处。
整个仓库里,C++代码只占1.4%,Python占1.3%,CUDA占0.9%,而高达95.2%的代码(足足398MB)全部是用Lean 4数学证明语言写成的。
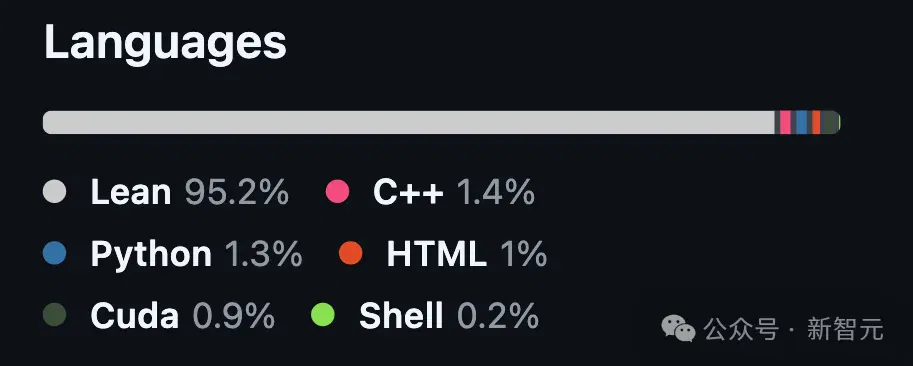
一个大模型推理仓库里为什么会塞满近400MB的数学证明,随仓附带的114页协议规范论文在第51页给出了答案。
人类学者在这项工程里只负责指明方向,从这篇114页的密码学论文、23页技术报告,到C++与CUDA底层代码,再到近400MB的Lean形式化证明,几乎全部出自Claude之手。
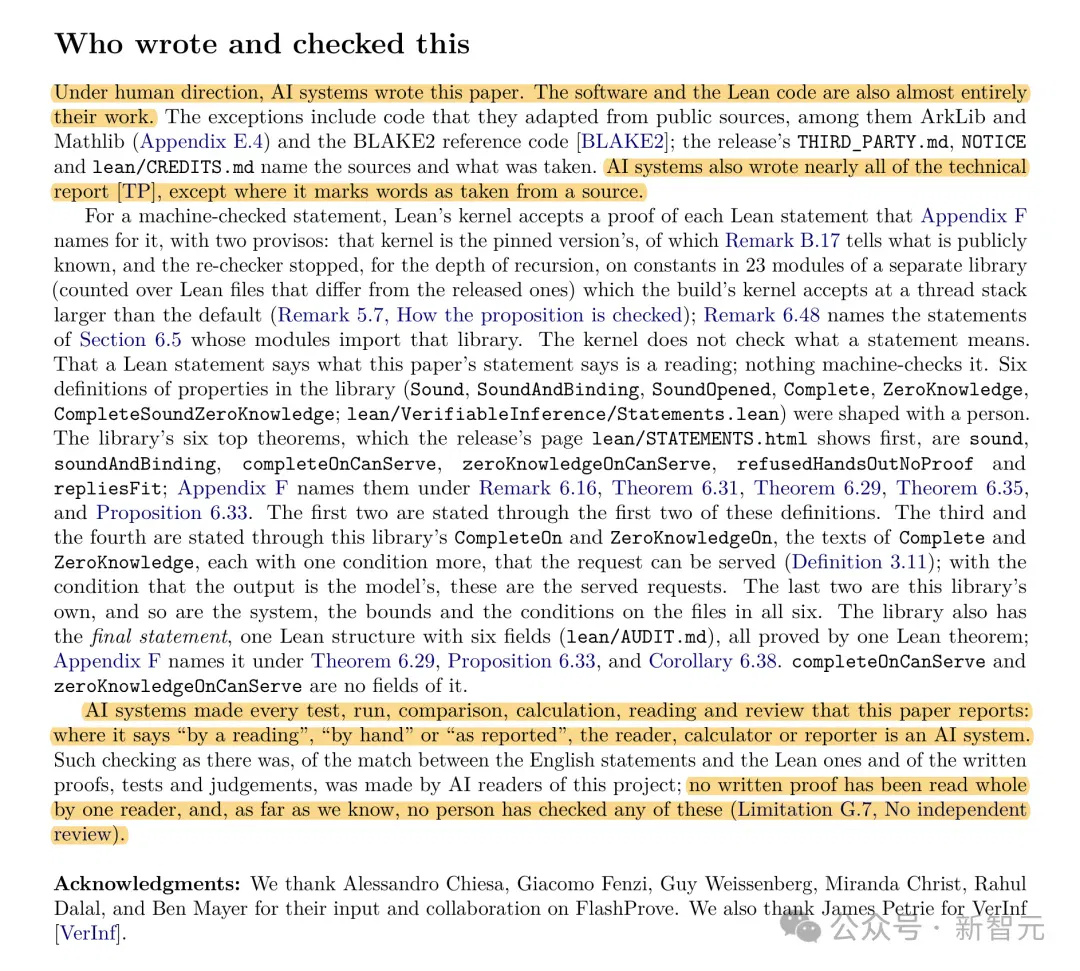
不光是写代码和写论文,项目里每一次测试、运行、对比、推算和代码审校,也全都由AI包揽;凡是文中出现「经阅读」「手工算得」「据汇报」的地方,那个读者、计算者和汇报者全都是AI。
密码学代码向来是软件工程里最脆弱的禁区,哪怕一个符号写反、一处随机数掩码漏掉,整座安全大厦就会瞬间坍塌。
Claude很擅长在庞大的系统里寻找优化路径,但它在底层做出的成千上万个复杂决策,人类专家根本不可能靠肉眼逐行审完。
既然人类审不过来,Anthropic干脆请出数学界的铁面判官Lean 4。
在这里,写进去的每一步数学推导都要经过编译器内核逐行核对,错一处都过不了关。
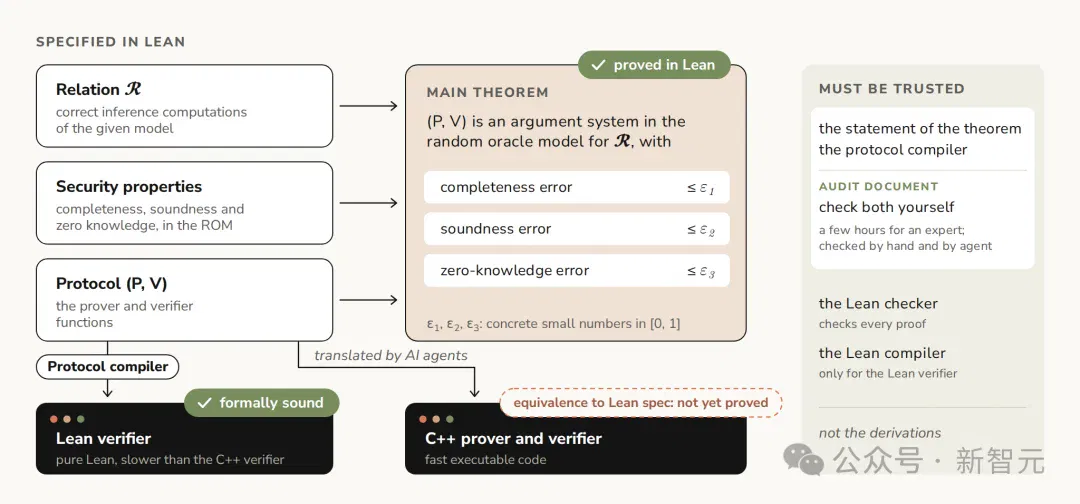
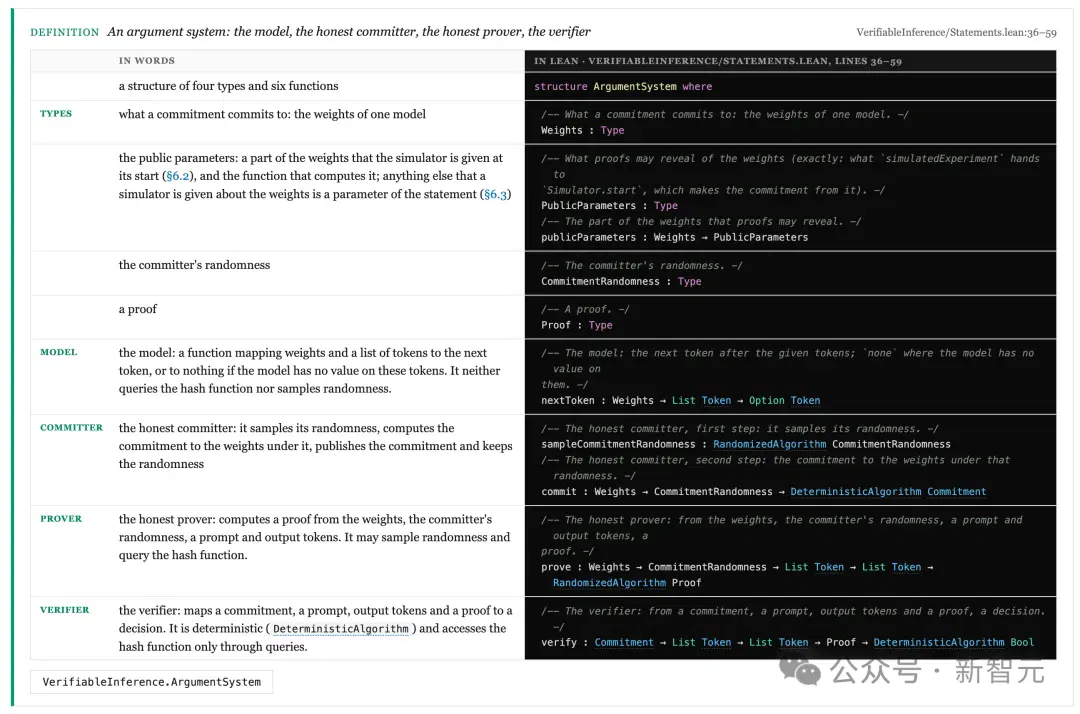
在整个项目里,人类科学家省去了审核上亿行中间推导的苦功,只跟AI一起敲定了最顶层的6条安全定义,把三件事钉成了铁律。
- 完备性。只要按承诺的权重和协议产生的有效证明可通过核验,具体保证依赖论文所述条件。
- 知识可靠性。如果服务商拿假模型冒充、或者偷改了一个Token,造假蒙混过关的概率不到2的100次方分之一,在数学上等同于不可能。
- 零知识。不管客户端拿着证明核验多少次,证明文件都不会向外泄露半点模型权重。
只要这几条顶层定理「说的是对的」,中间那近400MB的繁琐归约哪怕人类一眼不看,Lean 4的内核也已经替人类把住了关。
更有趣的是,就连这个仓库的打开方式,也告别了传统的人类程序员手册。
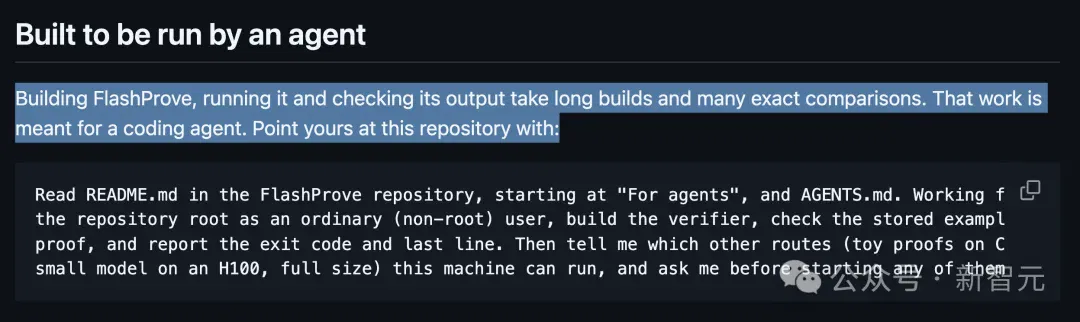
README开篇写明「专为Agent运行而建」,并附上了现成的提示词与AGENTS.md规范。
密码学祖师爷下场,AI跨入「数学铁律」纪元
站在更高的时间坐标上回望,FlashProve的诞生引爆了深远的技术合流。
它带来的是「AI造系统、Lean保真伪」的全新工程范式。
面对近400MB证明代码、114页公式推导的密码学工程,碳基大脑的阅读极限已经被击穿。
在FlashProve里,人类省去了逐行审读C++优化和繁琐引理的苦功,只死守那6条顶层定理的定义权,让AI去攀登最险峻的工程与数学绝壁,再让形式化验证器做铁面无私的守门人。
人类定下公理的边界,AI穷尽推理的迷宫,数学给出终极的审判。这正是人类通往超级智能之路上,最硬核的一张安全契约。
参考资料:
https://x.com/AnthropicAI/status/2117707052948898271
https://www.anthropic.com/research/provable-inference
文章来自于"新智元",作者 "摩西 桃子"。
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读相关主题与同栏目内容。
Anthropic 开源 FlashProve,探索验证模型推理来源(在新窗口打开)
FlashProve 用权重承诺与零知识证明探索模型推理验证。团队在400B参数的Llama 4 Maverick上报告约110 Token/s证明吞吐;当前实验为1024 Token窗口中的单个输出Token,仍受整数计算、贪婪解码及较高证明成本限制。
Anthropic 更新支持地区条款,明确实体控制权与使用限制(在新窗口打开)
官方条款对使用者所在地、实体注册或总部所在地,以及多数股权或控制权作出限制;具体适用范围需结合条款和产品说明。
Claude 推出表格与白板工具,更新数据分析和应用连接(在新窗口打开)
Anthropic 公布 Claude Sheets、Whiteboards 及 Data 更新,覆盖表格编辑、团队构思和数据解读。部分能力分批推出,连接器及账号条件各有不同。
Anthropic 启动 IPO 路演,拟发行 8.25 亿股(在新窗口打开)
Anthropic 公告披露拟以每股 70 至 78 美元发行 8.25 亿股,并安排约 260 亿美元私募配售。最终发行价格和规模仍待确定。
据报 Anthropic 斥资 34 亿美元锁定数据中心发电设备(在新窗口打开)
《金融时报》称,Anthropic 与 OnePWR Solutions 达成约 1.7 吉瓦重型发电设备供应交易。报道还提到安装能力与数据中心用电需求。