1位菲尔兹奖得主+12位博士,这些俄罗斯数学家训出了顶级AI(在新窗口打开)
俄罗斯AI初创公司Mostik由12位博士和1位菲尔兹奖得主组成,在Kaggle ARC-AGI-3竞赛中冲上榜首,并推出让大模型与小模型在数学空间直接传递隐藏状态的"桥梁"技术,使混合系统运行成本仅为完整大模型的二十分之一且小模型补上约50%的性能差距。
共 19 篇
俄罗斯AI初创公司Mostik由12位博士和1位菲尔兹奖得主组成,在Kaggle ARC-AGI-3竞赛中冲上榜首,并推出让大模型与小模型在数学空间直接传递隐藏状态的"桥梁"技术,使混合系统运行成本仅为完整大模型的二十分之一且小模型补上约50%的性能差距。
AWM 将交互环境中的观察写成可执行假设,再通过实验修订与 Lean 4 形式化,尝试在游戏中解释可行路径和无解条件。团队报告了 ARC-AGI-3 任务结果,同时指出证明依赖于已建模的规则,遗漏环境机制时仍需重新探索和验证。
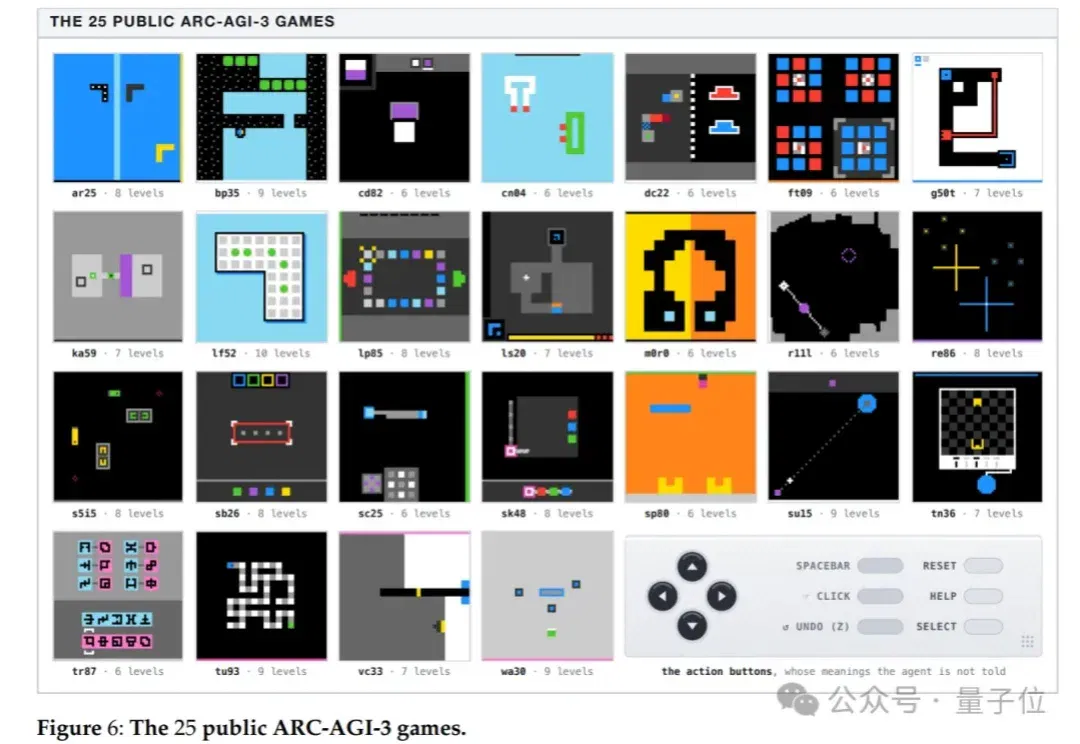
一边打游戏,一边给自己升级? 好家伙,华为这波直接让AI学会了《边玩边变强》啊?! 最新一项研究,华为诺亚方舟实验室联合UCL等团队拿出了一个名叫Memento 3的AI智能体系统—— 直接把ARC-AGI-3公开集里的25款游戏、183个关卡,全部打通了。 还不是靠无脑试错硬闯过去的。 人类完成同样一套关卡,需要17135次操作。 而Memento 3只用了7518次,比人类少操作约56%,最终拿下了满分100的RHAE成绩(Relative Human Action Efficiency,相对人类行动效率)。 更离谱的是,这套系统以Claude Opus 5为底模,全程没有更新模型权重,也
AI把考卷刷到接近满分,下一张,还能考什么?
媒体报道OpenAI发布GPT-6 Astra官博前后多次悄悄修改跑分数据,包括将自身幻觉率从4.2%降至2.0%、将竞品Anthropic Fable 5.1数学成绩调低近10个百分点,并将ARC-AGI-3得分从98.6%注水至99.99%,OpenAI仅以"消除噪点的常态修正"作为回应。
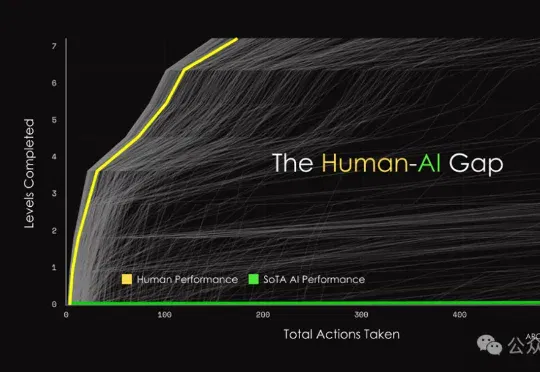
就在昨天,ARC-AGI-3刚把全球顶尖大模型按在地上摩擦,结果一家名不见经传的公司却给出惊天消息:他们的AI在首日就取得了36.08%的成绩!这匹黑马究竟靠什么撕开全球最难AI考试的铁幕?是真突破,还是另有玄机?
当地时间 2 月 19 日,Google 曝光 Gemini 3.1 Pro 最新模型。在 ARC-AGI-2 这个公认的推理基准测试中,Gemini 3.1 Pro 拿到了 77.1% 的分数。什么概念?它的前辈 Gemini 3 Pro 只有 31.1%,就连专门用来「深度思考」的 Gemini 3 Deep Think 也只有 45.1%。
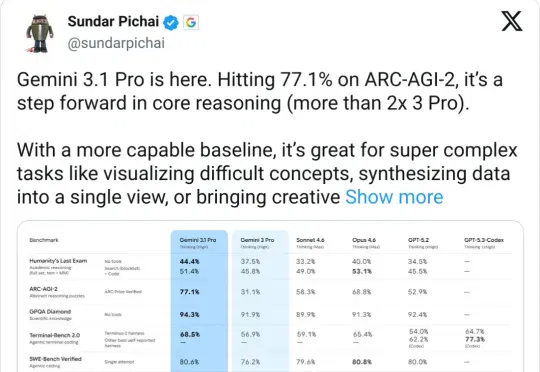
今天凌晨,Google 发布 Gemini 3.1 Pro。核心提升在推理能力,ARC-AGI-2(抽象推理基准)从 3 Pro 的 31.1% 跳到 77.1%,翻了一倍多,GPQA Diamond(科学知识推理)从 91.9% 提到 94.3%
6位前DeepMind成员以元系统重塑大模型调用方式,该系统推出的Gemini 3 Pro优化技术在ARC-AGI-2上以54%的成绩夺得榜首,而成本仅为此前最优方法的一半。