GPT-6刷到99.9%,ARC AGI考卷被迫重做!下一关考「发明」
AI把考卷刷到接近满分,下一张,还能考什么?
AI把考卷刷到接近满分,下一张,还能考什么?
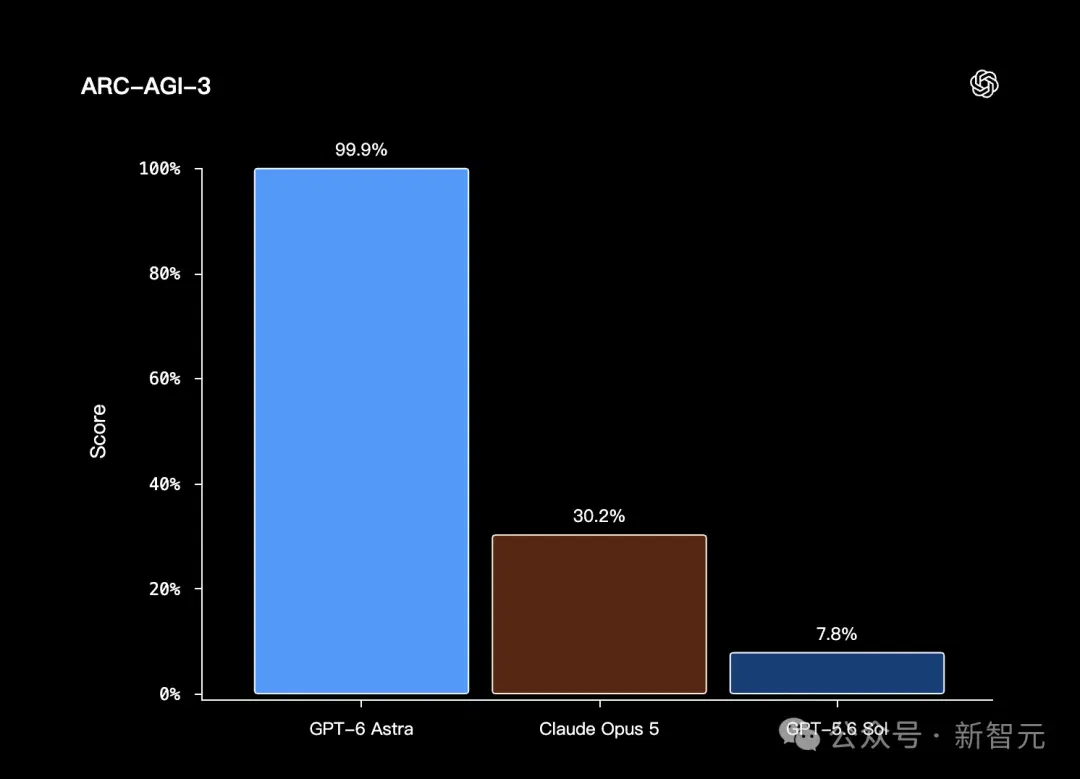
GPT-6 Astra一出世,在ARC-AGI-3半私有测试集上,拿下了99.9%的成绩。
用OpenAI自己的话说:已经完全「饱和」了。
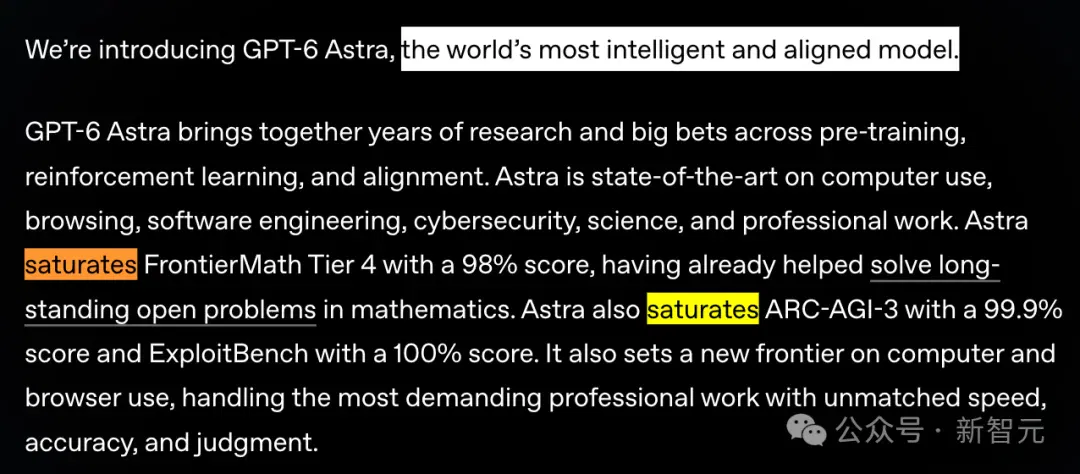
没想到,它的出现,直接让ARC-AGI原定方案全盘作废。
提前规划好的ARC系列,需要重新拟题了。
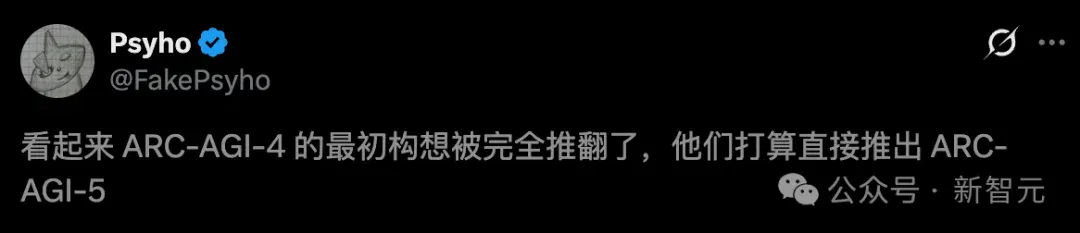
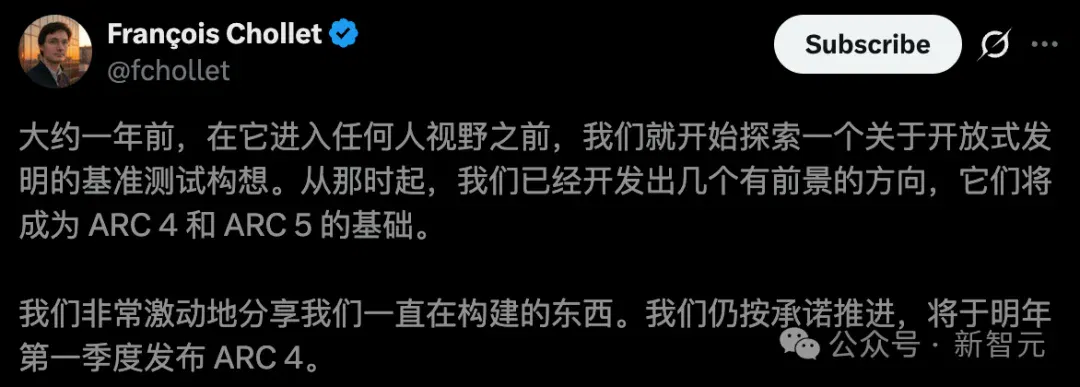
就在今天,ARC Prize创始人François Chollet,正式披露了下一代评测蓝图:
ARC-AGI-4确认将于明年Q1如期登场,而真正具有颠覆性、甚至被称为「人类最后考卷」的ARC-AGI-5已全面提上日程。
ARC 4将聚焦更长尺度下,持续学习与课程学习;ARC 5完全围绕「发明」展开。
他甚至表示,「当AI的学习效率与人类再无客观测量差距时,那便是真正的AGI时刻」。
GPT-6刷爆ARC-AGI-3
全靠工程学
GPT-6 Astra在ARC-AGI-3上的表现,是2026年AI圈最具戏剧性的一幕。
在ARC Prize的「标准测试框架」下,Astra拿到62.7%。
这个成绩当然已经是历史最高,但距离满分还很远。
然而,当OpenAI接入自家的Provider Adapter,同一个模型的得分直接飙到99.9%。
这是一种能在多次调用之间保留模型隐藏推理状态的上下文管理适配器,可以让AI以更接近生产环境的方式接入能力插件。
结果就是:同一套权重,同一组题目,得分差出36个百分点。
ARC-AGI-3的排行榜含金量因此被重新审视,争论焦点从「哪家模型泛化能力更强」,变成了「哪个harness更公平」。
这不是孤例。Claude Opus的同一套权重,在ARC-AGI-3私有集上验证为30%,换用更好的harness后达到95.5%。
英伟达的AVO,甚至在公开演示集上拿到100%。
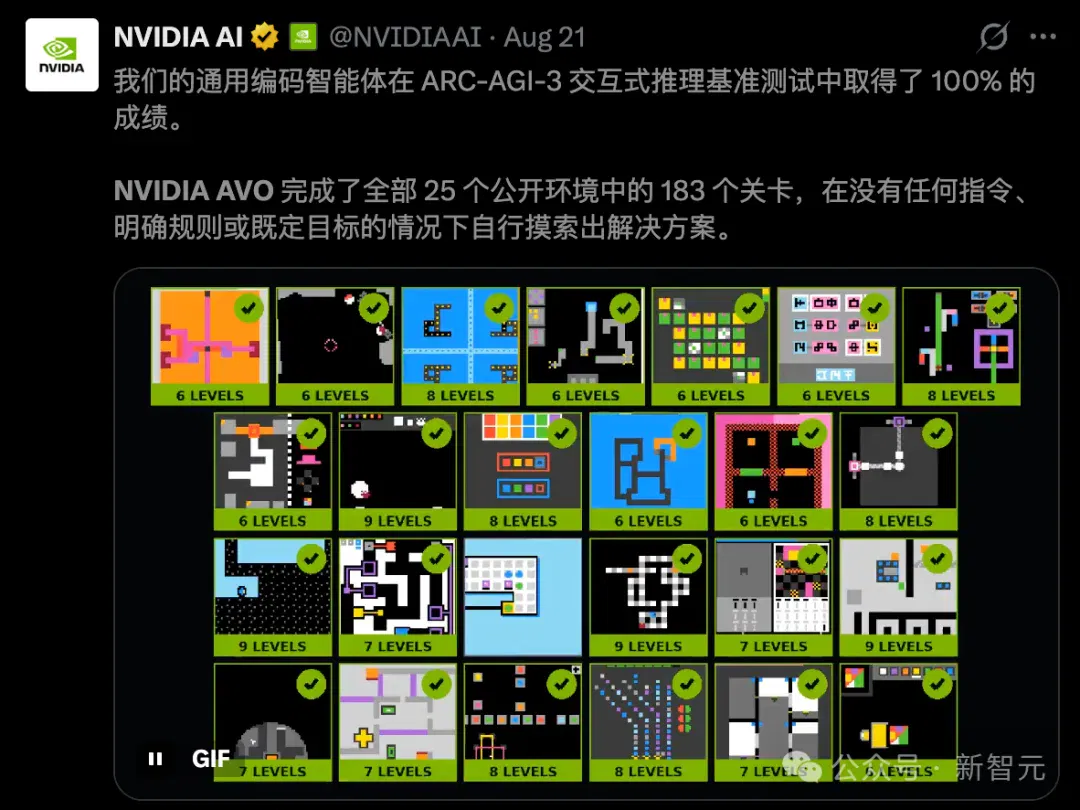
ARC-AGI-3的「饱和」,更像是一个评测工程学事件。
ARC-AGI 3在测什么
前两代ARC-AGI-1和ARC-AGI-2,核心还是「看图找规律」。
系统给几组「输入→输出」的小方格图,AI猜规则,再画出新一组的输出。
这是静态题,答案唯一,靠的是「看几个例子就能归纳出规则」的能力。
到了ARC-AGI-3,考法被彻底换掉了。
它直接把AI丢到一个游戏世界里,在1000多个关卡中,让它自己玩、自己试、自己找规则。
每个游戏有自己的内在逻辑、隐藏规则和通关条件。
没有说明文档,没有自然语言提示,没有人告诉你「收集三个红色方块就能过关」。
AI只能看到当前画面,选择一个动作,观察结果,再决定下一步。
像盲人摸象一样,一步一步试探,在大脑里拼凑出「这个世界可能是这样运作的」的模型。
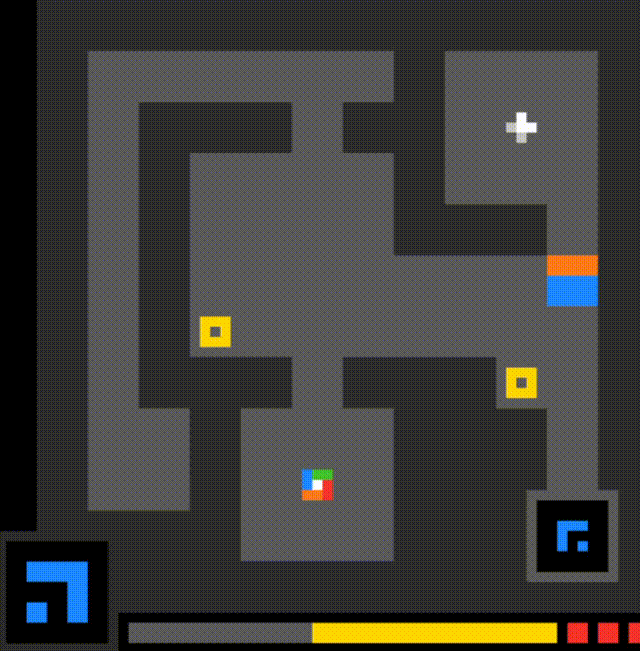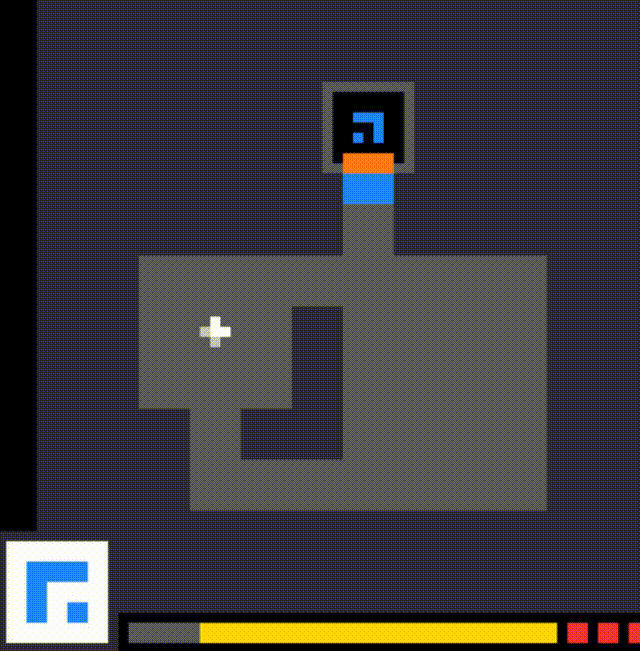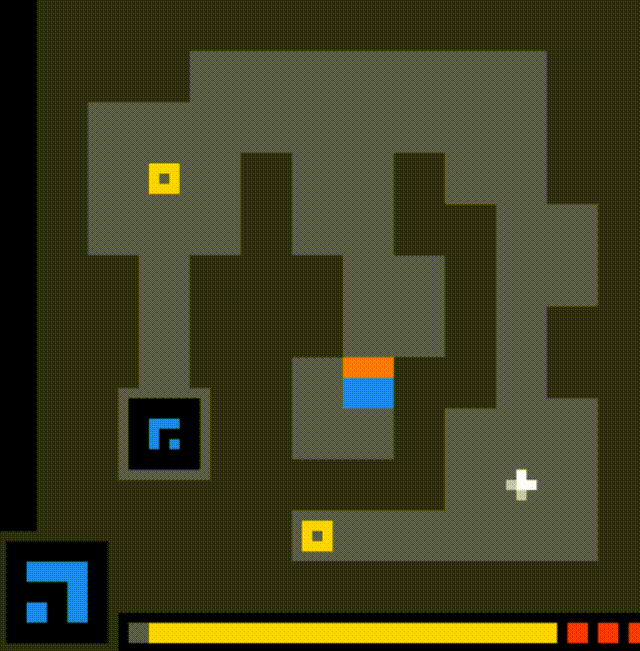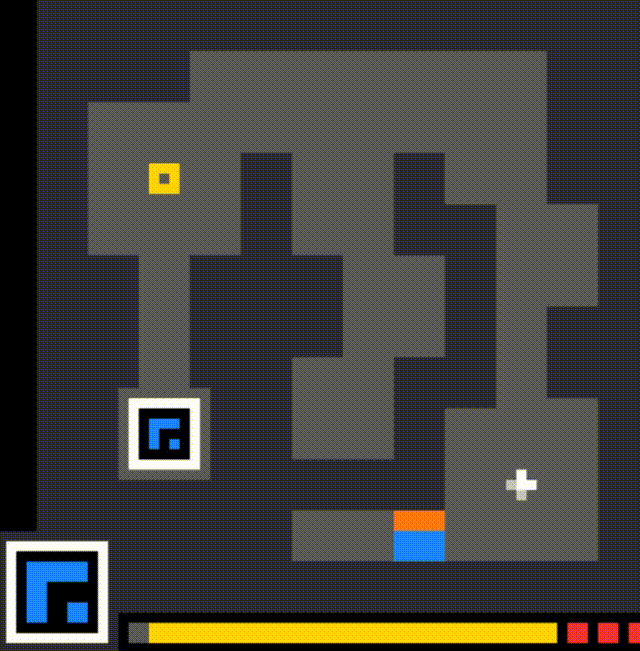
ARC Prize团队明确列出了这个基准要测的四件事:探索;建模;目标获取;规划与执行。
GPT-6 Astra在96%的关卡上用比人类中位数更少的步数完成了任务,平均每关少用51.7%的动作。
ARC Prize称这是「阶跃式的能力变化」,但同时强调了一句:基准饱和并不等于证明了AGI。
因为这些环境是「有界」且确定性的,不是开放式的 。
下一张考卷
开始逼AI「发明」
按照原计划,ARC 4将延续ARC 3的精神,但更偏向更长时间尺度上的持续学习和课程学习。
每个游戏的关卡多得多,而且关卡是「复利」的,每一关都得复用前面关卡学到的东西。
现在,Chollet把「开放式发明」,放进了ARC 4和ARC 5共同的研发基础。
那么,「考发明」到底怎么出题?
ARC 1到3都有一个共同前提:存在一个「对」的答案或一个「赢」的状态,而且人类第一次上手就能做到,这样才能用人类当尺子。
ARC 3的整套人类基线,就是那486个人、2893次尝试量出来的。
发明的定义里就包含「以前没有」,没有标准答案,也就没有现成的人类基线可以除。
你没法说「人类发明这个东西用了多少步」。那接下来,具体该怎么量?
一条可能的路是回到Chollet对智能的「定义」:智能不是会多少技能,是获取新技能的效率。
如果沿着这条线,发明可以量成——AI造出来的那个新工具、新规则、新记号,有没有后面的问题解得更快。
Astra给游戏编速记符号,其实已经是这个动作的雏形。它发明了一个中间表示,然后靠它省了一半的步数。
下一张考卷,ARC 5大概率是把这件事变成「考题本身」。
ARC 5直奔终极
人类还能出几张考卷?
值得一提的是,ARC系列的考题,大概会在第6代、7代终结了。
Cholle曾表示,只要还能提出「人类能做、AI 不能做」的事,就继续出题;
等到提不出来了,等到人类的学习效率和前沿AI之间的差距已经无法测量,那个时刻就是AGI。
AI进步太快,留给一张评测证明自己「足够难」的时间,正在被压缩。
一道难关刚被攻克,出题人就得寻找下一道。
分数逼近天花板后,原来的考卷也越来越难分辨:AI究竟又强了多少,人类还领先在哪里?
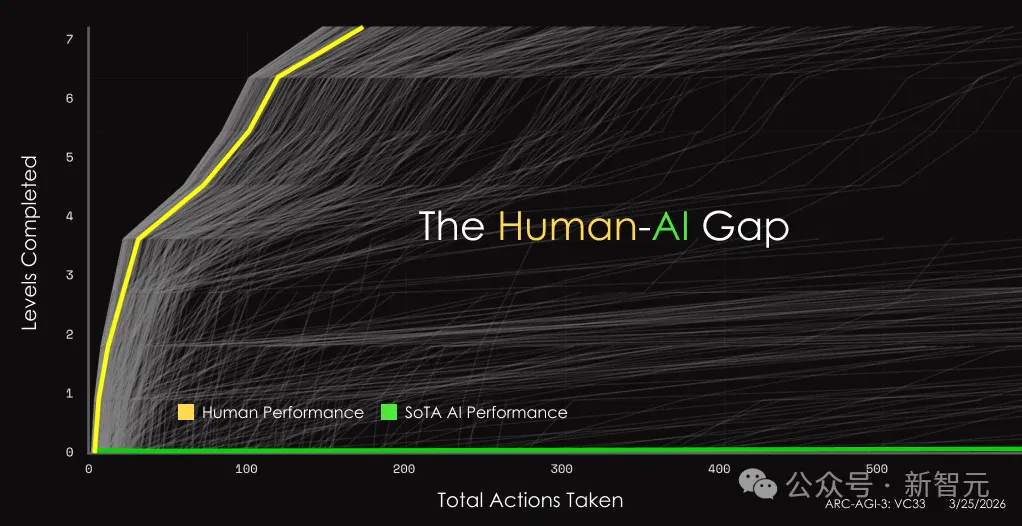
沿着这条趋势看,ARC 5瞄准「发明」,很可能是在提前寻找一道更难被刷穿的考题:
让AI走出预设解法,创造出能被验证、能继续复用的新东西。
这道题能守住多久,现在没人知道。
但如果连开放式发明也无法再拉开人机差距,「考无可考」就会从一句感叹,变成AGI讨论中绕不开的问题。
AI还在加速,人类还能出几张考卷?
参考资料:
https://x.com/FakePsyho/status/2099086728963207537?s=20
文章来自于"新智元",作者 "桃子"。
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读AI资讯栏目中的内容。
AI 会毁掉数学吗?它先学会了大厂的虚荣(在新窗口打开)
大概是今年以来,AI 冲击各种数学猜想,越来越像永不结局的连续剧。这个模型又拿到了更高分,那个模型又解开了一道多年无人攻克的难题,人类的数学智慧岌岌可危。
前OpenAI后训练VP回应陶哲轩:说AI毁了数学,可能还是太小瞧AI了(在新窗口打开)
说AI毁了数学,可能还是太小瞧AI了。 刚刚,OpenAI前后训练VPLiam Fedus,回应了陶哲轩等数学家关于“AI不应只追求解题,更应推动数学理解”的观点。 他赞同陶哲轩对概念理解的重视,但也认为不能用今天AI的能力边界,框定未来的可能性。 在Liam看来,未来的AI不仅能解决问题,还能提出有价值的洞见、建立新的概念框架,让数学家在此基础上继续探索。 换句话说,如果AI的训练目标不只是“把题做对”,而是进一步扩展到解释为什么、提炼方法、帮助人类理解,那么它最终可能成为一个既能给答案,也能创造新思路的数学研究伙伴。 这份乐观,与陶哲轩等25位菲尔兹奖得主最初联署的声明,既有共识,也有分歧
横扫四榜,DM0.5 凭什么面面俱到?(在新窗口打开)
单科冠军不够,具身智能落地需要没有结构性短板的底座
突发,GPT-6 Sol曝光了!(在新窗口打开)
OpenAI的GPT-6 Sol已在API中被发现并处于内部测试阶段,预计本月与Anthropic的Opus 5.2同期上线,实测显示其性能逼近GPT-6 Astra但调用成本更低;OpenAI核心研究员Noam Brown在播客访谈中透露,公司已将AI递归自我改进(RSI)确立为第一优先战略目标。
端侧AI从「能跑」到「会进化」,元空智能跑进惠普预装(在新窗口打开)
静态互联网数据的增长红利,见顶了。 下一轮模型能力的跃迁,会越来越依赖与真实环境持续交互的「端侧」。 当整个行业还在想办法把更强的模型塞进设备时,一支从北大走出来的团队,给出了上述这一激进的行业判断。 甚至在端侧AI迎来爆发的这个时间节点,他们还直接给它重新下了一个定义: 生产力=元空端侧AI=模型×Agent×设备。 端侧AI也由此从一条「把模型搬下来」的单向链路,开始变成一套能自己转起来的飞轮。 △ AI生成 得出这个反常识判断的公司,大家应该也不陌生:元空智能(元空AI)。 三年前,这支从北大走出来的创业团队,靠国内最早一批AI Excel产品ChatExcel迅速出圈,短时间积累上百万