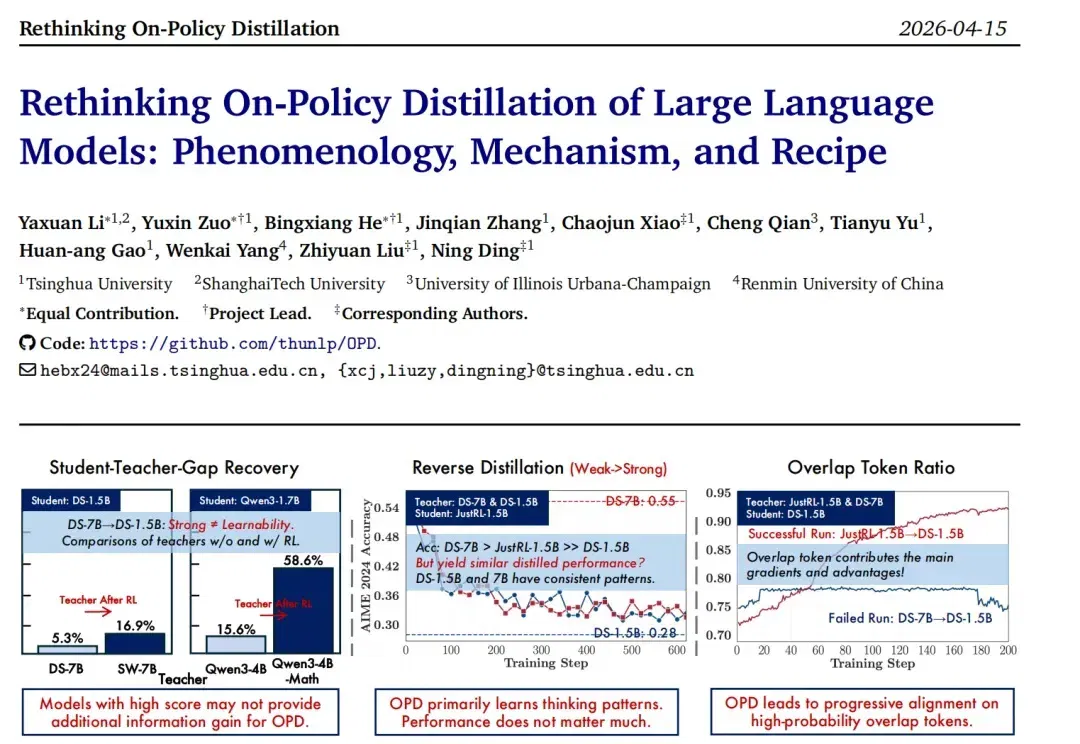
名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」(在新窗口打开)
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
共 219 篇
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
3B激活参数,视觉能力直逼Claude Sonnet 4.5。
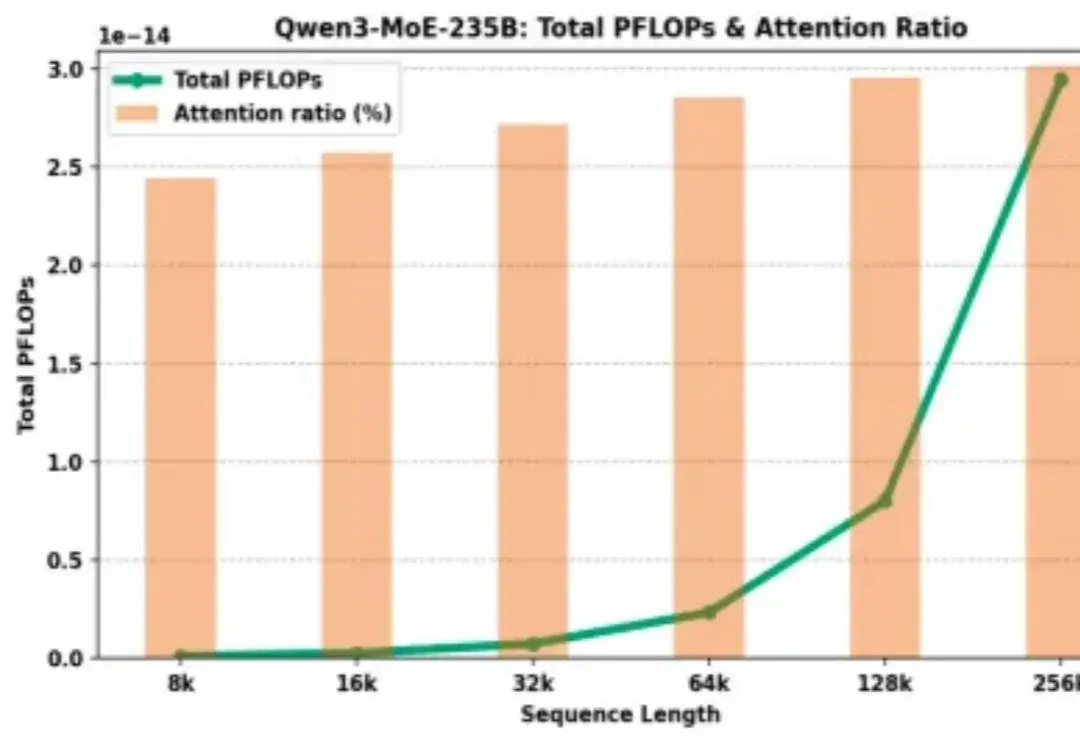
为什么大模型厂商给了 128K 的上下文窗口,却在计费上让长文本显著更贵?
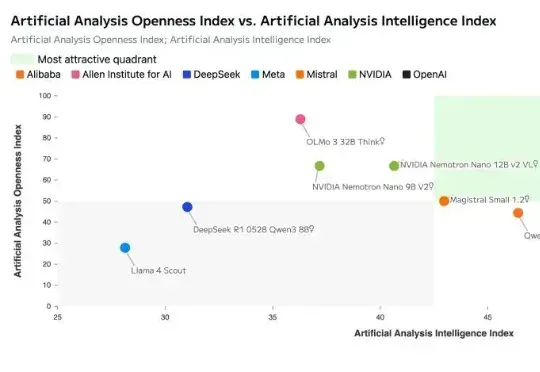
就在刚刚,英伟达正式开源发布了其新一代AI模型:NVIDIA Nemotron 3。Nemotron 3 系列由三种型号组成:Nano、Super 和 Ultra。官方介绍其具备强大的智能体、推理和对话能力。
这一次带来如此新SOTA效果的,是全球首个实现项目级开发的AI IDE——Vinsoo。刚刚,Vinsoo上新Beta 3.0版本,仅用国产大模型(Qwen),就超越了搭载Claude的Cursor、Codex、Claude Code等一众流行AI编程产品。Vinsoo是芸思智能推出的全球首个搭载云端安全Agent编程团队的AI IDE,主打从需求确认到交付验收,AI全流程自动推进项目开发。
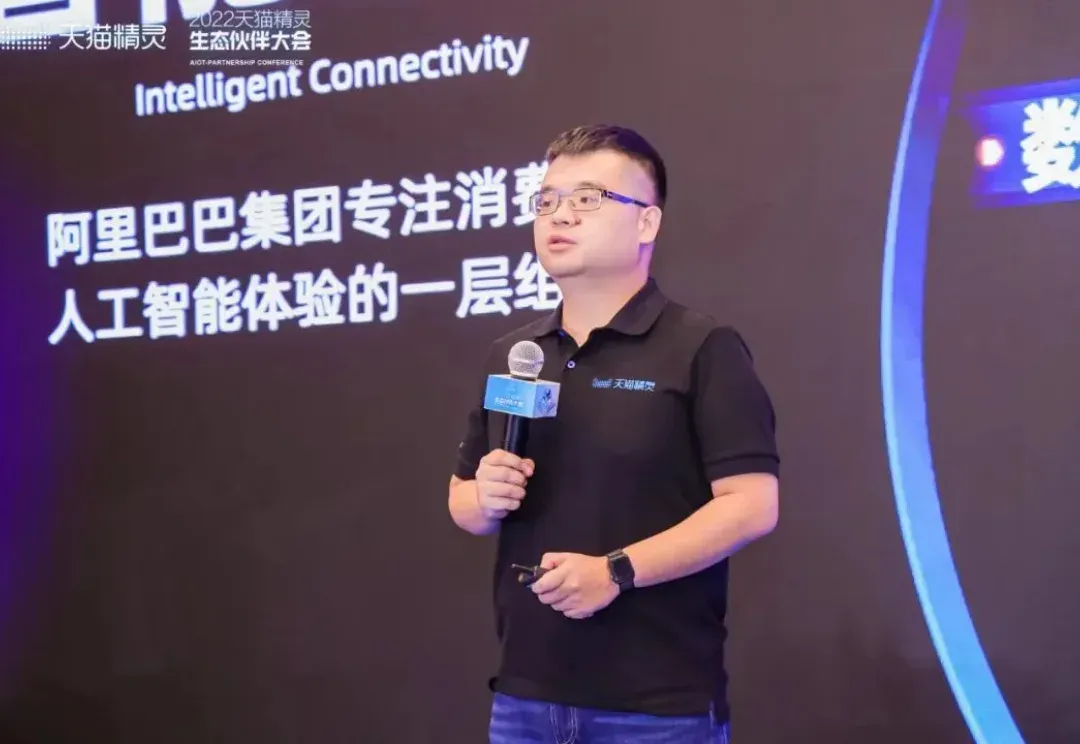
彭超曾在华为印度、阿里任消费硬件业务1号位;联合创始人齐炜祯为Multi-token架构开创学者,被Deepseek、Qwen引入预训练方法。
近日,号称是首个专注于金融市场的 AI 实验室的美国实验室 Nof1 启动了一个将多个 AI 大模型置于真实金融市场中进行自动化交易对决的实验平台。这一项目的名称叫做 Alpha Arena,它是一个
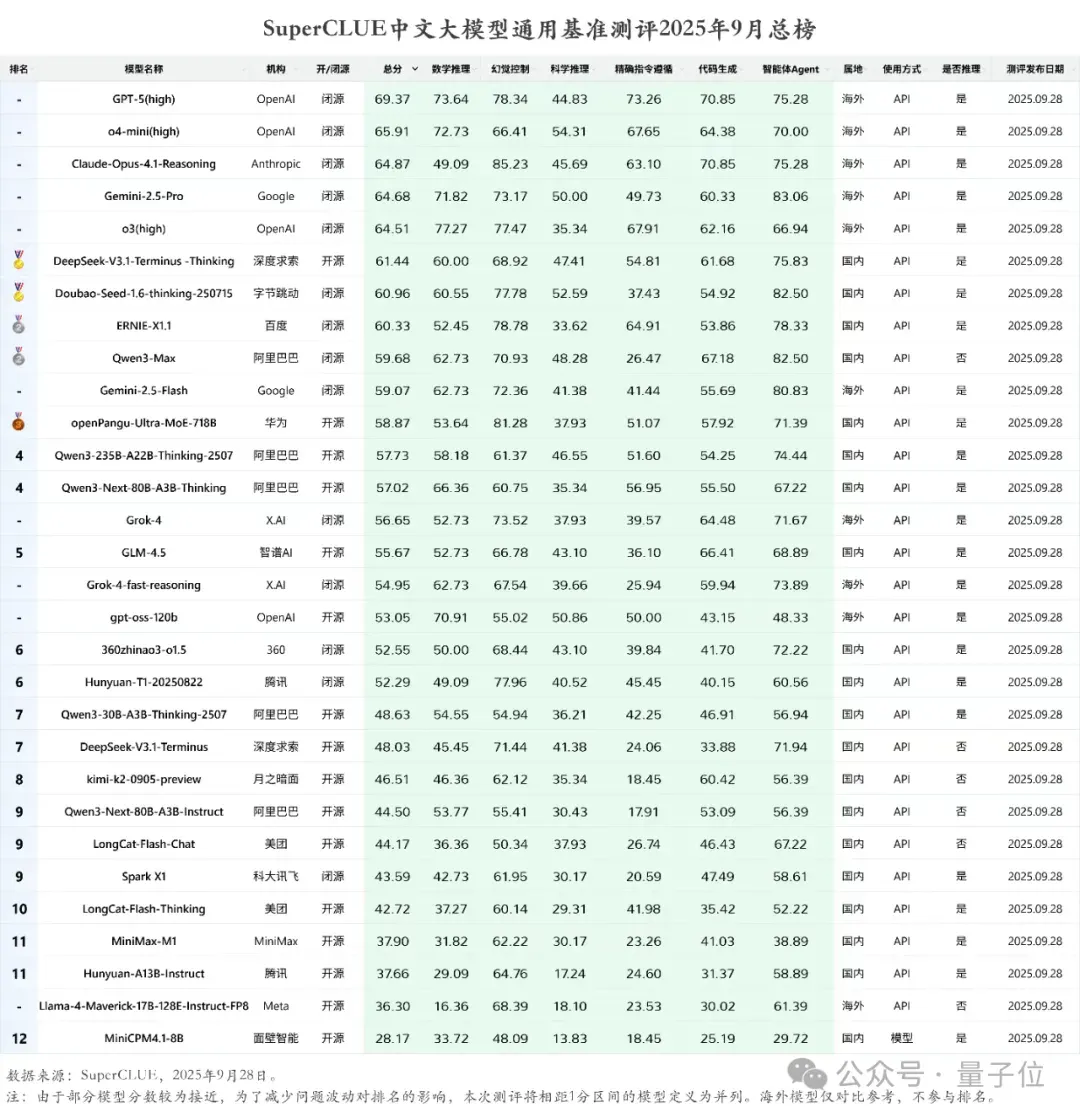
就在最新一期的SuperCLUE中文大模型通用基准测评中,各个AI大模型玩家的成绩新鲜出炉。DeepSeek-V3.1-Terminus-Thinking openPangu-Ultra-MoE-718B Qwen3-235B-A22B-Thinking-2507
作者以冻结行情数据比较Qwen4-Max、Hy4、Kimi和DeepSeek的投研底稿、公式兼容性与调用费用。测试包含尚待验证的价格预测,不能将小样本交付结果等同交易收益或预测可靠性。
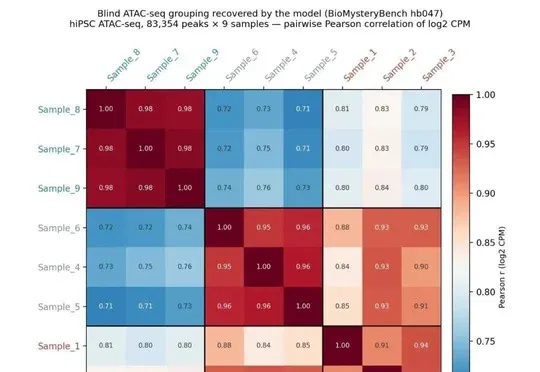
团队对基于Qwen模型的生信后训练版本公布多次尝试成绩,并展示队列、无标签样本和数据质检案例;结论仍限指定任务和系统。