无界前沿开放 Fx-Bio-1031,报告生信基准与分析工作流测试
团队对基于Qwen模型的生信后训练版本公布多次尝试成绩,并展示队列、无标签样本和数据质检案例;结论仍限指定任务和系统。
编辑更正(2026年11月16日)基准成绩由发布团队在其框架下报告,Pass@k为多次尝试指标;案例为计算研究,不是临床因果或疗效验证。本地部署也需核对资源、联网工具及权限。
过去半年,如果你仔细观察硅谷最顶尖的AI实验室,会发现一场围绕“生命科学”的闪电合围已经悄然完成:
- 今年4月,OpenAI率先抛出王炸,发布专为生命科学打造的垂直推理模型GPT-Rosalind(随后迅速迭代至以GPT-5.5为底座的GPT-Rosalind-5.5),并同步祭出严苛的生信评测基准;
- 今年5月,Google紧随其后推出Gemini for Science;
- 今年6月,Anthropic正式上线面向科研人员的AI工作台Claude Science。
从底层垂直模型、评测标准到科研工作台,全球头部AI企业在短短半年内,已经将生命科学视作验证AGI与RSI含金量的头号战场之一,纷纷开启全栈布局。
然而,当这股前沿浪潮照进现实,国内生命科学界与开发者在实际落地中,却面临着两道绕不开的现实门槛:
一方面,以GPT-Rosalind为代表的海外生信垂域模型高度闭源。更关键的是,这些模型未必能够直接满足国内课题组与药企对本地化部署、数据安全和业务适配的需求;
另一方面,生物信息学本身具有较高的专业门槛。面对动辄数百万行的测序数据、缺失标签的实验样本,以及涉及多步统计检验和复杂工具调用的分析管线,通用大模型往往还需要专业知识、工具链与执行环境的配合,才能稳定完成真实科研任务。
通用模型做生信,像在背诵医学百科:表面术语对答如流,一进真实沙盒就报错崩溃。
垂域RSI模型做生信,则是把模型直接扔进命令行与数百万行原始噪声里:自己写脚本、调数据库、做交叉验证。没跑通的一方只能眼看着代差一代代拉大。
今天,无界前沿正式开源生物信息大模型Fx-Bio-1031。
该模型面向专业生物信息学任务研发,瞄准OpenAI GPT-Rosalind等专业模型所探索的方向,并开放完整模型权重。目前Fx-Bio-1031已经跑通生物医药干实验。
在Anthropic发布的BioMysteryBench基准测试中,Fx-Bio-1031在困难子集(Difficult)上取得了70.59%的Pass@5,大幅甩开同框架下的GPT-6-Astra(47.06%)与Claude Opus-5(52.94%)。相比之下,Fx-Bio-1031分别高出23.53和17.65个百分点。
此外,在考察复杂科学分析全流程能力的BiomniBench上,Fx-Bio-1031的Pass@3更是达到了89.50%。
面对连人类专家都头疼的高难度任务,它不再是一个只会背诵基因名词的“文献问答机”,它能做到写代码、装软件、调数据库、做交叉验证,甚至在算出一个显著结论后,主动再给自己连上14道“魔鬼质询”。
先看成绩单:在人类专家卡壳的深水区,拉开代差
为什么生物信息学是检验AI智能体(Agent)成色的残酷试金石?
在Anthropic的BioMysteryBench中,模型不能靠检索原始数据集的现成结论蒙混过关,而是被直接扔进真实的生物数据与Linux工具环境里,完成一系列复杂分析任务。这些任务覆盖全基因组测序(WGS)、单细胞转录组(scRNA-seq)、染色质开放性(ATAC-seq)、宏基因组与蛋白质组学。
它必须像真正的计算生物学家一样:自己审视原始文件、去NCBI和Ensembl捞注释、编写多步统计脚本,走不通就推翻重来。
在团队统一的智能体评测框架下,Fx-Bio-1031交出了这样的答卷:
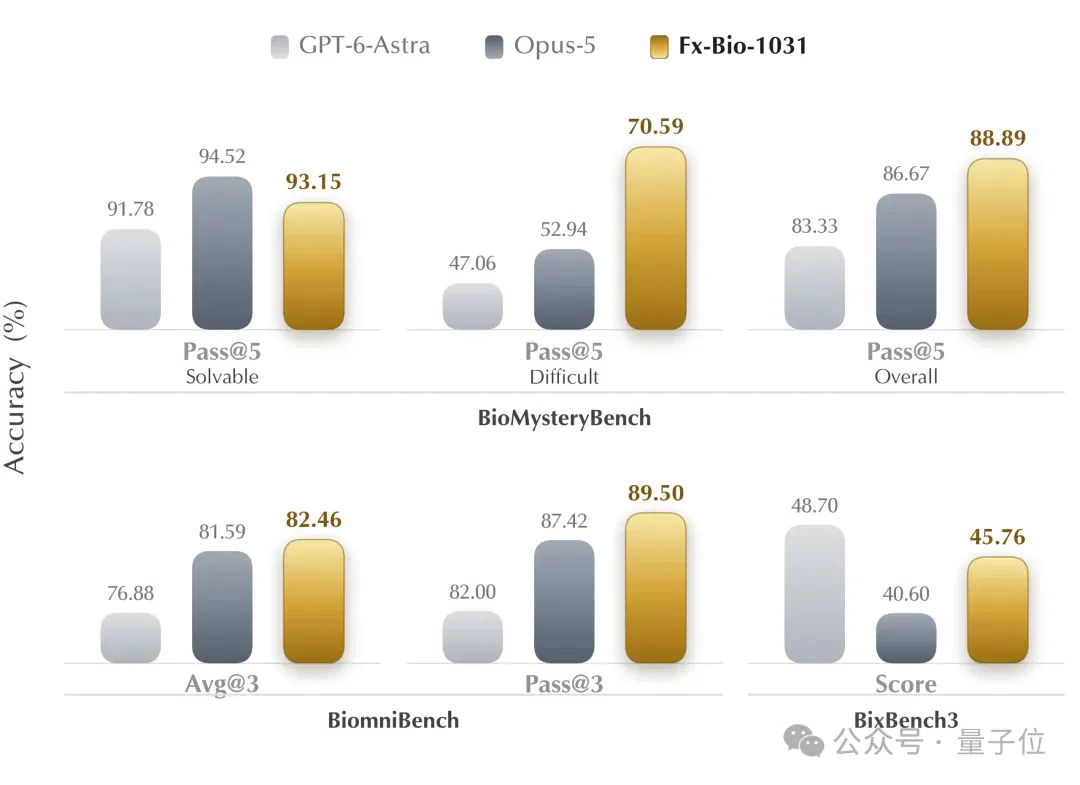
图中数据来自发布团队上传的模型卡与内部评测框架,并非Hugging Face平台独立官方验证。Pass@k表示给定尝试预算下的成功指标,不能等同单次运行成功率。
仔细看这张图,最刺眼的数字出现在Difficult(困难子集)。
当题目属于人类专家可解子集(Solvable)时,顶尖模型都在90%以上神仙打架;但一旦进入需要数十步长程推理、多源证据拼图、甚至人类专家都会折戟的Difficult深水区,GPT-6-Astra和Opus-5的通过率瞬间跌破或卡在50%左右。
而Fx-Bio-1031直接冲到了70.59%,领先幅度达到17.65到23.53个百分点。
真正的模型代差,从来不在送分题里,而在那些条件残缺、信噪比极低、人类都要苦思数天的极限任务里。
五大落地场景:国产开源生信模型,能解决哪些痛点?
跑赢高难基准只是第一步。
对于每天都在持续产生海量数据的医院临床团队、高校课题组、Biotech药企和CRO机构而言,真正有价值的是AI能否进入实际科研流程,处理不同类型的组学数据,完成从数据质控、统计分析到结果验证的复杂任务,并将这些能力融入现有的科研工作流。
基于专业生信分析能力、工具调用能力以及本地沙盒运行环境,Fx-Bio-1031重点面向以下五类应用场景:
1. 药物研发与临床肿瘤队列挖掘(靶点与生物标志物验证)
支持药企在本地私有化环境中,对海量患者临床测序队列进行基因共突变/互斥分析、耐药机制排查、患者亚群分型与生存关联复核。
新一批临床样本入组后,一键重跑全套管线并自动开展十余项敏感性分析,把原本需要生信团队排期数周的靶点立项调研压缩至小时级。
2. 多组学联合分析与分子机制拆解(高校与科研院所)
覆盖全基因组(WGS)、常规转录组(Bulk RNA-seq)、单细胞转录组(scRNA-seq)、表观遗传学(DNA甲基化、ATAC-seq、ChIP-seq)及蛋白质组学数据。
从“启动子区域甲基化变化筛选”到“基因表达关联分析与功能通路富集”,模型能端到端跑通从原始矩阵清洗、统计检验到发表级图表与报告生成的完整证据链。
3. 病原微生物溯源、宏基因组挖掘与质控排障(疾控、临床检验与测序服务商)
面对匿名的临床分离株、肠道感染样本或海量环境宏基因组数据,模型可自动完成底层FASTQ/MAF脏数据质检与修复、病毒/细菌物种及血清型(如诺如病毒亚型、鞭毛抗原式)精准鉴定,并在复杂背景噪声中锁定抗性基因或新型防御系统信号。
4. 实验异常排查、盲测还原与审稿补实验(湿实验与干实验协同)
当湿实验出现样本标签混淆、批次效应干扰,或收到期刊审稿人“换一种统计口径/加做阴性对照结论是否依然成立”的严苛质询时,研究员可直接将问题与数据丢给模型,联动NCBI、Ensembl、COSMIC等公共数据库交叉验证,快速完成盲测溯源与补充实验。
5. 生信自动化Agent底座与定制化管线开发(AI+Bio开发者生态)
凭借512K超长上下文与强化过的工具调用能力,开发者可将Fx-Bio-1031直接接入如深势科技BioMaster等科研智能体工作台或企业内部LIMS系统,构建能够自主写代码、装软件、诊断报错并交付可审计报告的自动化生信流水线。
为什么这套基座能真正走进产业一线,甚至跨越学科边界?
第一,极致性价比,专为私有化本地部署而生(数据不出域)。
当前模型卡区分125B MoE骨干与嵌入、MTP等组件,并标注语言部分合计180B。6B是MoE骨干的活跃参数口径,不能据此估计全部权重的内存或存储需求。
得益于较低的激活参数规模,Fx-Bio-1031在推理时所需的计算量相对可控,有助于降低推理成本。对医院科室、高校课题组与药企来说,无需天价算力集群即可在本地机房私有化部署。
私有部署可以减少外部传输,但联网数据库、工具、日志与权限仍需配置检查,不能自动保证数据绝不离开组织或设备。
第二,不止于生信,依托RSI-OS能够面向万千场景快速迁移。
生物信息学只是这套自演进体系的第一块试金石。模型在训练中真正习得的,是一套“拆解模糊需求、调用工具、交叉验证、自我纠错”的通用问题解决范式。
团队希望把工作流与自我改进方法扩展到其他领域,跨领域效果仍需独立任务验证,不能保证低成本自动迁移。
三个硬核现场:哪怕不懂生物学,也能看懂的“恐怖执行力”
为什么Fx-Bio-1031能扛起这五大硬核场景?
团队直接拆开它在评测与真实盲测中的三个运行现场,用大白话带你看懂问题有多难,再看它如何破局。
破案一:算出显著结果只是开始,它反手给自己做了14项“压力测试”
大白话:
1、药企研发抗癌药时,最怕“假阳性”——表面算出来两个癌症基因“水火不容”(互斥),但换个筛选标准结论就崩了。
2、在这道题里,AI先从近两千条医院记录里算出“这两个基因确实互斥”;但它没急着交卷,而是主动把判断标准苛刻地换了14种写法反复验算。
在数据科学和生信研究里,最怕一句话:
“你换个统计口径,这个显著规律还在吗?”
很多时候,所谓的“重大发现”,只是恰好卡在某个特定的筛选阈值上。要验证结论硬不硬,研究员得推翻重筛样本、调整纳入标准、重跑全套检验。
在一道乳腺癌临床队列任务(BiomniBench da-18-7)中,任务要求探究内分泌治疗后的HR+/HER2−乳腺癌患者体内,ESR1突变与RAS/MAPK通路变异到底是“倾向共存”还是“相互排斥”。
Fx-Bio-1031先从1,918份杂乱的样本记录入手,清理MAF文件中的完全重复记录,精准锁定762名独立患者,算出核心结论:ESR1突变患者的通路变异率仅为7.1%,远低于野生型患者的19.5%(比值比OR=0.317,p=0.0011),10万次置换检验进一步确认了强烈的“互斥”信号。
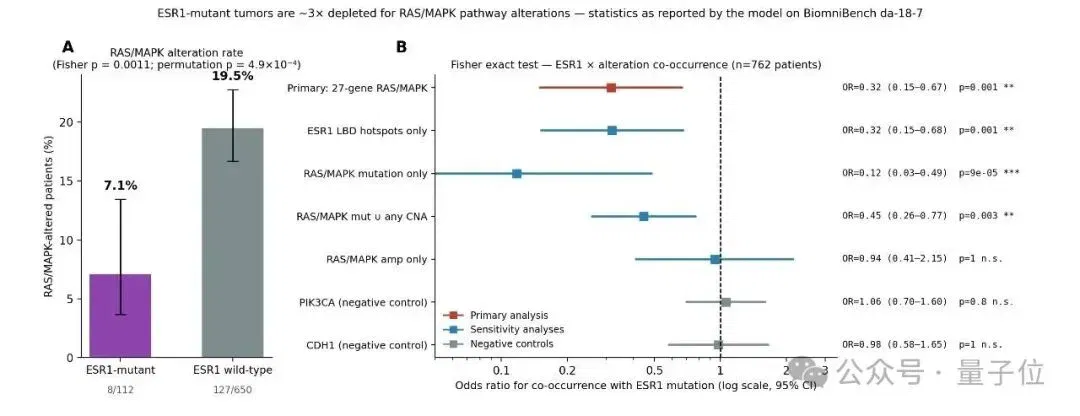
△ESR1突变与RAS/MAPK通路变异的关联分析。左侧比较两组患者的变异率,右侧展示主分析、代表性敏感性分析与阴性对照。
如果是一般模型,算完p值就已经交卷了。但Fx-Bio-1031接下来做了一件极其硬核的事:它主动对自己的结论发起了14项敏感性分析,并设置阴性对照。
它尝试把突变范围收紧到特定热点区域(LBD hotspots)、尝试剔除拷贝数变异只看点突变、尝试只看基因扩增(amp only),甚至主动拉入PIK3CA和CDH1两个基因作为阴性对照(Negative controls)。
最终,它不仅交出了显著性结论,还画出了一张清清楚楚的“结论边界地图”:在绝大多数严苛设定下,互斥效应稳如泰山;但一旦把变异定义放得过宽、或仅统计基因扩增时,统计显著性就会消失。
所以说它不仅算得准,还极其清醒地知道“结论的边界在哪里”。
破案二:9份彻底撕掉标签的样本,怎么靠跨库推理完成“盲测破案”?
大白话:
1、实验室里9管样本标签全消失了,只知道里面有3管是水(对照组),另6管分别加了A、B两种药。
2、AI先通过内部数据比对,把长相最像的样本归成了三堆(每堆3管);接着自己跑去外部数据库里查出“加了A或B之后细胞会往哪个方向变”,拿外部铁证回头比对,把9管无标签样本的身份全部回归原位。
来看一道Anthropic BioMysteryBench的高难盲测题(hb047)。
团队输入给模型的,是9份没有任何分组标签的人源诱导多能干细胞(hiPSC)ATAC-seq测序样本,原始数据涉及110,559个染色质开放峰(peaks)。
题目只给了一条线索:其中6份样本用过两种class I HDAC抑制剂药物处理,另外3份是未处理的空白对照。
请找出谁是谁。
没有标签,怎么认?Fx-Bio-1031的第一步是向内找结构:过滤低信号噪声后,计算了9份样本在83,354个位点上的两两相关性,干净利落地把9份样本聚成了三组(每组3个重复)。
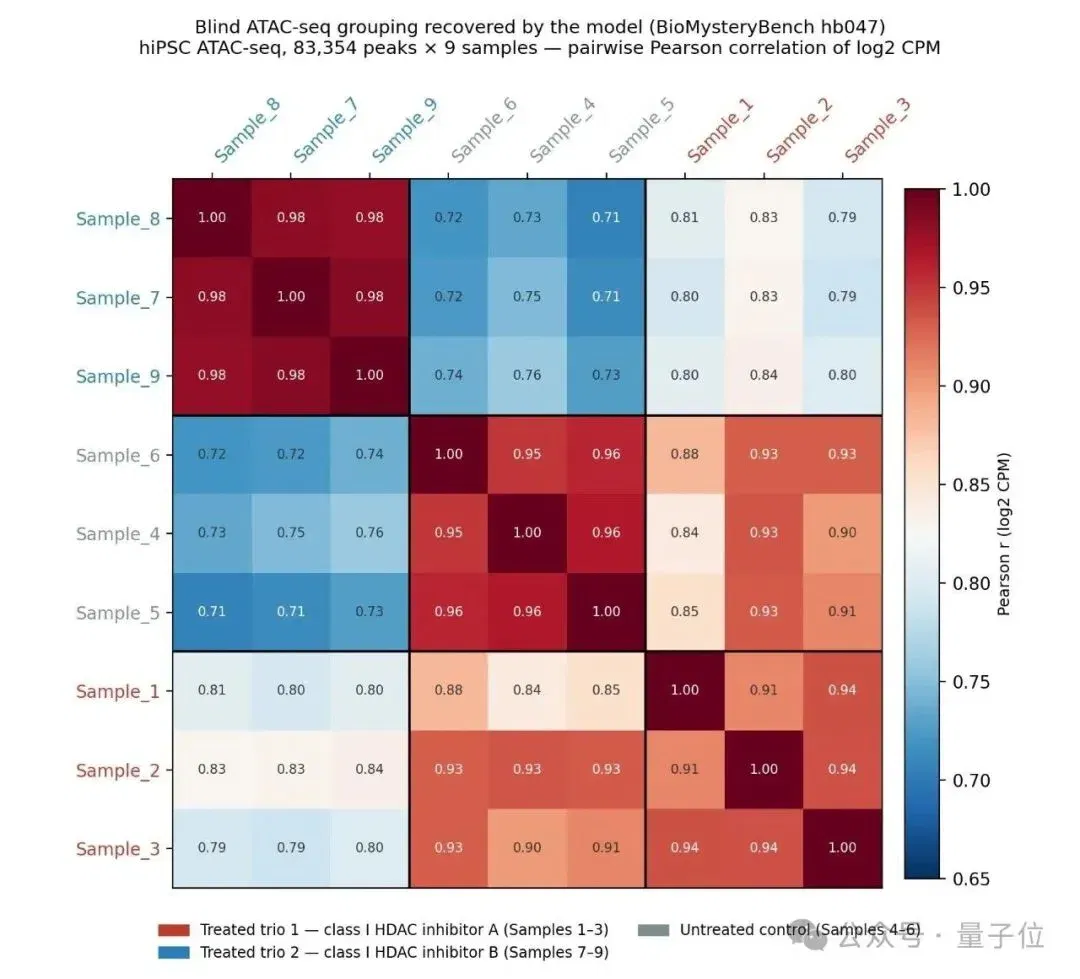
△九份无标签ATAC-seq样本的相关性热图。模型结合样本聚类与公开药物响应数据推断实验分组。
但真正的难题在第二步:聚成三堆之后,哪一堆才是没加药的对照组? 单看数据内部的相似度,神仙也猜不出来。
此时,Fx-Bio-1031展现了惊人的科研直觉,它跳出当前文件,主动去调取基因组注释和公开的HDAC抑制剂已知转录响应数据,将开放峰关联到基因,把“外部已知的生物学响应方向”当作标尺,再通过逐峰位移比较,核对两组药物处理的响应是否一致,最终一锤定音,还原了两组药物处理组与一组空白对照。
破案三:206万个变异、76步连续操作,连原始文件底层的Bug都逃不过它的眼睛
大白话:
该案例分析队列中的突变签名贡献,不等于识别出所有乳腺癌的首要病因,更不能由队列统计直接认定个体因果。
2、自动排雷:一位真实用户传了一份带底层缺陷(数据格式错位)的细菌测序文件,普通软件一跑就崩,AI精准揪出并切掉这行坏数据,连跑258步交出完美报告。
当数据规模推到极限,或者原始数据本身就带着“坑”时,模型还能稳住吗?
在另一道高难题中,输入直接甩过来2,700个肿瘤样本、206万个单核苷酸变异(SNV)、96个突变通道,既不给参考库,也不指定算法,要求找出乳腺癌队列合并统计下贡献最高的COSMIC SBS突变签名。
Fx-Bio自己在本地测试环境中解析突变矩阵与SBS参考签名谱、开展非负最小二乘(NNLS)数学拟合、调起官方工具交叉验证、再跑200次Bootstrap抽样和跨版本复核,完成76步分析操作,精准锁定答案。
在基于BioMaster平台开展的一项细菌测序分析测试中,模型需要根据输入的测序reads(原始测序读段),推断菌株的鞭毛H抗原式(相当于给未知细菌做精准身份分型)。
Fx-Bio在启动分析前的底层数据质检中,敏锐地抓出了一个极其隐蔽的工程Bug:R2测序文件的最后一条记录里,碱基序列长度与质量值长度根本对不上!
它主动写脚本剔除了这条损坏记录,随后调用专业工具SeqSero2完成预测;中间遇到首次运行报错,它当场自我诊断、修复管线,全程连续跑完258步、耗时34.5分钟,最终交出一份完全可追溯的交付报告。
底层引擎:从BigBang到Fx-Bio,无界前沿的“三层RSI”进化飞轮
一个模型凭什么能在如此琐碎、硬核、容错率极低的专业领域里,展现出老练研究员般的直觉与工程韧性?
答案,藏在无界前沿一以贯之的核心信仰里:RSI(Recursive Self-Improving,递归自我改进)。
今年,从谷歌传奇元老Jeff Dean离职创办Discovery Loop,到硅谷一众华人学者创立Recursive Superintelligence,全球最顶尖的AI大脑都在押注同一件事:当人类专家出题和判卷的速度,已经彻底跟不上大模型进化的胃口。
唯一的破局点,就是让AI自己迭代AI。
- 普通微调像对着往年题库答案刷题:题型是固定的、标准答案就在那儿,答错了重调一次参数就行。
- 普通微调与自演进训练各有适用条件。这里比较的是团队的训练思路,不能断言其他方法只会背答案或一换任务就全部失效。
今年8月,无界前沿发布BigBang-V1,用100%由AI自主合成、验证并演化的科学前沿数据,跑通了“数据层RSI”,让35B模型在多项高难科研基准上正面硬刚万亿参数大模型。
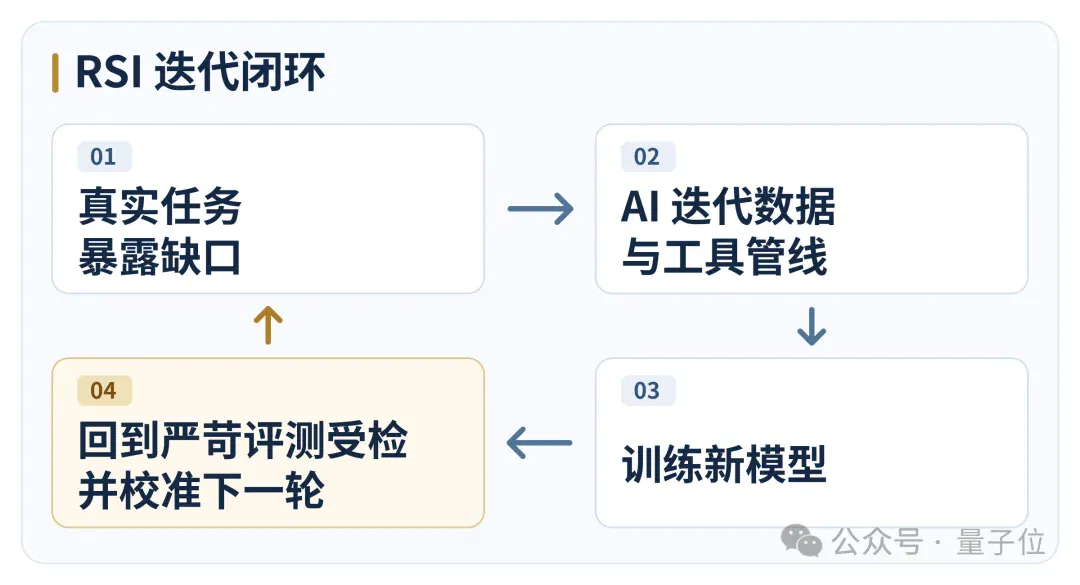
而这一次,在Fx-Bio-1031上,无界前沿把自我进化的引擎进一步推向了纵深——把难以一步闭合的科研大循环,拆解并咬合为“评估层+数据层+环境层”三层可复利演进的RSI飞轮:
评估层(AI参与检验什么算好)
团队联合深势科技BioMaster团队,围绕生物信息分析中的典型任务与复杂工作流构建内部独立验证体系,重点考察模型在数据处理、工具调用、多步分析和结果复核中的表现。
在包含模型、工具与沙盒的完整系统里,对114道内部自建复杂任务独立运行三轮(共342个题次、超20,000次模型请求)。
数据层(AI针对短板自己造题)
沿袭BigBang的数据层演化思路,AI深度参与生成、求解和审查训练任务。
基于内部独立验证集(非外部公开评测基准)反映出的通用能力短板(如跨批次统计口径漂移、多步证据链断裂),系统在公开合规的科研文献与真实生信工作流上自主演化训练轨迹;所有外部公开基准(如BioMysteryBench、BixBench3等)均严格作为零接触的最终盲测考卷,不参与任何训练、微调或数据合成策略调整。
环境层(AI参与打磨工具与环境)
这是生信领域极具潜力的一环。模型在迭代过程中,不只是学知识,更开始尝试编写与修复生信分析脚本、配合持续演进的智能体运行框架(Harness),让下一轮模型做任务时的“武器库”和执行环境同步变强。
为什么选生物信息学作为演进这三层飞轮的第一站?
因为它文献最杂、数据最碎、推理链最长,同时代码执行结果和统计检验又可以复查和重算。
自动化可以分担部分任务构建与检查工作,但专家审查、评估可靠性、算力及真实实验仍构成约束,不能据此宣布摆脱人类专家产能限制。
无界前沿将这套打通“评估—数据—环境”三层闭环的底层引擎定义为RSI-OS(递归自演进操作系统)。
正是依托RSI-OS的持续自演进管线,并结合深势科技提供的高性能机器学习平台(Trisol)的底层算力与训练工程支撑,Fx-Bio-1031得以在海量复杂任务的高频迭代中快速收敛、持续进化。
完整权重开源:让生信基座可控可用
今天,无界前沿正式开放Fx-Bio-1031的完整模型权重:
- 基础架构:基于Qwen3.8-Flash-Next进行深度RSI后训练
- 超长上下文与思考模式:发布配置原生支持512K上下文窗口,足以吞下超长工具调用轨迹、多篇完整文献与大规模组学统计输出
- 开箱即用生态:完整模型权重、分词器、处理器配置与生成配置(采用Qwen Community License 1.0协议;如需将本模型或衍生模型用于商业用途,请提前查阅并遵循Qwen社区许可协议的相关商业授权条款)
📦模型权重与评测详情:https://huggingface.co/endless-frontier/Fx-Bio-1031
无界前沿由中国科学院院士发起,由上海交通大学、上海算法创新研究院和深势科技联合孵化。
创始团队汇集了来自高校和产业的顶级研究者与工程师。团队核心成员陈思衡和张林峰曾带队研发了科学基座大模型Innovator和通用科研智能体SciMaster。
如果您的课题组或研发团队手里正握着一批组学数据,想复核某个关键生物学关联、排查诡异的实验分组,或者想把一条高频使用的生信分析管线彻底自动化,欢迎带着你的真实问题与无界前沿交流,从一项结果可以复查的任务开始联合验证。
联系无界前沿:pr@endlessfrontier.tech
抢先加入无界前沿模型试用社群,让科学家与开发者面对面交流。
文章来自于微信公众号 “量子位”,作者 “量子位”
相关主题
读完之后
加入 AINRK 交流群
了解加入交流群的方式,与更多 AI 从业者交流。
相关文章
继续阅读相关主题与同栏目内容。
乌兰察布数据中心建设一线:工期、运维与城市收益(在新窗口打开)
晚点采访施工、供应链、运维和当地居民,记录算力投入与有限长期岗位之间的落差,并讨论电力、租房和税收变化。
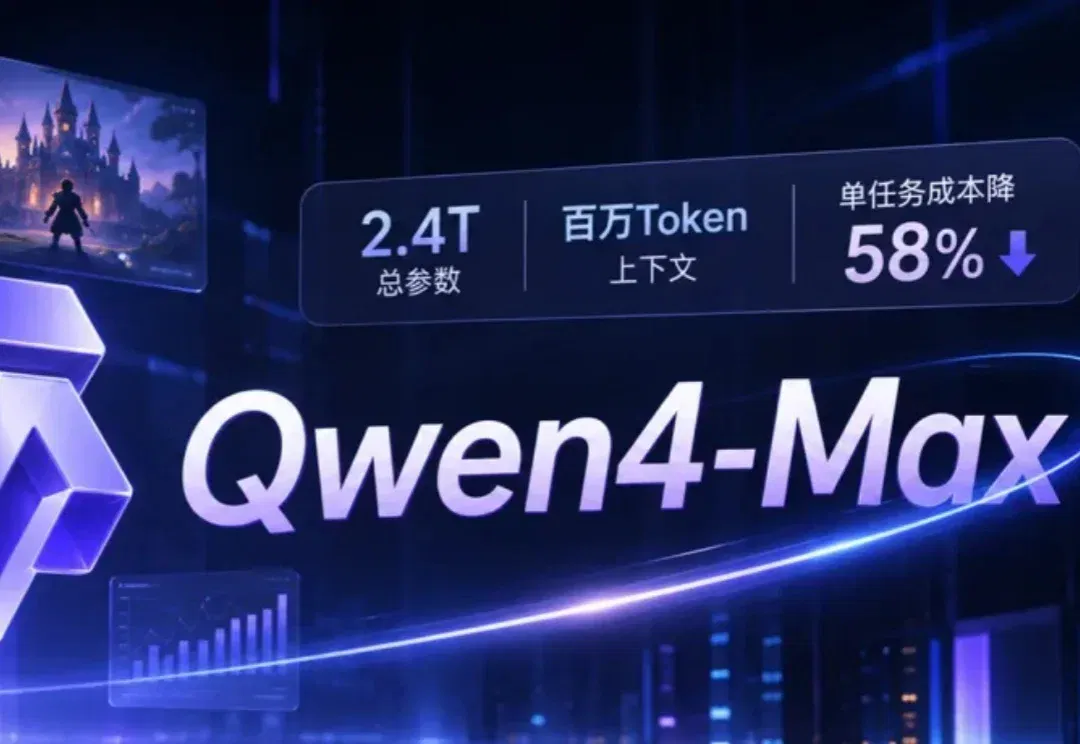
阿里正式发布 Qwen4-Max,扩展多模态与行业 Agent 工作流(在新窗口打开)
报道介绍架构、百万Token上下文及长程交付案例。Work360与AII上的成本降幅不同,复杂开放任务仍有短板,中小模型待后续开放。
Geodesic 发布 NovaAtom-Lite,报告全原子结构预测结果(在新窗口打开)
团队在抗体抗原与蛋白配体基准中报告进展,并测试提示和多候选采样;结构预测成绩不等于药物获批或治愈疾病时间表。
Weitu AI 介绍流式视频大脑,结合稀疏感知与长期记忆(在新窗口打开)
团队以时间片段和空间特征筛选控制计算开销,并报告OVBench与S-EMBER成绩,探索眼镜、办公和工业中的连续视频理解。
据报造物潭完成数千万元天使轮,开发硬件研发智能体小潭子(在新窗口打开)
ZPotentials介绍电子行业模型、工程对象描述与数字员工体系,并转述机器人原型设计、试制与下一步产品开放计划。