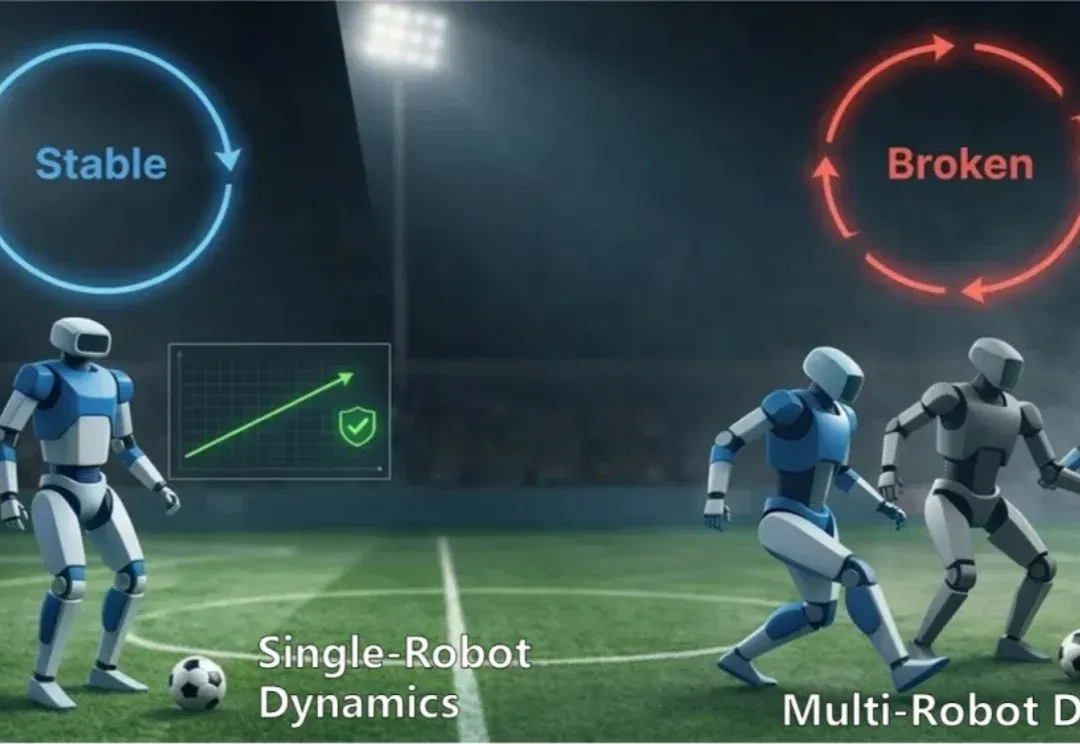
ICLR 2026 | 世界模型卡在多机器人协作?一个「顺序分解」思路打通(在新窗口打开)
近年来,Decision-Coupled World Model 与 Model-based RL 在机器人领域取得了显著成功。通过学习环境动力学模型,智能体能够在内部模拟未来,从而进行规划与决策。但当系统从单机器人扩展到多机器人时,问题开始变得棘手。
共 362 篇
近年来,Decision-Coupled World Model 与 Model-based RL 在机器人领域取得了显著成功。通过学习环境动力学模型,智能体能够在内部模拟未来,从而进行规划与决策。但当系统从单机器人扩展到多机器人时,问题开始变得棘手。
Anthropic 研究科学家 Nicholas Carlini 在 [un]prompted 2026 安全会议上用不到 25 分钟演示了一件事:语言模型现在可以自主找到并利用零日漏洞,目标包括 Linux 内核这种被人类安全专家审计了几十年的软件。
OpenClaw-RL的核心价值在于:它能让您的OpenClaw🦞仅仅通过与你日常对话产生的自然反馈(如你的纠正、补充说明或环境报错),就能在后台实时自动更新权重,变得越来越符合您的个性化偏好,并在实际任务中不再犯同样的错误。
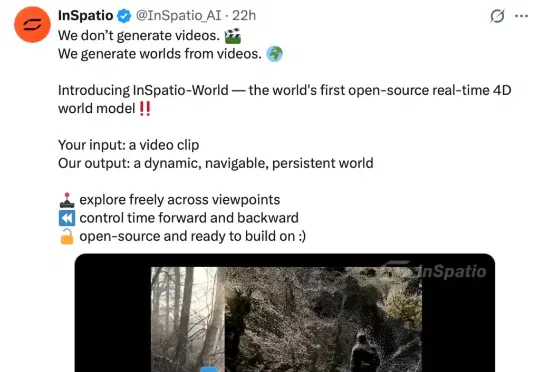
近日,影溯正式发布并开源世界模型 InSpatio-World,综合性能优异,在李飞飞牵头的权威世界模型榜单 WorldScore-Dynamic 中,力压其他实时 / 交互级推理速度的世界模型。它彻底摒弃了烧钱低效的纯 2D 视频路径,凭借更具第一性原理的 3D 空间架构,带来了可实时交互的动态世界。
在当前的 LLM 开发中,后训练阶段通常被视为赋予模型特定能力的关键环节。传统的观点认为,模型必须通过强化学习(如 PPO、GRPO 或 RLHF)和进化策略(ES)等算法,在反复的迭代和梯度优化过程中调整权重,才能在特定任务上达到理想的性能。
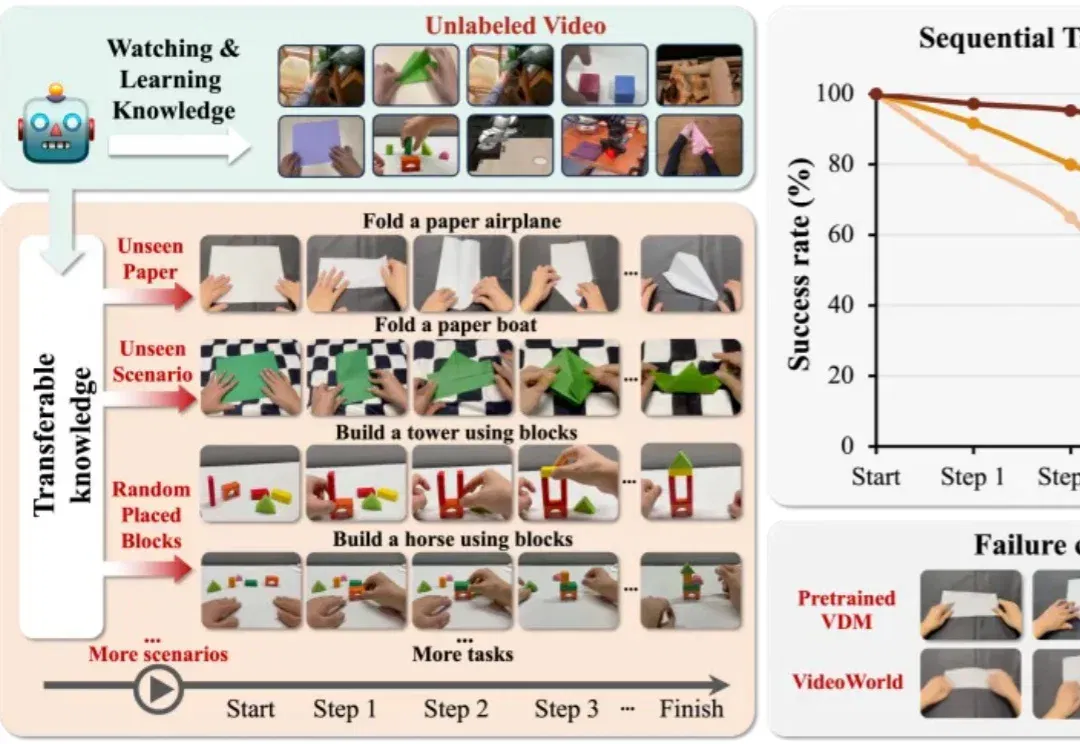
视觉世界模型 “VideoWorld 2” 由豆包大模型团队与北京交通大学联合提出。不同于 Sora 2 、Veo 3、Wan 2.2 等主流多模态模型,VideoWorld 系列工作在业界首次实现无需依赖语言模型,即可认知世界。
OpenAI的人才地震还在继续!刚刚,前研究副总裁Max Schwarzer宣布离职,这位亲手主导o1、o3和整个GPT-5系列post-training的核心人物,选择加入Anthropic,重返一线RL研究。
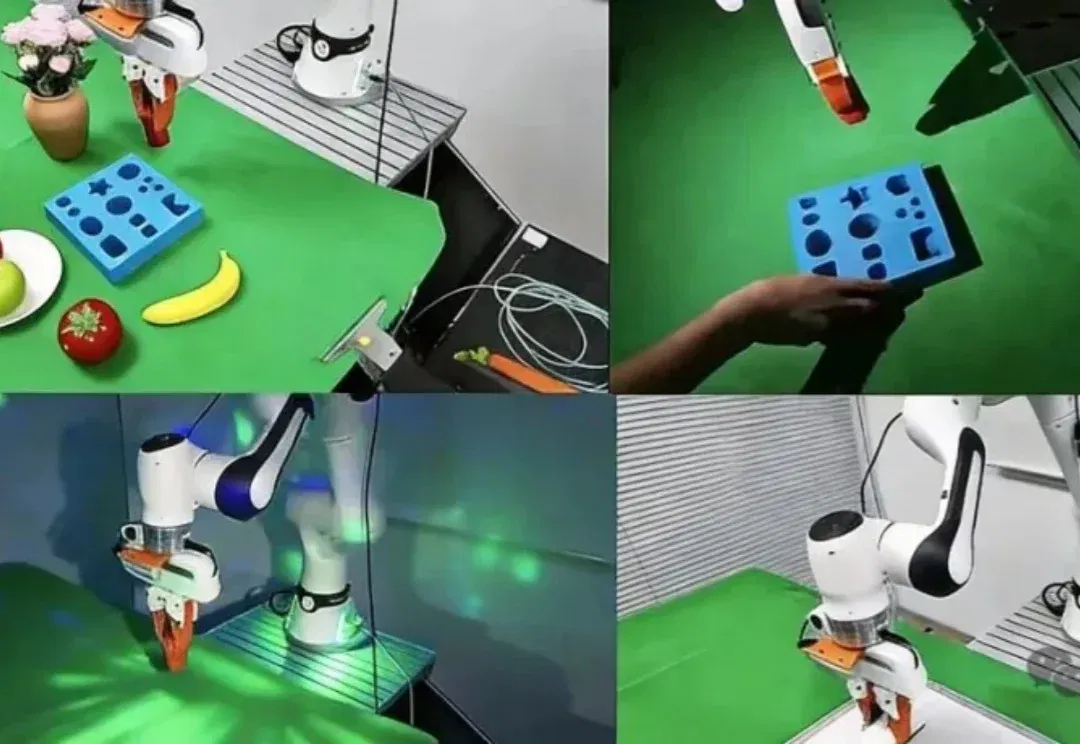
TwinRL用手机扫一遍场景构建数字孪生,让机器人先在数字孪生里大胆探索、精准试错,再回到真机20分钟跑满全桌面100%成功率——比现有方法快30%,人类干预减少一半以上。
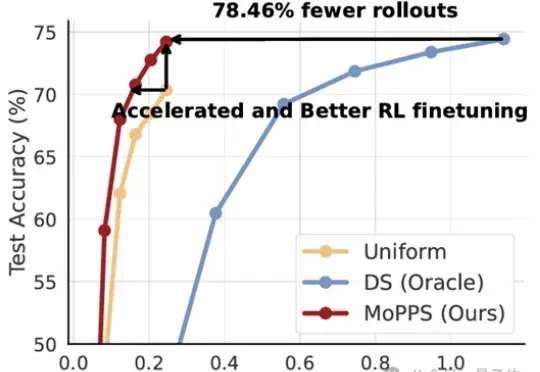
以DeepSeek R1为代表的一系列基于强化学习(RLVR)微调的工作,显著提升了大语言模型的推理能力。但在这股浪潮背后,强化微调的代价却高得惊人。
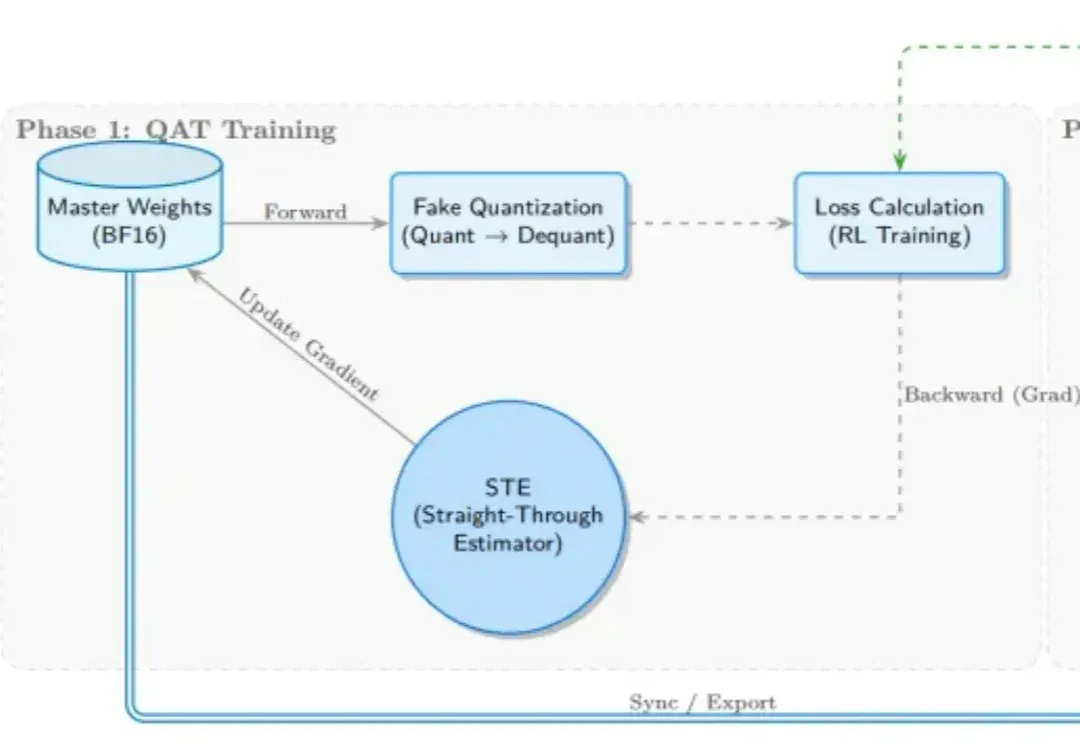
受 Kimi K2 团队启发,SGLang RL 团队成功落地了 INT4 量化感知训练(QAT) 流程方案。通过 “训练端伪量化 + 推理端真实量化(W4A16)” 的方案组合,我们实现了媲美 BF16 全精度训练的稳定性与训推一致性,