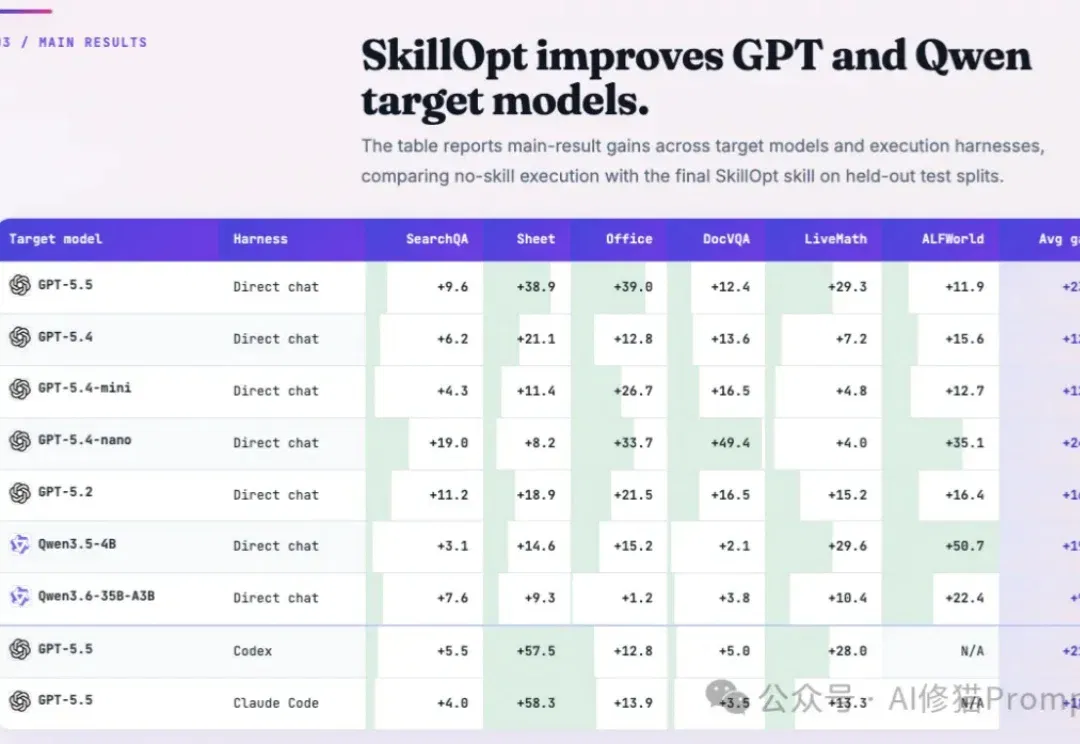
微软最新提出SkillOpt,用训练大模型的方法优化你的Agent Skills(在新窗口打开)
训练大模型时,工程师绝对不会指望网络做一次前向传播就能收敛。它需要数据喂养、Batch切分、学习率控制、验证集筛选以及优化器状态的迭代试错。
共 160 篇
训练大模型时,工程师绝对不会指望网络做一次前向传播就能收敛。它需要数据喂养、Batch切分、学习率控制、验证集筛选以及优化器状态的迭代试错。
Claude Mythos就用6.1×10²⁷ FLOPs提前叩响了奇点的大门。
在上午 11 点开始的英伟达 GTC Taibei 2026 大会现场,黄仁勋拿出了英伟达与微软联手打造的 PC 产品。在细数了将近 1 个小时已有成果之后,黄仁勋终于开讲今天的重头戏:一款迄今为止全球性能最强、能效最高的轻薄型 Windows PC。
从大模型的提示词到智能体的 Skills,看着进化了,但又没有完全进化。
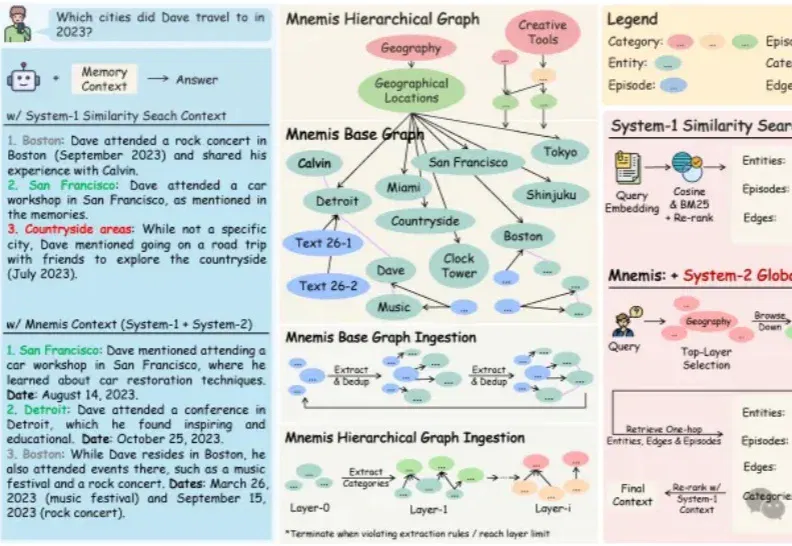
随着大语言模型在各类应用中加速落地,一个核心技术瓶颈日益凸显——AI始终缺乏真正的长期记忆能力。当前主流的RAG(检索增强生成)方案依赖语义相似度检索历史信息,但“语义相似”并不等于“真正相关”,常常出现检索结果不完整、无法区分信息相关性、缺乏推理能力等问题。
扩散模型杀进了文本生成的地盘,而巨头们为了抢它,已经打起来了。
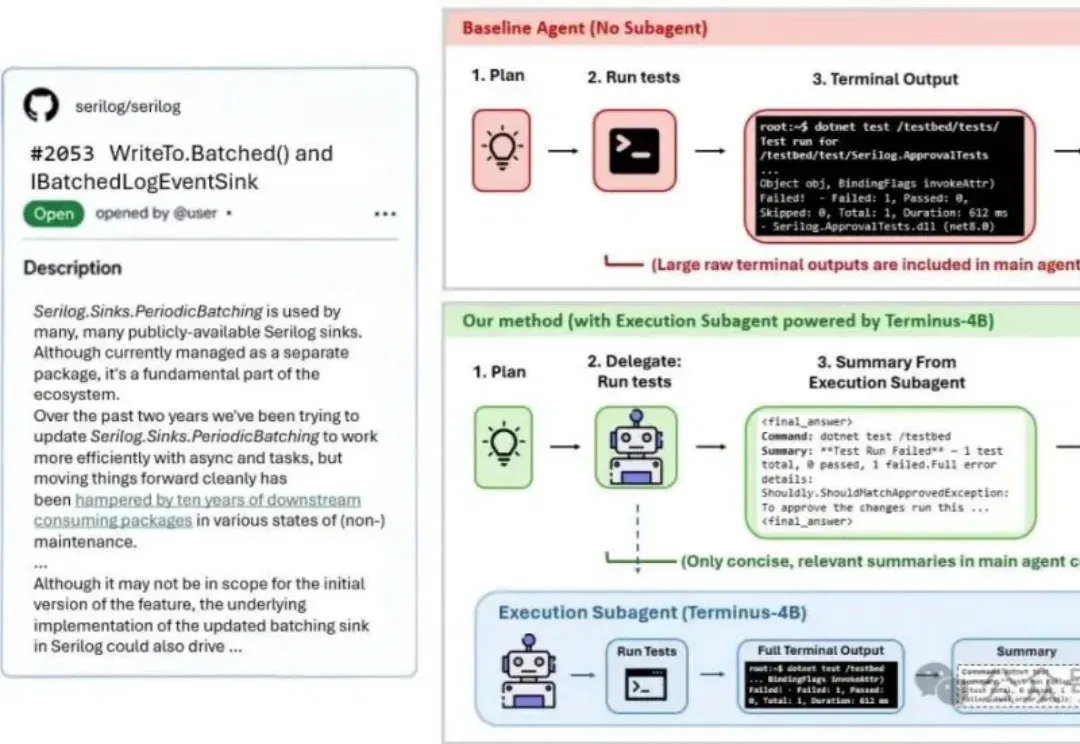
您有没有想过:在代码Agent里,执行终端命令、跑测试、读报错、总结日志这种任务,用Claude Opus、Claude Sonnet、GPT-5.3-Codex这类昂贵Token的大模型来执行,是不是有点浪费?一定要这么做吗?
世纪庭审将进入第三周,纳德拉出庭。 智东西5月12日消息,今天,马斯克诉奥尔特曼案进入第三周,被告方关键证人相继出庭,微软CEO萨提亚·纳德拉(Satya Nadella)、OpenAI联合创始人兼前首席科学家伊利亚·苏茨克维(Ilya Sutskever),以及OpenAI基金会董事会主席布雷特·泰勒(Bret Taylor)作证。 ▲纳德拉(左)抵达联邦法院(图源:彭博社) 此前第二周庭审中,马斯克方主导举证,OpenAI前CTO米拉·穆拉蒂(Mira Murati)、前董事海伦·托纳(Helen Toner)、塔莎·麦考利(Tasha McCauley)、前员工罗茜·坎贝尔(Rosie
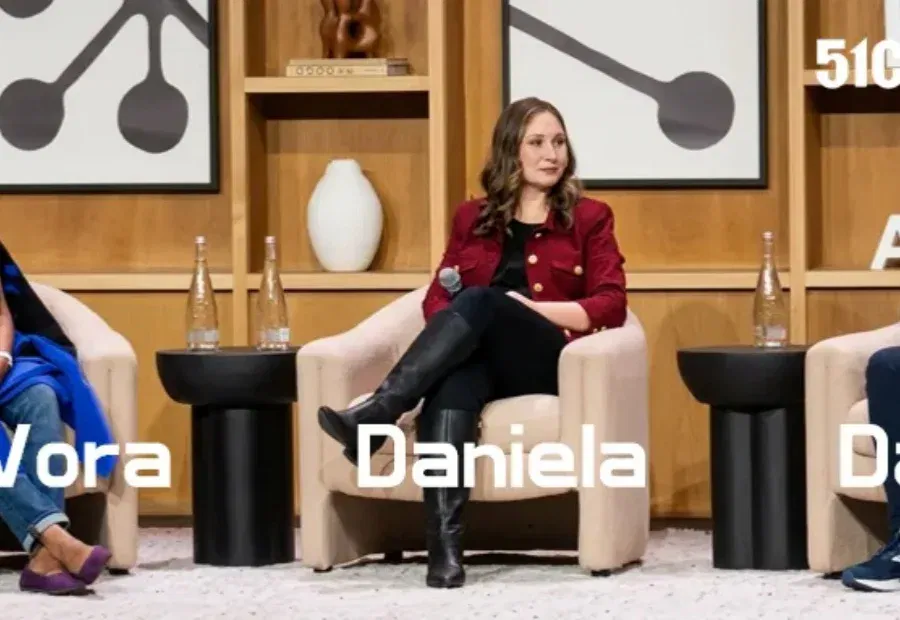
就在上周,旧金山“Code with Claude”开发者大会上,Anthropic CEO Dario Amodei 和 总裁 Daniela Amodei 兄妹二人同台对话。主持人 Ami Vora 是 Anthropic 的首席产品官,曾任职于微软、Meta。
2026年4月,Khan TED Institute正式进入公众视野。该项目计划以约一万美元的成本,探索一种面向AI时代的新型高等教育路径,并邀请谷歌、微软、麦肯锡等全球知名企业共同参与课程与能力体系设计,试图将教育与未来真实工作世界更紧密地连接起来。