只有0.9B的PaddleOCR-VL,却是现在最强的OCR模型。(在新窗口打开)
整个Hugging Face的趋势版里,前4有3个OCR,甚至Qwen3-VL-8B也能干OCR的活,说一句全员OCR真的不过分。然后在我上一篇讲DeepSeek-OCR文章的评论区里,有很多朋友都在把DeepSeek-OCR跟PaddleOCR-VL做对比,也有很多人都在问,能不能再解读一下百度那个OCR模型(也就是PaddleOCR-VL)。
共 45 篇
整个Hugging Face的趋势版里,前4有3个OCR,甚至Qwen3-VL-8B也能干OCR的活,说一句全员OCR真的不过分。然后在我上一篇讲DeepSeek-OCR文章的评论区里,有很多朋友都在把DeepSeek-OCR跟PaddleOCR-VL做对比,也有很多人都在问,能不能再解读一下百度那个OCR模型(也就是PaddleOCR-VL)。
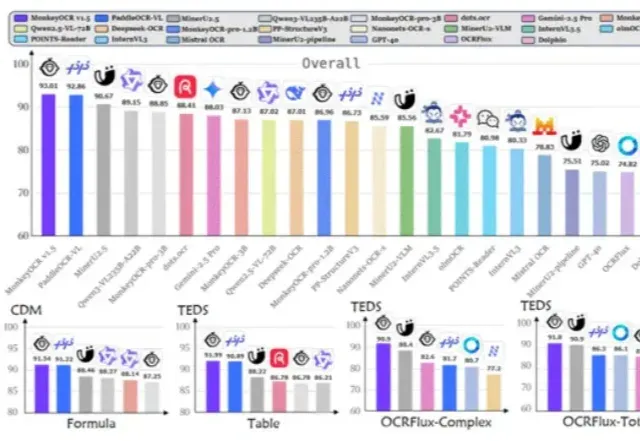
是金山派来的猴子,复杂文档解析有救了! 2025年6月以来,多模态文档解析领域迎来新一轮研究热潮,该方向逐渐成为多模态理解及大模型数据来源的重要前沿课题。 在数字化办公与AI技术深度融合的今天,文档智能解析技术已成为信息抽取、检索增强生成和自动化文档分析的核心基石。然而,现实世界中的文档往往布局复杂、表格嵌套、内含图片公式,甚至跨页分布,这让许多现有的OCR(光学字符识别系统,Optical Character Recognition)系统感到棘手。 MonkeyOCR v1.5是一个全新的统一视觉-语言文档解析框架。它在全能多模态文档解析基准OmniDocBench v1.5,OCRFlux
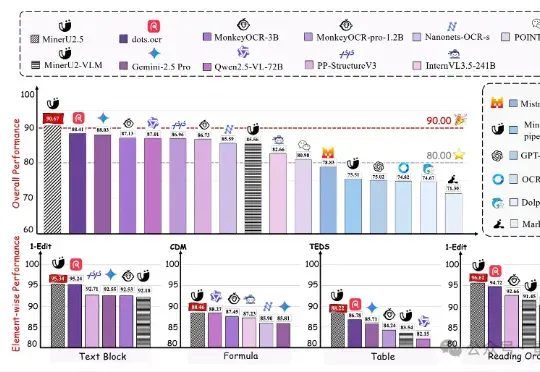
上海人工智能实验室发布新一代文档解析大模型——MinerU2.5。作为MinerU系列最新成果,该模型仅以1.2B参数规模,就在OmniDocBench、olmOCR-bench、Ocean-OCR等权威评测上,全面超越Gemini2.5-Pro、GPT-4o、Qwen2.5-VL-72B等主流通用大模型,以及dots.ocr、MonkeyOCR、PP-StructureV3等专业文档解析工具。
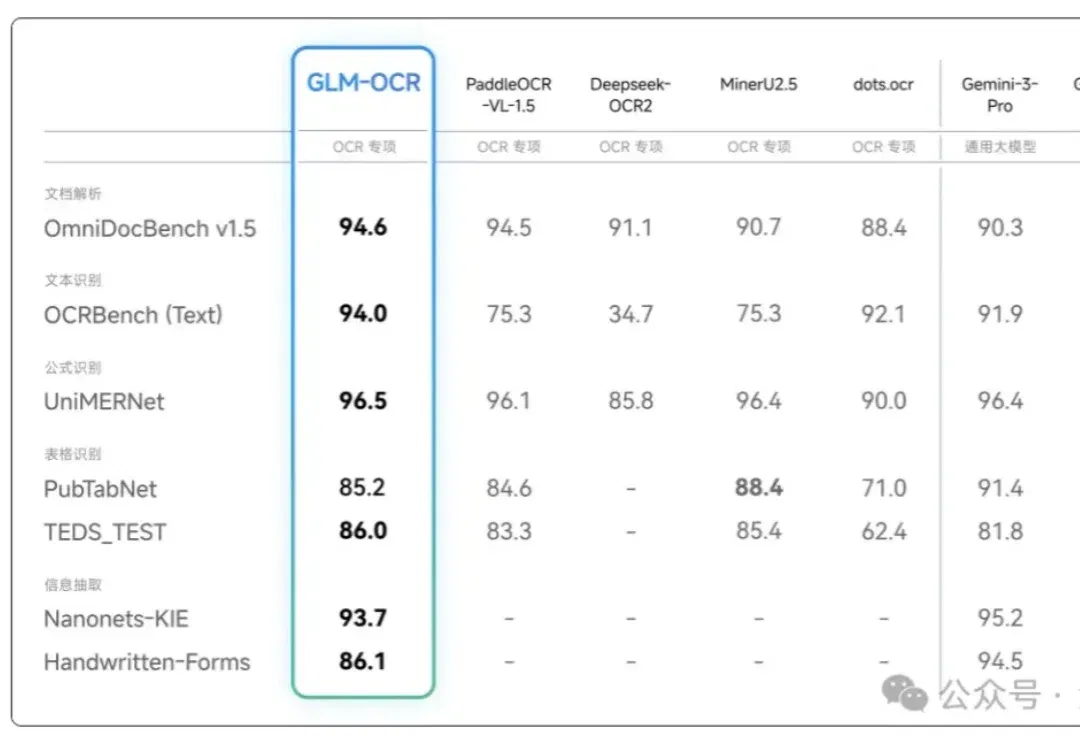
OCR模型究竟能干什么?干得怎么样? 2025年末2026年年初,科技圈最卷的技术无疑就是——O!C!R! 这不,就在前两天,智谱也下场整活儿了,发布了自家的「GLM-OCR」开源模型~ 别看参数就0.9B,在OmniDocBench V1.5榜单上可是一通乱杀。 拳打Gemini-3-Pro!脚踢GPT5.2!(开玩笑 在手写体、代码文档、印章识别、跨单元格等场景的性能表现直通SOTA: 这两天处于工作的原因,我也深度上手使用了GLM-OCR一番,这波用下来的感受是: 在日常基础文档解析场景里用起来确实爽爽爽! but,涉及到字迹不清晰或复杂排版的信息时,翻车现象还是有的…… 顺带,帮友友们
前不久我写了一篇百度最新的OCR模型(PaddleOCR-VL)的文章反响还不错。
近期,DeepSeek-OCR提出了“Vision as Context Compression”的新思路,然而它主要研究的是通过模型的OCR能力,用图片压缩文档。
Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。
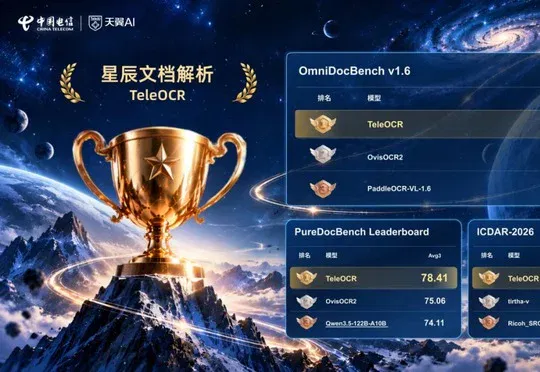
中国电信星辰通用人工智能实验室推出的轻量化文档解析模型TeleOCR(约1.2B参数)凭借形变感知学习、多边形版面分割、CGDP采样及内容—结构解耦等技术创新,在OmniDocBench v1.6、Wild-OmniDocBench、PureDocBench等多个公开榜单取得领先,并在ICDAR 2026 Sci-ImageMiner挑战赛中夺冠,目前已开源。
大模型再强,也读不懂你公司那一柜子的合同、发票和扫描件。在"纸张世界"和"LLM世界"之间,缺一座桥——而百度开源的 PaddleOCR,可能就是当下最稳的那座。
嘿!刚刚,DeepSeek 又更新了!这次是更新了十月份推出的 DeepSeek-OCR 模型。刚刚发布的 DeepSeek-OCR 2 通过引入 DeepEncoder V2 架构,实现了视觉编码从「固定扫描」向「语义推理」的范式转变!