马卡龙的下注:把模型后训练,做成企业服务 (opens in a new tab)
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
Total 289 articles
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。

一周之内大语言、图片、视频模型都迎来新赛季:OpenAI的GPT-6 Astra让编码 Agent更好地使用游戏引擎和Blender,自己改场景、自己跑、自己测;GPT-image-2.5上线,更快更强,图片编辑和关键帧动画显著提升;fal和Yoroll分别发布 H3 MaxTurbo和H3 Superfast后训练加速模型,5秒视频3秒内推理,实时生成和互动玩法纷纷涌现。
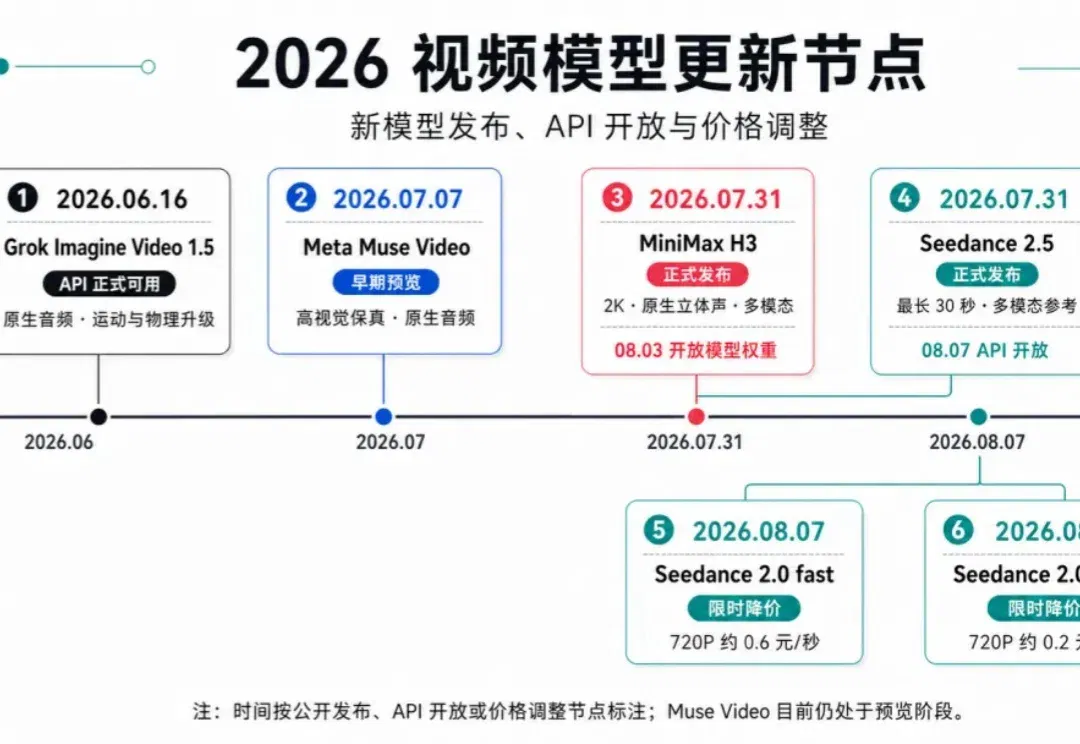
大家好,这里是K姐。 一个帮助你把AI真正用起来的女子。 友友们,最近的视频模型更新得有点凶。 字节家的 Seedance 2.5 正式开放 API,最长可以生成 30 秒视频,最多接收 50 个图片、视频、音频和文本参考;Seedance 2.0 fast、Seedance 2.0 mini 降价,直接把 720P 视频的成本压到了 0.6 元/秒和 0.2 元/秒左右。 当然这波更新也不只有 Seedance。MiniMax H3、Meta Muse Video、Grok Imagine Video 都是最近更新的,视频生成继续往长时长、原生音频和多模态参考方向走。 模型越多,普通创作者越
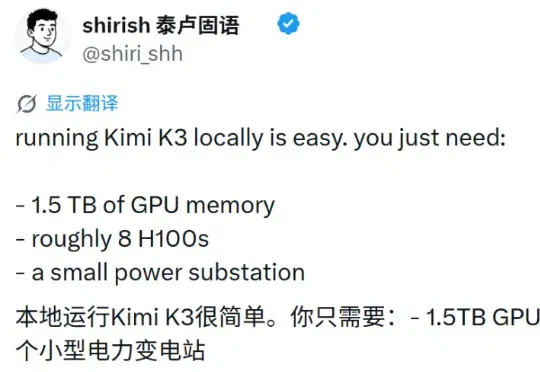
有人总结,运行 Kimi K3 其实很容易,只需要 1.5TB GPU 内存、大约 8 张 H100,以及一座小型变电站。一名开发者拿出一台 128GB 统一内存的 M5 Max,直接加载 Kimi K3 发布在 Hugging Face 上的官方 MXFP4 权重。
2026年7月,Spectro Cloud完成超过1亿美元D轮融资,估值跨过10亿美元。Goldman Sachs Alternatives继续领投,AMD、Ericsson、LG Technology Ventures和美国政府服务商Maximus一同入场。这家公司没有制造芯片,也不训练大模型。它处理的是一件更加琐碎、却让许多企业头疼的事:GPU买回来以后,怎样真正用起来。
这是葬AI起号以来工作量最大的一篇文章。为了严肃评测国产模型的能力,我自研了一个Benchmark,完整测试了智谱、Qwen、Kimi、Minimax、Deepseek这些最新国产模型,还引入了境外势力Claude作对照组。
把 Agent 从单体,组成一支可以协作的 Agent Teams。
大厂员工为 token 而疯狂。 最近,硅谷兴起一种新的「炫耀性消费」,称为 tokenmaxxing(token 最大化)。 它将 token 使用量转变为生产力基准,以及衡量谁最具「AI 原生」特质的竞争指标。 员工们不断优化提示词、编程会话,并同时运行多个 AI Agent,以攀登公司内部排名,在 AI 加速替代传统编程等岗位职能的焦虑背景下,用消耗量来证明自己无可取代。 这其中的典型代表就是 Meta。 Meta 员工疯狂刷 Token 据 the information 报道,Meta 内部最近玩起一种新游戏,看谁烧掉的 AI token 最多。 公司内网上,一名员工自发搭建了一个名
3月24日,Anthropic宣布Claude引入“Computer Use”能力,在Claude Cowork和Claude Code中,Claude可以直接操作用户的Mac电脑:打开文件、使用浏览器、运行开发工具,无需任何配置。该功能以研究预览版形式向Pro和Max订阅用户开放。
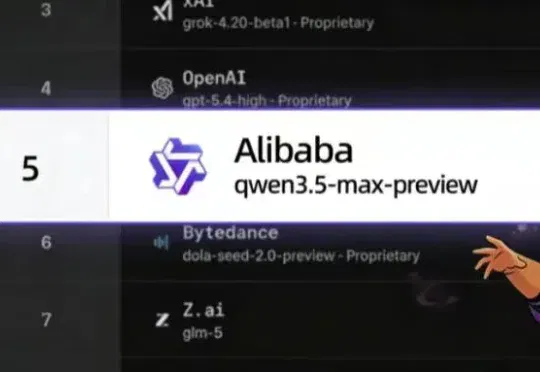
今日,阿里千问最新旗舰模型预览版Qwen3.5-Max-Preview正式亮相,并登上全球大模型评测平台LMArena。在最新榜单中,该模型拿下1464分,进入第一梯队,同时带动阿里千问跻身全球大模型实验室前五、国内第一。