马卡龙的下注:把模型后训练,做成企业服务
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
马卡龙(准确说叫 Mind Lab)在版本理解上,一直是非常领先的。而今天,马卡龙正式发布了Mint Recursive:定位面向企业的模型后训练与推理平台,以托管服务的方式提供模型的训练与部署能力
马卡龙作为可能是目前国内最典型的 neo lab,具体是做了这些:
- 从大模型后训练研究出发,建起 MinT 等底层系统
- 用这套系统完成 Macaron V1.1 的训练与迭代
- 现在把内部训练链路整理为 Mint Recursive,对企业开放
至于想法,则是这么一个判断:企业会需要符合自身业务标准、能够持续更新的模型版本,围绕它的训练、部署和迭代,也会成为一项持续服务
因自身需求,而搭起训练底座
要让企业持续训练自己的模型版本,首先得把成本降下来,负担得起
Mind Lab 有一款自己的应用,叫做马卡龙。在最早的时候,Mind Lab 为了能够给用户提供更好的长期记忆能力,便围绕着这个产品进行了一系列的后训练和部署
在 2025 年。Mind Lab 开始在 Kimi K2 等大模型上做后训练,并完成基础设施建设,在 64 张 H800 上运行万亿参数模型 LoRA 强化学习的实践(NVIDIA 还对此有所报道)
在这里面,团队要解决跨 GPU 的分片、通信和显存问题,也要让不同客户的训练任务共享资源而互不干扰。于是,MinT 等底层系统把不同任务的 LoRA、梯度、优化器状态和模型版本隔离管理,同时共享常驻基座与算力
作为结果:在相同资源配置下,三个独立的 Qwen3-4B 强化学习任务从依次执行改为共享并发,总完成时间从约 3081 秒降到 1736 秒,峰值显存不变,通过更高的资源利用率,为小批量 LoRA 训练共享常驻基座、按用量提供服务打下工程基础
训练 Macaron V1.1
Macaron V1.1 这个模型,是以 744B 的 GLM-5.3 为基座后训练而来,为 Chat、Agent、Coding 和生成式 UI 分别训练四个 2B LoRA 专家,最终尺寸为 752B
而在这个训练的过程中,数据、训练、测试、部署连成自动化流程均由 Mint Recursive 所为,并构建了一条模型自迭代的管线:
π₀ →〔观测 → 归因 → 干预 → 验证〕ⁿ → πₙ
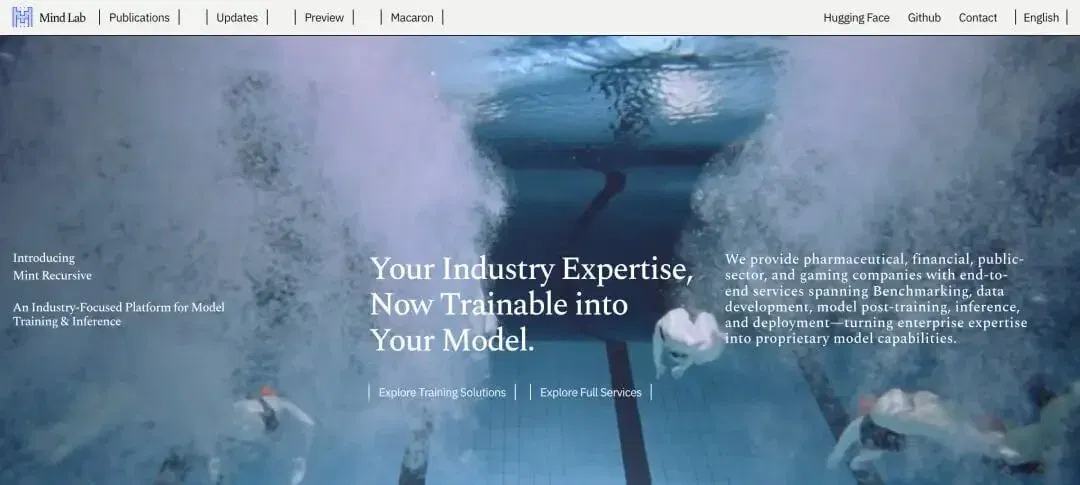
模型分析自己的表现,针对能力缺口合成和筛选数据,发起训练与评估,再根据新结果决定下一轮怎么改,不断轮回
在后训练的过程中,有一项执行的发票核对任务:原邮件金额为 12,340.50 美元,财务负责人随后在 Slack 更正为 11,340.50 美元;旧模型漏读更正,按旧金额入账。模型回看执行轨迹,把失败归为写入前缺少核对。团队先用规则对照测试这个判断,再生成示范“查证更正、写入明细、核对汇总”的训练数据。V1.1 随后找到更正并更新了记录,验证看的是实际入账结果
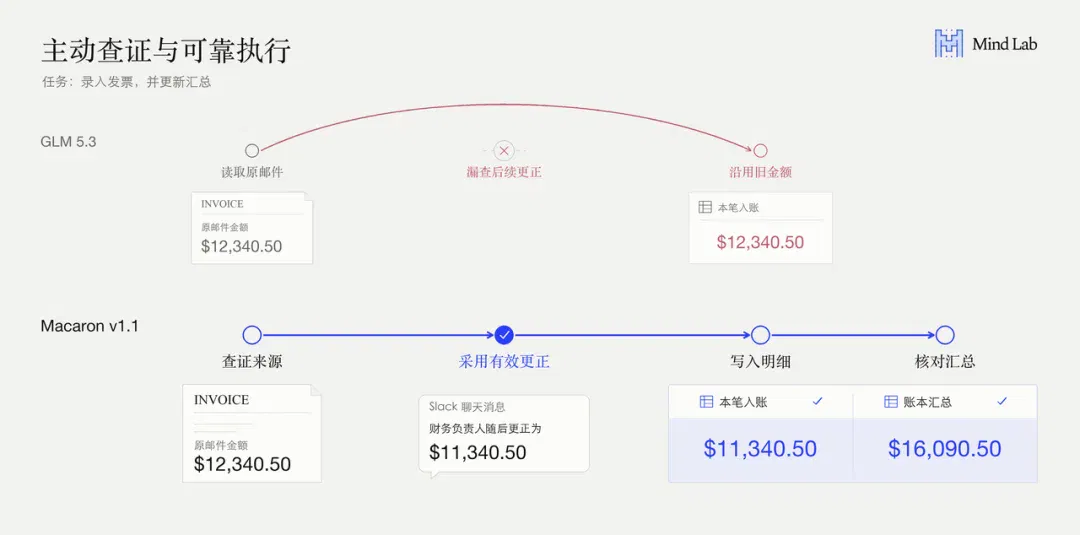
发票任务中核对 Slack 更正并更新记录的前后对照
这种归因也用在开放任务里。比如在 Chat 模式中,用户已经表示想先待一会儿,模型继续追问,团队就把“及时停止”变成具体的训练目标。生成式 UI 中,供应商对比页面算对了价格,却没让人直接看出低单价与高起订量之间的取舍;模型据此提出补充比较关系更清楚的页面样本,训练后的版本改用并排图表
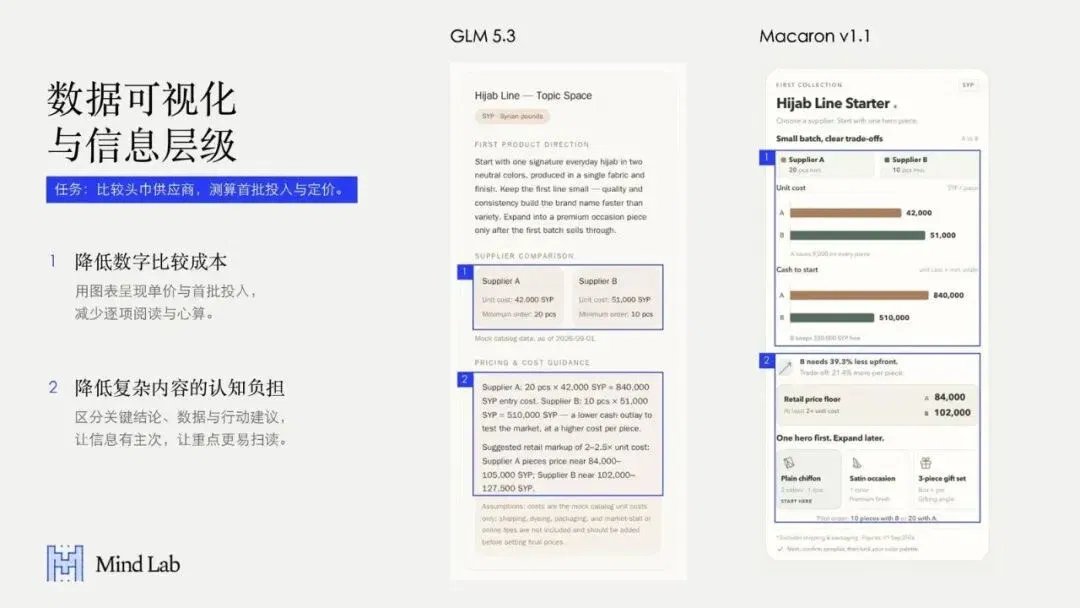
供应商比较页面的前后对照
在完成一系列后训练后,在同一组 60 题 UI4A 任务里,GLM-5.3 首次交付成功 43 题,Macaron V1.1 成功 58 题。这说明给定任务和评测标准内的首次交付表现有所改善;真实新任务能否持续带来下一版能力,还要继续验证
把内部能力开放
从马卡龙自己的长期记忆需求出发,Mind Lab 已经把评测、数据、后训练和部署接进同一套系统。V1.1 是这套系统最新的一次内部实践;今天发布 Mint Recursive,则是把它整理为企业能直接使用的托管服务
Mind Lab 发现,其他团队也有类似需求:先定义业务 Benchmark,再整理或生成训练数据,发起后训练,对比前后表现,部署新版本,并把线上反馈接入下一轮。Mint Recursive 把这几步留在同一个平台
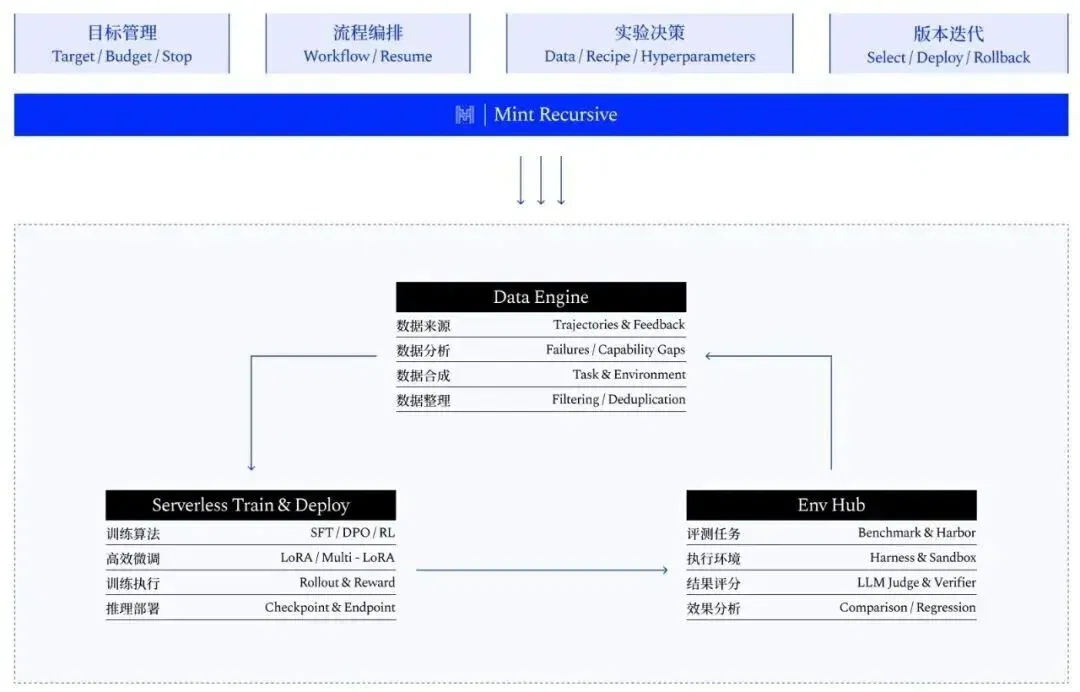
Mint Recursive 将训练部署、评测环境与数据连接成一套系统
目前平台支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座,以及监督微调、强化学习、全参数训练和 LoRA。企业可以通过 API、Python SDK 自己控制数据和训练方法,也可以与 Mind Lab 专家共同训练,或在设定目标、预算和约束后让平台运行迭代。训练记录、模型版本和推理部署留在同一处,便于比较、上线和回退
这里的“拥有”不是说每家企业都要自研基座,而是拥有自己的任务数据、评测标准和基座上的 LoRA 版本,让业务经验在一轮轮训练中沉淀下来
最后
马卡龙总是能够提前半步看到爆发点,下注在非共识之所,故而行业里有句古话(???):质疑马卡龙,理解马卡龙,成为马卡龙,超越马卡龙
Macaron V1.1 展示了这套系统如何训练出新版本;Mint Recursive 则把能力开放给企业。
马卡龙的下注,正是让企业也能持续迭代自己的模型
文章来自于微信公众号 “赛博禅心”,作者 “赛博禅心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
两周一次迭代,1000美元起,这家公司想让后训练“人人可用” (opens in a new tab)
最近几个月,后训练成了 AI 行业最集中的议题。
梁文锋押注的方向,中国00后团队先交卷了!性能直逼Opus 4.8 (opens in a new tab)
上周AI圈都在讨论一件事,但大多数人只看到了一半。
爆改GLM-5.2!全球首款200万上下文混合LoRA开源,外挂四大专家彻底治愈技能冲突 (opens in a new tab)
最近手头在测一个新模型,叫 Macaron-V1。说实话一开始没抱太大期待,打着「个人智能体」旗号的产品这两年太多了,大多数打开之后还是那套老配方:一个聊天机器人,外面挂几个插件。但测了三四天下来,发现这个模型的思路跟我预想的不太一样,值得认真写一篇。
Macaron 新版本拆解:三个信号,看懂 Personal AI 的进化路径 (opens in a new tab)
最近刷到了 Macaron 发布的一条技术视频。
刚刚,Mind Lab开源V1系列模型Preview,749B参数,专为Agent 后训练 (opens in a new tab)
过去一个多月,大模型圈依旧热闹。从 GPT-5.5、DeepSeek V4 到 Claude Opus 4.8,后训练正在成为模型能力提升的关键引擎。