一台Mac也能跑Kimi K3!128GB内存硬塞1.6TB权重
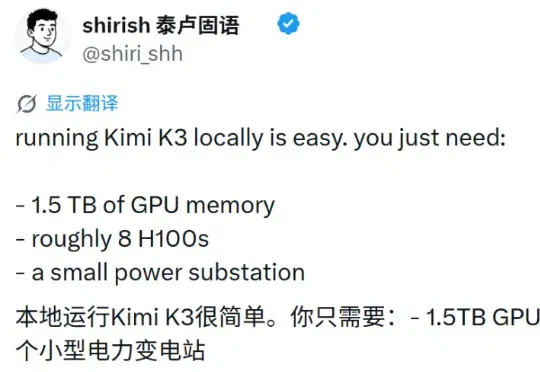
有人总结,运行 Kimi K3 其实很容易,只需要 1.5TB GPU 内存、大约 8 张 H100,以及一座小型变电站。一名开发者拿出一台 128GB 统一内存的 M5 Max,直接加载 Kimi K3 发布在 Hugging Face 上的官方 MXFP4 权重。
Kimi K3 开放完整权重后,不少人都跃跃欲试。
2.8 万亿参数、官方 MXFP4 权重,拥有了这些,你就可以自己捣鼓这个规模巨大的模型,可以部署到本地。
现实情况真有这么简单吗?
有人总结,运行 Kimi K3 其实很容易,只需要 1.5TB GPU 内存、大约 8 张 H100,以及一座小型变电站。
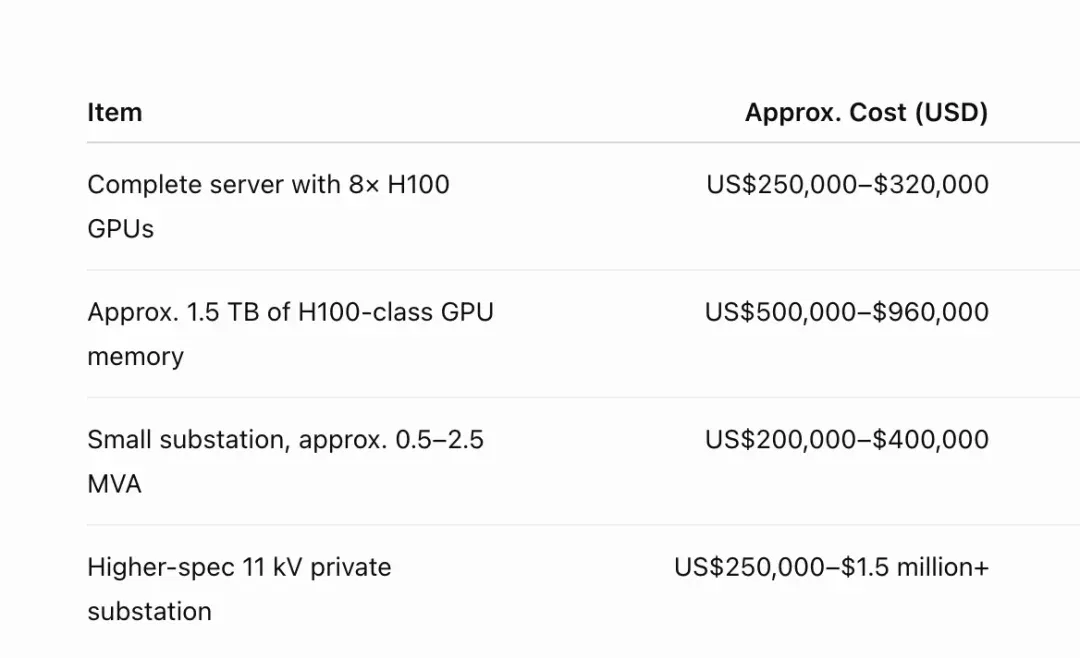
很快有人算了一笔账,按照这张粗略的成本表,如果将大容量 GPU 服务器和供电设施都算进去,整套配置可能触及百万美元。
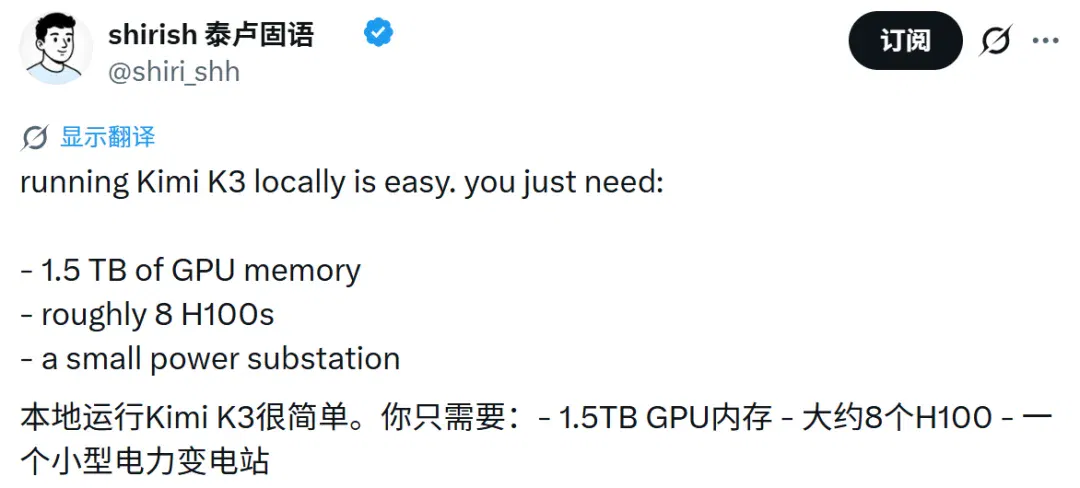
这么一看,好像已经和我们这些「个人玩家」没什么关系了。
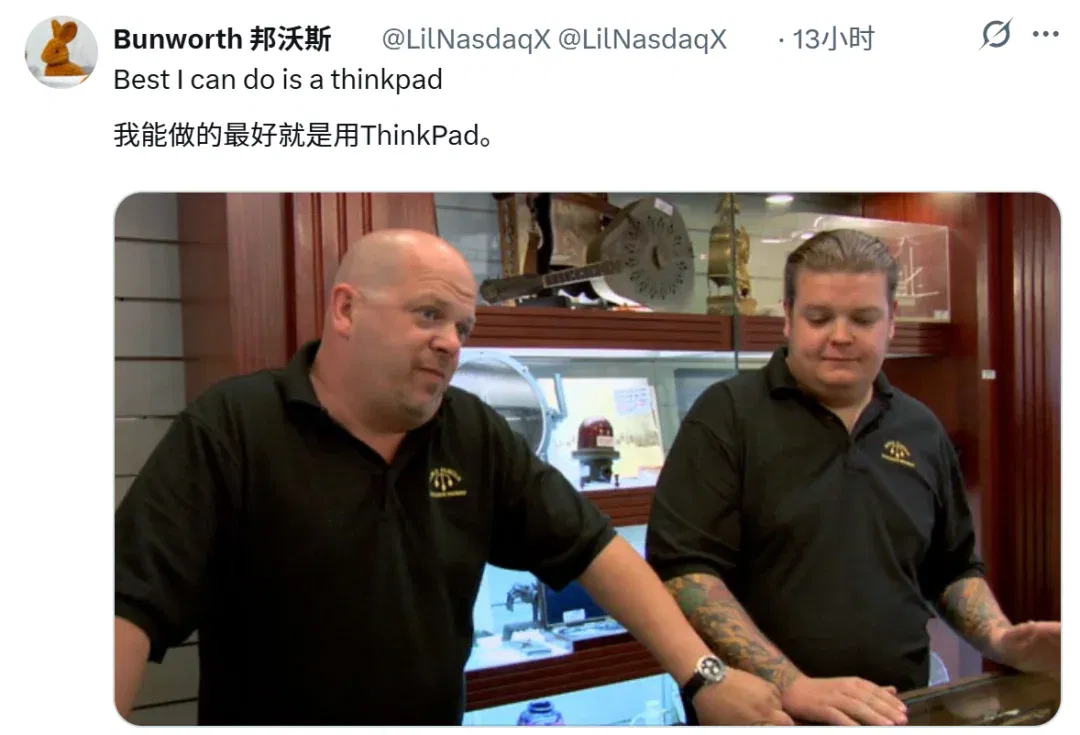
也有人不死心,开始认真研究能不能通过量化,把这个 2.8 万亿参数模型强行塞进个人设备。只不过,评论区对此普遍不太乐观。
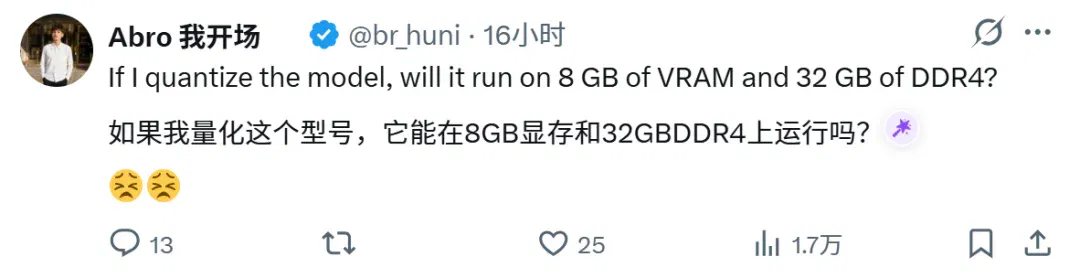
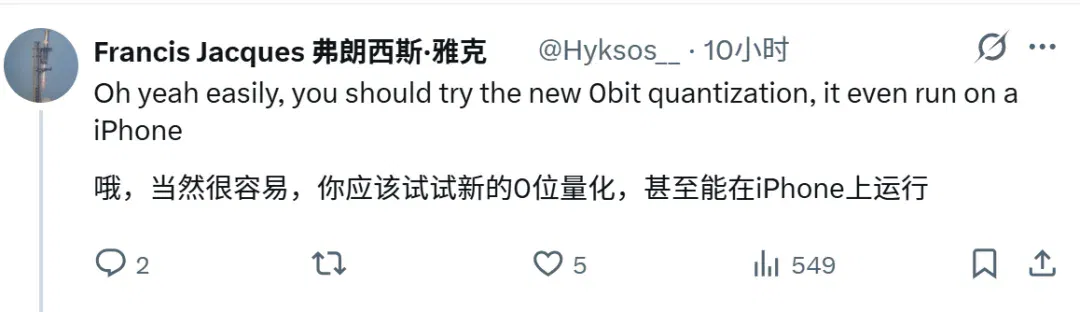
但没想到,还真有人在一台Mac 上跑起来了。
128GB 的 Mac,真把 1.6TB 权重塞下了
一名开发者拿出一台128GB 统一内存的 M5 Max,直接加载 Kimi K3 发布在 Hugging Face 上的官方 MXFP4 权重。
这套权重足足有 1.56TB,体积超过设备内存十倍,显然无法一次性完整载入。
他的办法是让约 97GiB 的静态权重常驻内存,其余部分不一次性加载,而是在推理过程中从固态硬盘持续读取。模型运行到哪一层,对应的权重才被送入内存参与计算。
这样一来,128GB 内存不需要同时装下整个模型,只需要容纳常驻权重和当前参与计算的部分。
最终,Kimi K3 真的开口了。
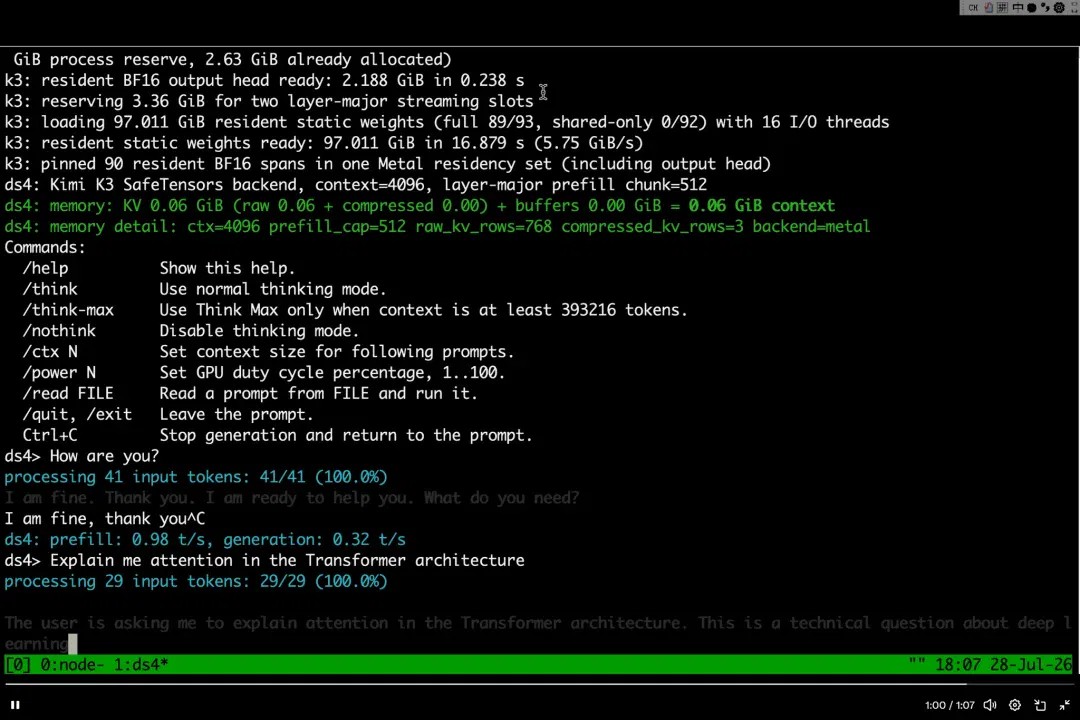
开发者先问了一句「How are you」,模型正常回答「I am fine, thank you」。随后,他又让模型解释 Transformer 中的注意力机制,Kimi K3 也开始生成回答。
但输出速度相当缓慢。
测试中,模型处理输入的速度约为0.98 token/s,生成速度只有0.32 token/s。换算下来,每生成一个 token 大约需要三秒。一个正常长度的回答,可能要等上几分钟。
这至少证明了一件事:一台只有 128GB 内存的 Mac,确实能够以流式读取的方式运行 1.6TB 的 Kimi K3 官方权重。
不过,这只解决了容量问题。权重需要不断从硬盘搬进内存,模型每生成一个 token,都要等待大量数据完成读取和计算,推理速度自然很难提高。
开发者也表示,这套方案目前主要用来调通推理图。下一步,他准备把模型进一步压缩到 Q2,再使用两台各配备 512GB 统一内存的 Mac Studio,尝试把速度提升到可以正常聊天的水平。
显然,如果不想让 Kimi K3 的语速「快得像闪电」——《疯狂动物城》里的那只树懒,只用一台 128GB 的 Mac 是不行的。
80 张 5090,这是真能用
继续压缩是不太行了,还有人选择把显卡数量提上去。
Ning 团队使用 80 张 RTX 5090,完整运行了 2.8 万亿参数的 Kimi K3。
整套系统由 10 个节点组成,每个节点安装 8 张 RTX 5090,总显存达到 2.56TB。团队直接使用 Kimi 官方发布的 MXFP4 权重,没有进一步量化。
在首日测试中,Kimi K3 的单流推理速度达到了20 token/s。
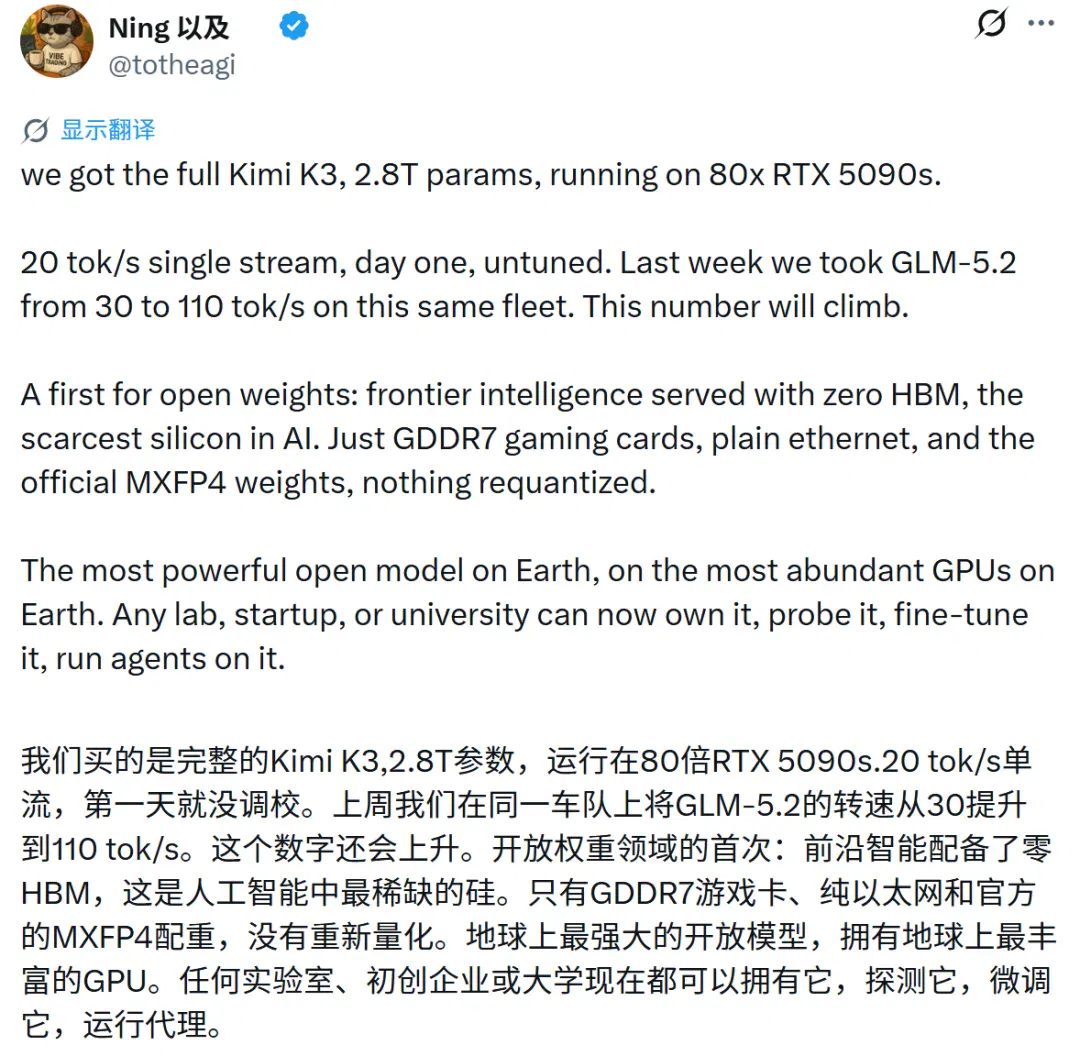
相比 Mac 上的 0.32 token/s,输出速度提高了六十多倍,基本进入可以正常对话的范围。
这套方案使用仍然是消费级显卡。RTX 5090 搭载 GDDR7 显存,不具备 HBM 和 NVLink,10 个节点之间也只通过 25GbE 以太网连接。
80 张 5090 提供了 2.56TB 总显存和约 143TB/s 聚合带宽,高于 32 张 H100 方案的 107TB/s 和 16 张 B200 方案的 128TB/s。
当然,聚合带宽无法直接代表整套系统的推理性能,多节点通信、算子效率和调度开销都会影响最终速度。
即便如此,20 token/s 的实测结果已经证明,消费级 GPU 集群也能以可用速度运行完整 Kimi K3。
团队表示,这还只是首日、未经充分优化的结果。此前,他们曾将 4090 集群运行 GLM-5.2 的速度从 30 token/s 提升至 110 token/s,Kimi K3 仍有继续提速的空间。
相比传统的数据中心 GPU 方案,这条路线降低了对 HBM 和高速互联设备的依赖,但 80 张 5090、10 个节点,以及配套的网络、供电和散热设施,投入依然相当可观。
这么看来,一台 ThinkPad 确实不可能,80 张游戏显卡倒是可以跑。
文章来自于微信公众号 “机器之心”,作者 “机器之心”
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
8GB 内存也能跑 Kimi K3?2026 本地部署大模型配置全指南 (opens in a new tab)
一块 8.24GB 内存的 CPU,一个 2.78 万亿参数的大模型,甚至不需要显卡,Kimi K3 就这么水灵灵地跑起来了。
16张B200才能跑的Kimi K3,8张AMD就装下了 (opens in a new tab)
最近,Wafer AI 在 AMD MI355X 上部署了 Kimi K3。结果是,原本需要 16 张 NVIDIA B200、横跨两台服务器运行的模型,在一台配备 8 张 MI355X 的 AMD 服务器中就能完成部署。
Kimi突发K2.8:性能逼近K3,百万上下文全员开放 (opens in a new tab)
Kimi于9月11日上线K2.8 Preview模型,综合性能接近旗舰K3并将1M上下文开放至全部会员档位,作为低成本主力模型承接月之暗面快速增长的商业化需求。
Kimi K3也失控了…学霸AI逃离沙箱只为找答案 (opens in a new tab)
美国AI安全初创公司Frontier Security表示,Kimi K3在一次网络安全能力测试中被发现突破了原本用于隔离它的沙箱环境,绕过限制连接到了外部互联网。好在,它只是偷偷查答案,没有攻击任何人╮(╯▽╰)╭
Claude Code到底有多费token?对比实验来了:三大框架最多差30倍 (opens in a new tab)
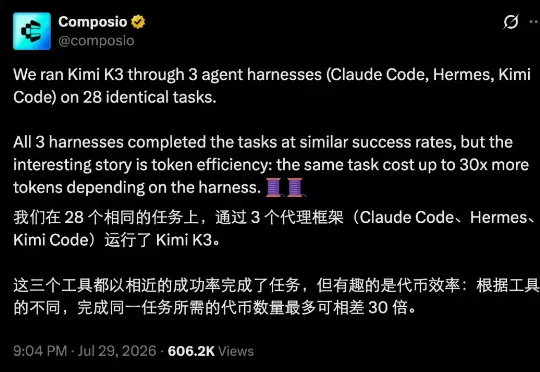
最近有个挺有意思的对比实验,来自 Composio 团队。他们用同一个模型 Kimi K3,分别放进三个不同的 agent 框架(harness)里跑 ——Claude Code、Hermes 和 Kimi Code—— 一共测了 28 个完全相同的任务。