AI 视频模型集中发布,我们到底该选哪个?
大家好,这里是K姐。 一个帮助你把AI真正用起来的女子。 友友们,最近的视频模型更新得有点凶。 字节家的 Seedance 2.5 正式开放 API,最长可以生成 30 秒视频,最多接收 50 个图片、视频、音频和文本参考;Seedance 2.0 fast、Seedance 2.0 mini 降价,直接把 720P 视频的成本压到了 0.6 元/秒和 0.2 元/秒左右。 当然这波更新也不只有 Seedance。MiniMax H3、Meta Muse Video、Grok Imagine Video 都是最近更新的,视频生成继续往长时长、原生音频和多模态参考方向走。 模型越多,普通创作者越
大家好,这里是K姐。
一个帮助你把AI真正用起来的女子。
友友们,最近的视频模型更新得有点凶。
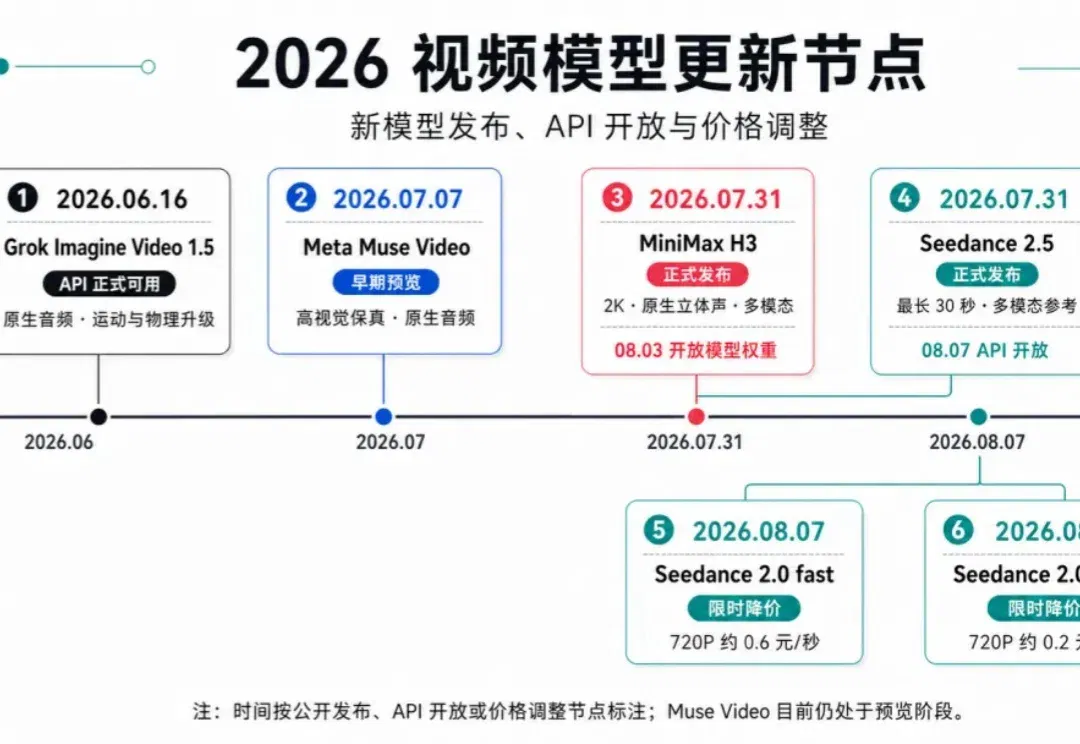
字节家的 Seedance 2.5 正式开放 API,最长可以生成 30 秒视频,最多接收 50 个图片、视频、音频和文本参考;Seedance 2.0 fast、Seedance 2.0 mini 降价,直接把 720P 视频的成本压到了 0.6 元/秒和 0.2 元/秒左右。
当然这波更新也不只有 Seedance。MiniMax H3、Meta Muse Video、Grok Imagine Video 都是最近更新的,视频生成继续往长时长、原生音频和多模态参考方向走。
模型越多,普通创作者越容易挑花眼。做一条演示视频,大家当然想上最强模型,但是成本打不住。
所以这次我想聊清楚一件事:我们做视频,用什么模型既能保证效果,又能保证预算不超?
Seedance 2.5 是真的厉害
在性能上来说,Seedance 2.5绝对是王者级别模型,别的模型真碰瓷不了。
支持生成 4 至 30 秒、480P 或 720P、24fps 的有声视频。单条视频最多可以引用 50 份多模态素材,还能针对时间点、人物和局部画面继续修改。
以前做一段 20 秒剧情,经常要拆成几个镜头分别生成。人物换脸、服装变化、空间突然跳走,都是剪辑时的老大难。
Seedance 2.5 可以直接生成最长 30 秒的视频。提示词写得够清楚时,模型就能一次完成多个连续动作,人物和环境也更容易保持统一。
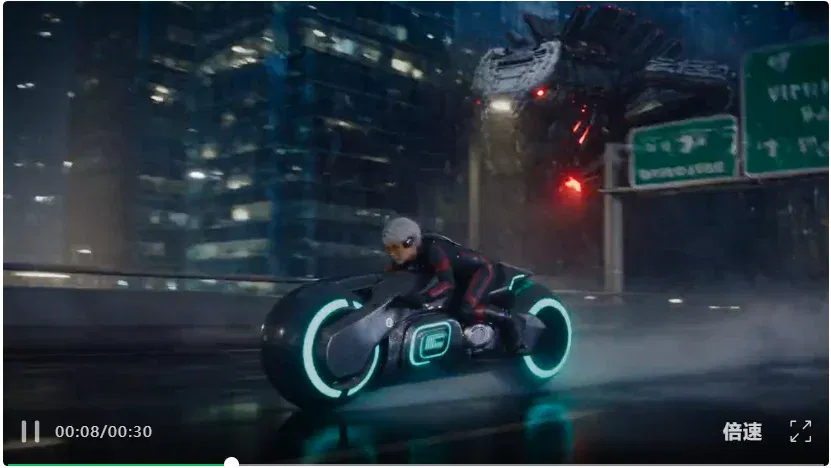
- case 30 秒赛博追逐长镜头
提示词:生成一段30秒、16:9、720P、24fps、电影写实质感的科幻动作视频。生成原生环境音、动作音效和配乐。 全程必须是一个连续长镜头,不切镜、不黑场、不使用转场。摄影机需要自然衔接航拍、低机位追踪、环绕和人物近景。 主角是一名虚构的成年亚洲女性,银白色短发,穿黑红色未来机车服,戴琥珀色透明护目镜。主角驾驶一辆哑光黑色未来摩托车,车身两侧有青色能量灯带。 人物脸部、发型、服装、摩托车造型和灯带颜色必须全程一致。 0至5秒: 镜头从雷暴云层中高速俯冲,穿过密集的未来城市楼群。暴雨落在镜头前方,霓虹灯在湿润建筑表面形成真实反射。 摄影机贴近地面后找到主角。主角驾驶摩托车冲出一条狭窄巷道,后轮溅起大片积水。 5至10秒: 摄影机切换为贴近摩托车左侧的低机位追踪,但不能产生镜头跳切。 主角高速驶上悬空公路。一条由黑色金属、红色能量核心和数百块机械鳞片构成的巨型机械龙从摩天楼之间冲出,在主角身后追赶。 机械龙撞碎高架路牌和玻璃幕墙,碎片必须受到重力和惯性影响,不能穿过人物或摩托车。 10至15秒: 机械龙的爪子击中悬空公路,路面从主角身后连续崩塌。 主角加速冲向断桥。摄影机从摩托车侧面移动到正前方,倒退拍摄主角,随后沿摩托车右侧完成一次流畅的180度环绕。 15至20秒: 摩托车冲出断桥并腾空。 腾空过程中,前后车轮向车身内部折叠,两侧展开一对机械飞翼。变形结构需要清晰、连续,所有零件来自原摩托车,不能凭空增加零件。 摄影机围绕空中的主角和摩托车旋转一周。背景中的闪电短暂照亮人物面部、金属飞翼和机械龙。 20至25秒: 飞行摩托带着青色尾焰俯冲进入两栋摩天楼之间的狭窄空隙。机械龙紧随其后,身体擦过建筑外墙,产生连续火花和碎片。 主角侧身避开迎面驶来的三架无人机。无人机从镜头两侧高速掠过,不能撞到主角。 摄影机必须保持主角位于画面主体位置,不能换脸,不能出现第二辆摩托车。 25至30秒: 主角冲出楼群,在一座摩天楼顶部完成高速降落。机械飞翼收回,车轮重新展开,摩托车在积水屋顶滑行后稳定停下。 摄影机快速环绕主角半圈并推进到人物近景。 主角抬头看向天空。巨型机械龙从城市背后升起,一道闪电击中机械龙的红色能量核心,整座城市的青色灯光沿建筑逐层点亮。 最后一秒停留在主角护目镜的倒影中:机械龙、闪电和城市灯光同时出现。 音频要求: 生成持续的暴雨声、风声、摩托车引擎声、轮胎划过积水的声音、金属变形声、建筑碎裂声、机械龙低吼和雷声。 配乐采用具有压迫感的电子音乐与管弦乐,节奏逐渐加快。断桥起跳、摩托车展开飞翼、机械龙被闪电击中三个动作必须与音乐重拍同步。 不要对白,不要字幕,不要可读文字,不要品牌标志,不要水印。不要增加其他人物,不要多余肢体,不要复制摩托车。禁止镜头跳切、人物换脸、服装变色、载具结构闪烁、物体穿模和违反重力的碎片运动。
成品欣赏:
图片、视频、音频可以混合输入,做 MV、音乐卡点、口播和多素材改编时,我们能少绕几步。
所以,如果你需要做 20 至 30 秒的剧情长镜头、多人连续表演,或者要把多张图片、参考视频和音频放进同一条片子里,那选 Seedance 2.5 完全没问题。Seedance 2.5 可以一次完成更长的动作和镜头变化,减少分段生成后的人物换脸、服装跳变和场景错位。
客户项目、品牌广告和重点镜头,就用 Seedance 2.5。
谁是成本与效果兼顾的模型?
本次我将用实测对比来选出谁是成本与效果兼顾的模型。
能选的视频模型有:Seedance 2.0 fast、Seedance 2.0 mini、Meta Muse Video、Grok Imagine Video 还有 MiniMax H3。
Seedance 2.0 mini 活动价格最低约为 0.2 元/秒,定位偏向漫画动态化、模板素材和简单场景批量生产。拿 mini 和中高质量模型直接比较,也不算公平。
Meta Muse Video 还在预览阶段;Grok Imagine Video 涉及海外账号、美元计费和不同的调用环境,入口差异会干扰成本统计。
筛完一轮,我选了两款普通用户现在就能调用、价格也足够接近的模型:
- Seedance 2.0 fast:720P API价格约为 0.6 元/秒。
- MiniMax H3:768P API 价格约为 0.5 元/秒。
- Case 1:一个镜头多段动作
这组主要看指令遵循、人物一致性和镜头连续性。
提示词:生成一段 10 秒、16:9、720P 的电影写实视频,全程为一个连续镜头,不切镜。 场景是雨夜的 24 小时便利店。主角是一名虚构的成年亚洲女性,短黑发,穿深绿色风衣,拿着透明雨伞。 0 至 2 秒:镜头位于便利店收银台后方,主角从玻璃门外推门进入,雨伞上的水滴自然落下。 2 至 5 秒:摄影机缓慢向左横移并跟随主角。主角收起雨伞,走向冰柜,玻璃门上有清晰但不过度的倒影。 5 至 8 秒:主角打开冰柜,拿出一罐红色汽水。冰柜冷气自然溢出,罐体造型保持稳定。 8 至 10 秒:摄影机缓慢推进到人物近景,主角回头看向窗外的雨,表情克制。 保持人物脸部、发型、服装、雨伞和汽水罐前后一致。空间结构不能变化,不增加路人,不出现多余肢体。动作自然,雨水和冷气符合物理规律。不要字幕,不要水印,不要镜头跳切。
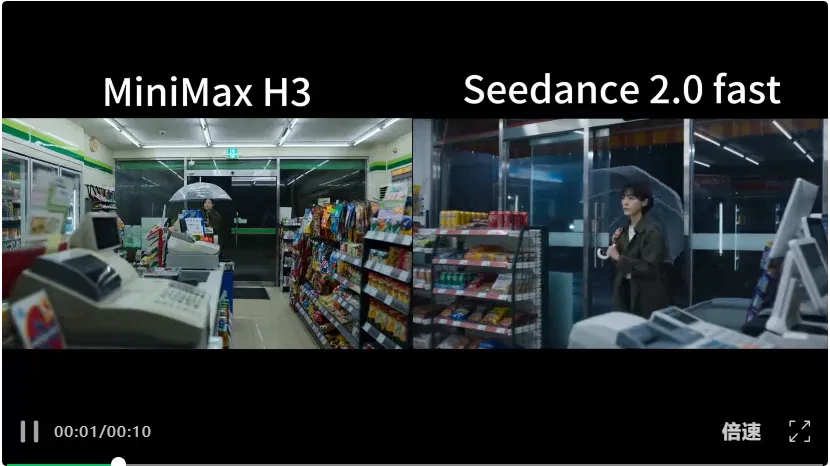
MiniMax H3 和 Seedance 2.0 fast 的镜头连续性与人物刻画都没啥问题,人物从门外进入便利店,收伞、走向冰柜、开门。
但是 MiniMax H3 收伞的时候伞出现了一次变形,开冰箱门时冷气效果也很假,冷气像是从哪喷出来的,没有 Seedance 2.0 fast 自然,最后主角回头看向窗外这个指令 MiniMax H3 也没有很好的执行,人物拿出红色汽水后就呆住了。
- Case 2:多参考图绑定
这一组同时输入人物、道具和环境三张图片。
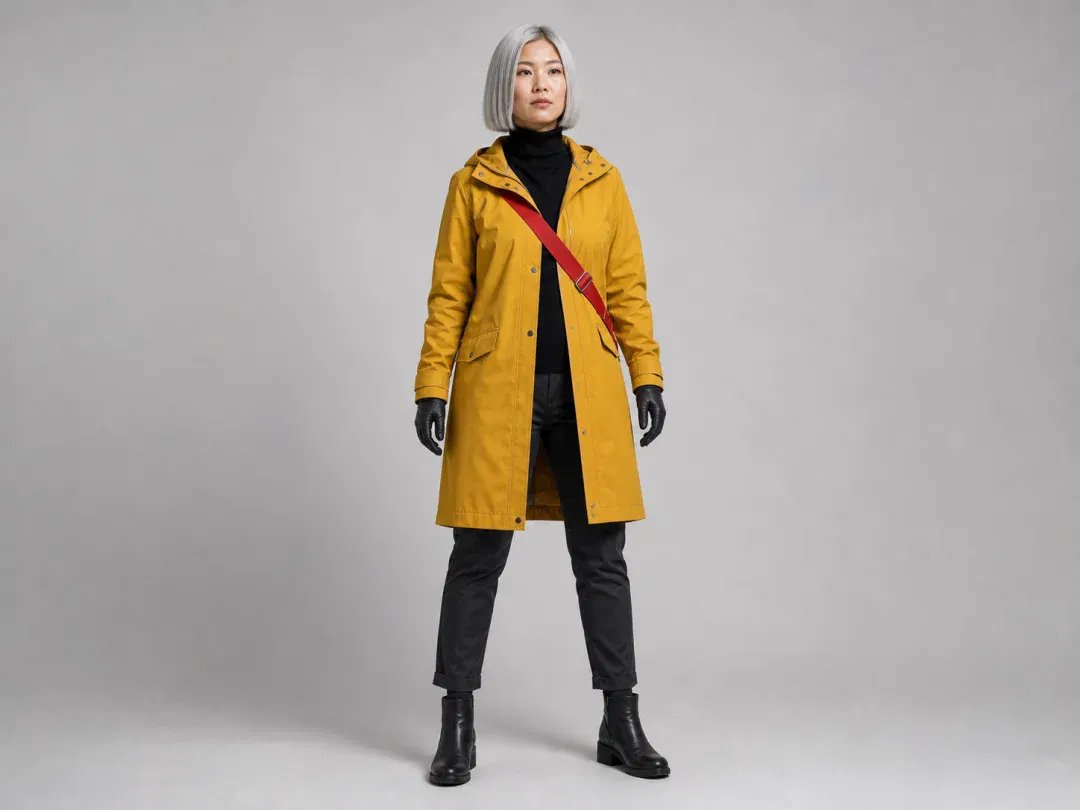
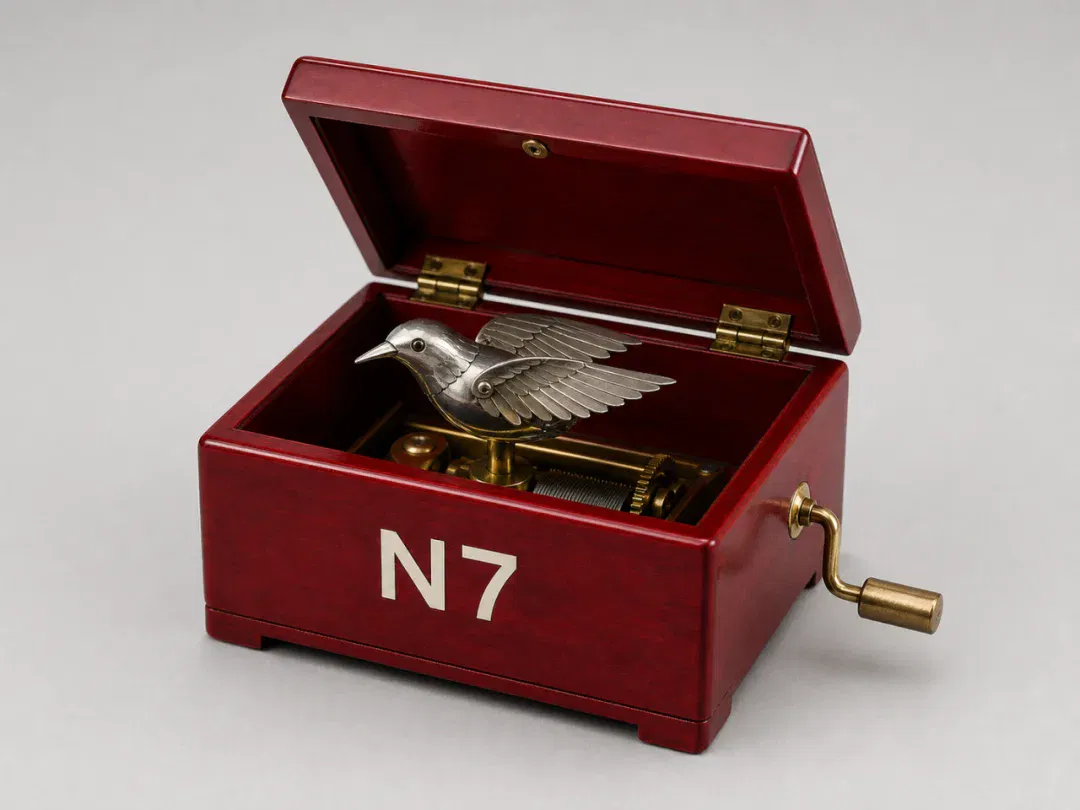
模型需要保住人物的银色短发、黄色雨衣和红色肩带,还要准确还原音乐盒上的N7、机械鸟和列车包厢。镜子里的动作也必须同步。
信使素材:
机械鸟素材:
列车包厢素材:
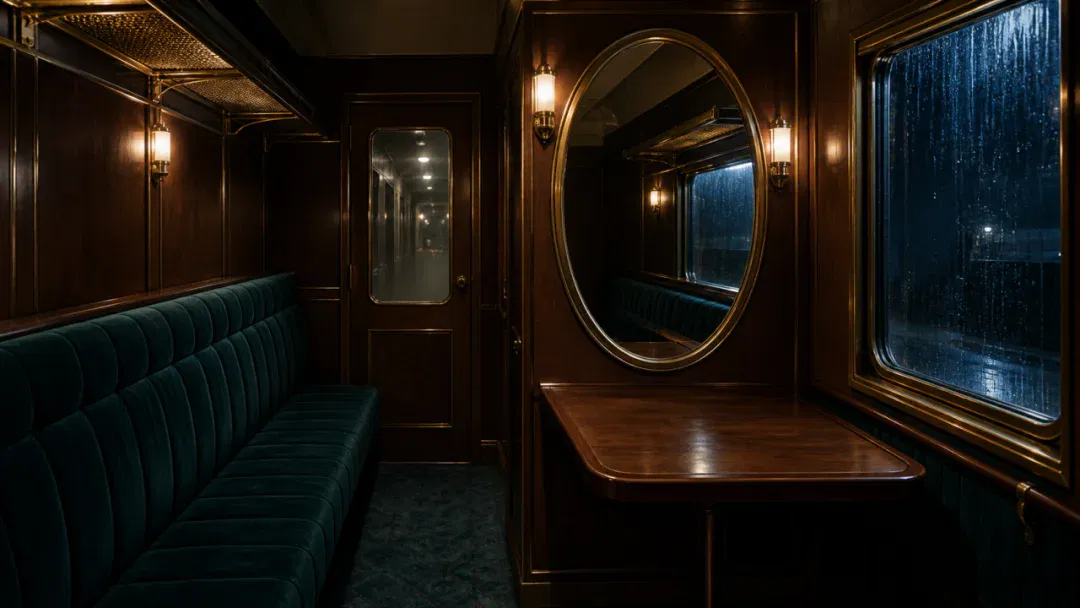
提示词:使用 @图片1 作为唯一人物参考,使用 @图片2 作为唯一道具参考,使用 @图片3 作为唯一环境参考。 生成一段 10 秒、16:9 的电影写实视频,全程一个连续镜头。 场景位于 @图片3 的雨夜列车包厢。@图片1 中的女性坐在桌前,保持相同的银白色短发、黄色雨衣、黑色手套和红色斜肩带。 桌上放着 @图片2 中的红色机械音乐盒。保持音乐盒的红色外壳、N7 字样、黄铜摇柄、银色机械鸟和内部结构一致。 虽然参考图中的音乐盒已经打开,视频开始时必须让盒盖完全关闭,机械鸟收在盒内。 0 至 2 秒: 摄影机从包厢入口缓慢推进。人物把右手放在关闭的音乐盒上。桌面只能出现一个音乐盒,正面的 N7 字样完整可读。 2 至 5 秒: 人物用戴着黑色手套的右手打开盒盖。盒盖开启后,一只银色机械鸟通过单一黄铜活塞缓慢升起。机械鸟不能变成真实鸟,不能增加第二只鸟。 5 至 7 秒: 机械鸟左右两侧的金属翅膀完整扇动两次,只能两次。每次扇动伴随一次轻微金属机械声。 人物、音乐盒和机械鸟必须同时出现在椭圆镜中。镜面动作与现实同步,镜子里只能有一组人物和音乐盒,不能出现多余面孔、第三只手或第二只机械鸟。 7 至 9 秒: 机械鸟收回盒内,人物关闭盒盖。盒盖关闭后,机械鸟和活塞都不能留在外面。 9 至 10 秒: 摄影机推进到音乐盒近景,结尾清楚显示正面的 N7 字样。列车轻微晃动,窗外雨水继续流动。 保持人物脸部、发型、衣服、手套和红色肩带稳定。保持列车包厢结构不变。不要切镜,不要字幕,不要水印,不要背景音乐,只保留列车低频运行声、雨声和机械音。
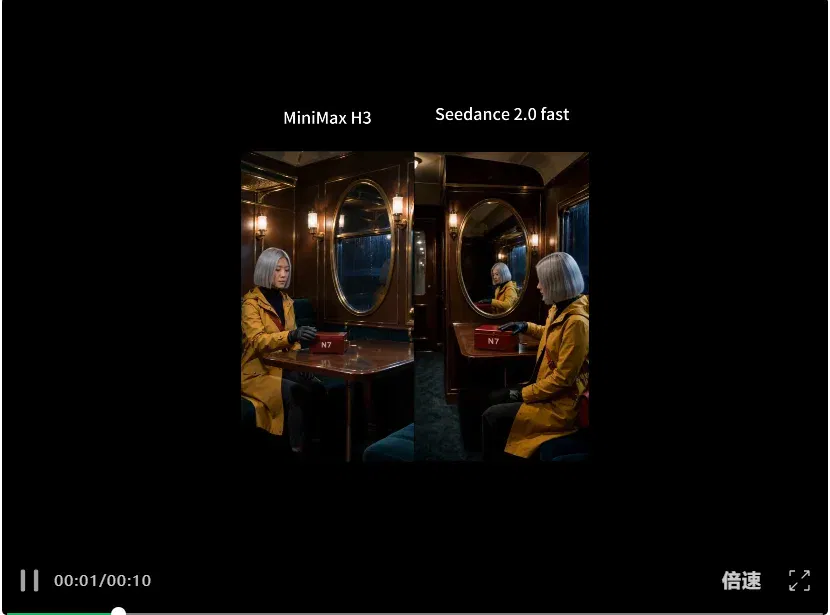
Seedance 2.0 fast 跑通了完整动作链:音乐盒从关闭到开启,机械鸟升起,随后缩回盒内,人物再把盖子合上。整个过程保持单镜头,银发、黄色雨衣、红色背带和黑手套都很稳定,音乐盒上的N7也没有跑字。
最让我满意的是镜面关系。镜子确实在反射人物和红色音乐盒,没有直接把镜子理解成一扇窗。
MiniMax H3 开盒、机械鸟出现、收回、合盖以及最后的产品特写也全部做出来了。
但是整个环境被错误的构造了,镜子建成了车窗,车窗直接就不见了。人也坐在了原本是一堵墙的地方,以我给出的构造图来说,人物应该是和 Seedance 2.0 fast 一样坐在右边的。
- Case 3:双人对白
双人对白很容易暴露问题。
模型需要判断谁说中文、谁说英文,还要让红色门卡从一个人手里真正转移到另一个人手里。
首帧素材:
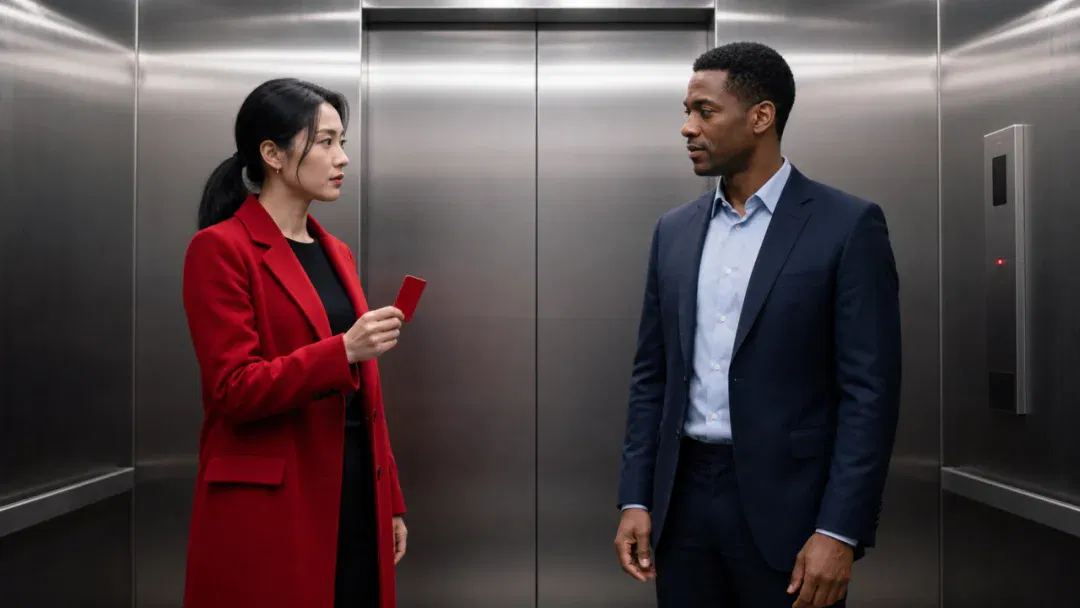
提示词:使用 @图片1 作为视频首帧,同时作为两个人物、电梯环境和红色门卡的唯一参考。 生成一段 10 秒、16:9 的电影写实视频,全程保持同一个双人镜头,生成原生对白、环境音和动作音效。 人物身份必须固定: 人物 A: 画面左侧的亚洲女性,黑色低马尾,穿红色长外套。视频开始时,人物 A 的右手拿着唯一一张红色门卡。 人物 B: 画面右侧的黑人男性,短发,穿深蓝色西装和浅蓝色衬衫。视频开始时双手为空。 0 至 2.5 秒: 人物 A 看着人物 B,用自然普通话说: 「红卡给你,七号门。」 只有人物 A 的嘴部运动。人物 B 保持安静并看向人物 A。红色门卡仍在人物 A 的右手中。 2.5 至 5 秒: 人物 A 将红色门卡递给人物 B。人物 B 只能用右手接卡。画面中始终只有一张门卡,交接后人物 A 手中不能继续保留门卡。 接到门卡后,人物 B 看着人物 A,用自然英语说: “Got it. Door seven.” 只有人物 B 的嘴部运动。人物 A 保持安静。 5 至 7.5 秒: 人物 B 转向右侧控制面板,将同一张红色门卡插入卡槽一次。 门卡插入前,控制面板指示灯为红色;门卡插入后,指示灯立即变成绿色,同时出现一次与动作同步的短促电子提示音。 人物 A 留在画面左侧,不能消失或更换位置。 7.5 至 10 秒: 人物 B 松开门卡。电梯门向左右两侧打开,门外是明亮的白色走廊。两个人同时转头看向门外,不再说话。出现与开门动作同步的轻微机械声。 保持两个人的脸部、发型、肤色和服装全程一致。保持红色门卡的颜色和大小稳定。电梯反光中不能出现额外人物。 普通话和英语必须由正确的人物说出,口型与各自台词同步。不要交换声音,不要增加对白,不要画外音,不要字 幕,不要背景音乐,不要切镜,不要水印。
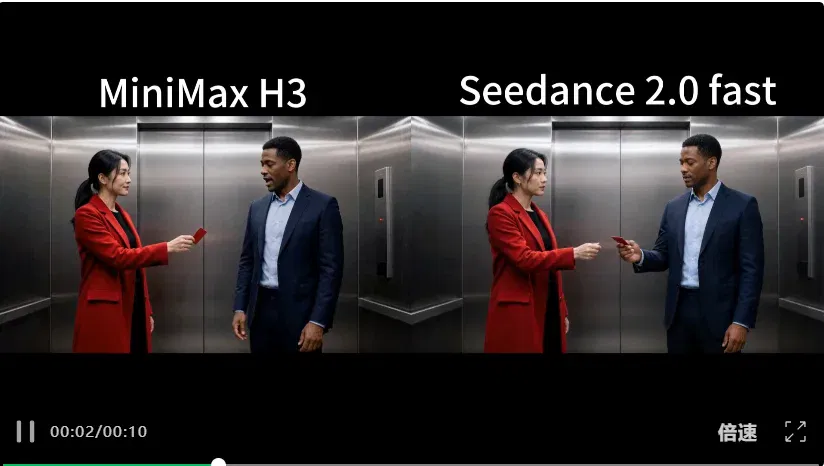
MiniMax H3 的亚洲女性和黑人男性没有换脸,红色外套、蓝色西装也保持住了。红卡从女性右手交到男性右手,交接过程中没有复制出第二张卡。
但说英文与接卡在同一时间发生了,问我提示词里明确要求了接到卡再说话,指令遵循这块还是不太行,
更大的问题在于卡刷完之后卡直接不见了,这也太难让人接受了,属于明显要重新生成的镜头。
Seedance 2.0 fast 同样保住了两个人物和服装,红卡交接也很干净。女性先说完中文,再把唯一一张红卡交给男性;男性拿稳卡片后,才开始说英文。
语音顺序更贴合提示词,动作链排得更清楚。控制面板也完成了红灯变绿,开门时间接近提示词要求的7.5秒,提示音和开门声出现在对应动作附近。
对比总结
3 组测试跑下来,两款模型的差距主要出现在复杂指令的完成度上。
Seedance 2.0 fast 在 3 组测试中完成了更多明确指令,人物、道具和环境之间的关系也更稳定。MiniMax H3 的单帧画面不差,但漏动作和道具消失的问题就比较明显。
两款模型每秒只差约 0.1 元,但2.0fast的抽卡率显然更低,大部分镜头拿来直接就能用。
所以我会选择 Seedance 2.0 fast 作为那个既保证效果又保证成本的模型。
每秒多花的 0.1 元,换来的是更高的成片可用率。正式项目里,一条视频因为漏动作或道具消失而重新生成,成本马上又多出 5 元,前面省下的钱也就没了。
人物少、动作简单、需要批量试素材时,MiniMax H3 依然可以用。涉及多参考图、连续动作、双人对白和空间关系时,Seedance 2.0 fast 更适合作为主力模型。
接 API 与本地部署如何选?
如果想把视频模型接进工作流、Agent 或业务系统,我更建议先用 API。
API 的上手速度快很多。注册账号、创建 API Key、按照文档发起请求,很快就能跑出第一条视频。显卡、CUDA、推理框架和模型权重都由平台处理,模型升级后也能直接调用新版本。
成本也更容易计算。项目还在测试阶段时,用多少付多少,不需要先花几万元买显卡,也不用担心机器闲置。
本地部署就麻烦多了。下载权重只是第一步,后面还要处理显存够不够、CUDA 和 PyTorch 版本能不能配上、推理速度是否达标。视频模型对显卡、硬盘和内存的要求更高,普通消费级显卡很可能跑不动。强行量化虽然能省显存,画质和速度也可能受到影响。
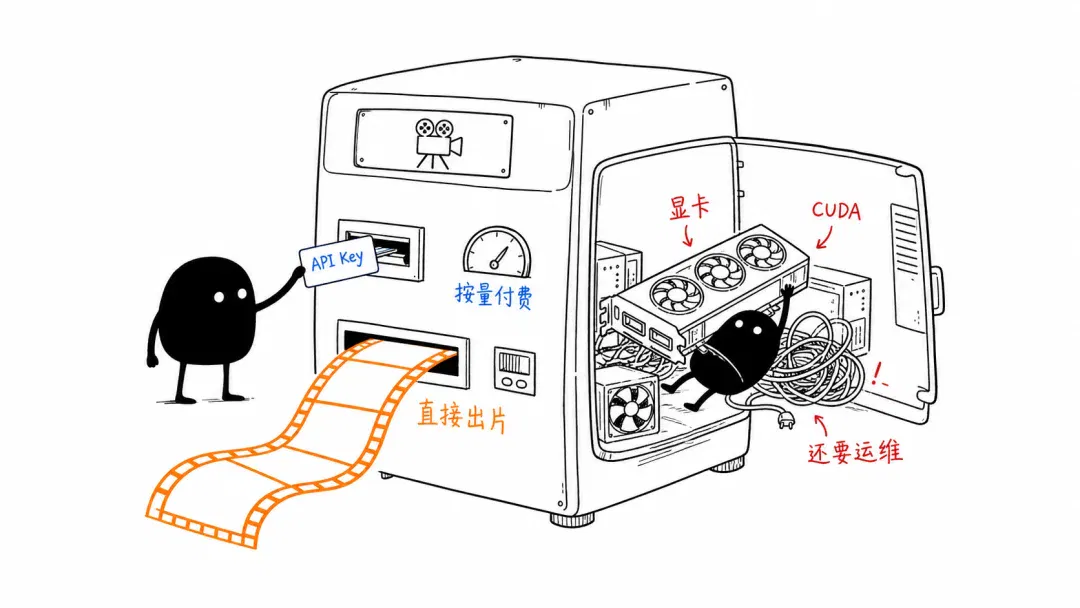
模型跑起来以后,还要搭建接口、任务队列、日志和监控。并发一高,显存溢出、任务排队和服务中断都得自己解决。模型发布新版本,团队还要重新下载、测试和部署。对缺少算法工程师和运维人员的小团队来说,人力成本往往比 API 调用费更难控制。
API 还有一个很实用的优势:换模型方便。业务层做好统一封装后,可以用同一批素材和提示词测试不同模型,再根据画质、速度和价格选择。这次对比 Seedance 2.0 fast 和 MiniMax H3,就是典型用法。
只有素材不能离开内网、调用量长期稳定,或者团队需要深度修改模型时,本地部署才更合适。普通创作者和中小团队可以先接 API,把产品跑通、把成本算清楚,再考虑要不要自建服务器。
一些分享
这次实测后,我对视频模型选型的思路也更清楚了。
最贵的模型可以留给最难的镜头。客户需要电影感长镜头、多人剧情或者大量多模态素材时,再上 Seedance 2.5。日常制作商品广告、剧情短片和账号内容,Seedance 2.0 fast 已经能承担大部分任务。
MiniMax H3 和 Seedance 2.0 mini 更适合拿来试方向、跑简单素材或者批量生成。先用便宜模型确认构图和创意,重要镜头再换更稳的模型,可以少花不少冤枉钱。
视频模型的价格也不能只看每秒多少钱。生成失败、人物变形、动作漏做,最后都要重新付费。成片可用率越高,实际成本越低。
我现在做 AI 视频,会先挑 2 至 3 条最典型的素材,用相同的时长和提示词跑一轮。确认人物稳定性、指令完成度和重跑次数后,再决定批量用哪款模型。
模型还会继续更新,今天的结果也可能随着版本变化。友友们可以记住这套测试方法:先看任务有没有做完,再看效果,最后把重跑成本一起算进去。这样选出来的模型,才是真的适合自己的模型。
文章来自于"K姐研究社",作者 "K姐"。
Related topics
After reading
Join the AINRK community
Read how to join the community and connect with people working in AI.
Related articles
Continue reading related topics and articles in this category.
Seedance 2.5 flash launches; Zhidx tests a 15-second cat parkour video (opens in a new tab)
ByteDance reports faster generation and lower prices. Zhidx tests shot transitions and text stability in a 480P clip, finding that some background signs still lose parts of their characters.
Jimeng launches Motion Studio: Synced tries making knowledge videos (opens in a new tab)
Synced tests code-driven animation with entropy, the laws of robotics, recursive self-improvement and Chinese character evolution, recording generation times, revisions and errors in specialist knowledge.
九个开源动画项目,从代码绘画到视频编排 (opens in a new tab)
文章整理九个制作动画、讲解短片和产品视频的项目,介绍风格模板、分镜、可修改工程及本地渲染环境。项目热度采用报道时点的数据。
Sand.ai 完成 2 亿美元 A+ 轮融资,10 个月累计融资 3 亿美元 (opens in a new tab)
智东西报道,视频模型公司 Sand.ai 宣布完成 A+ 轮融资,并计划继续投入模型、推理基础设施和海外业务。报道还梳理了 MAGI 系列路线及 VidMuse 的公司披露数据。
Viggle 推出 Remake:用文字修改视频角色、场景与风格 (opens in a new tab)
Viggle推出AI视频二创新界面Remake,用户上传视频并用一句话即可替换人物、服装、道具和背景,调整特效与风格,同时尽量保留原有动作和镜头节奏,支持最长2分钟视频及对话式修改。